Опубликовано
В каждом фреймворке глубокого обучения два бага округления. Их нашли и починили
Автор: Гусев Николай [портфолио]
Обновлено
Темы: ml, optimizaciya, grokking
Коротко: В софтмаксе и кросс-энтропии два численных бага: обрыв градиента у уверенной модели и шум при дистилляции. Механика, фикс в две строчки и граница применимости.
Исследователи Google DeepMind (Джонатан Баррон, Дан Гнанапрагасам, Михаэль Чаннен) опубликовали работу «A Fix for Softmax and Cross-Entropy» с неожиданным выводом: базовые формулы, на которых учится каждая нейросеть, содержат две численные ошибки. Не в математике, в реализации: арифметика с плавающей точкой тихо теряет части градиентов. Из этих потерь вырастают внезапные скачки ошибки на длинных прогонах, срывы при передаче знаний от большой модели маленькой и провалы в исследованиях обучения. Починка занимает пару строк и не замедляет обучение.
Разбираю, что именно сломано, чем это грозит на практике и стоит ли вам ставить фикс. Каждый термин кратко расшифрован при первом употреблении и ведёт ссылкой в глоссарий сайта. Ролик-разбор и проверенный код в конце статьи.
Как сеть учится отвечать
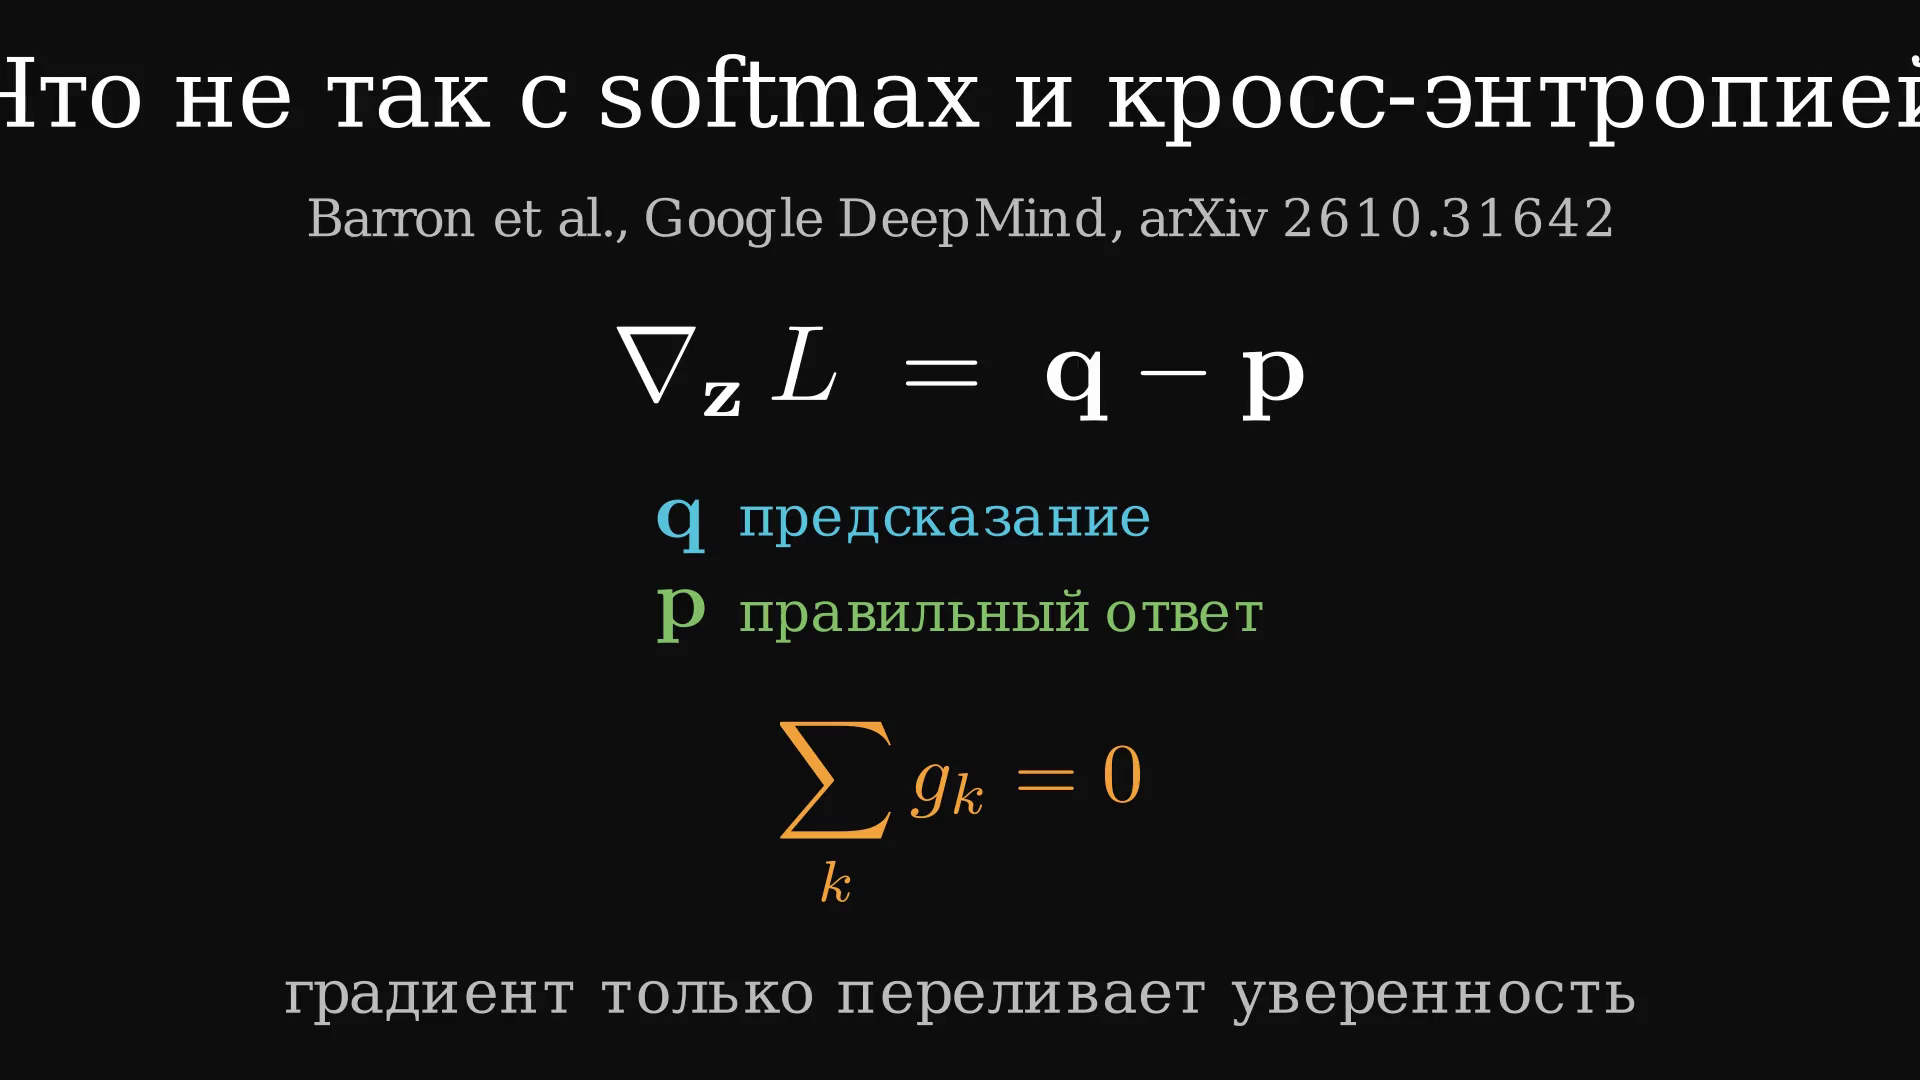
Нейросеть, решающая задачу классификации, выдаёт для каждого варианта ответа сырую оценку, логит. Софтмакс переводит логиты в вероятности, которые в сумме дают 100%. Кросс-энтропия меряет промах: насколько предсказанное разошлось с правильным ответом. Обучение держится на градиенте этой меры: подсказке, в какую сторону и насколько сильно сдвинуть параметры сети.
У градиента кросс-энтропии есть аккуратное свойство: его компоненты в сумме дают ноль. Уверенность не возникает из ниоткуда, она переливается с неверных вариантов на верный, как вода между стаканами. Если сумма стала не ноль, сеть получает фантомный толчок, которого в задаче нет.
Чтобы вероятности не переполняли разрядную сетку, все фреймворки перед расчётом вычитают из логитов максимальный. Приём стандартный и обязательный: без него экспоненты переполняют разрядную сетку. Баг прячется в том, что происходит дальше.
Баг первый: уверенный ответ глушит собственный градиент
Когда сеть уже хорошо решает задачу, она отвечает уверенно: запас правильного варианта над остальными (логит-маржа) большой. Знаменатель в формуле становится суммой вида 1 + e^(-m), где e^(-m) очень маленькое число: чем выше уверенность, тем меньше.
Тут вступает устройство чисел с плавающей точкой. Деления у этой «линейки» сгущаются к нулю: возле нуля различимы крошечные величины, возле единицы всё мельче некоторого порога исчезает при сложении. Касса без копеечного разряда: рубль плюс копейка показывает как рубль.
В формуле копейки прибавляются к рублю. Когда маржа переходит порог, который авторы назвали обрывом точности (precision cliff), слагаемое e^(-m) теряется, знаменатель становится ровно единицей, и градиент правильного ответа обращается в ноль. Порог зависит от формата чисел: 5.5 в bf16 (им учат современные ускорители), 16.6 в fp32, 36.7 в fp64. Ошибки в логах нет, всё выглядит штатно.
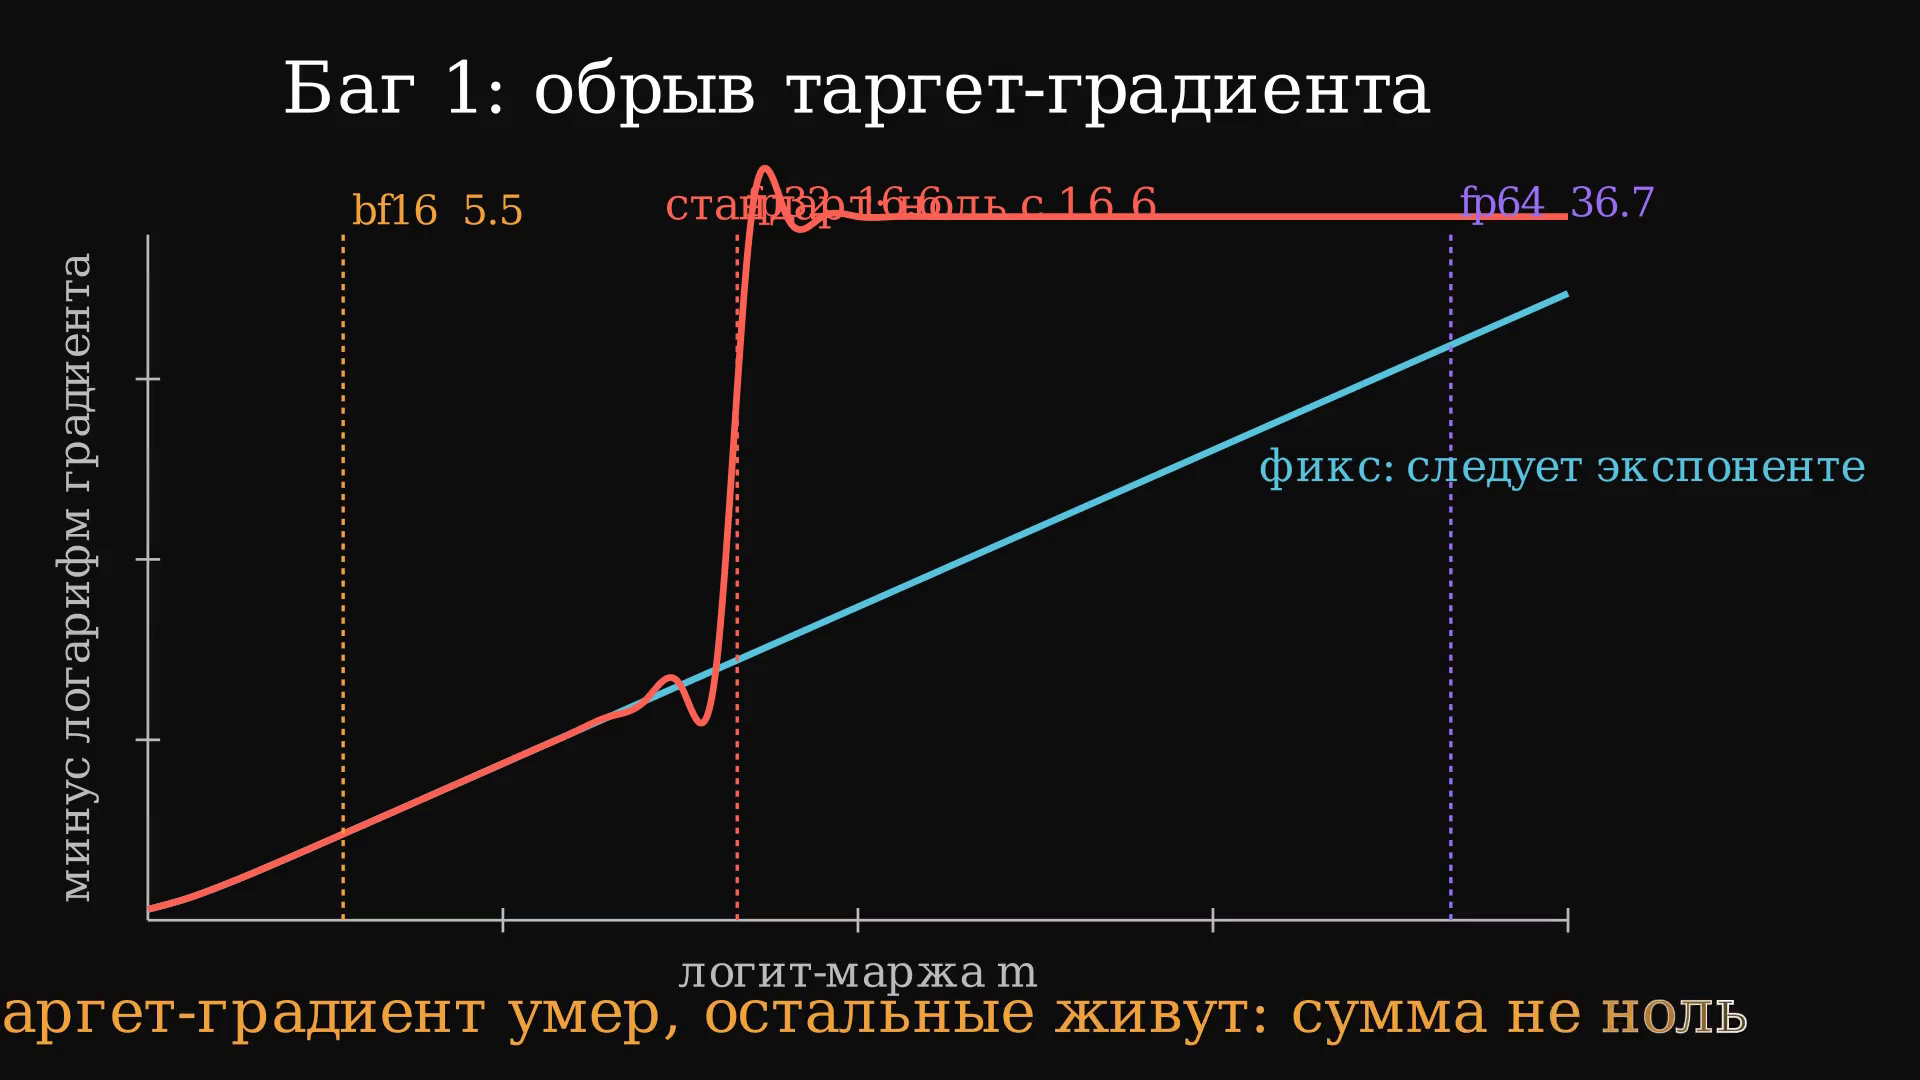
Дальше худшее: глохнет только градиент правильного ответа. Градиенты остальных вариантов считаются другой веткой формулы, без сложения с единицей, и остаются в силе. Сумма перестаёт быть нулём. Сеть, которая уже отвечает правильно, получает постоянный толчок «уходи с правильного ответа».
Авторы показывают это на одном примере: логиты [9.0, -9.0, -9.0], правильный ответ первый. Стандартная библиотека отдаёт лосс ровно ноль и градиенты [0.0, +1.5e-08, +1.5e-08]: вода появляется из ниоткуда. Точное значение: лосс 3.0e-08 и градиент таргета -3.0e-08.
Чем это аукнулось: рогатка на графике лосса
Механизм, который авторы зовут Slingshot (рогатка), в исследованиях grokking (внезапное обобщение после зазубривания) его давно считали загадкой. Оказалось, это прямое следствие обрыва.
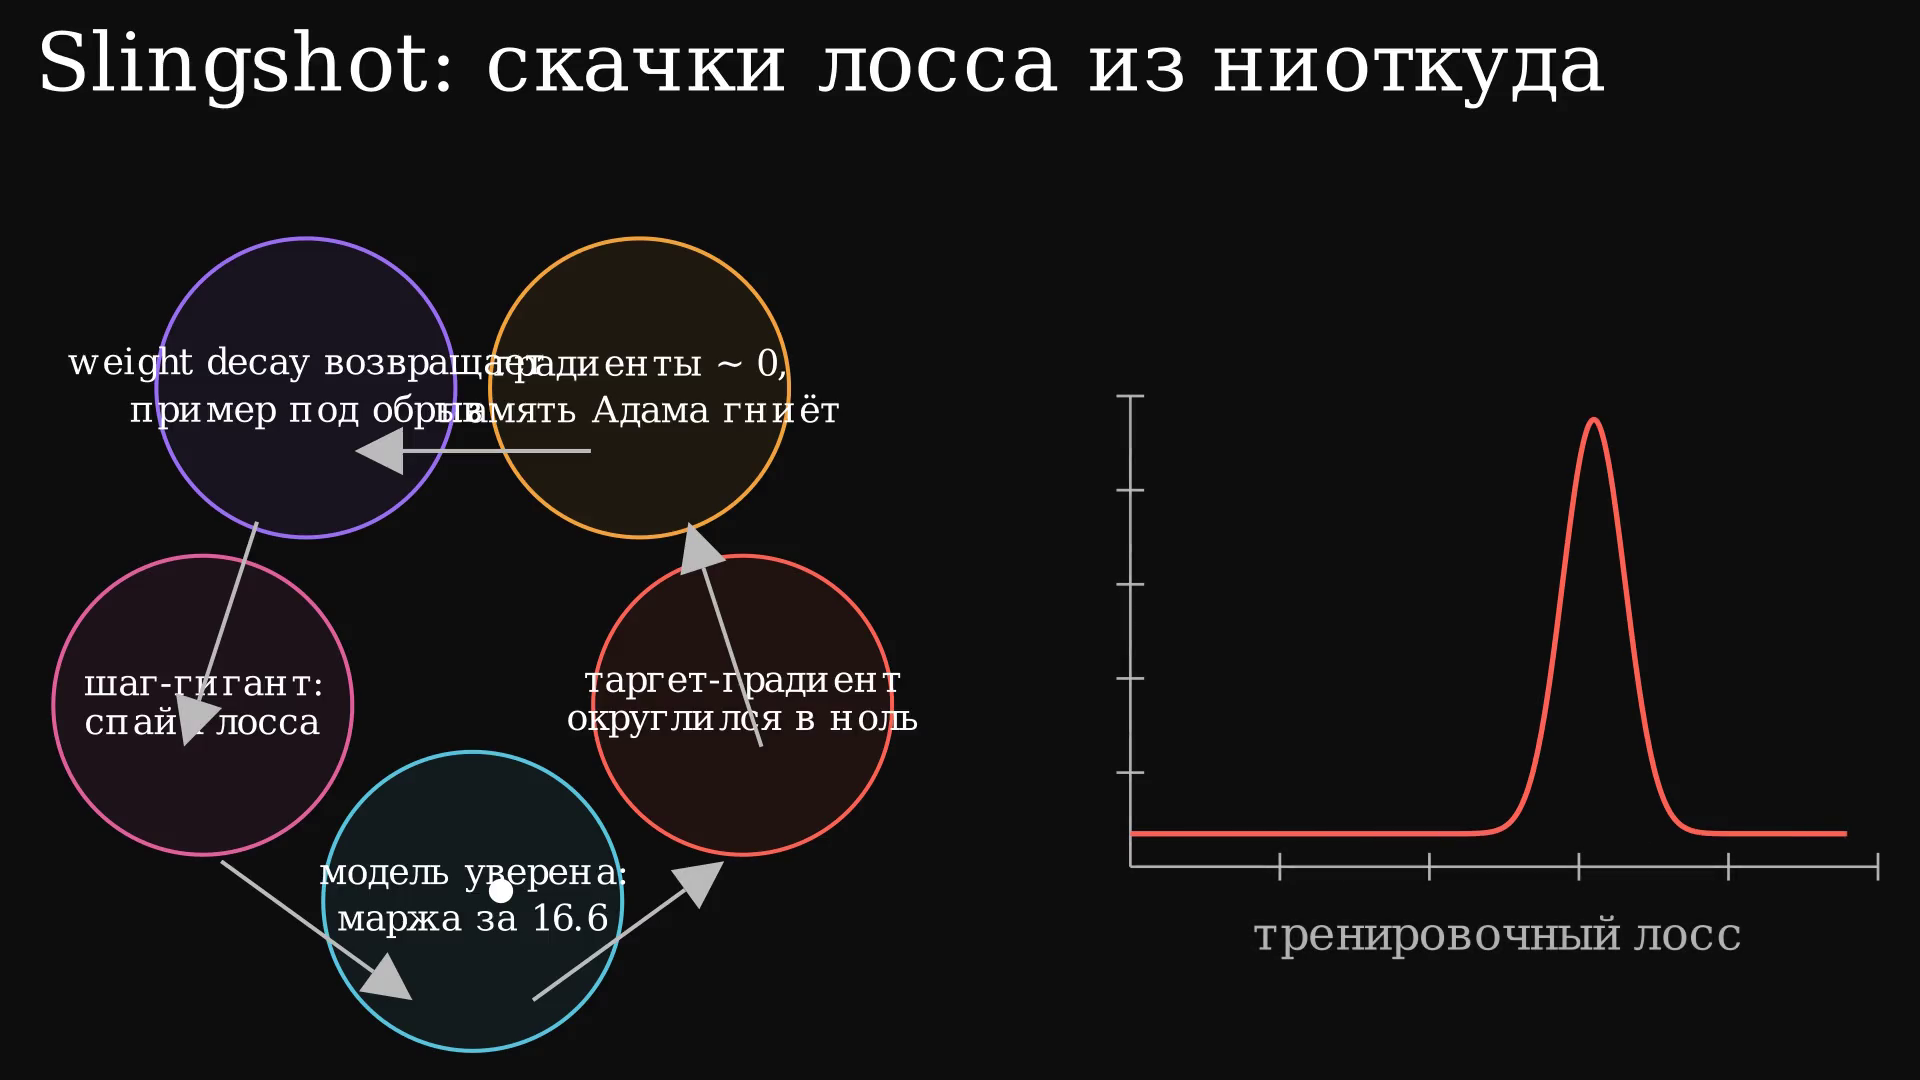
Цикл такой. Сеть зазубрила тренировочные данные, маржа растёт и перелезает обрыв, таргет-градиенты гаснут. Пока все примеры батча (порции данных на один шаг обучения) выше обрыва, градиенты почти нулевые, а память оптимизатора Adam о масштабе градиентов затухает к нулю. Затем weight decay (лёгкое сжатие весов) втаскивает пару примеров обратно под обрыв, их градиенты резко возвращаются, но делятся на уже сгнивший знаменатель. Шаг получается гигантский, ошибка на графике выстреливает шипом, цикл повторяется.
Цена из экспериментов статьи: без weight decay один такой шип ронял точность с 61% до 23%. С weight decay обрыв не ронял точность разом, но замедлял обучение и снижал итог: около 94% против стабильных 100% у починенной версии.
Баг второй: студент дрожит рядом с учителем
Второй баг живёт в дистилляции, передаче знаний от большой модели маленькой. Студент учится повторять распределение ответов учителя, а градиент считается как разность двух наборов вероятностей: предсказанного и учительского.
Когда студент уже близок к учителю, вычитаются почти равные числа, и точность такой разности катастрофически падает. Хуже: расчёт в прямом проходе и в обратном идёт разными последовательностями операций и не совпадает до последнего бита даже при полном равенстве студента и учителя. Ненулевой градиент есть там, где должен быть ровно ноль.
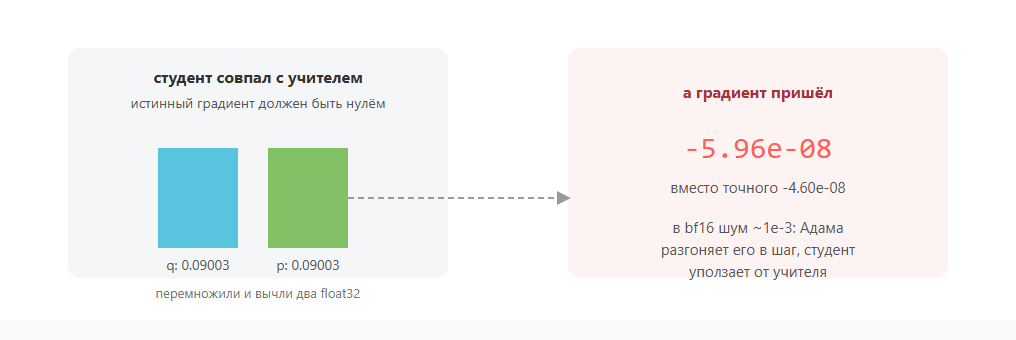
Авторы инициализируют студента весами учителя и тренируют: студент обязан стоять на месте. В fp64 шум на уровне 1e-17 невидим, в fp32 (1e-8) даёт краткий всплеск расхождения с учителем, в bf16 шум порядка 1e-3: оптимизатор нормирует его в полноценные шаги, и студент уползает от учителя с падением точности.
Починка: не складывать копейки с рублём
Оба бага растут из одной привычки: складывать единицу с крошечным числом или вычитать почти равные вероятности. Авторы переписали формулы так, чтобы этого не происходило:
- для обычной кросс-энтропии маржа считается отдельно от единицы и склеивается функцией softplus, которая не теряет малые слагаемые;
- для дистилляции разность вероятностей вычисляется из разности логитов через парные функции expm1 и log1p, точные возле нуля.
Градиенты снова точно в сумме дают ноль, во всех трёх форматах чисел, без каста к более длинному и без замедления.
Я прогнал реализацию фикса для PyTorch на логитах [9.0, -9.0, -9.0] из статьи: стандартная функция дала сумму градиентов 3.0e-08, фиксированная ровно 0.0. В задаче дистилляции ошибка градиента против эталонного расчёта двойной точности: 1.4e-08 у стандарта против 2.5e-15 у фикса, то есть до машинного предела точности. Код с тестами приложен к статье: torch_fixed_ce.py, проверки воспроизводятся одной командой.
Побочный вывод: у уверенности есть потолок, и его задаёт eps
Самое красивое в работе получилось попутно. Починенная кросс-энтропия позволяет марже расти без обрывов, и всё же рост останавливается, но не из-за точности чисел. Авторы выводят: при затухающем градиенте оптимизатор Adam перестаёт нормировать шаг, и в какой-то момент шаг уравновешивается с weight decay. Точка равновесия: log(1/eps), где eps это крошечная добавка в знаменателе Адама.
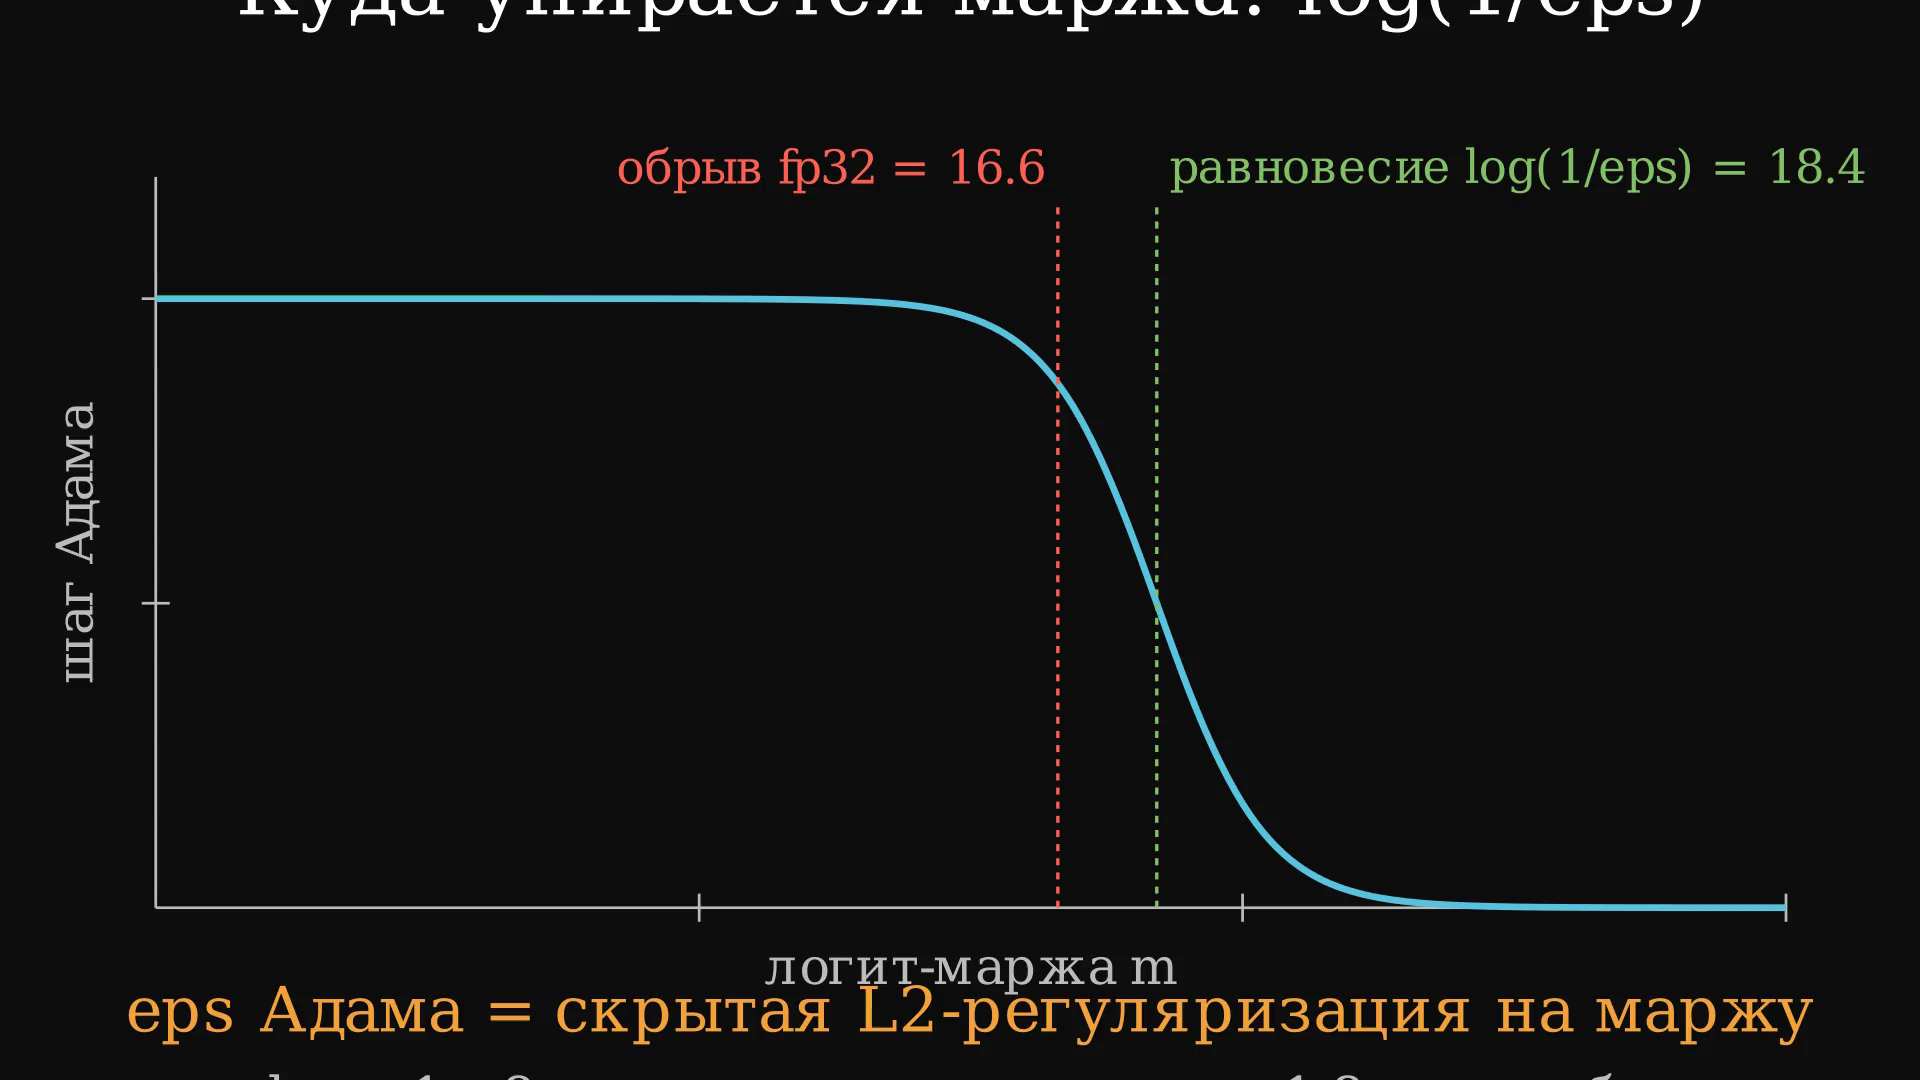
Выходит, у eps Адама есть скрытая вторая работа: он работает как L2-регуляризатор уверенности, потолок, выше которого модель не раскачивает свои ответы. Отсюда изящное объяснение давней загадки: дефолтный eps = 1e-8 ставит потолок на 18.4, что на 1.8 выше обрыва fp32 (16.6). Стандартная реализация бьётся в обрыв прямо перед тем, как естественно успокоиться. Поднимите eps до 1e-7, потолок опустится до 16.1, ниже обрыва, и стандартная реализация внезапно перестаёт сбоить.
Что это значит практически
Кому стоит обратить внимание на эту работу:
- Обучаете модель в bf16. Обрыв там наступает уже на марже
5.5, уверенные модели долетают до него за часы. Всё обучение после этого частично идёт по шуму. - Дистиллируете близкие модели. Студент, скопированный с учителя, должен стоять на месте, а уползает. Чем короче формат чисел, тем сильнее.
- Видите шипы ошибки после того, как сеть выучила тренировочные данные. Если на графике лосса плато и внезапные шипы, это с высокой вероятностью рогатка, а не мистика и не проблема данных.
- Занимаетесь исследованиями обучения. В экспериментах статьи фиксированная кросс-энтропия давала 99-100% точности там, где стандартная срывалась.
Чинить можно по-разному, по возрастанию усилий:
- Поднять eps Адама с
1e-8до1e-7. Одна строчка в конфиге, потолок уверенности опустится ниже обрыва fp32, рогатка уйдёт. Это паллиатив: сам баг остаётся, для bf16 с его обрывом на5.5не помогает. - Поставить фиксированные функции лосса. Drop-in замена без замедления, чинит оба бага во всех форматах. Готовая реализация для PyTorch приложена к статье.
- Для дистилляции добавить к пункту 2 мягкий вариант лосса из той же реализации.
И граница честности, которую авторы обозначают сами: на обычном большом обучении такие запредельные маржи встречаются редко. Фикс не спасёт провалившийся проект и не ускорит обучение в разы. Его польза в другом: он бесплатный, и он снимает целый класс необъяснимых артефактов там, где модели становятся очень уверенными или очень похожими друг на друга. А главное, работа показывает, что часть «загадочного» в поведении нейросетей при внимательном взгляде оказывается арифметикой.
Материалы и код
- Статья-первоисточник: A Fix for Softmax and Cross-Entropy, arXiv 2610.31642 (Barron, Gnanapragasam, Tschannen, Google DeepMind).
- Ролик-разбор (47 секунд, 1080p60, четыре сцены: градиент, обрыв, рогатка, равновесие): softmax_fix_explainer.mp4.
- Проверенная реализация фикса для PyTorch с тестами: torch_fixed_ce.py.