Опубликовано
Бонус 2. Комикс по ТЗ на 8 GB VRAM: три попытки и найденный метод
Автор: Гусев Николай [портфолио]
Темы: ai-agents, benchmarks, local-models, privacy
Бонус 2. Комикс по ТЗ на 8 GB VRAM: как мы искали идеальный пайплайн
Гусев Николай · сентябрь 2026
В первой части был тезис: бенчмарк - наводка, проверять модели надо руками на своих задачах. Это бонус про такую проверку. Задача детская по формулировке и взрослая по исполнению: взять ТЗ "нарисуй комикс про приключения Незнайки на Венере" и собрать мультимодельный пайплайн, который выдаст связный комикс с одинаковым героем на всех панелях. Железо - игровая карта на 8 GB.
Спойлер: с первой попытки не получилось. Со второй - наполовину. С третьей - нашли метод, который даёт одинаковое лицо, но платит временем. Этот текст - хроника всех трёх попыток с цифрами и кодом.
Что было в арсенале
Из первой части под рукой: Aion-RP-Llama-3.1-8B (ролевик), Granite-4.1-3B (структуры и tool calling), LFM2.5-VL-3B (мультимодальные глаза). Плюс рисовательная LLaDA-Image-Turbo в ComfyUI - 6B диффузионная модель, INT8-квант, 4 шага Turbo.
Гипотеза наивного пайплайна: каждая модель делает свою работу. Сценарист пишет рассказ в стиле Носова, Granite режет его на сцены и выдаёт английские промпты, диффузионка рисует, мультимодальная модель смотрит результат и говорит, годится ли.
Четыре локальных специалиста вместо одной универсальной модели. Звучит разумно. Проверяем.
Попытка 1: наивный конвейер (провал)
Запуск текстовых моделей - llama-server напрямую, не через GUI:
# сценарист
llama-server -m Aion-RP-3.1-8B-Q4_K.gguf --port 8081 -ngl 99 \
  --ctx-size 4096 -t 6 --no-webui
# структуры
llama-server -m granite-4.1-3b-Q4_K_S.gguf --port 8083 -ngl 99 \
  --ctx-size 4096 -t 6 --jinja --no-webui
# глаза
llama-server -m LFM2.5-VL-3B-Q4_K_M.gguf \
  --mmproj mmproj-LFM2.5-VL-3B-F16.gguf \
  --port 8082 -ngl 99 --ctx-size 4096 -t 6 --no-webui
Стиль Носова сценаристу передавали образцом: два абзаца оригинала в системный промпт - не описание стиля словами, а сам стиль.
Результат по этапам:
Aion-RP выдал 3092 символа за 53 секунды. Диалоги живые, но текст с артефактами: "настаток", "земляниньи", а в конце генерация сорвалась в бессмыслицу на польском языке с служебными токенами диалога. Причина вторая половины - незакрытый чат-шаблон Llama-3.1: модель дорисовала чужой диалог поверх рассказа. RP-файнтюн держит ролевую игру, но не детской прозы: 8B-модель уровнем ниже задачи "напиши как Носов".
Granite честно разобрал мусор на 6 сцен: JSON валидный, с первого раза. Но сцены высосаны из рваного текста. Мусор на входе - мусор на выходе, модель не виновата.
LLaDA нарисовала 6 панелей за 194 секунды при настройках по умолчанию (4 шага, CFG 1.0). И тут главный провал: Незнайка на каждой панели - разный мальчик. Шляпа есть, но каждый раз новая. Плюс модель рисовала "текст" внутри кадров - каши из букв, которые не читаются. Диффузионка на 4 шагах игнорирует тонкости описания персонажа в промпте.
LFM2.5-VL посмотрела панели и почти всё одобрила. Без жёсткого критерия "перечисли расхождения с эталоном" 3B-контролёр резиновый: она отвечает "годится" почти на всё.
Итог попытки: связка из четырёх локальных специалистов мультиплицирует ошибки. Слабое звено - сценарист - испортило всё вниз по течению. Классический конвейер без контроля качества на каждом стыке.
Вывод номер один: сценарий и сцены не доверяем 8B-модели. Автор - главная модель (облако или большая локальная), локальные малыши - исполнители и глаза.
Попытка 2: главный сценарист + тюнинг генерации (наполовину)
Рассказ переписан нормальной моделью. Короткие реплики, характеры на месте, финал "Зато теперь я знаю, чего я не знаю!" - это уже по-носовски.
Генерация картинок перенастроена:
"steps": 8,            # было 4
"guidance_scale": 2.0, # было 1.0
"negative_prompt": "text, letters, words, watermark, deformed hands"
Плюс то, что мы назвали "ядро персонажа": одна и та же строка описания Незнайки в каждом промпте, слово в слово - шляпа, рубаха, штаны, галстук, красный нос.
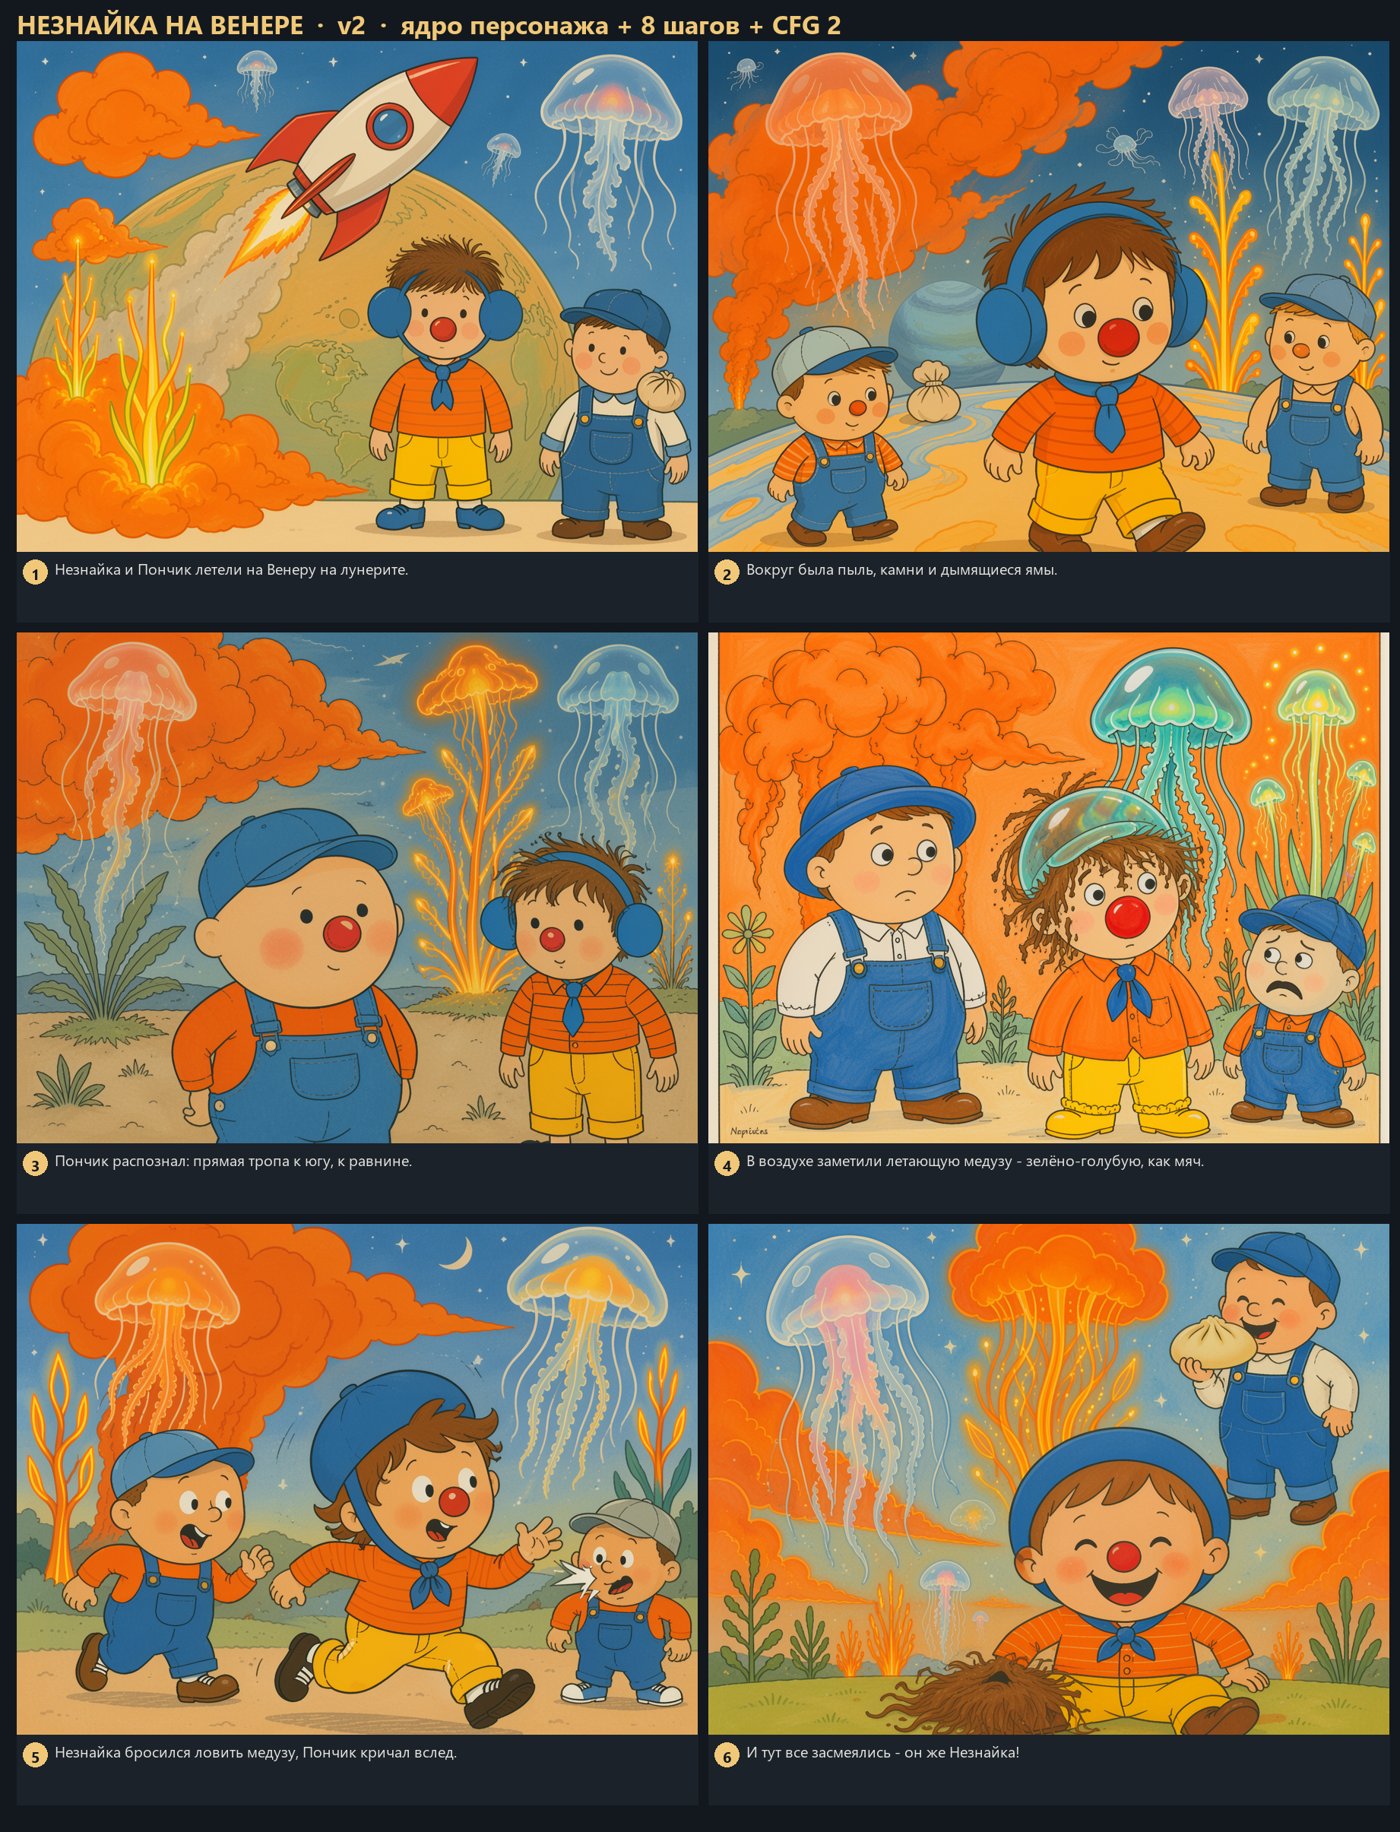
Результат: текст-каша исчезла полностью (негатив-промпт работает). Стиль "советская книжная иллюстрация" стал единым. Персонаж - узнаваем. Но "узнаваем" не значит "одинаков": пропорции лица и фигуры гуляют от панели к панели. Это один типаж в разных воплощениях, не один ребёнок.
Вывод номер два: промпт-ядро даёт узнаваемость, не идентичность. Потолок метода на безреференсной генерации.
Попытка 3: канонический портрет + нативное редактирование (сработало)
У LLaDA-Image есть режим нативного редактирования - generation_mode="editing", путь image-conditioning SigVQ. Это НЕ img2img с ползунком denoise: модель получает исходную картинку и инструкцию "сохрани персонажа, смени окружение".
Схема:
-
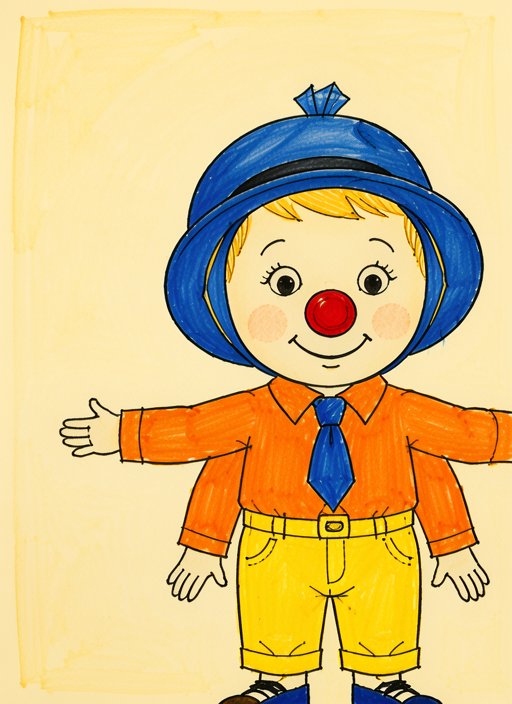
Один раз генерируем канонический портрет персонажа. CFG 3.0, жёсткое "ONE single character only, plain background". Важная грабля: без этого усиления модель рисует ДВА экземпляра героя рядом.
-
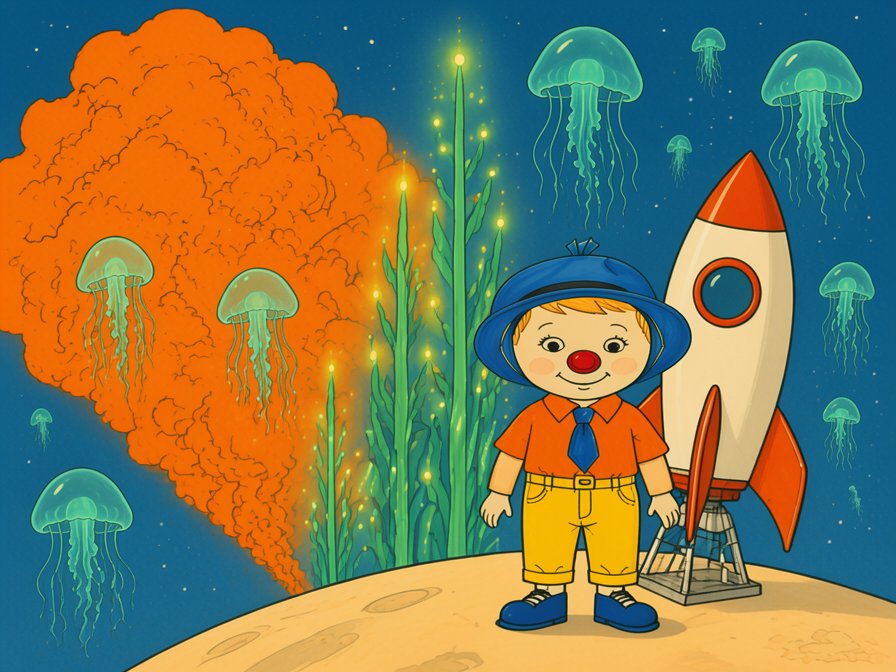
Каждая панель комикса - редактирование канона: "поставь этого же мальчика на поверхность Венеры к ракете, сохрани персонажа идентичным".
api = {
  "1": {"class_type": "LLaDAImageLoader", "inputs": {...}},
  "5": {"class_type": "LoadImage", "inputs": {"image": "nez_canon.png"}},
  "3": {"class_type": "LLaDAImageEdit", "inputs": {
        "pipeline": ["1", 0], "image": ["5", 0],
        "prompt": edit_instruction,
        "width": 896, "height": 672,  # кратны 32 - требование режима
        "steps": 8, "guidance_scale": 2.0, "seed": seed}},
  "4": {"class_type": "SaveImage", "inputs": {...}}
}
Сравнительный стенд трёх методов (эталон / промпт-ядро / editing):
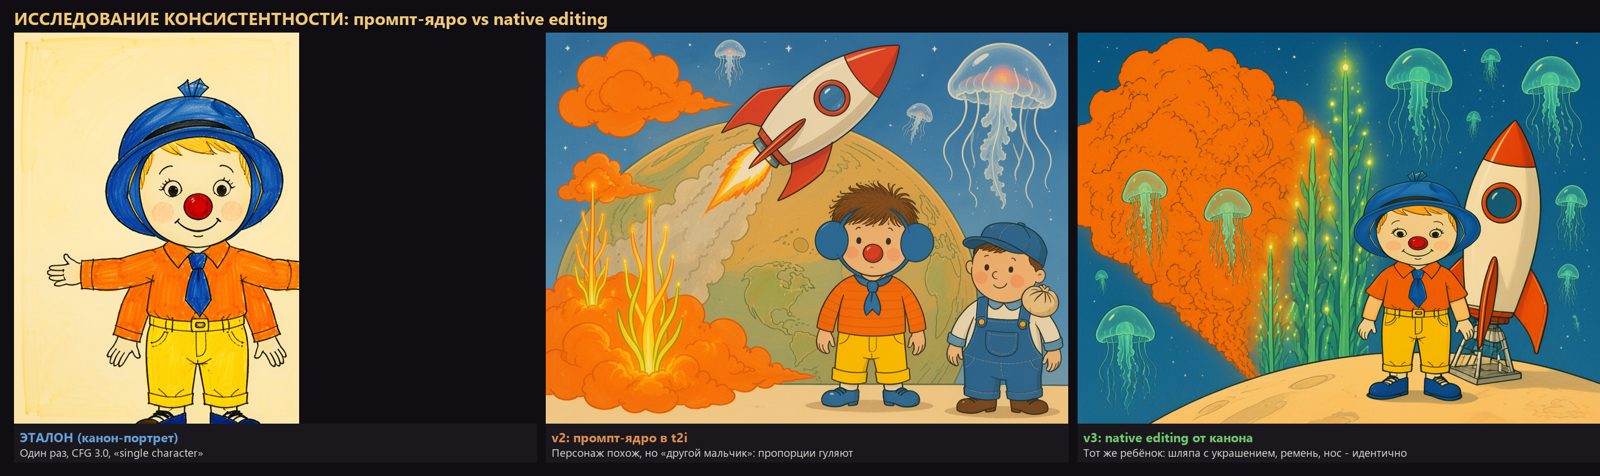
Результат первой панели: персонаж перенесён буквально. Та же шляпа с украшением сверху, тот же ремень с квадратной пряжкой, тот же красный нос, те же светлые пряди из-под шляпы - при полностью новой сцене с ракетой, кратерами и медузами. Это единственный метод из трёх, который даёт "одно лицо" на 8 GB VRAM без IPAdapter и LoRA (тех под LLaDA пока не существует).
Канонический портрет (четыре руки - даже стильно и удобно, когда одна пара держит булку, а вторая машет шляпой):
Первая панель через editing от канона:
Цена метода - время. Edit-кадр на нашей карте идёт 25-30 минут против двух минут у прямой генерации: режим редактирования гоняет через conditioning больше тензорных проходов, и на 8 GB веса частично свопятся. Для шести панелей это три часа против пятнадцати минут.
Экономика трёх методов
Выбор метода - выбор бюджетной оси: скорость или лицо. Для одиночного комикса хватит v2. Для сериала, где герой живёт десятками кадров, канон окупается сразу.
Грабли, собранные по пути:
Три llama-сервера съедают 7.4 GB VRAM. Если оставить их жить рядом с ComfyUI, диффузионка свопит веса по кусочкам и шаг растёт с 5 секунд до минуты. Перед генерацией картинок текстовые серверы глушим: VRAM одна на всех, очередь вместо параллельности.
Незакрытый чат-шаблон - источник внезапного бреда в длинных генерациях. Обрезайте вывод по стоп-токенам и проверяйте хвост.
Канон-портрет без "single character only" в промпте даёт двух одинаковых героев рядом - модель любит дублировать.
Контролёр без чек-листа одобряет всё. Мультимодальной модели нужен вопрос "перечисли расхождения с эталоном", а не "годится ли".
Итоговая архитектура
То, что мы считаем правильным для 8 GB VRAM после этого эксперимента:
Сценарий и сцены - главная модель. Локальная 8B не пишет детскую прозу, точка.
Канон-портрет - один раз, прямой генерацией с высоким CFG.
Панели - native editing от канона, если персонаж должен быть тем же (медленно, но идентично), или прямая генерация с ядром персонажа, если важнее скорость (типаж, не идентичность).
Подписи - не внутри кадров, а наложением поверх: диффузионки не умеют в текст, и негатив-промпт "text, letters" только маскирует проблему.
Контроль - мультимодальная модель с жёстким чек-листом сравнения с эталоном.
VRAM-дисциплина: текстовые серверы живут отдельно от рисования, не одновременно.
Итоговый комикс второй попытки (типажная консистентность, 6 панелей):
Что дальше
Метод v3 открывает дорогу к "ДНК персонажа" на слабом железе: один канонический портрет на героя, editing переносит его в любую сцену. Предел роста - IPAdapter и LoRA, когда их допилят до LLaDA-архитектуры. Пока их нет, editing - лучший ответ на вопрос "как сделать одинаковое лицо".
Артефакты эксперимента: папка 2026-09-05-bonus2-comic в channel-materials (зеркало на GitFlic: manve-sulimo2/channel-materials).
Наши сервисы: pii-guard.ru, llm.pii-guard.ru, hermes-agent.ru, shturman.ai. Сотрудничество и вопросы - Telegram: @sneg1313.