Опубликовано
Qwen-Image-2.1 Turbo: в 2.5 раза быстрее на одной карте
Автор: Гусев Николай [портфолио]
Обновлено
9 октября Alibaba выложила Turbo-версию Qwen-Image-2.1. К вечеру того же дня она прошла полный прогон на моей карте: RTX 4060 с восемью гигабайтами, ComfyUI, 1024×1024. Замер простой: три сцены, два зерна, одинаковые промпты, одна и та же обвязка. Отличаются только чекпойнт и число шагов.
Результат: базовая модель отрисовывает кадр за 121 секунду, Turbo за 48. Ускорение в 2.52 раза, при этом качество на тексте и руках не просело.
Что такое Turbo
Turbo это тот же трансформер, дообученный работать за 8 шагов вместо 25. Расписание сэмплирования зашито прямо в чекпойнт, CFG равен единице, негативный промпт не читается. Через Diffusers модель грузится классом QwenImage21Pipeline, но мне был нужен путь через ComfyUI, а там свой формат.
Повезло: в тот же день на Hugging Face появилась пересборка Turbo в int8-convrot, том самом формате, в котором у меня уже жила базовая версия. Файлы совпадают до байта по размеру: 7.26 гигабайта у обоих. Замена свелась к подстановке имени файла в ноду UNETLoader.
Замер
Условия: RTX 4060 8GB, ComfyUI 0.37, 1024×1024, euler с простым планировщиком, cfg 1.0, шесть кадров на каждую модель. Скорость брал из собственных таймстампов ComfyUI, а не по настенным часам, чтобы загрузка модели не портила цифру.
base int8,   25 шагов:  121.3 сек  (116.3-133.5)
turbo int8,   8 шагов:   48.1 сек  (45.8-58.7)
turbo Q4 GGUF,8 шагов:   45.6 сек  (41.6-46.9)
Свободная видеопамять после прогрева: 2.49 ГБ у базы, 2.26 у Turbo, 0.45 у Q4. Да, у четырехбитной версии памяти свободно меньше, чем у восьмибитной, хоть файл и весит вдвое меньше. Об этом ниже.
Ускорение в 2.52 раза. Примерно треть от этого дает сам Turbo-чекпойнт, остальное съедает разница шагов: восемь проходов диффузии против двадцати пяти.
Качество
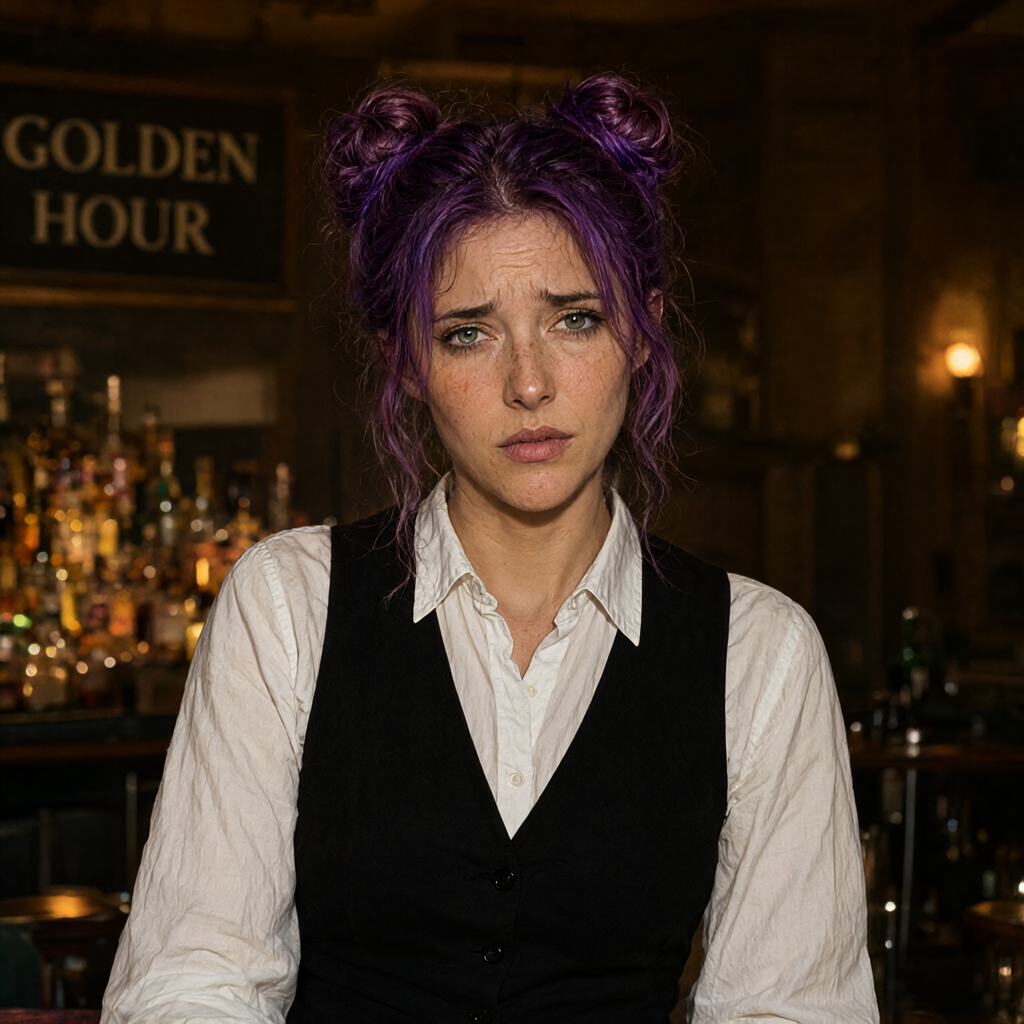
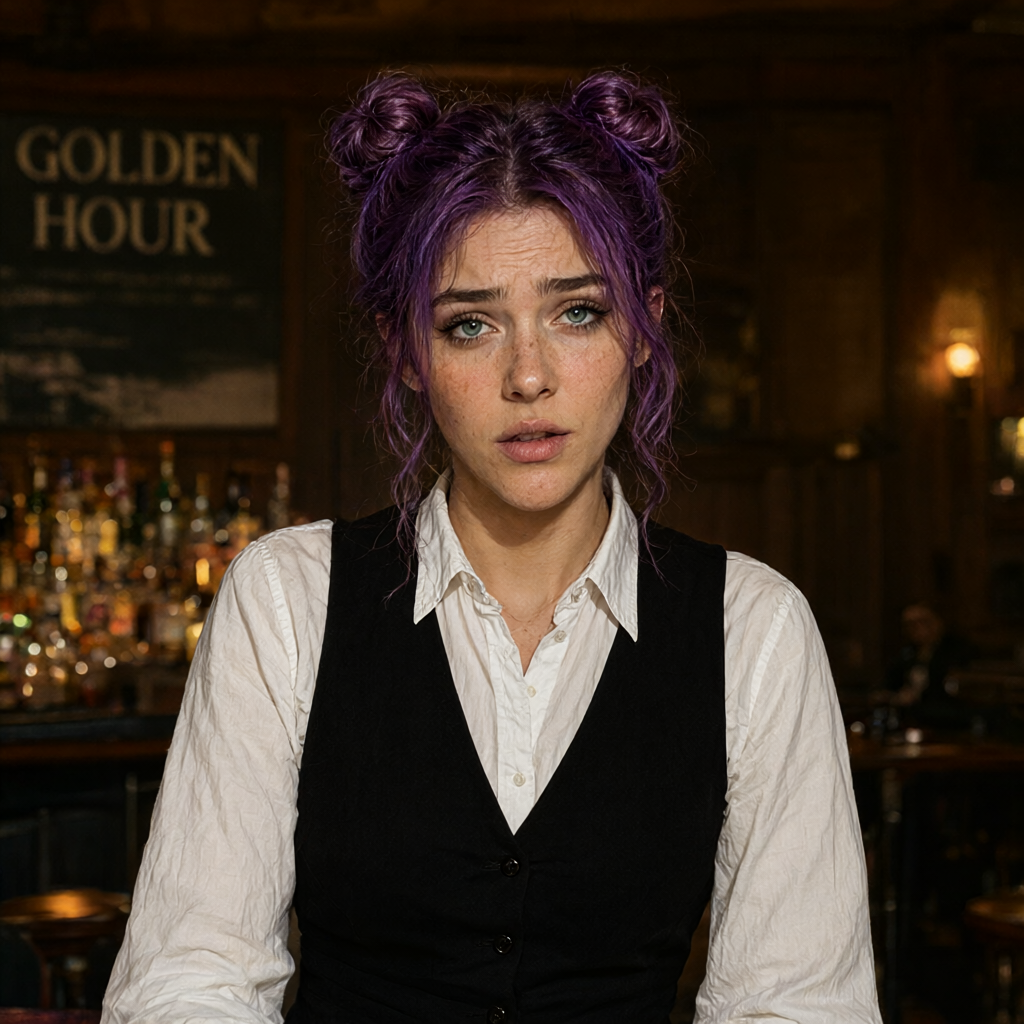
Три сцены проверял попарно на одинаковых зернах: постер с крупным текстом GOLDEN HOUR, портрет крупным планом, руки с кружкой.
Текст читается чисто в обоих вариантах, буквы без артефактов. Анатомия рук и хват кружки корректны и там, и там. По общему уровню детализации разницы на глаз нет. Для постеров и обложек Turbo подходит без оговорок.
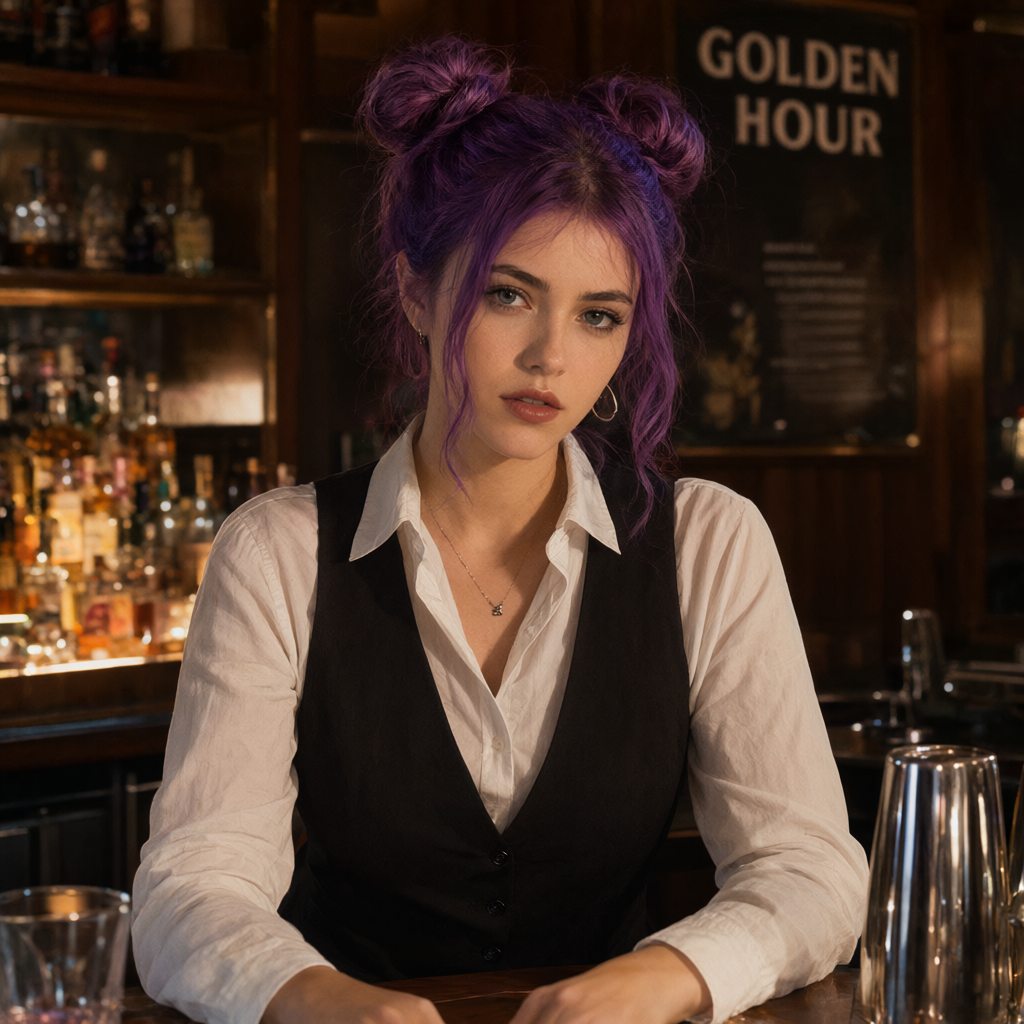
Грабли, ради которых статья и писалась
Первая версия бенча падала так: второй кадр сессии доходит до декодера, и ComfyUI умирает целиком, без traceback в логе, просто access violation. Я собирал эту граблю три дня, вот что выяснилось.
Первое. GGUF-версия держит модель в памяти хоста двумя способами сразу: отображение файла на диск плюс распакованные копии весов. Процесс разрастается до 11.7 гигабайта при восьми гигабайтах видеопамяти. На декодере следующего кадра система не может выделить еще 13 мегабайт, и процесс падает.
Второе. Лекарство в одну строку: после каждого кадра просить ComfyUI выгрузить веса. Эндпойнт /free с флагами free_models и unload_models, но без free_vram. Последний флаг на Windows с драйвером WDDM течет: каждый цикл выгрузки оставляет в памяти хоста немного мусора, и через восемь рендеров процесс съедает всю оперативку. Выгружать после каждого кадра, а не после пакета: одна невыгруженная сессия весит больше, чем вся видеопамять карты.
Третье. Свежие зерна обязательны. ComfyUI кэширует выполнения, и повторный запрос с тем же зерном вернет старую картинку за четыре секунды. Половина моих первых замеров мерила кэш, а не модель.
Четвертое. Q6_K из GGUF-линейки не заработал у меня конкретно вот как: модель весит 5.6 гигабайта в распакованном виде, в восемь гигабайт карты она не помещается целиком, ComfyUI включает режим стриминга весов с диска, и при первой же выгрузке куска модели под декодер нода comfyui-gguf падает с access violation внутри операции перемещения тензора между устройствами. Воспроизвелось дважды на чистой памяти, включая прогревочный кадр: он отрабатывает, падает уже декодер. Это баг ноды в пути частичной выгрузки, а не проблема кванта или модели. На карте с 16 гигабайтами VRAM и больше Q6_K, скорее всего, заведется без единой правки: модель влезет целиком, стриминг не включится, падать будет нечему. Проверить не могу, у меня восьмерка. Q4_K_M весит меньше и влезает целиком, поэтому работает.
А как же квант поменьше
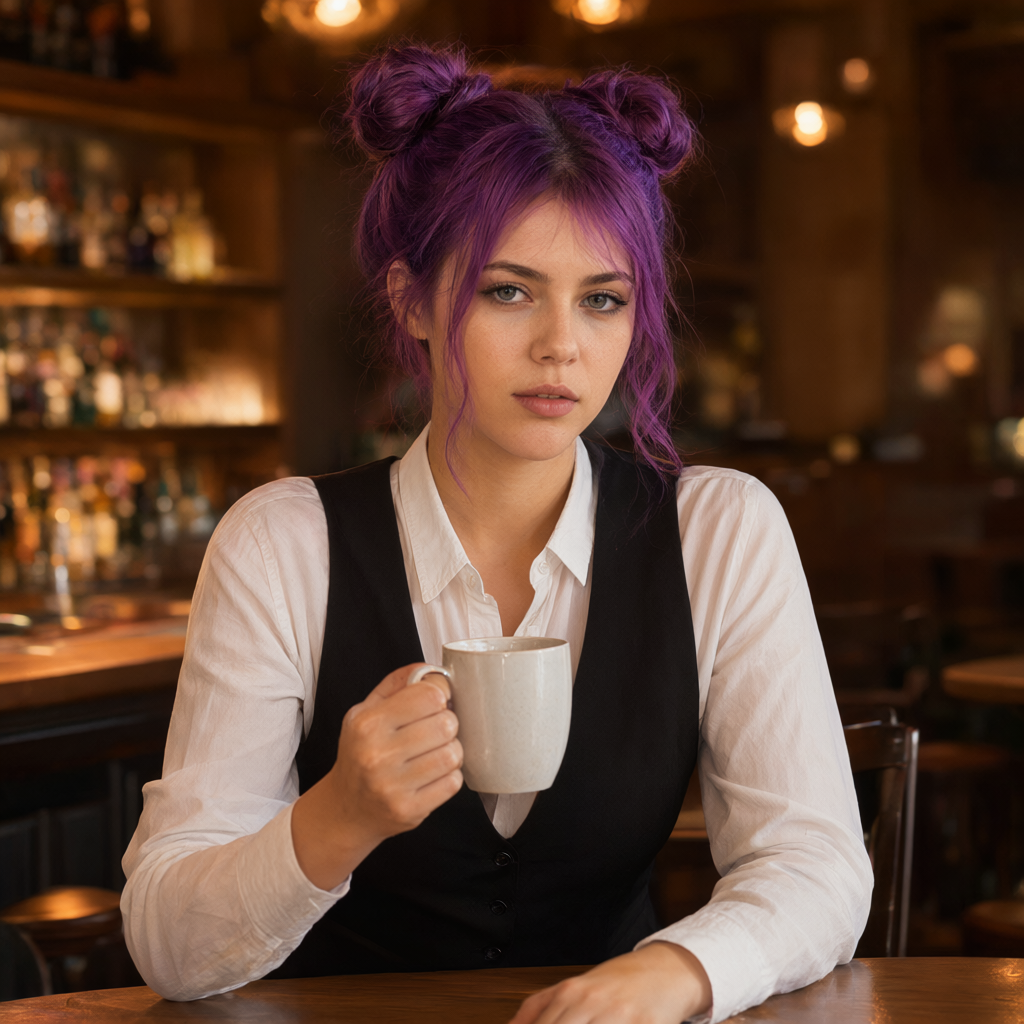
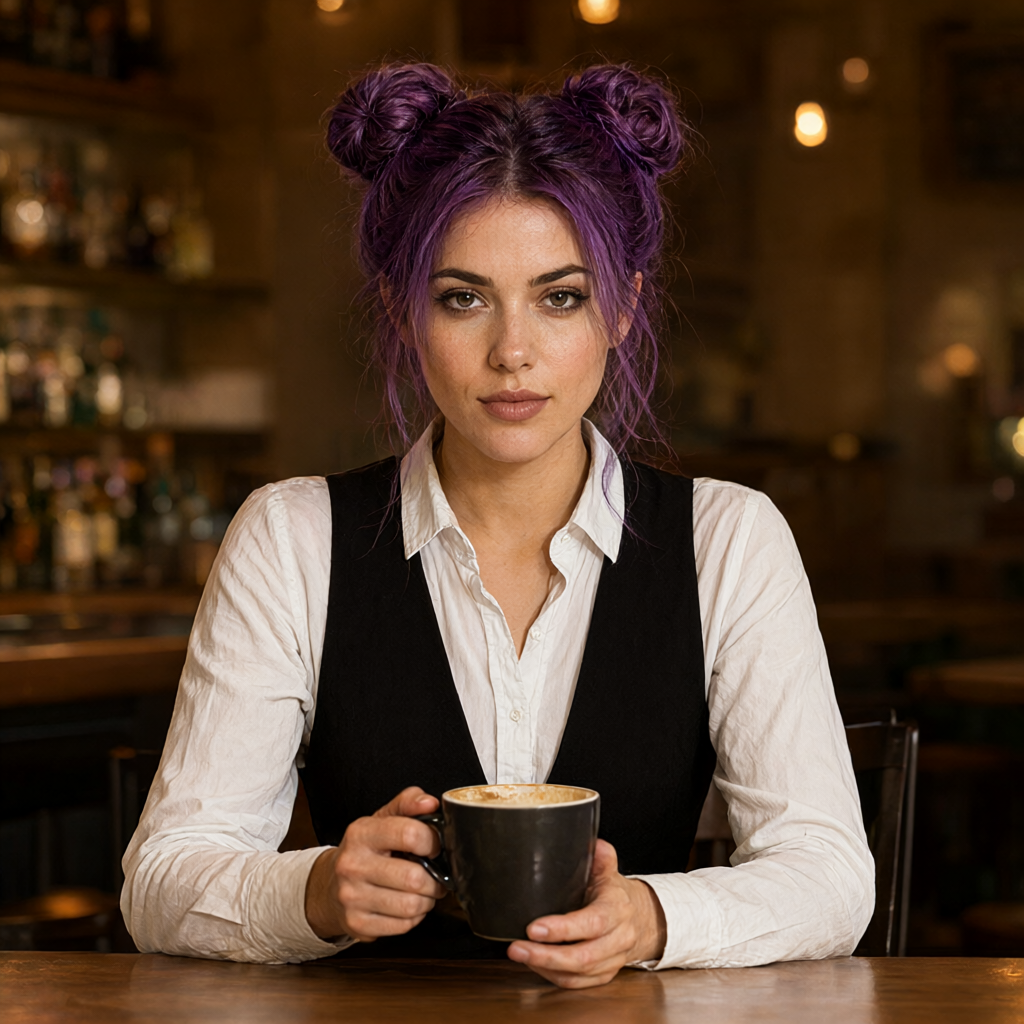
Q4_K_M весит 4.19 гигабайта против 7.26 у int8. Казалось бы, меньше бит, быстрее счет. По факту выигрыш 5 процентов, в пределах шума, а свободной памяти остается меньше: распаковка квантованных тензоров ест память в процессе. Качество текста при этом заметно хуже: надпись GOLDEN HOUR на Q4 читается через раз.
Итог по квантам: int8-convrot Turbo остается рабочим вариантом. Q4 экономит место на диске и больше ничего. Q6 не работает.
Лицензия
Turbo-чекпойнты идут под Qwen Research License, некоммерческое использование. Для постеров канала проходит, для коммерческих задач надо читать условия.
Что брать под задачу
Карта на 8 гигабайт, русскоязычные постеры и обложки: Turbo int8-convrot, 8 шагов, выгрузка весов после каждого кадра. Двадцать пять шагов базовой модели на этой карте больше не нужны: двукратная разница в цене кадра не покупает ничего, кроме уверенности, что ты использовал модель как в tutorials.
Код и материалы
Весь пайп выложен в открытом репо канала, каталог 2026-10-09-qwen21-turbo-bench. Внутри:
- code/bench-generic.py - скрипт A/B-бенчмарка: гоняет ваши чекпойнты на одинаковых промптах и зернах, меряет время по таймстампам ComfyUI, складывает JSON. Все места для замены помечены: имена моделей, классы лоадеров, канон персонажа, сцены, зерна. Выгрузка весов и обход кэша уже зашиты.
- code/submit-generic.py - минимальный клиент разовой генерации: подставили свою модель и промпт, запустили, получили картинку и выгрузку памяти в конце. С этого файла проще всего начать сбор своего пайпа.
- article.md - эта статья, картинки кадров отдельно.
Зеркало для РФ: gitflic.ru/manve-sulimo2/channel-materials, тот же каталог.
Под свою модель меняются три вещи: классы нод загрузки и энкодера (UNETLoader против UnetLoaderGGUF, TextEncodeQwenImage21 против CLIPTextEncode), имена файлов весов и текст канона. Под свое железо - размер батча и число шагов Turbo-чекпойнта, если ваша карта тянет больше восьми гигабайт и вы хотите полную версию модели.