
Опубликовано
Qwen-Image-2.1 на RTX 4060: текст в кадре, прозрачность и референсы вместо IP-Adapter
Автор: Гусев Николай [портфолио]
Дата обновления не указана в исходнике.
Темы: qwen-image, local-generation
В Бонусе 4 я собирал локальный рисовательный стек на 8 ГБ VRAM: 5 SDXL-чекпойнтов, IP-Adapter для лица персонажа, 18-30 секунд на панель. У стека было три врождённых дырки: текст в кадре SDXL коверкает, прозрачность не умеет вовсе, а для серии с одним лицом нужен обвес из IP-Adapter и CLIP-Vision. 20 сентября Alibaba выложила Qwen-Image-2.1 - и все три дырки в ней закрыты из коробки. Я проверил за один вечер на своей 4060, вот цифры.
Что выпустили
Qwen-Image-2.1 - единая модель генерации и редактирования: 7B параметров в DiT-компоненте (32 single-stream слоя), текстовый энкодер Qwen3-VL 8B, VAE с нативной поддержкой альфа-канала. Заявлено: до 10 референсов на генерацию, локальные правки через нарисованные области, прозрачный фон без постобработки, текст и портреты лучше предшественника.
Важно, что день-в-день модель подхватили все: diffusers (через QwenImage21Pipeline), ComfyUI (свои веса и шаблоны), vLLM-Omni, SGLang, LightX2V. Официальный блог: qwen.ai/blog?id=qwen-image-2.1, веса: huggingface.co/Qwen/Qwen-Image-2.1, ComfyUI-версия: Comfy-Org/Qwen-Image-2.1.
Сколько весит и что качать на 8 ГБ
Полный набор Comfy-Org - 74 ГБ, это для владельцев 24-гигабайтных карт. Мне хватило 14.3 ГБ:
diffusion_models/qwen_image_2.1_int8_convrot.safetensors   7.26 GB   DiT
text_encoders/qwen3vl_8b_w4a8.safetensors                  6.31 GB   энкодер
vae/qwen_image_2.1_vae_bf16.safetensors                    0.68 GB   VAE
К вечеру первого дня сообщество уже выложило кванты поменьше: int4-версия DiT на 3.67 ГБ (toxicdog/Qwen-Image-2.1-INT4ConvRot-ComfyUI) и GGUF Q2-Q8 от realrebelai - тех же ребят, которые квантовали LLaDA для моего стека. int4 влезает в VRAM целиком и работает быстрее на холодном старте, но у 4-битного кванта нашлась цена, о ней ниже.
Энкодер в VRAM не помещается - и не должен: ComfyUI с --lowvram держит его в RAM, кодирует промпт, выгружает и отдаёт карту DiT. Промпт кодируется заметно дольше, чем у SDXL, но это разовая цена за кадр.
Рабочий граф
Официальный шаблон ComfyUI разворачивается в простой API-граф, я пересобрал его руками для своих скриптов:
{
  "1": {"class_type": "UNETLoader", "inputs": {"unet_name": "qwen_image_2.1_int8_convrot.safetensors"}},
  "2": {"class_type": "CLIPLoader", "inputs": {"clip_name": "qwen3vl_8b_w4a8.safetensors", "type": "qwen_image"}},
  "3": {"class_type": "VAELoader", "inputs": {"vae_name": "qwen_image_2.1_vae_bf16.safetensors"}},
  "4": {"class_type": "TextEncodeQwenImage21", "inputs": {"clip": ["2", 0], "prompt": "...", "negative_prompt": ""}},
  "6": {"class_type": "KSampler", "inputs": {"model": ["1", 0], "positive": ["4", 0], "negative": ["4", 1],
        "latent_image": ["5", 0], "steps": 25, "cfg": 1.0, "sampler_name": "euler", "scheduler": "simple"}},
  "7": {"class_type": "VAEDecode", "inputs": {"samples": ["6", 0], "vae": ["3", 0]}}
}
Три неочевидности, на которых я споткнулся. Первая: у CLIPLoader нет типа qwen_image_21, новая модель едет на старом типе qwen_image. Вторая: нода TextEncodeQwenImage21 выдаёт сразу positive, negative и пустой латент - отдельный CLIPTextEncode не нужен. Третья: official путь - cfg 1.0 без негатива, negative_prompt при этом заполняется пустой строкой.
Отправка и поллинг - десять строк поверх HTTP API:
import json, time, urllib.request

opener = urllib.request.build_opener(urllib.request.ProxyHandler({}))
res = json.load(opener.open(urllib.request.Request(
    "http://127.0.0.1:8188/prompt",
    data=json.dumps({"prompt": wf}).encode(),
    headers={"Content-Type": "application/json"})))
pid = res["prompt_id"]

while pid not in json.load(opener.open(f"http://127.0.0.1:8188/history/{pid}")):
    time.sleep(10)
Тест 1: текст в кадре
Промпт-детектор для диффузионок: вывеска с заданным текстом. "A neon shop sign that reads "QWEN IMAGE 2.1", rainy night, reflections on wet pavement".
[IMG: https://raw.githubusercontent.com/NikolayGusev-astra/channel-materials/master/2026-09-21-qwen-image-21/images/t2i-neon-int8.png | Neon-вывеска, int8. Текст прочитан верно с первого прогона]
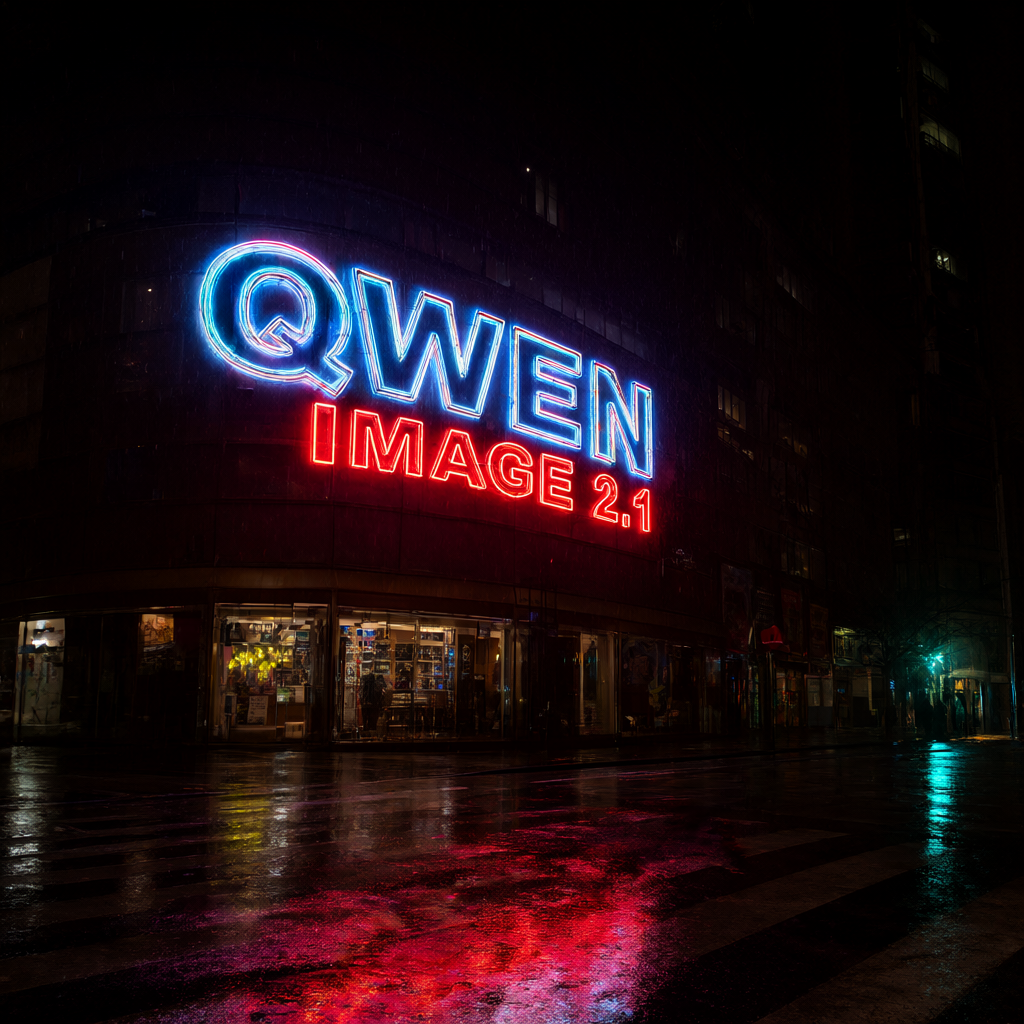
"QWEN IMAGE 2.1" - все буквы на месте, отражения на мокром асфальте, никакого PIL-оверлея поверх. LLaDA в этом же тесте всегда выдавал кашу, у SDXL текст стабильно ломается без лор и вбивания текста отдельной нодой.
Тот же промпт на int4 выдал "OWEN IMAGE 2.1" - Q съела 4-битная квантизация. Скорость при этом одинаковая, около 2 минут на кадр 1024×1024. Вывод простой: если в кадре есть текст, квантование ниже 8 бит не допускаем, выигрыша по скорости оно не даёт.
Тест 2: прозрачный фон
Нативная RGBA-генерация - то, чего в локальном стеке не было совсем. Обёртка промпта официальная:
This is an RGBA format image with transparency. A cute cartoon dragon sticker,
waving, kawaii style. The image has an alpha channel and a transparent background.
[IMG: https://raw.githubusercontent.com/NikolayGusev-astra/channel-materials/master/2026-09-21-qwen-image-21/images/rgba-dragon-checker.png | Стикер дракона на шахматном фоне - прозрачность настоящая]
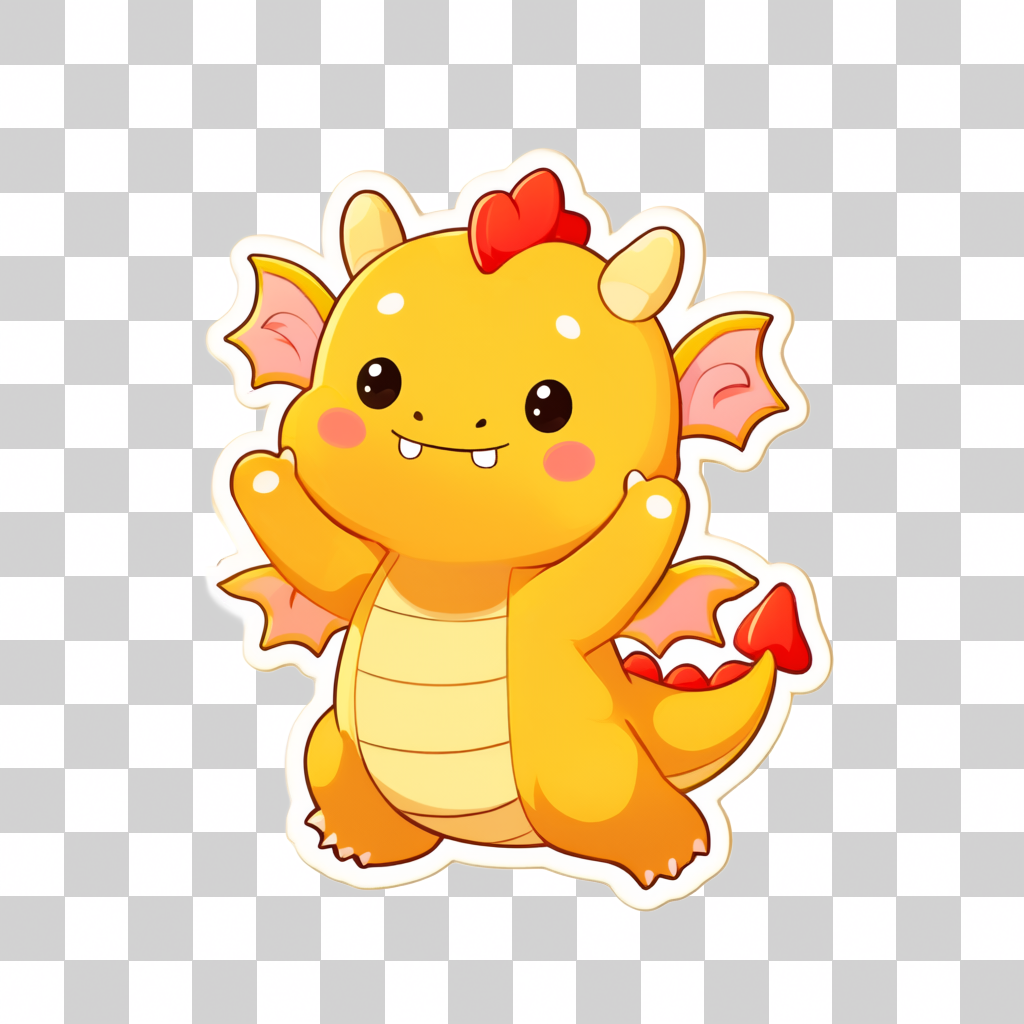
Проверял не глазами, а пикселями: PNG в режиме RGBA, 66.1% полностью прозрачных пикселей, 0.8% полупрозрачных краёв, остальное - дракон. Гладкая обводка, готовый стикер для стикерпака. Для маскотов, стикеров и иллюстраций с вырезанным фоном это экономит целый этап вырезания в редакторе.
Тест 3: редактирование по референсу
Синтетическая сцена (небо, дом, гора, солнце) с инструкцией "Change the background to a sunset beach". За 5.5 минут модель перестроила фон, сохранив объекты: дом и гора переехали в пляжную сцену, вписались в новое освещение.
[IMG: https://raw.githubusercontent.com/NikolayGusev-astra/channel-materials/master/2026-09-21-qwen-image-21/images/edit-before-after.png | Слева исходник, справа результат правки одной строкой промпта]
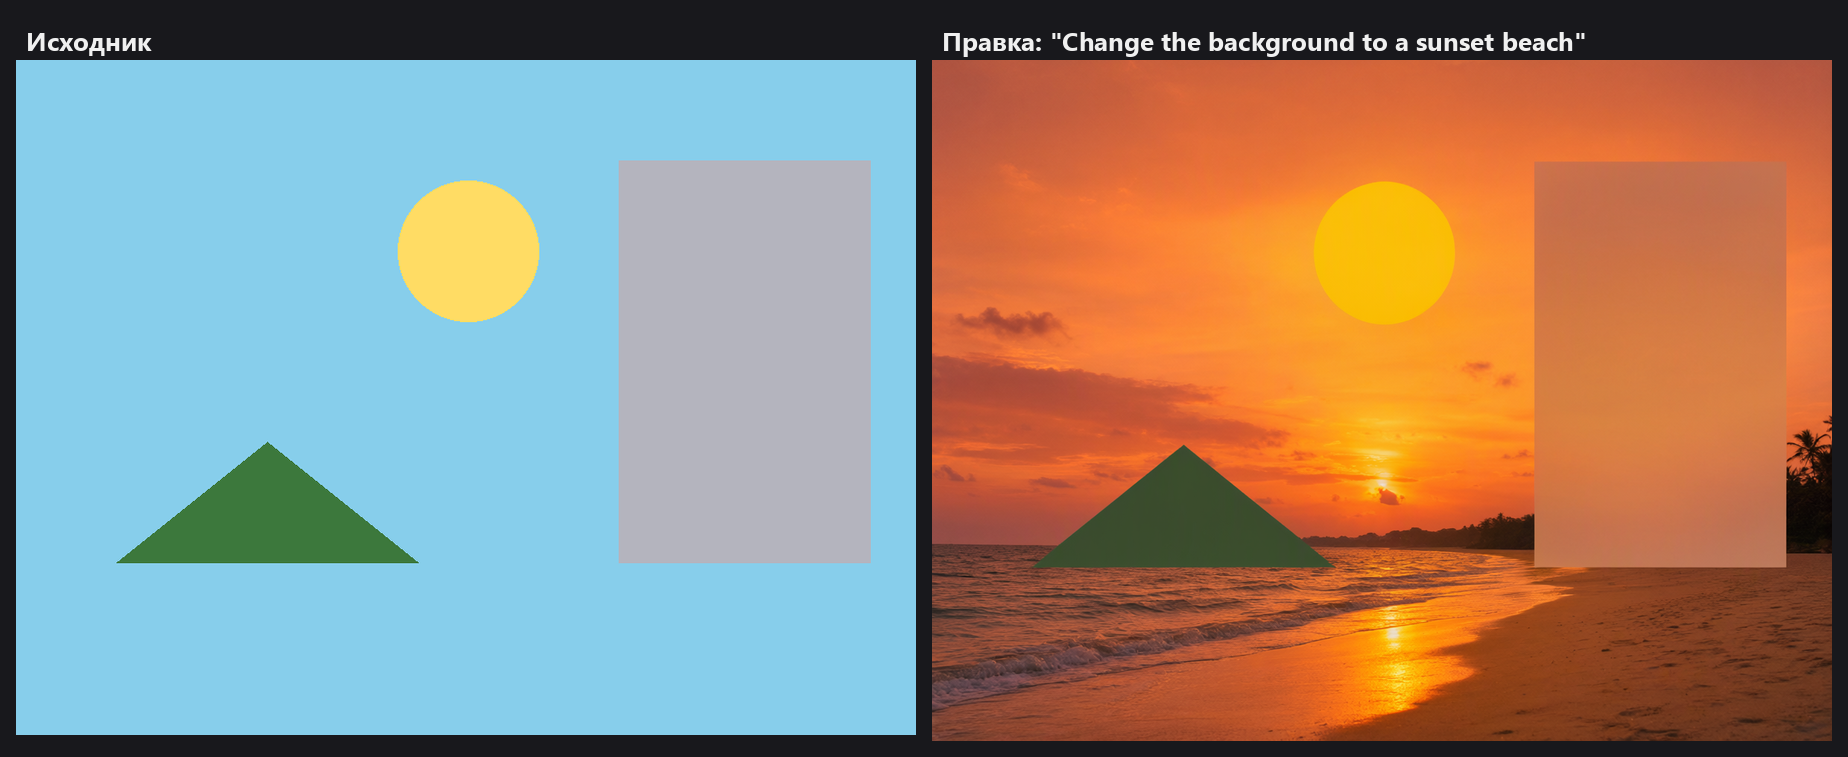
Для сравнения: LLaDA editing на том же железе - 33 минуты на кадр. Не в шесть раз быстрее, а именно что другое время жизни эксперимента: пока LLaDA дорисовывает одну правку, Qwen успевает пять итераций.
Тест 4: персонаж с двух референсов без IP-Adapter
Главная заявленная фича: референсы внутри модели. Промпт-ядро маскота канала (девушка-бармен с фиолетовыми пучками) я дал двумя картинками - канонический портрет и сцену за стойкой - и попросил новую сцену: крыша, ночной неоновый город, коктейль. В стеке Бонуса 4 для этого требовались IP-Adapter, CLIP-Vision и танцы с весами.
[IMG: https://raw.githubusercontent.com/NikolayGusev-astra/channel-materials/master/2026-09-21-qwen-image-21/images/jill-rooftop.png | Два референса и новая сцена: лицо, причёска и жилет держатся]
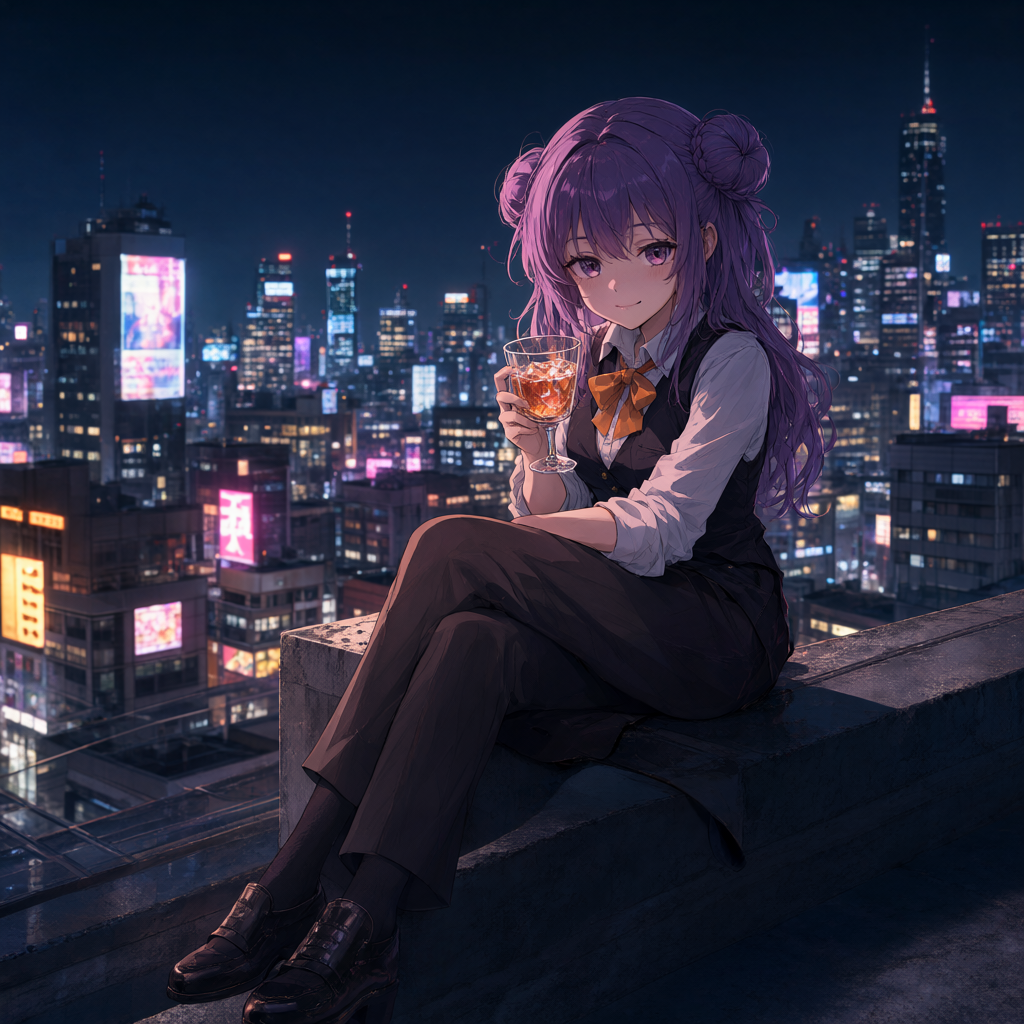
Одно лицо, одна причёска, жилет и рубашка на месте - и это без единой дополнительной модели поверх базовой. Референсы подаются прямо в ноду энкодера: images.image_1, images.image_2, до 16 входов. Внутри модель кодирует референс VAE и подмешивает латент в контекст, тот же механизм работает и на групповых фото из шести портретов, и на трёх ракурсах одного персонажа.
Цена вопроса: было / стало
Замер на RTX 4060 8GB, всё локально, 0 рублей за кадр:
                                Бонус 4 (SDXL+IP-Adapter)   Qwen-Image-2.1
Панель 1024x1024                18-30 сек                   ~120 сек
Текст в кадре                   ломается                    верно (int8)
Прозрачный фон                  нет                         нативный
Правка по инструкции            нет (только inpaint)        5.5 мин
Лицо персонажа в новой сцене    IP-Adapter + CLIP-Vision    референс в промпт
Доп. модели для персонажа       +4.0 GB                     +0 GB
Диск под модель                 6.5-7.1 GB на стиль         14.3 GB весь стек
SDXL остаётся быстрее в режиме "намолотить 50 однотипных панелей без текста". Qwen-Image-2.1 забирает всё, где SDXL ломался: текст, прозрачность, правки, персонаж с референса. Для моего цикла (обложки статей, стикеры маскота, иллюстрации с подписями) перекрытие почти полное, и стек упростился - выкинулся целый слой обвеса.
Ловушки
Энкодер на 6.3 ГБ при забитой RAM уходит в своп, и кодирование промпта растягивается на минуты. Перед батчем проверяю свободную память - правило из Бонуса 4, оно никуда не делось.
Куда дальше
Не проверено и честно отложено: группы из 6+ референсов, трёхракурсные развороты персонажа, локальные правки размазанной кистью (в UI это кружочки поверх картинки), 2K-генерация нативно, PE-редрайтеры на Qwen3.5-VL, которые разворачивают короткий промпт в развёрнутый. Скорость с двумя референсами просела с 2 до 9 минут на кадр - где у батч-серий с референсами проходит предел, покажет следующий замер.
Материалы: workflows, скрипты загрузки и все картинки - в репозитории канала, папка 2026-09-21-qwen-image-21. Предыдущая часть про SDXL-стек: Бонус 4.