
Опубликовано
Суммаризация: MapReduce против Refine на живом замере
Автор: Гусев Николай [портфолио]
Обновлено
Продолжаем читать книжку с самолёта
Вторая часть цикла по книге AI Agents and Applications Роберто Инфанте (Manning, 2026). На этот раз главы 3-4 книги: что делать, когда документ длиннее контекстного окна. (Для порядка: первая часть цикла разбирала главы 1-2 книги, нумерация цикла - это выпуски, нумерация в строке внизу - главы книги.) В первой части разбирали три класса LLM-систем: движок, чат-бот, агент.
Серия выходит раз в 1-2 дня, пометки: #AI_Agents_and_Applications #глава_2.
Две стратегии склейки: MapReduce и Refine
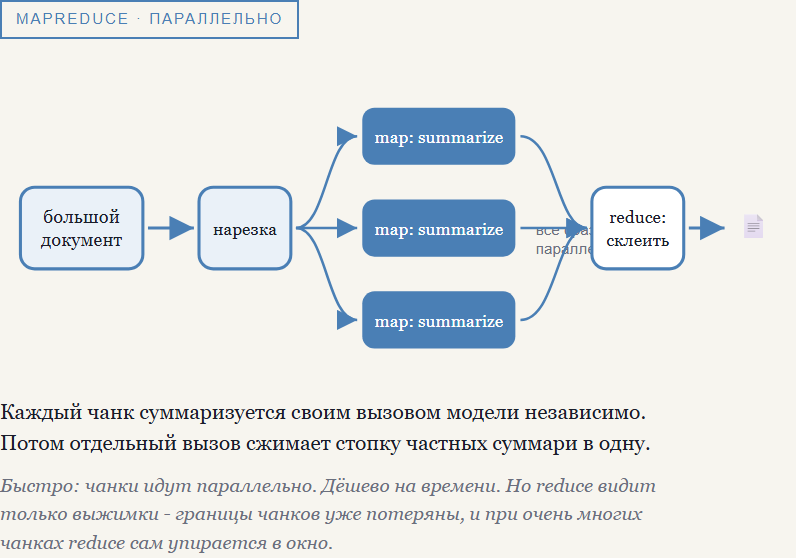
Документ не влезает в окно - его режут на чанки. Дальше вопрос: как из частных выжимок собрать одну?
MapReduce. Каждый чанк суммаризуется своим вызовом модели, все независимо и параллельно. Затем отдельный вызов (reduce) сжимает стопку выжимок в единый текст. Быстро, но границы чанков теряются, а при большом числе чанков reduce сам упирается в контекстное окно.
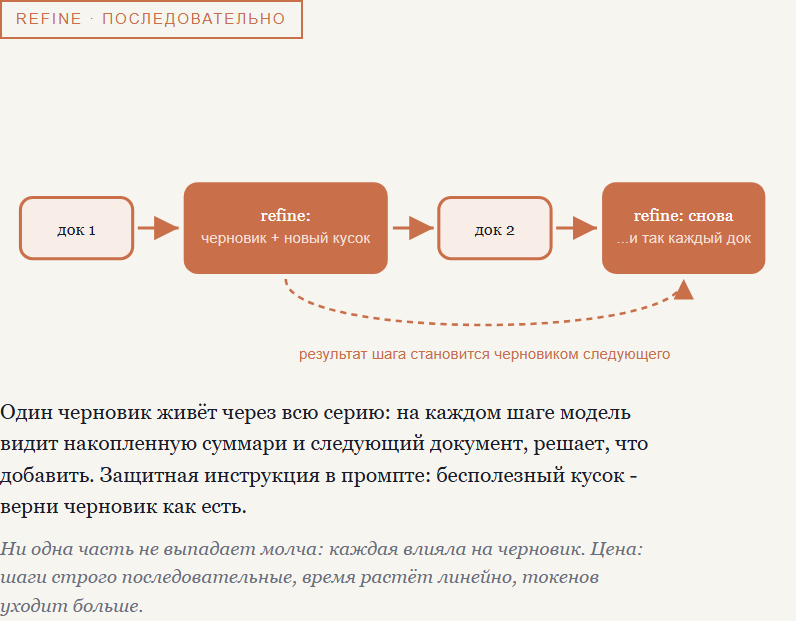
Refine. Один черновик живёт через всю серию: на каждом шаге модель видит накопленное саммари и следующий кусок, решает, что добавить. В промпте защитная инструкция: бесполезный кусок - верни черновик без изменений. Автор книги продаёт refine как способ "ни одна часть не выпадает молча".
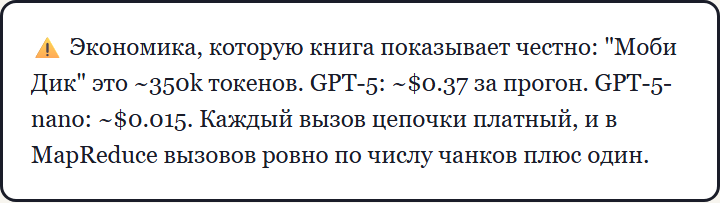
Экономика из книги честная: "Моби Дик" это около 350k токенов, $0.37 за прогон на большой модели и $0.015 на nano. Каждый вызов платный, и в MapReduce вызовов ровно по числу чанков плюс один.
Живой замер: книга против книги
Словам автора я предпочёл цифры. Взял 10 разделов самой книги (~83 тыс. символов, 14 чанков по 6k), yandexgpt-5-lite-8b локально в LM Studio, обеим стратегиям одну задачу: саммари о том, как выбирать модель и программировать промпты. Оба подхода выложены generic-скриптами в репо цикла (mapreduce.py и refine.py, любой OpenAI-совместимый эндпоинт, воспроизведение описано в README каталога) - можешь прогнать на своём документе и своей модели. Цифры: MapReduce 151 секунда и 15 вызовов модели, refine 282 секунды и 14 вызовов, шагов без изменений у refine ноль.
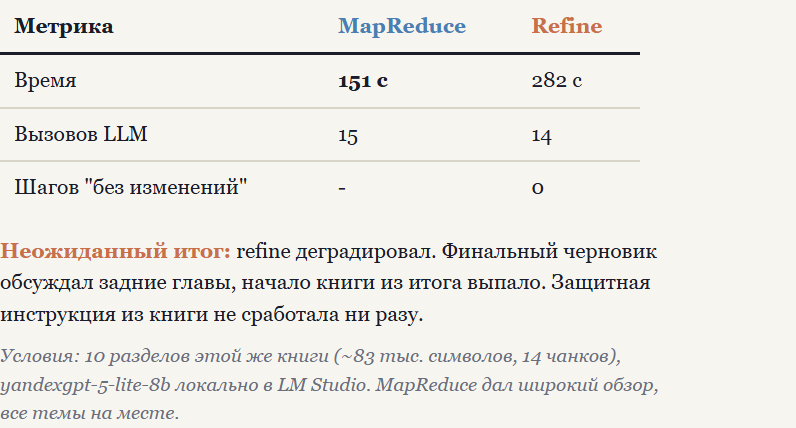
"Заметки на полях". Главная находка: refine деградировал, а не накопил. Финальный черновик обсуждал PromptTemplate и палиндромы из задних глав, а начало книги - три класса систем, RAG - из итога выпало. Механика: черновик рос с конца, и на каждом шаге модель переписывала его под свежий фрагмент вместо дополнения. Защитная инструкция не сработала ни разу: 0 шагов без изменений при исчезнувших ранних темах. Наивный refine, где черновик это весь прошлый ответ, - это не гарантия полноты, а гарантия забывания начала. Чистый recency bias.
MapReduce при этом дал широкий обзор: все главные темы на месте, хоть и обобщённо. Для задачи "обзор большой книги" он оказался лучше и быстрее. Refine без структуры черновика (список тем вместо прозы), без ограничения его длины или без иерархии - брать нельзя.
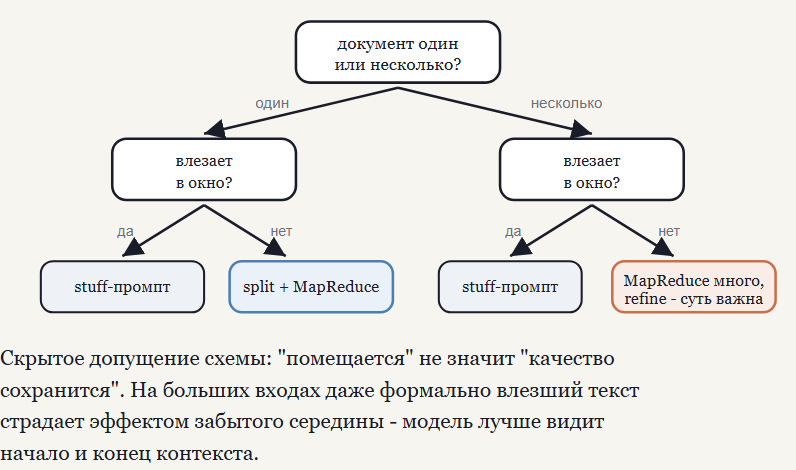
"Заметки на полях". Здесь у меня показательный случай не того выбора. GDrive Summarizer - мой инструмент для тестового задания Tribonian: по публичной папке Google Drive собрать одно сводное саммари. PDF после извлечения текста, сканы через vision-модель, всё по OpenRouter с бесплатными моделями и ретраем на лимитах. Схему я собрал stuff: содержимое каждого файла обрезается до 12 тысяч символов, всё склеивается в один промпт, один вызов модели. На тестовой папке это сработало. Но это именно stuff из блок-схемы выше, а не MapReduce: при реальном наполнении папки один промпт перестанет влезать, и обрезка по 12k молча съест хвосты длинных документов. Правильная доработка - суммаризировать каждый файл отдельно и собирать саммари по частным выжимкам. Код в частном репо, поэтому ссылки не даю.
Второй опыт - не прод, а учебный прогон. В приложении E.6 автор предлагает собрать research-движок из главы 4 и запустить его на локальной модели. Я сделал это на LM Studio: тот же код, только get_llm() смотрит не на OpenAI, а на localhost. Вывод: точность ответов сопоставима с облаком, инференс идёт на домашней RTX 4060 - медленнее облачного API, но бесплатно и без отправки текста наружу. Для разработки и персональных задач этого достаточно; автор книги отдельно советует vLLM для серверного сценария.
Блок-схема выбора
Скрытое допущение схемы: "помещается" не значит "качество сохранится". На больших входах даже формально влезший текст страдает эффектом забытой середины - модель лучше видит начало и конец контекста. Я разбирал это отдельно на живом needle-тесте: 0 попаданий из 7 на середине 30k контекста у малой модели, U-образная кривая внимания. Детали и как это лечится инструментом поиска - в статье "Больше контекста - хуже результат". И наш замер выше это подтверждает с другой стороны: refine в наивной реализации - тот же эффект, но причинённый руками: черновик перезаписывается каждым новым куском, и ранние главы уходят с дальнего края внимания.
Замечание шире: саммаризация контекста вообще опасна для инструкций. Если система работает по правилам, а контекст с ними прошёл через чью-то выжимку - часть правил в выжимке молча умерла. Поэтому в Hermes-подобных системах правила не держат в саммари диалога: они лежат отдельным слоем и подаются целиком.
Критерий, который стоит забрать
Выбор стратегии - это выбор того, что тебе дороже: время или полнота. Но полноту refine даёт только при дисциплине черновика. Без неё ты платишь большим временем и большим числом токенов за саммари, которое помнит только конец. Мой критерий после замера: по умолчанию MapReduce; refine - когда у каждой части есть самостоятельная ценность и черновик структурирован явно.
Вторая половина глав - сборка research-агента: персона под вопрос, генерация нескольких поисковых запросов, скрапинг, суммаризация страниц, отчёт. Вся "параллелизация" там - это .map() над списками. Что книга замалчивает: ошибки скрапинга превращаются в текст и уходят в модель как факты, дедупликация URL отдана промпту, метрик качества ноль.
Продолжение - глава 5, LangGraph: от цепочек к графам, состояние и условные переходы.
Книга: AI Agents and Applications (Roberto Infante, Manning, 2026), главы 3-4.
#AI_Agents_and_Applications #глава_2