Опубликовано
YandexGPT-5-Lite-8B как генератор над выдачей: третья часть цикла про домашний Perplexity
Автор: Гусев Николай [портфолио]
Обновлено
Темы: llm, rag, local-models
Сложность: средняя
Третья часть: зачем нам ещё одна модель
В первой части цикла я собрал добычу: SearXNG ищет, Camoufox достаёт контент из-под антибота. Во второй - сравнил пять локальных моделей над грязной поисковой выдачей: быстрый qwen3.8 отвечал за сто секунд, LFM2.5 на 32 тысячах контекста честно отказывался натягивать несуществующие связи. Победили универсалы - модели, которые одинаково среднего кодят, рассуждают и резюмируют.
Но у меня оставался вопрос. Весь мой корпус - русский: база знаний по инфраструктуре, документация, поисковая выдача на русском. Универсальные модели всё это читают через переводной токенизатор, собирая русские слова из кусков. А если взять модель, которую русскоязычный корпус учили с нуля?
Сравнение плотности токенизации на одном и том же русском тексте (356 символов):
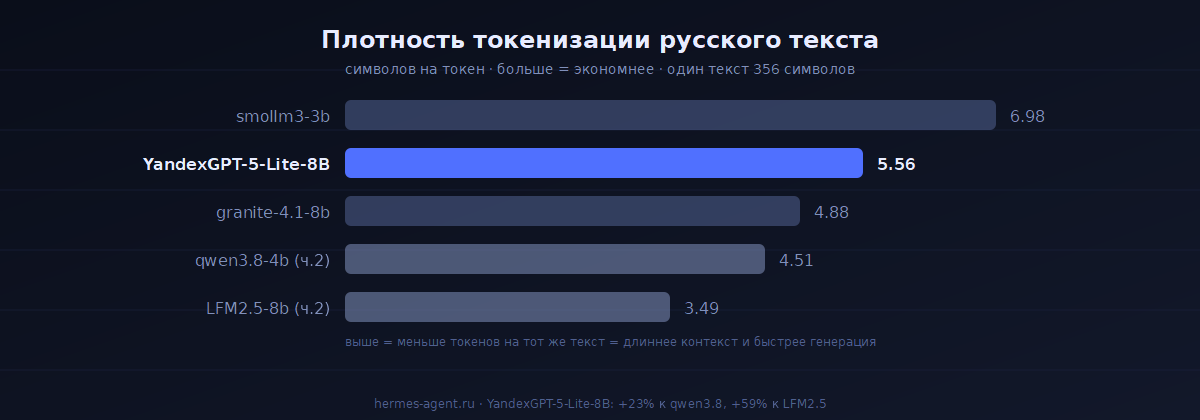
smollm3 формально плотнее, но на английском YandexGPT не проигрывает никому, а вот против участников второй части выигрыш заметный: qwen3.8 тратит на тот же русский текст на 23% больше токенов, LFM2.5 - на 59%. Меньше токенов = больше контекста в те же 32k и быстрее генерация. Плотность - не главное достоинство, но приятный бонус нативного инструмента.
Для проверки взял YandexGPT-5-Lite-8B-instruct и прогнал через оба пайплайна из прошлых частей: локальный RAG по базе знаний и ответчик над веб-выдачей. Главный вывод: самое ценное в этой модели не то, как она отвечает, а то, как она отказывается отвечать.
Серия "Домашний Perplexity"
- Часть 1: Как собрать свой домашний Perplexity на нулевом бюджете - добыча: SearXNG, Camoufox, computer_use против капчи
- Часть 2: Кто думает над выдачей - сравнение пяти локальных моделей над грязным контекстом
Роль генератора в пайплайне
Агентская схема работает так: retrieval собирает чанки, специализированная модель формулирует по ним ответ, а главная модель агента обрабатывает результат - проверяет, дополняет, решает, что делать дальше. Лёгкий генератор в этой схеме - расходник: он делает дешёвую механическую работу "превратить чанки в связный текст с цитатами", не тратя контекст и токены дорогой основной модели.
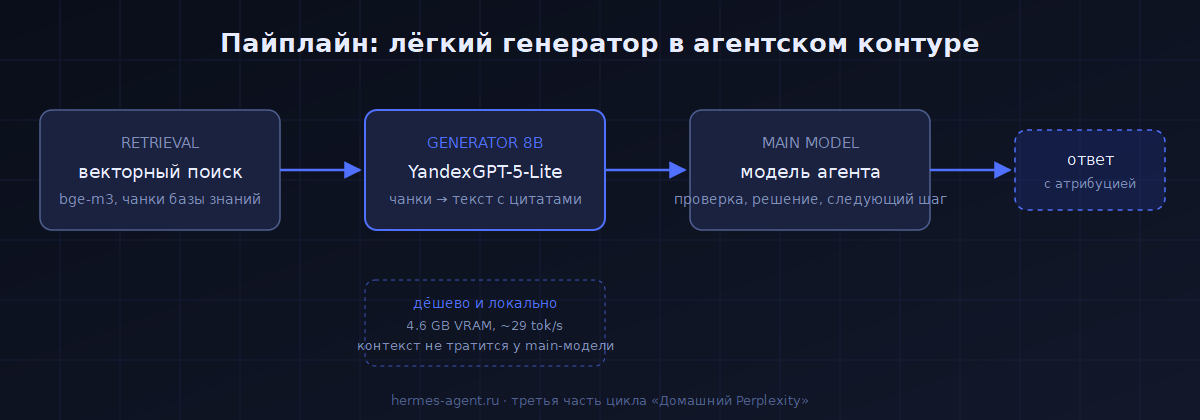
Схема элементарная:
запрос → retrieval (поиск чанков) → контекст с номерами → LLM → ответ с цитатами
Retrieval отвечает за "найти релевантное". Генератор - за "сформулировать ответ строго по найденному". Это разные компетенции, и для второй нужна instruct-модель: base-модель без дообучения продолжит текст вместо ответа на вопрос,_instruction-tuned - поймёт систему ролей и будет держать формат.
Почему YandexGPT-5-Lite-8B-instruct:
- 8B параметров, квант Q4_K_M весит 4.6 GB - целиком влезает в 8 GB VRAM обычной игровой карты (RTX 4060)
- около 29 токенов/сек на этой карте
- контекст 32k - топ-10 чанков с запасом
- сильный русский - для локальной базы знаний на русском это решающий фактор
- официальный GGUF от Яндекса, есть в LM Studio из коробки
- лицензия: коммерческое использование до 10 млн исходящих токенов в месяц, дальше - API в Yandex Cloud
Не путать с новой линейкой Яндекса: осенью 2026 они выпустили AliceAI-Foundation-80B-A3B и Alice AI Search Pretrain - это другие, серверные модели. Foundation 80B в Q4 весит около 45 GB, для домашней карты не предназначен. Для персонального RAG 8B - рабочая точка.
Подключение за пять минут
Качаем GGUF, кладём в папку моделей LM Studio, загружаем. Дальше - обычный OpenAI-совместимый API на localhost:1234. Единственная ловушка на этом пути: если в системе прописан корпоративный прокси, он перехватит и localhost, и вы получите 502 Bad Gateway на запрос к собственной машине. Лечится пустым ProxyHandler:
import json, urllib.request

# пустой ProxyHandler - обход системного прокси
opener = urllib.request.build_opener(urllib.request.ProxyHandler({}))

def llm(messages, max_tokens=700):
    req = urllib.request.Request(
        "http://127.0.0.1:1234/v1/chat/completions",
        data=json.dumps({
            "model": "yandexgpt-5-lite-8b-instruct",
            "messages": messages,
            "temperature": 0.3,
            "max_tokens": max_tokens,
        }).encode(),
        headers={"Content-Type": "application/json"},
    )
    with opener.open(req, timeout=240) as r:
        d = json.loads(r.read())
    return d["choices"][0]["message"]["content"], d["usage"]
Пара слов о темплейте. У модели нестандартный формат диалога - реплика генерируется после маркера "Ассистент:[SEP]", переводы строк кодируются особым токеном. Через OpenAI-совместимый endpoint LM Studio всё это обёрнуто автоматически, руками ничего править не надо. Это стало бы проблемой только при прямом запуске через llama.cpp.
Пайплайн 1: RAG-ответчик
Формула простая: ретрив отдаёт чанки, мы нумеруем их и складываем в контекст, модель отвечает со ссылками.
def rag_answer(query, chunks):
    context = "\n\n".join(
        f"### Источник {i+1}\n{c}" for i, c in enumerate(chunks)
    )
    messages = [
        {"role": "system", "content":
         "Ты отвечаешь на вопросы по документации, используя ТОЛЬКО "
         "приведённый контекст. Указывай номера источников. Если ответа "
         "в контексте нет - скажи об этом прямо."},
        {"role": "user", "content": f"Контекст:\n{context}\n\nВопрос: {query}"},
    ]
    return llm(messages)
Живой пример из моего прогона. Вопрос: как переустановить некорректно настроенную реплику домена. Ретрив нашёл два чанка из базы знаний, ответ модели:
Чтобы переустановить некорректно настроенную реплику, выполните:
1. Удалите реплику и выйдите из домена (astra-freeipa-server -U,
   astra-freeipa-client -U).
2. Удалите пакеты: sudo apt purge 'aldpro*' 'freeipa*' 'sssd*' ...
3. Проверьте список профилей в домашнем каталоге.
4. Повторно введите реплику в домен.
Источник: [1]
193 prompt-токена, 6.5 секунды. Атрибуция на месте, шаги по делу.
Пайплайн 2: ответчик над веб-выдачей
Тот же принцип, но retrieval заменён на веб-поиск. Мини-Perplexity на локальной модели:
def search_answer(question):
    hits = web_search(question, limit=4)["data"]["web"]
    pages = web_extract([h["url"] for h in hits[:2]], char_limit=2500)
    parts = [
        f"[{i}] {p.get('title','')}\n{(p.get('content') or '')[:2200]}"
        for i, p in enumerate(pages["results"], 1)
    ]
    messages = [
        {"role": "system", "content":
         "Ты отвечаешь на вопрос по приведённым материалам. Указывай "
         "номера источников в квадратных скобках. Если данных "
         "недостаточно - так и скажи."},
        {"role": "user", "content":
         "Материалы:\n" + "\n\n".join(parts) + f"\n\nВопрос: {question}"},
    ]
    return llm(messages)
Реальный прогон: "как включить отладку регулярных выражений в Python". Поиск нашёл статью, extract вытащил текст, ответ:
Чтобы включить отладку регулярных выражений в Python, нужно
использовать флаг `re.DEBUG` в методе `re.compile` [1].
722 prompt-токена, 1.2 секунды генерации.
Восемь тестов на честность
Теперь главное. Я собрал восемь сценариев, где правильное поведение генератора разное: полный ответ, частичный ответ или отказ. Результаты живых прогонов:
Тест                                    | Результат                      | Метрики
----------------------------------------|--------------------------------|-------------
RAG: поиск по базе, ответ существует    | полный ответ + атрибуция [1]   | 193 tok, 6.5s
RAG: вопроса в контексте нет            | честный отказ                  | 11.8s
RAG: веб-добыча + поиск, ответ есть     | пошаговая инструкция + ссылка  | 193 tok, 6.5s
Web: выдача без ответа (FreeRDP)        | отказ: "нет информации"        | 488 tok, 5.3s
Web: сниппеты дают версию без деталей   | версия названа, детали - отказ | 435 tok, 1.6s
Web: статья НЕ про тот вопрос           | отказ - поймала нерелевантность| 868 tok, 1.1s
Web+extract: релевантная статья         | точный ответ + [1]             | 722 tok, 1.2s
Контраст: противоречивые источники      | хронология, конфликт показан   | 1.4s
Разберу два показательных случая.
Нерелевантная выдача. Искал "фичи Python 3.14", поиск вернул статью про полезные фичи Python вообще - похоже, но не то. Модель не притянула материал за уши:
В предоставленных материалах нет информации о ключевых
особенностях Python версии 3.14 [1][2].
Противоречивые источники. Подал два блока: "релиз 15 марта" и "перенесён на апрель из-за сертификации". Ответ:
Версия X.Y была запланирована к выходу на 15 марта 2027 года,
однако позже выход был перенесён на апрель 2027 года из-за
проблем с сертификацией [1], [2].
Хронология восстановлена, конфликт не замолчан, обе ссылки на месте.
Почему это важно. RAG-генератор, который выдумывает, опаснее, чем его отсутствие: пользователь получает уверенный текст со ссылкой на источник, которого не существует. Модель, которая говорит "в контексте этого нет", заставляет пайплайн честно сказать "не нашёл" - и это правильное поведение для ответчика над базой знаний. Из восьми тестов модель ни разу не сгаллюцинировала факт сверх контекста.
Отсюда правило: ответственность за релевантность - на retrieval, не на генератор. Если поиск вернул шум, модель откажется отвечать - и правильно сделает. Улучшать надо поиск, а не промпт.
Скорость зависит от длины контекста: ответы на 200-700 prompt-токенах занимают 1-6 секунд, а с 900 токенами и большим max_tokens - до 12. Для интерактивного чат-бота нормально, для батч-обработки - закладывайте очередь.
Лицензия разрешает коммерческое использование до 10 млн исходящих токенов в месяц. Для внутреннего инструмента на команду - с запасом, для публичного сервиса - считайте экономику или берите API.
Где это применять
Годится: внутренние базы знаний, персональный "Perplexity" над вебом, ответчик в чат-боте по документации, суммаризация найденного.
Не годится: агентные сценарии с вызовом инструментов (function calling у модели есть, но после дообучения слабый), многошаговое планирование, сложный код - там нужны модели классом выше, а 8B - это про другое: дешёвый, быстрый, честный генератор текста по контексту.
Формула простая: эмбеддинги находят, генератор отвечает. Остальное - детали реализации.
UPD от 23 сентября: восемь тестов - это ещё не всё
После публикации я прогнал модель через жёсткий бенч - тот же протокол, по которому в части 2 выбирал qwen3.8: грязный контекст (поисковая выдача про FISA и PRISM, разбавленная чанками про борщ, игровые ноутбуки и русский балет) плюс вишенка - кусок чувашской Википедии, чтобы было кросс-язычное мясо.
Скорость - восторг. Фундаментальный вопрос YandexGPT отвечает за 9.5 секунд против 37 у qwen3.8, на серии из десяти одинаковых запросов - 3.7 секунды на итерацию против 4.6. Ловушка дат, на которой я ловил модели в части 2 (PRISM: создана в 2007 или раскрыта в 2013?), проходит красиво: "начала работу в 2007 году [11]. До июня 2013 года существование программы было засекречено [5]". Обе даты, обе роли, не перепутала.
А потом я задал вопрос: "Кто был директором NSA при создании программы PRISM?"
В контексте был чувашский текст: "директор национальной разведки США Джеймс Клеппер подтвердил существование PRISM" (в 2013-м). Модель перевела его и уверенно ответила: "Директором Агентства национальной безопасности при создании программы PRISM был Джеймс Клеппер". Две ошибки в одном предложении: Клеппер был директором национальной разведки, а не NSA, и подтвердил программу через шесть лет после её создания.
Самое забавное - воспроизводимость. Десять прогонов, две температуры - ответ слово в слово одинаковый. Это не случайный сбой, а стабильный систематический дефект. Я попробовал вылечить промптом: добавил в систему "проверяй факты из вопроса по материалам", потом полный chain-of-verification с принудительной выпиской фактов. Модель честно выписала: "факт подтверждается источником [5]: директор национальной разведки США Джеймс Клеппер сообщил о программе" - и следующим предложением снова выдала "директором NSA при создании". Верификация выполняется, вывод следует за ложной посылкой вопроса. Восьмимиллиардная модель слышит вопрос сильнее, чем собственную проверку.
Для контроля прогнал тот же вопрос через LFM2.5 из второй части - та же история, плюс её рассуждения показывают, что противоречия она просто не заметила.
Что в итоге выбрал. В perplexity-fast qwen3.8 остаётся генератором по умолчанию: ноль галлюцинаций на этом бенче против одной у YandexGPT. YandexGPT прописал как альтернативу для чисто русскоязычных запросов с одноязычным контекстом - там её плотный токенизатор и скорость в четыре раза дают честное преимущество. Кросс-язычная выдача или вопрос, звучащий как наводящий, - только qwen3.8. В perplexity-deep ничего не менял: LFM2.5 со своим thinking живёт в другой нише, и пятикратная разница в цене итерации - цена за рассуждения, а не за генерацию.
Мораль бенча: "восьмой тест на честность" из основной статьи проверял, что модель не выдумывает факты из воздуха. А у leading question - вопроса со встроенной ложной посылкой - другая механика: модель не выдумывает, она принимает посылку как данность и подтягивает к ней ближайшее имя из контекста. От этого не защищена ни одна из трёх моих генераторов. Лечится не промптом, а архитектурой: факт-чек ответов отдельным проходом - и это хорошая тема для следующей части.