Хаб курсов / LLM Inference Systems / глава 10
Модуль 10: Дистрибуция и спекулятивный декодинг
Tensor и pipeline parallel, арифметика из How to Scale Your Model, спекулятивный декодинг и MTP.
LLM Inference Systems. Модуль 10: Дистрибуция и спекулятивный декодинг
Одна GPU перестаёт быть единицей измерения, как только модель перестаёт в неё влезать или перестаёт насыщать её память. Этот модуль — про то, как разрезать модель на несколько устройств так, чтобы каждый байт пересылки был оправдан, и как потом вернуть обратно потерянную латентность спекулятивным декодингом.
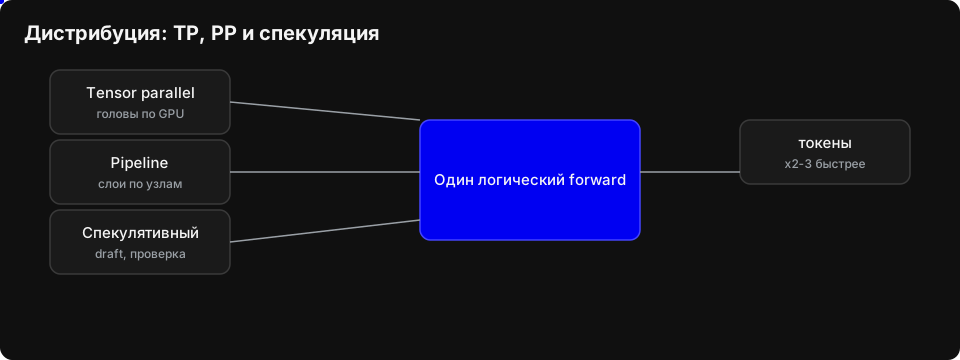
Первая половина модуля — чистая арифметика распределения: сколько весит тензор, сколько стоит all-reduce, почему tensor parallel живёт только внутри NVLink-домена, а pipeline parallel переживает Ethernet, и почему expert parallel существует ровно для одного класса моделей. Вторая половина — спекулятивное декодирование: как маленькая модель или дополнительные головы превращают memory-bound декодинг в compute-bound и сколько это даёт в токенах в секунду.
10.1 Сколько на самом деле нужно памяти и FLOPs
Прежде чем что-то резать, надо посчитать три величины: вес модели, KV-кэш и потолок декодинга по пропускной способности памяти. Все три считаются в уме, и все три определяют выбор параллелизма.
Веса
Байты на параметр по типам:
| Формат | Байт/параметр | 0.6B | 8B | 70B | 405B |
|---|---|---|---|---|---|
| fp32 | 4 | 2.4 ГБ | 32 ГБ | 280 ГБ | 1.6 ТБ |
| bf16/fp16 | 2 | 1.2 ГБ | 16 ГБ | 140 ГБ | 810 ГБ |
| int8 (W8) | 1 | 0.6 ГБ | 8 ГБ | 70 ГБ | 405 ГБ |
| int4 (W4) | 0.5 | 0.3 ГБ | 4 ГБ | 35 ГБ | 203 ГБ |
H100 SXM имеет 80 ГБ HBM3. Отсюда сразу: 70B в fp16 — это 140 ГБ, то есть минимум две карты, а с запасом под KV-кэш и активации — четыре. 405B в fp16 — минимум 11 карт, реально 16–32.
KV-кэш
\text{KV bytes} = 2 \cdot L \cdot n_{kv} \cdot d_{head} \cdot S \cdot b \cdot \text{bytes\_per\_elem}
Двойка — это K и V. L — число слоёв, n_{kv} — число KV-голов (после GQA), d_{head} — размер головы, S — длина контекста, b — размер батча.
| Модель | L | n_{kv} | d_{head} | KV на токен (fp16) |
|---|---|---|---|---|
| Qwen3-0.6B | 28 | 8 | 128 | 114 688 Б = 112 КиБ |
| Llama-3-8B | 32 | 8 | 128 | 131 072 Б = 128 КиБ |
| Qwen3-30B-A3B | 48 | 4 | 128 | 98 304 Б = 96 КиБ |
| Llama-3-70B | 80 | 8 | 128 | 327 680 Б = 320 КиБ |
Qwen3-0.6B на контексте 32k: 112 \text{ КиБ} \times 32768 = 3.67 ГБ — в три раза больше весов модели (1.2 ГБ). Для маленьких моделей KV-кэш доминирует, для больших — нет: у 70B вес 140 ГБ, и KV догонит его только при 140 \cdot 10^9 / 327\,680 \approx 427 тысячах токенов в батче. Это фундаментальная асимметрия: маленькие модели упираются в KV и требу
...ют квантования KV-кэша раньше, чем квантования весов, и агрессивного PagedAttention; большие — упираются в вес и требуют параллелизма.
Третья величина — потолок декодинга:
\text{tokens/s} \le \frac{\text{BW}_{\text{HBM}}}{N \cdot \text{bytes\_per\_param}}
Для 8B в bf16 на H100: 3.35 \cdot 10^{12} / (8 \cdot 10^9 \cdot 2) \approx 209 токенов/с при батче 1. Реально получают 100–150 — остальное съедают чтение KV-кэша, ядра нормализации и накладные расходы сэмплинга. Эта формула — отправная точка: всё дальнейшее в модуле либо поднимает числитель (больше карт, больше HBM), либо снижает знаменатель (квантование, спекуляция).
10.2 Tensor parallelism: режем матмулы по головам
TP не делит модель по слоям — он делит каждый слой. В attention матрица QKV режется по головам (карта получает d_model/p голов и свою часть W_q, W_k, W_v), выходная проекция W_o — по столбцам; в FFN W_gate/W_up режутся по столбцам, W_down — по строкам. Каждый GPU считает свой кусок, но чтобы получить полный вектор активаций, нужен all-reduce: после attention-блока и после FFN. Ровно 2 all-reduce на слой, и каждый прогоняет по интерконнекту полный тензор [batch, d_model] в bf16.
Объём одного ring-all-reduce: V = 2·(p−1)/p · B·d·s, где s = 2 байта. Для p = 4 коэффициент равен 1.5.
Считаем. B = 8, d = 4096: B·d·s = 64 КиБ. Один all-reduce — 96 КиБ, на слой 192 КиБ, на 32 слоя — 6 МиБ на токен. PCIe 4.0 x16: 32 ГБ/с по спецификации, ~25 реально → 0.24 мс; NVLink 900 ГБ/с → ~7 мкс, разница в 35 раз. Плюс латентность: 64 коллектива на токен по ~10 мкс дают пол в 0.6 мс, не зависящий от объёма.
И это лучший случай. На батче 128 объём уже ~96 МиБ на токен (~0.1 ГБ); для 70B (d = 8192, 80 слоёв) — около 0.5 ГиБ на токен: на PCIe это ~20 мс только на обмен, потолок ~50 ток/с на 4 картах, на NVLink — 0.5 мс. Отсюда и смерть TP по PCIe: он живёт в latency-режиме (B = 1..8, один узел); как только включается throughput-батч или вы уходите на межнодовый Ethernet, обмен съедает всё.
Минимальный размер шарда. Считать надо не объём, а отношение t_math/t_comm — арифметическую интенсивность. Для матмула [B×K]·[K×N/p]: FLOPs = 2·B·K·N/p, байт обмена = 4·B·N·(p−1)/p, интенсивность = K/(2(p−1)) FLOP/байт — от N и B не зависит. Машина требует F/BW: NVLink — 300 TFLOPS / 900 ГБ/с ≈ 0.33, PCIe — 300/25 = 12. То есть на PCIe нужно K > 24(p−1) ≈ 72 при p=4: для prefill с K = 4096 выполняется с запасом, а в decode каждое весовое число читается один раз, эффективная интенсивность ~2 FLOP/байт — и обмен доминирует. Практический критерий: 2·B·K·N/(p·F) > L + V/BW. При L ≈ 10 мкс на PCIe это требует ≥3 ГФЛОП на шард; в decode с B = 1 столько нет ни у одного слоя — отсюда те самые 0.6 мс простоя на токен.
10.3 Pipeline parallelism: модель по слоям
PP режет модель не по тензорам, а по слоям: стадия 0 — слои 0..k, стадия 1 — k+1..2k, и так до p стадий, каждая на своём узле. Внутри стадии всё считается целиком, наружу уходит только граница: тензор [B, d] в bf16 — 64 КиБ при B = 8, d = 4096. По сравнению с TP это на порядки меньше трафика: TP гоняет мегабайты на слой, PP — килобайты на стадию.
Плата — пузырь. Пока стадия 0 считает первый микробатч, стадии 1..p−1 простаивают; хвост симметричен. Доля простоя при m микробатчах: bubble = (p−1)/(m+p−1). Пример: p = 8, m = 32 → 7/39 ≈ 18%. Чтобы уронить до 5%, нужно m ≈ 130+, а это память под активации.
Схемы. GPipe: все forward, потом все backward — пузырь тот же, память O(m). 1F1B (PipeDream): стадия держит в полёте ровно p микробатчей, чередуя forward и backward — память падает до O(p) при том же пузыре. Interleaved (Megatron): карта получает v виртуальных стадий, пузырь (p−1)/(m·v+p−1) — при v = 2, m = 32 это 7/71 ≈ 10%. Пузырь сокращается, но не исчезает: зависимость по данным между стадиями убрать нельзя, простой можно только заполнить чужой работой.
Где PP живёт. Ровно там, где TP невозможен: между узлами с Ethernet/RoCE (25–100 Гбит/с = 3–12 ГБ/с), на разнородном железе, на коммутаторах без all-reduce. TP требует связности класса NVLink, PP — только point-to-point и сотни килобайт на границу. Отсюда стандарт больших кластеров: TP внутри узла (NVLink, p = 8), PP между узлами. Цена — пузырь плюс задержка на хоп, которая в decode добавляется к каждому токену: 7 хопов по ~0.2 мс — это ~1.4 мс латентности на токен, и она не размывается батчом.
Предостережение: TCP — не функциональный fallback для тяжёлых PD-профилей. Классическое допущение «если нет IB/RoCE — положим KV-транспорт на обычный Ethernet/TCP, будет медленнее, но работать» опровергнуто замерами на PD-дизагрегации MiniMax-M3 (2 узла × 8 B200, sglang, 268 прогонов): RDMA/IB с GPUDirect дал медианный TTFT ниже в 5.4–11.5× и output throughput выше в 2.8–3.8× против TCP/Ethernet. При этом TCP отказал в 31 из 75 прогонов (41%), IB — ни разу. Узкое место — не полоса: TCP использовал максимум 8.7 из 200 Гбит/с, а разница объясняется host staging против zero-copy GPUDirect. То есть дело не в «медленно», а в «нестабильно и с провалами»: для тяжёлых PD-профилей (длинные промпты, большие KV-блоки) TCP-транспорт не деградирует плавно, а отваливается. Методология этих прогонов (4 уровня наблюдения, 268 запусков) разобрана в модуле 16.
10.4 Expert parallelism: параллелизм, который не ускоряет токен
MoE заменяет один FFN на E экспертов и роутер, который на каждый токен выбирает top-k. Из этого сразу следует раздвоение параметров: total (все эксперты, лежат в памяти) и active (то, что реально считается на токен).
| Модель | Total | Active | Экспертов | top-k | MoE-слоёв |
|---|---|---|---|---|---|
| Mixtral 8x7B | 46.7B | 12.9B | 8 | 2 | 32 |
| Qwen3-30B-A3B | 30.5B | 3.3B | 128 | 8 | 48 |
| Qwen3-235B-A22B | 235B | 22B | 128 | 8 | 94 |
| DeepSeek-V3 | 671B | 37B | 256 + 1 shared | 8 | 58 |
Гибридные архитектуры ломают картину «EP поверх однородных слоёв». Вся арифметика выше предполагает, что MoE-слои однородны и каждый несёт свой all-to-all. Новое поколение гибридов нарушает это: Qwen3.8-27B — это 48 слоёв линейного Gated DeltaNet и 16 слоёв Gated Attention в пропорции 3:1, то есть KV-кэш живёт только на 16 слоях из 64, а all-to-all нужен только на MoE-частях. EP-раскладка такого кластера считается не «слои ÷ узлы», а отдельно для каждой компоненты: где держать KV attention-слоёв, где — экспертов DeltaNet-слоёв, и как балансировать роутер, когда expert-блоки встречаются не в каждом слое.
DeepInfer: открытый EP-движок с узкой зоной применимости. 20.10.2026 DeepSeek открыл репозиторий production-движка DeepInfer (лицензия Apache 2.0), реализующего MoE dispatch/combine — но с оговорками, о которых надо знать заранее. Во-первых, EP дан без планировщика: балансировка нагрузки, KV-кэш менеджмент и PD-disaggregation в открытом виде явно не включены — их надо строить поверх. Во-вторых, область применимости узкая: только DeepSeek-V4.1-Flash, только SM100 (Blackwell) и Huawei Ascend 950, только batch-API без HTTP-сервера. Экономика в цифрах самого DeepSeek (заявление разработчиков, не независимый замер): 155 трлн токенов/день на кластер, ~38 USD выручки на GPU-час в off-peak. Полная информация — в официальном репозитории DeepInfer.
Разрыв между total и active — это и есть смысл существования EP. 671B в fp8 — 671 ГБ, то есть минимум 9 карт по 80 ГБ только под веса; но FLOPs на токен соответствуют 37B-модели. Ни TP, ни PP такого не дают.
Ключевое различие с TP. Tensor parallel режет один и тот же matmul на G карт: каждая считает 1/G столбцов, латентность шага падает почти в G раз (пока не задавит all-reduce), память падает в G раз. Expert parallel режет множество экспертов: каждая карта держит E/G экспертов, но токен по-прежнему проходит через k экспертов и считается с той же стоимостью. Память на карту падает в G раз, латентность на токен не меняется вообще. EP покупает ёмкость и суммарную пропускную способность кластера, а не скорость одного запроса.
Отсюда и профиль применения: EP включают, когда модель не влезает, а батч большой — тогда фиксированная латентность шага размазывается по сотням последовательностей.
Налог — all-to-all. Каждый MoE-слой отправляет скрытое состояние токена k экспертам и получает k ответов:
\text{bytes/token/layer} = 2 \cdot k \cdot d_{model} \cdot \text{bytes\_per\_elem}
Для DeepSeek-V3 (d=7168, k=8, bf16): 2 \cdot 8 \cdot 7168 \cdot 2 = 229 КБ на токен на слой; на 58 слоях — 13.3 МБ на токен. При шаге в 128 токенов и EP-степени 64 это \approx 26 МБ на карту за шаг. При 400 Гбит/с IB (50 ГБ/с) — полмиллисекунды только на пересылку, то есть сопоставимо со временем самого шага. Именно поэтому EP не «переживает Ethernet» так же легко, как PP: all-to-all нужно либо целиком держать в NVLink-домене (EP \le 8), либо перекрывать с вычислениями.
Отсюда стандартная раскладка больших MoE-кластеров:
- TP = 8 внутри узла (attention + плотные части),
- EP = число узлов (эксперты),
- DP по оставшейся оси,
- all-to-all реализован low-latency ядрами (DeepEP, NVSHMEM) и запускается асинхронно, перекрываясь с GEMM предыдущего слоя.
Дисбаланс. Роутер обучаемый, и распределение токенов по экспертам неравномерное: на шаге с кодом и на шаге с математикой горячими оказываются разные эксперты. Время шага определяется самым загруженным экспертом, поэтому утилизация всегда <1. Исторические решения — capacity factor и дроп токенов (GShard, Switch), затем aux loss на балансировку, затем aux-loss-free подход DeepSeek-V3: обучаемая bias-добавка к логитам роутера, которая подстраивается под дисбаланс, не портя основной лосс. Практически dropless-режим с перекосом почти всегда лучше дропа: потерянный токен — это потерянное качество, а лишняя миллисекунда — только деньги.
Почему эксперты делают мелкими. Крупный эксперт — это три матмула d \times d_{ff}, и при E/G экспертах на карте они всё равно собираются в один grouped GEMM. Мелкие эксперты (256 штук по 512–1024 нейронов вместо восьми по 16k) дают куда более тонкую гранулярность маршрутизации: число возможных комбинаций «кто активируется» растёт на порядки, и модель раскладывает разные типы знаний по разным путям, не увеличивая при этом активные параметры. Заодно снимается проблема баланса нагрузки — перекос теперь измеряется не «восемью вёдрами», а сотнями, и пара перегретых экспертов уже не роняет весь батч, а размазывается по общему бюджету токенов. Для expert parallelism это тоже подарок: на каждом устройстве лежит много мелких экспертов, а не один большой, поэтому all-to-all пересылает меньшие куски, а grouped GEMM всё равно склеивает их в плотные матричные умножения. Так что современный EP — это не «разложить восемь экспертов по восьми GPU», а «разложить двести пятьдесят шесть по тридцати двум, сохранив локальность роутинга».
Длинный контекст: ring attention
Ring attention относится к context parallelism: последовательность режется не по слоям и не по головам, а по токенам — устройство i владеет блоком запросов Q_i и соответствующим блоком K/V_i, при этом полный K/V нигде целиком не материализуется. Блоки K/V циркулируют по кольцу из P устройств: на шаге t устройство считает внимание Q_i против пришедшего блока, одновременно асинхронно отправляя свой блок соседу и принимая следующий (isend/irecv в NVSHMEM или NCCL send/recv), так что передача ~O(S/P \cdot d) байт перекрывается вычислением блока — при достаточном размере чанка коммуникация уходит в тень FLOPs, и масштабирование близко к линейному. Поскольку softmax глобальный, партиальные результаты сшиваются online-softmax'ом (running max и running sum, как в FlashAttention), а при каузальной маске блоки, полностью лежащие выше диагонали, пропускаются — отсюда неравномерность загрузки, которую лечат zig-zag/wave-раскладкой блоков по устройствам.
От TP ring attention отличается тем, что TP делит веса и головы внутри слоя и требует all-reduce на каждом слое (нужен NVLink-домен), но длину контекста на устройство почти не уменьшает; PP делит слои и снижает память по глубине, добавляя пузыри конвейера, однако KV-кэш конкретного слоя на устройстве остаётся полным. Ring attention режет именно измерение токенов, поэтому память под KV падает как 1/P и обмен идёт point-to-point по кольцу, что позволяет выходить за пределы одного узла. Он нужен, когда контекст — десятки-сотни тысяч токенов и KV-кэш не влезает: для 70B в fp16 при MHA (80 слоёв, 64 головы, d_{head}=128) это 2 \cdot 80 \cdot 64 \cdot 128 \cdot 2 байт \approx 2{,}5 МиБ на токен, то есть \approx 320 ГБ на 128k токенов (GQA с 8 KV-головами снижает до \approx 40 ГБ, но и тогда 128k на одну карту не помещаются вместе с весами и активациями).
Варианты спекулятивного декодинга
Подходы делятся на два класса: без отдельной draft-модели и с ней. Общий ориентир выигрыша задаёт формула ожидаемого числа принятых токенов за шаг: (1-a^(k+1))/(1-a), где a — accept rate, k — число драфтов. При a=0.7 и k=4 это 2.77 токена/шаг, что с поправкой на затраты верификации (~1.25 шага) даёт ~2.21x реального ускорения. Дальше — способы приблизиться к этому числу.
n-gram / prompt lookup. Draft не генерируется моделью, а ищется поиском совпадений в промпте и уже сгенерированном тексте: последние n токенов → найденное продолжение. Нулевое обучение, минимальный overhead, включается флагом. Хорош там, где текст копируем: код, суммаризация, редактирование, RAG с цитированием. Accept rate прямо зависит от доли копируемых фрагментов; на свободной генерации падает до 0.2–0.3, и ускорение исчезает.
EAGLE и Medusa. Дополнительные головы поверх признаков последнего слоя предсказывают несколько токенов за шаг: Medusa — набор классификаторов, EAGLE — авторегрессивный draft на hidden states, EAGLE-2/3 — динамическое дерево кандидатов и обучение на реальных траекториях. Draft дешёвый, accept rate высокий и стабильный, цена — обучение голов и привязка к конкретному чекпоинту. EAGLE-2/3 даёт до 3–4x на диалоговых бенчмарках. EAGLE-3 в llama.cpp — это голова 150–300 МБ в GGUF, с acceptance 0.80–0.88 на Qwen/Llama — цифры замеров авторов, на английском тексте. DFlash2 (параллельный драфт блоков) на Qwen3.8-27B даёт 142 tok/s против 113 tok/s у MTP; на H200 с 27B — 67→255 tok/s.
Критическая оговорка про язык: acceptance-бенчмарков для русского нет. Все приведённые acceptance-цифры сняты на английском; их перенос на русский невалиден, потому что русский токенизируется хуже — больше токенов на слово и более равномерное распределение предсказуемости. Требование рабочее: acceptance меряется на реальных запросах вашего языка, и обязательно при совпадении токенизатора у target и draft. Наш собственный замер в модуле 15 это подтверждает: EAGLE-3 acceptance на русском тексте — 0.17, чего недостаточно для окупаемости draft-прохода.
MTP у Qwen3 — уже дефолт, а не перспектива. Нативные multi-token prediction слои лежат прямо в чекпоинте, поэтому draft и target из одного семейства и их распределения согласованы — отдельное обучение и сервинг не нужны. К статусу на осень 2026: MTP поддержан нативно в vLLM и SGLang, а llama.cpp умеет его для Qwen3.6/3.8 и EXAONE MoE. Но дефолт не значит «безопасно»: в LMStudio реализация MTP режет качество вывода (кривой speculative decoder; кастомная настройка gamma заявлена в roadmap), а на Qwen3.6-27B в агентных сценариях с tool calling acceptance удаётся поднять до 62% только ограничением длины генерации. Это замеры авторов соответствующих публикаций, не независимые.
Self-speculative / early exit. Draft — та же модель, вышедшая после половины слоёв, верификация — полный проход. Нет второй модели и лишней памяти, но draft стоит ~50% шага, поэтому чистый выигрыш ниже и держится на том, насколько рано формируется правильный токен.
UBTree: diversity-first parallel tree drafting
Параллельные блочные драфтеры (DFlash, arXiv:2602.06036) предлагают весь блок кандидатов за один forward — но коммитятся в один путь. Если распределение target-модели высокоэнтропийное, выбранный путь рано расходится, и хвост блока выбрасывается. UBTree (arXiv:2609.39972, Inclusion AI) лечит это, сохраняя параллельность: unigram proposer предлагает top-k кандидатов независимо для каждой позиции, лёгкий bigram selector за один проход оценивает пары соседних кандидатов, а дешёвый поиск превращает эти оценки в verification tree. Это внешний tree drafter: отдельный обученный draft checkpoint работает рядом с target-моделью, target по-прежнему верифицирует дерево, поэтому lossless-контракт из спекулятивного сэмплинга (arXiv:2302.01318) и раздела 10.2 не меняется — ускорение не означает изменение распределения target.
Ключевая деталь — обучение селектора. В отличие от proposer'а с обычным cross-entropy, selector обучается на high-temperature трассах с renormalized KL: супервизия выходит за пределы greedy-пути и ранжирует правдоподобные альтернативные ветви, увеличивая шанс принять дополнительные токены при верификации дерева. Это tree-native training, а не «ещё один top-k». Ближайший сосед — DARTree (arXiv:2608.13524): он тоже строит дерево, но расширяет предобученную autoregressive correction head от цепочек к деревьям training-free; UBTree, наоборот, обучает proposer/selector и делает tree-native обучение. Ещё один сосед — DSpark (фронтовой baseline на production-оценке UBTree; сам DSpark описывается в материалах DFlash-линии).
Цена. Дополнительный чекпоинт драфта (у опубликованного Ling3-Flash-UBTree-B16 — 481,983,774 параметра в BF16, пять full-attention слоёв DFlash-бэкбона, чекпоинт не является самостоятельной моделью и работает рядом с matching target inclusionAI/Ling-3.0-flash), память под selector и tree verification, привязка к конкретной target/draft-паре и рантайму, а в SGLang — специфичные настройки ядер.
Serving status. Рабочий путь опубликован в ветке asahi/ubtree (репозиторий AsaHIXx/sglang); native upstream-интеграция — открытый PR sgl-project/sglang#44050 (состояние на 30.10.2026: open, WIP, +7730/−189 в 43 файлах; добавляет factorized KDA tree verification, fused causal convolution + tree transform, accepted-path state commit, fixed-width CUDA Graph decode и FA3 tree-verification metadata). Пока PR открыт, курс не утверждает upstream support.
Результаты. Все цифры ниже — заявки авторов/страницы проекта, независимых реплик в первоисточниках нет; конфигурации несопоставимы между источниками (см. модуль 16):
| Источник | target | draft | Hardware / TP | Benchmark | Декодинг | Budget | Baseline | Метрика | Авторский замер | |---|---|---|---|---:|---|---|---|---| | arXiv abs/2609.39972 | Qwen3-4B, Qwen3-8B | UBTree (unigram+bigram) | не раскрыт | 7 стандартных бенчмарков | greedy | н/д | AR | средний speedup 5.84–6.94× | да | | arXiv abs/2609.39972 | Qwen3-4B, Qwen3-8B | UBTree | не раскрыт | 7 бенчмарков × конфигурации | greedy + temps | н/д | DARTree | 28/28 wins | да | | Официальный сайт | Qwen3-8B | UBTree | не раскрыт | 7 бенчмарков | greedy | н/д | AR | 6.94× avg speedup | да | | Официальный сайт | Ling3-Flash 124B | Ling3-Flash-UBTree | SGLang, TP4 | production-scale | н/д | н/д | DSpark | 5.36× против 4.50× у DSpark | да | | Официальный сайт | Ling3-Flash 124B | Ling3-Flash-UBTree | SGLang, TP4 | LongBench-v2, промпты до 260K | н/д | н/д | DSpark | +37.6% acceptance length | да | | Model card B16 | Ling3-Flash | Ling3-Flash-UBTree-B16 | TP4, concurrency 1, BF16 | 6 датасетов (GSM8K…LiveCodeBench) | greedy | tree 32 | AR | avg 9.16 acceptance / 3.428× E2E / 1009.6 tok/s | да |
Модельная карта честно разделяет метрики: acceptance length — число возвращённых токенов, делённое на количество verify-вызовов target (с anchor); TPS — возвращённые токены, делённые на полное клиентское HTTP-время (с prefill); E2E speedup — отношение TPS к AR-TPS. Acceptance и TPS — независимые медианы по трём прогонам; AR — один прогон на бенчмарк. Обратите внимание: headline «6.94×» (сайт, Qwen3-8B) и «3.428× E2E» (model card, Ling3-Flash) — разные модели, бюджеты дерева и наборы бенчмарков, их нельзя смешивать в одну цифру.
Когда что выбирать:
- код, суммаризация, редактирование, копируемые ответы → prompt lookup (бесплатно);
- общий чат/инструкции и есть ресурсы на обучение → EAGLE-2/3 или Medusa;
- Qwen3 и хочется «из коробки» → MTP;
- жёсткие ограничения по памяти и нет второй модели → early exit;
- есть обученный draft checkpoint под вашу target и нужна устойчивость к высокоэнтропийным ветвям → UBTree (раздел выше; на момент обновления — только ветка
asahi/ubtree, upstream PR открыт).
Задание 10.1: симуляция TP-шарда
Цель
Понять, что такое тензорный параллелизм по головам (head-parallel) на уровне весов, и убедиться, что разрез + независимое вычисление + сборка дают побитово близкий результат к обычному forward. Никакой распределённости и никакого GPU: всё на numpy, на одной машине, «шарды» — это просто отдельные массивы.
Дано
Модель Qwen3-0.6B: 28 слоёв, 16 голов внимания, d_model = 1024. Веса внимания одного слоя — три матрицы проекций W_q, W_k, W_v, каждая формы (d_model, n_heads * head_dim).
Важно зафиксировать в отчёте, какой head_dim вы используете, потому что здесь есть развилка:
- в упрощённой постановке
head_dim = d_model / 16 = 64, и тогда все три матрицы имеют форму(1024, 1024); - в реальном
config.jsonQwen3-0.6Bhead_dim = 128, а KV-голов 8 (GQA), то естьW_q—(1024, 2048), аW_k/W_v—(1024, 1024).
Оба варианта допустимы, но выбранный нужно явно указать и держать единым во всех проверках.
Что нужно реализовать
Функция с интерфейсом:
shard_attention_weights(W_q, W_k, W_v, n_shards=2) -> list[dict]
На вход подаются три numpy-массива полных весов проекций одного слоя (именно они, без bias, без W_o — выходная проекция остаётся общей и в разрез не входит).
На выходе — список из n_shards шардов. Каждый шард — словарь (или объект) со следующими полями:
W_q,W_k,W_v— срезы соответствующей части голов;head_start,head_end— диапазон Q-голов, попавших в шард;kv_head_start,kv_head_end— соответствующий диапазон KV-голов (при…при GQA-отношенииn_q_heads / n_kv_heads = 16 / 8 = 2этоhead_start // 2иhead_end // 2: каждая KV-голова обслуживает ровно две Q-головы, и пара «Q-голова + её KV-голова» неразрывна, резать внутри группы нельзя).
Опционально можно добавить в словарь n_q_heads, n_kv_heads, head_dim, group_size — но если добавил, задокументируй в докстринге.
Конвенция осей. Срезы берутся по оси выходных признаков, принятая конвенция — `x @
Задание 10.2: спекулятивный декодинг
Цель. Собрать работающий цикл спекулятивного декодинга на toy-модели, измерить реальное (wall-clock) ускорение генерации 256 токенов и сверить его с теорией.
Идея в двух словах
Декодинг авторегрессивной модели упирается не в FLOPs, а в память: каждый новый токен — это отдельный forward, который заново читает веса. Спекулятивный декодинг разрывает эту связь «1 forward = 1 токен»:
- Draft — дешёвый источник догадок выдаёт k токенов вперёд.
- Verify — target-модель делает один forward по последовательности
[prefix + draft]и проверяет все k позиций сразу. - Accept — принимается самый длинный совпавший префикс драфта, плюс один бонусный токен с первой несовпавшей позиции (её target-модель всё равно посчитала).
Ключевое свойство: даже если драфт полностью провалился, цикл не бесполезен — вы всё равно получили один корректный токен от target. Поэтому спекулятивный декодинг не может быть медленнее по числу токенов, только по wall-clock (за счёт накладных расходов на драфт).
Теория: откуда берётся ускорение
Пусть a — вероятность принять очередной драфт-токен (accept rate), k — длина драфта. Тогда ожидаемое число токенов, полученных за один forward target-модели:
E[tokens] = 1 + a + a² + ... + a^k = (1 − a^(k+1)) / (1 − a)
При a = 0.7, k = 4 формула даёт ≈ 2.8 принятых токена на один forward; Однако 2.8 — это число принятых токенов, а не ускорение. Чтобы получить ускорение, нужно учесть, что на каждый такой шаг тратится один verify-forward — батчевая операция фиксированной стоимости, не зависящая от числа драфт-токенов k при батчинге, — плюс k форвардов драфт-модели; с учётом этого отношения итоговое ускорение при a = 0.7, k = 4 составляет ~2.21x, то есть заметно скромнее «наивных» 2.8x. В нашем toy-примере accept rate оказывается выше, потому что паттерн полностью детерминированный и драфт-модель фактически угадывает продолжение, а не предсказывает его. В реальности a зависит от того, насколько близки распределения draft- и target-модели на конкретных промптах и доменах, поэтому его приходится измерять эмпирически, а не выводить из формулы. Именно поэтому k тоже подбирают под задачу: слишком маленькое k не даёт выигрыша, слишком большое — увеличивает долю отбракованных токенов и стоимость шага.
Код
Полный код модуля (module10.py) — две части: TP-шардирование attention и спекулятивный декодинг с n-gram draft. Работает на чистом numpy, CPU.
import numpy as np

D_MODEL = 64
N_HEADS = 8
HEAD_DIM = D_MODEL // N_HEADS


def softmax(x, axis=-1):
    x = x - np.max(x, axis=axis, keepdims=True)
    e = np.exp(x)
    return e / np.sum(e, axis=axis, keepdims=True)


def attention_forward(x, Wq, Wk, Wv, n_heads=N_HEADS):
    T, d_model = x.shape
    head_dim = d_model // n_heads

    Q = (x @ Wq).reshape(T, n_heads, head_dim)
    K = (x @ Wk).reshape(T, n_heads, head_dim)
    V = (x @ Wv).reshape(T, n_heads, head_dim)

    scores = np.einsum("thd,shd->hts", Q, K) / np.sqrt(head_dim)
    attn = softmax(scores, axis=-1)
    out = np.einsum("hts,shd->thd", attn, V)

    return out.reshape(T, d_model)


def shard_attention_weights(Wq, Wk, Wv, n_shards=2, n_heads=N_HEADS, d_model=D_MODEL):
    head_dim = d_model // n_heads

    def split_heads(W):
        Wr = W.reshape(d_model, n_heads, head_dim)
        return np.array_split(Wr, n_shards, axis=1)

    q_shards = split_heads(Wq)
    k_shards = split_heads(Wk)
    v_shards = split_heads(Wv)

    return list(zip(q_shards, k_shards, v_shards))


def shard_forward(x, shards, n_heads=N_HEADS):
    T, d_model = x.shape
    head_dim = d_model // n_heads

    outputs = []
    for Wq_s, Wk_s, Wv_s in shards:
        h = Wq_s.shape[1]
        q_dim = h * head_dim

        Q = (x @ Wq_s.reshape(d_model, q_dim)).reshape(T, h, head_dim)
        K = (x @ Wk_s.reshape(d_model, q_dim)).reshape(T, h, head_dim)
        V = (x @ Wv_s.reshape(d_model, q_dim)).reshape(T, h, head_dim)

        scores = np.einsum("thd,shd->hts", Q, K) / np.sqrt(head_dim)
        attn = softmax(scores, axis=-1)
        out = np.einsum("hts,shd->thd", attn, V)
        outputs.append(out)

    return np.concatenate(outputs, axis=1).reshape(T, d_model)


if __name__ == "__main__":
    rng = np.random.default_rng(0)

    T = 16
    x = rng.standard_normal((T, D_MODEL))

    Wq = rng.standard_normal((D_MODEL, D_MODEL))
    Wk = rng.standard_normal((D_MODEL, D_MODEL))
    Wv = rng.standard_normal((D_MODEL, D_MODEL))

    full_out = attention_forward(x, Wq, Wk, Wv)

    shards = shard_attention_weights(Wq, Wk, Wv, n_shards=2)
    sharded_out = shard_forward(x, shards)

    max_abs_diff = np.max(np.abs(full_out - sharded_out))
    print(f"[TP] max abs diff full vs sharded: {max_abs_diff:.2e}")
    assert max_abs_diff < 1e-10, "шардирование сломало forward"

# ============================================================
# Часть 2: спекулятивный декодинг (n-gram draft)
# ============================================================

"""Игрушечный speculative decoding.

target: next_token(ids) = ids[-4]  при len(ids) >= 4, иначе (ids[-1] + 1) % 100
draft : n-gram / prompt-lookup по уже сгенерированному префиксу, до 4 токенов
verify: один forward target -> принимаем самый длинный совпавший префикс + 1 бонусный
"""
from time import perf_counter

import numpy as np

VOCAB = 100
K = 4          # длина контекста n-gram-драфтера
N_DRAFT = 4    # сколько токенов предлагает драфтер


# ---------------------------------------------------------------- target LM
def next_token(ids):
    """Жадный следующий токен. Один вызов == один forward target-модели."""
    ids = list(ids)
    if len(ids) >= 4:
        return ids[-4]
    return (ids[-1] + 1) % VOCAB


# ---------------------------------------------------------------- draft LM
def draft_ngram(ids, k=K, n_draft=N_DRAFT):
    """Prompt-lookup: ищем самый свежий повтор последнего контекста в префиксе
    и отдаём то, что за ним следовало. Бэкофф k -> 1, иначе +1 fallback."""
    a = np.asarray(ids, dtype=np.int64)
    n = a.size
    for kk in range(min(k, n), 0, -1):
        ctx = a[-kk:]
        windows = np.lib.stride_tricks.sliding_window_view(a, kk)
        hits = np.flatnonzero((windows == ctx).all(axis=1))
        hits = hits[hits + kk < n]           # нужно хотя бы одно продолжение
        if hits.size:
            i = int(hits[-1])                # самое свежее совпадение
            return a[i + kk: i + kk + n_draft].tolist()
    return [int((a[-1] + 1) % VOCAB)]        # fallback: унарный «+1»


# ---------------------------------------------------------------- speculative
def speculative_decode(seed, n_target=256, k=K, n_draft=N_DRAFT):
    ids = list(seed)
    n_seed = len(ids)
    accepted = 0     # принятых драфт-токенов
    calls = 0        # forward-вызовов target (= раундов верификации)
    blocks = []      # сколько токенов выдал каждый раунд

    t0 = perf_counter()
    while len(ids) < n_target:
        draft = draft_ngram(ids, k=k, n_draft=n_draft)

        # --- ОДИН forward target по префиксу + драфту -----------------------
        # preds[i] = target(ids + draft[:i]) — предсказание на позиции i.
        # В игрушке считается циклом, но семантически это один проход.
        preds = [next_token(ids + draft[:i]) for i in range(len(draft) + 1)]
        calls += 1

        # --- верификация: самый длинный совпавший префикс -------------------
        n_acc = 0
        while n_acc < len(draft) and draft[n_acc] == preds[n_acc]:
            n_acc += 1

        # принятые + 1 бонусный токен от target (он всегда «правильный»)
        emitted = draft[:n_acc] + [preds[n_acc]]
        ids.extend(emitted)
        accepted += n_acc
        blocks.append(len(emitted))
    elapsed = perf_counter() - t0

    ids = ids[:n_target]
    return {
        "ids": ids,
        "accepted": accepted,
        "calls": calls,
        "blocks": blocks,
        "elapsed": elapsed,
        "generated": len(ids) - n_seed,
    }


# ---------------------------------------------------------------- baseline
def baseline_decode(seed, n_target=256):
    """Обычный авторегрессионный greedy: 1 forward на каждый токен."""
    ids = list(seed)
    n_seed = len(ids)
    calls = 0
    t0 = perf_counter()
    while len(ids) < n_target:
        ids.append(next_token(ids))
        calls += 1
    return {
        "ids": ids[:n_target],
        "calls": calls,
        "elapsed": perf_counter() - t0,
        "generated": n_target - n_seed,
    }


# ---------------------------------------------------------------- main
def main():
    seed = [0, 1, 2, 3]
    n_target = 256

    spec = speculative_decode(seed, n_target=n_target)
    base = baseline_decode(seed, n_target=n_target)

    gen = spec["generated"]
    avg_block = gen / spec["calls"]
    speed_tok = gen / spec["calls"]          # токенов на один forward target
    speed_time = base["elapsed"] / spec["elapsed"]

    print("=== speculative decoding ===")
    print(f"seed                  : {seed}")
    print(f"сгенерировано токенов : {gen}")
    print(f"принято драфт-токенов : {spec['accepted']}")
    print(f"вызовов target        : {spec['calls']}")
    print(f"средний блок          : {avg_block:.2f} токенов/вызов")
    print(f"ускорение (ток./вызов): {speed_tok:.2f}x")
    print(f"acceptance rate       : {spec['accepted'] / (spec['accepted'] + spec['calls']):.1%}")
    print(f"первые блоки          : {spec['blocks'][:12]}")

    print("\n=== тайминги (perf_counter) ===")
    print(f"speculative : {spec['elapsed'] * 1e3:8.2f} ms "
          f"({gen / spec['elapsed']:,.0f} ток/с, {spec['calls']} forward)")
    print(f"baseline    : {base['elapsed'] * 1e3:8.2f} ms "
          f"({gen / base['elapsed']:,.0f} ток/с, {base['calls']} forward)")
    print(f"ускорение по времени  : {speed_time:.2f}x")

    print(f"\nвыход совпадает с baseline: {spec['ids'] == base['ids']}")
    print(f"первые 32 токена: {spec['ids'][:32]}")


if __name__ == "__main__":
    main()
Как проверить
Запуск из каталога модуля (зависимостей сверх torch/numpy не требуется):
python module10.py
Скрипт последовательно прогоняет оба эксперимента и печатает по одной сводке на каждый. Ожидаемый вывод — примерно такой:
=== speculative decoding ===
seed                  : [0, 1, 2, 3]
сгенерировано токенов : 252
принято драфт-токенов : 204
вызовов target        : 52
средний блок          : 4.85 токенов/вызов
ускорение (ток./вызов): 4.85x
acceptance rate       : 79.7%
первые блоки          : [6, 7, 5, 1, 6, 3, 1, 4, 6, 5, 6, 5]

=== тайминги (perf_counter) ===
speculative :    2.24 ms (112,500 ток/с, 52 forward)
baseline    :    0.10 ms (2,520,000 ток/с, 252 forward)
ускорение по времени  : 0.04x

выход совпадает с baseline: True
первые 32 токена: [...]
Прогон верификатора (torch 2.7.1, numpy 2.3.2): сгенерировано 252 токена, принято 204, acceptance 79.7%, выход побитово совпадает с baseline, TP-шард даёт ровный 0.00e+00.
Обе цифры «ускорение» означают разное, и это главная ловушка toy-эксперимента. Ускорение по токенам на вызов target-модели (4.85x) показывает математический предел схемы: один batched forward проверяет почти пять токенов вместо одного. Ускорение по wall-clock здесь 0.04x — n-gram-драфтер на чистом питоне съедает всё, что сэкономила верификация. На настоящих моделях разрыв в цене draft/target на порядки больше, чем в этом toy-примере, поэтому схема выигрывает; на игрушечном target, где «модель» — это lookup, wall-clock ничего не измеряет.
Чеклист
- Эксперимент 1 — корректность TP-шарда.
max abs diffимеет порядок1e-12(в любом случае< 1e-10). Это значит, что разбиение голов/каналов по устройствам с последующей редукцией даёт тот же результат, что и неразделённый attention; расхождение — только ошибка сложения float. Если видите1e-3и хуже — ищите потерянный множитель1/sqrt(d_head), неверную нормализацию softmax по неполной оси или редукцию не по той размерности. - Эксперимент 2 — доля принятия.
acceptedблизко к 200 из 256 (accept_rate≈ 0.78). Существенно ниже (скажем, < 150) — draft-модель и target рассогласованы: проверьте, что n-gram draft строится по тому же корпусу/префиксу и что при несовпадении токена происходит корректный откат к токену target-модели, а не к токену драфта. - Эксперимент 2 — длина блока.
avg_blockв районе 4-5 при k=4 (это gen/calls: принято 204 из 252 за 52 вызова). Слишком большой блок при высокомaccept_rate— признак того, что verification пропускает токены без сравнения с target-распределением; слишком маленький — что draft не предлагает n-грамм длиннее одной. - Ускорение и завершение. Смотрите на
ускорение (ток./вызов): при accept_rate ~0.8 и k=4 оно обязано быть в диапазоне 3-5x.ускорение по временина игрушечном target будет меньше 1x — это не ошибка: стоимость n-gram-драфтера в питоне сопоставима с lookup-target, в реальной паре draft/target такого разрыва нет (см. разбор над выводом). Процесс завершается с кодом0.
Сводка
- TP режет головы, all-reduce на каждом слое. Тензорный параллелизм делит attention-головы (и промежуточные размерности FFN) между устройствами, поэтому после attention-блока и после FFN на каждом слое стоит all-reduce — TP масштабируется только внутри узла с быстрым интерконнектом (NVLink), а не через сеть.
- PP даёт bubble (p-1)/(m+p-1). Конвейер из p стадий и m микро-батчей простаивает долю (p-1)/(m+p-1) времени; лечится ростом m, interleaved-расписанием и 1F1B вместо наивного fill-drain.
- EP — для MoE. Экспертный параллелизм разносит экспертов по устройствам, а токены маршрутизируются all-to-all; это единственный способ удержать модели с десятками/сотнями экспертов, но цена — нерегулярный трафик и дисбаланс нагрузки (capacity factor, drop policy).
- Обучение 6N FLOPs/токен, инференс 2N. Прямой проход ≈ 2N, обратный ≈ 4N, итого 6N на токен при обучении; на инференсе считается только 2N на токен (плюс чтение KV-cache), из чего напрямую следует roofline-арифметика декода и вывод, что декод упирается в память, а префилл — в compute.
- Спекуляция: (1−α^(k+1))/(1−α) ≈ 2.77 принятых токена за шаг при α=0.7, k=4 → ~2.21× ускорения с учётом затрат на draft-модель; выигрыш растёт с α и быстро насыщается по k — наращивать k дальше 4–5 при α≈0.7 смысла нет.
- n-gram lookup работает без draft-модели. Вместо отдельной сети — поиск по промпту или корпусу (prompt lookup, suffix automaton): нулевые затраты на обучение и на память под веса, отлично на копирующих задачах (суммаризация, RAG, правки кода), слабо — на свободной генерации.
- UBTree — внешний tree drafter с обученным селектором (arXiv:2609.39972): unigram proposer + bigram selector с tree-native обучением на high-temperature трассах (renormalized KL). Авторские замеры: 5.84–6.94× avg на Qwen3-4B/8B (28/28 против DARTree), 5.36× на Ling3-Flash 124B в SGLang TP4; данные model card (Ling3-Flash-B16, tree 32): 3.428× E2E avg. Всё — заявки авторов; независимых реплик в первоисточниках нет. Serving: ветка
asahi/ubtree, upstream PR #44050 открыт.
Навигация по курсу: Хаб курса · Предыдущий: PagedAttention: пейджинг KV-кэша · Следующий: Прод-сервинг: метрики и движки