Хаб курсов / LLM Inference Systems / глава 9
Модуль 09: PagedAttention: пейджинг KV-кэша
KV-кэш как виртуальная память: BlockPool, BlockTable, prefix sharing, copy-on-write, paged attention.
LLM Inference Systems. Модуль 09: PagedAttention, пейджинг KV-кэша
KV-кэш — главный потребитель памяти при инференсе, и до 2023 года его выделяли «по максимуму»: под каждый запрос резервировали буфер на max_seq_len токенов. На практике запрос живёт 200–2000 токенов из 32768, и 60–80% зарезервированной памяти простаивает. PagedAttention (Kwon et al., SOSP'23, ядро vLLM) переносит в KV-кэш идею виртуальной памяти: кэш нарезается на блоки по 16 токенов, физические блоки берутся из общего пула по требованию, а соответствие «логический блок → физический блок» хранится в block table. Потери падают до <4%, а одинаковые префиксы (системный промпт) разных запросов начинают ссылаться на одни и те же физические блоки.
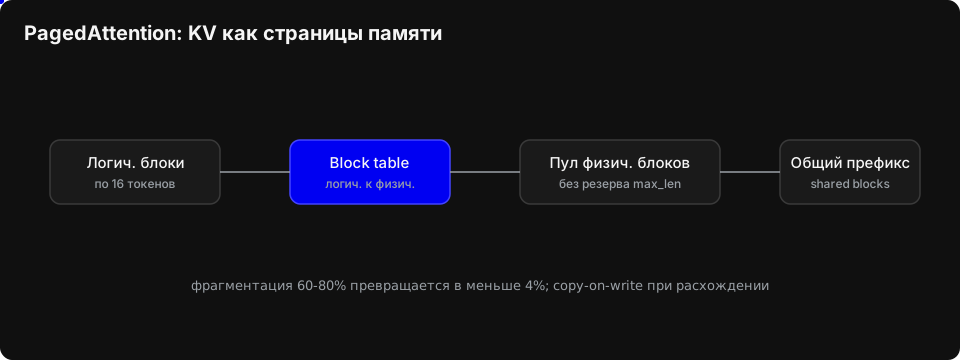
В этом модуле мы посчитаем честные числа потерь для 8B-модели, напишем на numpy BlockPool с refcount и copy-on-write, реализуем декод-внимание, читающее K/V по block table через online-softmax (та же схема, что в CUDA-кернеле vLLM), и снимем метрики на двух запросах с общим системным промптом.
1. Сколько памяти занимает KV-кэш
Для модели с n_layers слоями, n_kv_heads KV-головами (GQA), head_dim и типом dtype:
bytes_per_token = 2 · n_layers · n_kv_heads · head_dim · sizeof(dtype)
Множитель 2 — K и V. Возьмём конфигурацию класса 7–8B: n_layers=32, n_kv_heads=8, head_dim=128, fp16 (2 байта).
- на один слой на токен:
2 · 8 · 128 · 2 = 4096байт = 4 КиБ; - на все 32 слоя:
4 КиБ · 32 = 128 КиБна токен; - блок из 16 токенов:
16 · 128 КиБ = 2 МиБ; - контекст 4k:
4096 · 128 КиБ = 512 МиБ; - контекст 32k:
32768 · 128 КиБ = 4 ГиБ.
| Длина | fp16 KV | int8 KV | блоков по 16 (fp16) |
|---|---|---|---|
| 512 | 64 МиБ | 32 МиБ | 32 |
| 2 048 | 256 МиБ | 128 МиБ | 128 |
| 4 096 | 512 МиБ | 256 МиБ | 256 |
| 32 768 | 4 ГиБ | 2 ГиБ | 2 048 |
На H100 80 ГБ: веса 8B в fp16 — 16 ГБ, активации и workspace — ещё несколько ГБ, под KV остаётся ~60 ГБ. Это 120 последовательностей по 4k токенов. Если резервировать слот под 32k (4 ГиБ), в те же 60 ГБ влезает 15 слотов, и при средней реальной длине 4k полезно используется 15 · 512 МиБ = 7.5 ГиБ — 12% памяти. Остальное занято пустотой.
Декод-шаг читает весь KV-кэш последовательности: 512 МиБ на один сгенерированный токен при 4k контекста. При пропускной способности HBM ~2 ТБ/с это ~256 мкс только на чтение K/V — декод упирается в память, а не в арифметику. Поэтому доля полезно занятых байт KV-кэша прямо конвертируется в throughput.
2. Два вида фрагментации
Internal fragmentation. Запрос из 10 токенов получает слот на 2048 токенов. Занято 10 · 128 КиБ = 1.25 МиБ из 256 МиБ; потери 99.5%. Даже при среднем заполнении 50% половина зарезервированной памяти не используется.
External fragmentation. Слот на 2048 токенов требует непрерывного куска 256 МиБ. После старта и завершения сотни запросов разной длины свободные куски раздроблены: суммарно памяти хватает, но непрерывного куска на новый слот нет — аллокатор отказывает.
В vLLM paper (SOSP'23, §2) замерено: в системах с резервированием под max_seq_len впустую уходит 60–80% памяти KV-кэша, из них 20–38% — internal fragmentation. PagedAttention снижает суммарные потери до менее 4%, потому что выделяет память блоками по 16 токенов и только по факту роста последовательности.
Остаточные потери при блочном выделении считаются точно: последовательность длины L занимает ceil(L/16) блоков, лишних токенов 16·ceil(L/16) − L < 16, то есть максимум один неполный блок — 2 МиБ на последовательность в нашей конфигурации. При 100 активных последовательностях это ≤ 200 МиБ из ~40 ГиБ, ~0.5%.
3. Логические и физические блоки
KV-кэш последовательности — это список логических блоков 0, 1, 2, …. Каждый логический блок отображается в физический блок пула через block table — массив int32 длины ceil(L/16). Токен с позиции t лежит в физическом блоке block_table[t // 16] по смещению t % 16.
BlockPool (физическая память)          Block table запроса A
┌────┬───────────────────────┐         логич.  физ.
│  0 │ K/V: 16 токенов, 2 МиБ│          0  →   7
│  1 │ ...                   │          1  →   0
│ ...│                       │          2  →  12
│  7 │ ← блок 0 запроса A    │
│ 12 │ ← блок 2 запроса A    │
│ 31 │ ← блок 2 запроса B    │
└────┴───────────────────────┘
Свойства, которые это даёт:
- Нет realloc. Рост последовательности — это
appendв текущий последний блок, а на границе 16 токенов — аллокация нового блока из free-list. Старые блоки не двигаются, указатели на них не меняются. - Нет требования непрерывности. Физические блоки берутся откуда угодно; непрерывна только логическая нумерация.
- Внутренние потери ≤ 1 блок на последовательность.
- Таблица дешёвая. 4 байта на блок: для 32k токенов это
2048 · 4 = 8 КиБпротив 4 ГиБ самих данных — 0.0002%.
Размер блока — компромисс. 16 токенов (значение по умолчанию в vLLM) дают блок 2 МиБ в нашей конфигурации: достаточно крупный, чтобы кернел читал его коалесцированно (16 · 128 · 2 = 4 КиБ на голову — ровно страница), и достаточно мелкий, чтобы потери были незаметны. Блок 8 уменьшит потери вдвое, но удвоит число записей в block table и накладные расходы кернела; блок 128 даст до 16 МиБ внутренних потерь на последовательность.
4. Prefix sharing и copy-on-write
Системный промпт у всех запросов одинаковый — 512 токенов, 32 блока, 64 МиБ. При резервировании под каждый запрос эти 64 МиБ дублируются: 10 запросов — 640 МиБ. При пейджинге достаточно, чтобы block table всех десяти запросов ссылались на одни и те же физические блоки 0…31: 64 МиБ на всех плюс хвосты.
Чтобы это было безопасно, каждый физический блок держит счётчик ссылок ref_count. Форк запроса (новый запрос с тем же префиксом) копирует block table и инкрементирует ref_count всех блоков. Запись в блок с ref_count > 1 запрещена: сначала блок копируется в новый физический (copy-on-write), ref_count старого уменьшается, и только потом выполняется запись. Копия одного блока — 2 МиБ, на H100 это ~1 мкс, и происходит только при расхождении префиксов.
Тонкость: если общий префикс заканчивается ровно на границе блока (L % 16 == 0), COW при первом же новом токене не нужен — выделяется свежий блок. В остальных случаях первый добавленный токен стоит одной копии блока.
vLLM строит на этом автоматический prefix caching: блок хешируется по содержимому (токены + хеши предыдущих блоков), и новый запрос переиспользует найденные блоки без явного форка.
RadixAttention: более агрессивный кузен PagedAttention
Prefix sharing через PagedAttention — не потолок. RadixAttention в SGLang хранит KV-cache в radix-дереве с LRU-вытеснением: общие префиксы всех когда-либо обработанных запросов образуют дерево, по которому кеш ищется автоматически и удерживается по LRU, а не живёт только в block table активных запросов. Это более агрессивный prefix caching, чем у PagedAttention в vLLM: дерево переживает запросы, и длинные системные промпты переиспользуются даже между «несвязанными» сессиями. Бренд направления — RadixArk (янв. 2026). Компромисс той же природы, что и всё в этом модуле: radix-дерево снимает фрагментацию логическую, но удержание кеша по LRU стоит памяти — и на практике проявляется в раскладке ниже.
Сколько это стоит в памяти
Раскладка 2026 на равном железе: vLLM потребляет ~70 ГБ против ~56 ГБ у SGLang — в основном из-за преаллокации KV. Ёмкость пула, которую мы считали как «чистый плюс», у каждого движка своя цена.
Backend'ы attention
Ещё одна ось выбора: vLLM attention backends — FLASH_ATTN (дефолт, рекомендация Red Hat 2026) и FLASHINFER (paged-KV и cascade-внимание в одном ядре — упоминался выше). Для MLA-моделей дефолтные paged-кернелы и вовсе заменяются ThunderMLA/FlexDecoding (см. модуль 07): выбор кернела определяется архитектурой внимания, а не только движком.
5. Внимание по страницам
Для запроса длины L с одним query-вектором на голову декод-шаг выглядит так:
scores[t] = (q · K[t]) / sqrt(head_dim),  t = 0..L-1
out = softmax(scores) · V
При пейджинге K[t] не лежит по адресу base + t·stride: его надо достать через block_table[t // 16]. Наивно это gather, но кернел делает иначе — он итерируется по блокам и обрабатывает блок целиком, как contiguous кусок из 16 строк. Для каждого блока:
S_b = q · K[phys_b]^T · scale        # (n_heads, 16)
m_new = max(m, rowmax(S_b))          # online softmax
alpha = exp(m - m_new)
P = exp(S_b - m_new)
l = l·alpha + rowsum(P)
acc = acc·alpha + P · V[phys_b]
m = m_new
out = acc / l
Это ровно схема FlashAttention, только внешний цикл идёт не по последовательным чанкам, а по записям block table. Маска нужна только для последнего блока (там L % 16 валидных слотов), потому что все предыдущие блоки заполнены целиком. При полном блоке L % 16 == 0 маски нет вообще.
Кернел paged_attention в vLLM — это отдельное CUDA-ядро для декода (один query на голову, партиционирование по блокам, как в Flash-Decoding). Для префилл-фазы с общим префиксом используют varlen-вариант FlashAttention с block table. Современная альтернатива — FlashInfer, где paged-KV и cascade-внимание собраны в одном ядре.
Форму памяти это не меняет: декод по-прежнему читает L · 128 КиБ. Меняется то, сколько последовательностей помещается в память одновременно — а именно это определяет throughput при memory-bound декоде.
6. Квантование KV-кэша по блокам
Блочная структура удобна для квантования: масштаб считается на блок, а не на всю последовательность, поэтому не нужно пересчитывать его при каждом новом токене. Для int8 на блок и голову:
scale = max|K[block, head, :]| / 127
q = clip(round(K / scale), -127, 127)
K ≈ q · scale
Ошибка на элемент ≤ range/254; для K с диапазоном ±4 это ≤ 0.03 абсолютной ошибки. Накладные расходы — 4 байта на голову на блок (scale + zero-point), то есть 0.2% от 4 КиБ блока. Память падает вдвое: 4k контекста — 256 МиБ вместо 512 МиБ.
На моделях класса LLaMA-2-7B int8-квантование KV даёт прирост perplexity в пределах 0.05–0.2 (KIVI, arXiv 2402.02750); FP8 E4M3 в vLLM и TensorRT-LLM практически не меняет качество и экономит те же 2×. Ключ — держать масштаб per-block и per-head: один масштаб на всю последовательность ломается на выбросах в отдельных головах.
Блочное квантование — не финальная точка. Следующий шаг ушёл вперёд по трём направлениям: per-token scales (отдельный масштаб на каждый токен вместо блока), Hadamard-ротация перед квантованием (размазывает выбросы) и кодбуки. Граница качества — 2-битный KV в reasoning-декодинге как рабочий режим: KVarN (arXiv 2606.03458 — calibration-free, Hadamard + dual-scaling, SOTA на 2-bit KV при длинном декодинге) и TurboQuant. Это продолжение темы разобрано в модуле 05 (§10); здесь достаточно знать, что per-block int8/FP8 из этого раздела — базовая ступень, а не конец эволюции.
Задание 09.1: BlockPool, BlockTable, append и освобождение
Реализуй BlockPool и Sequence с интерфейсом:
pool = BlockPool(num_blocks, n_layers, n_kv_heads, head_dim, block_size=16)
seq = Sequence(pool, seq_id)
seq.append(k, v)      # k, v: (n_layers, n_kv_heads, head_dim), возвращает физический блок
seq.block_table       # list[int]
seq.free()            # вернуть все блоки в пул
pool.used, pool.free  # занятые / свободные блоки
Требования:
appendаллоцирует новый физический блок только когдаlen(seq) % 16 == 0.free()уменьшаетref_count; блок возвращается в пул только приref_count == 0.- Аллокация из пула — O(1), free-list.
- На 64 последовательностях со случайными длинами 10…2048 при
max_len=2048покажи: пейджинг тратит блоков вдвое меньше, чем резервирование, а остаточные потери (недозаполненные слоты) — меньше 4% от выделенного.
Ожидаемо: waste_ratio < 0.04, paged_blocks ≈ 0.5 · reserved_blocks.
Задание 09.2: внимание по страницам
Реализуй две функции:
def paged_attention(pool, seq, layer, q, scale) -> np.ndarray  # (n_heads, head_dim)
def reference_attention(K, V, q, scale) -> np.ndarray          # contiguous K,V: (L, n_kv_heads, head_dim)
paged_attention обязан идти по блокам из block_table с online-softmax (не собирать весь K в один массив). Проверка: при L = 40 (два полных блока и половина третьего) результаты совпадают с reference_attention с точностью atol=1e-5, включая GQA (n_heads=4, n_kv_heads=2).
Задание 09.3: prefix sharing
Собери системный промпт из 500 токенов, форкни его в 10 запросов, каждому добавь по 3 токена. Напечатай:
- block table двух запросов (общий префикс и разошедшийся хвост);
- число общих физических блоков;
- суммарно занятых блоков против варианта без шеринга (
10 · ceil(503/16)); - экономию в мегабайтах для конфигурации
n_layers=32, n_kv_heads=8, head_dim=128, fp16; - что происходит с
ref_countприfree()базового запроса.
Ожидаемо: 31 общий блок (последний, неполный блок префикса COW-копируется каждому форку), 42 занятых блока против 320, экономия 278 блоков = 556 МиБ.
Код
"""paged_kv.py — пейджинг KV-кэша на CPU (numpy).

BlockPool   — физические блоки, refcount, free-list.
Sequence    — block table, append, fork, copy-on-write.
paged_attention — декод-внимание по block table с online-softmax.
"""

import numpy as np

BLOCK_SIZE = 16


# ---------------------------------------------------------------- BlockPool
class BlockPool:
    """Пул физических блоков: один блок = BLOCK_SIZE токенов для всех слоёв."""

    def __init__(self, num_blocks, n_layers, n_kv_heads, head_dim,
                 block_size=BLOCK_SIZE, dtype=np.float32):
        self.block_size = block_size
        self.num_blocks = num_blocks
        self.n_layers = n_layers
        self.n_kv_heads = n_kv_heads
        self.head_dim = head_dim
        shape = (n_layers, num_blocks, block_size, n_kv_heads, head_dim)
        self.k = np.zeros(shape, dtype=dtype)
        self.v = np.zeros(shape, dtype=dtype)
        self.ref = np.zeros(num_blocks, dtype=np.int32)
        # free-list: забираем с конца, чтобы аллокация шла с блока 0
        self._free = list(range(num_blocks))[::-1]
        self.peak = 0

    def allocate(self):
        if not self._free:
            raise MemoryError("block pool exhausted")
        b = self._free.pop()
        self.ref[b] = 1
        self.k[:, b] = 0.0
        self.v[:, b] = 0.0
        self.peak = max(self.peak, self.used)
        return b

    def release(self, b):
        assert self.ref[b] > 0
        self.ref[b] -= 1
        if self.ref[b] == 0:
            self._free.append(b)

    @property
    def used(self):
        return self.num_blocks - len(self._free)

    @property
    def free(self):
        return len(self._free)

    def bytes_per_block(self):
        return (2 * self.n_layers * self.block_size * self.n_kv_heads
                * self.head_dim * self.k.dtype.itemsize)


# ---------------------------------------------------------------- Sequence
class Sequence:
    """Логическая последовательность: block table + длина."""

    def __init__(self, pool, seq_id):
        self.pool = pool
        self.seq_id = seq_id
        self.block_table = []
        self.length = 0

    # --- запись одного токена -------------------------------------------------
    def append(self, k, v):
        """k, v: (n_layers, n_kv_heads, head_dim). Возвращает физический блок."""
        pool = self.pool
        if self.length % pool.block_size == 0:
            self.block_table.append(pool.allocate())
        phys = self.block_table[-1]
        if pool.ref[phys] > 1:          # блок общий -> copy-on-write
            phys = self._cow(phys)
        off = self.length % pool.block_size
        pool.k[:, phys, off] = k
        pool.v[:, phys, off] = v
        self.length += 1
        return phys

    def _cow(self, phys):
        pool = self.pool
        new = pool.allocate()
        pool.k[:, new] = pool.k[:, phys]
        pool.v[:, new] = pool.v[:, phys]
        pool.ref[phys] -= 1
        self.block_table[-1] = new
        return new

    # --- форк и освобождение --------------------------------------------------
    def fork(self, new_id):
        child = Sequence(self.pool, new_id)
        child.block_table = list(self.block_table)
        child.length = self.length
        for b in child.block_table:
            self.pool.ref[b] += 1
        return child

    def free(self):
        for b in self.block_table:
            self.pool.release(b)
        self.block_table = []
        self.length = 0

    def __repr__(self):
        return f"Sequence({self.seq_id}, len={self.length}, blocks={self.block_table})"


# ---------------------------------------------------------------- attention
def gather_kv(pool, seq, layer):
    """Собрать contiguous K,V из пейджинга (только для проверки, не для кернела)."""
    K = np.zeros((seq.length, pool.n_kv_heads, pool.head_dim), np.float32)
    V = np.zeros_like(K)
    bs = pool.block_size
    for t in range(seq.length):
        phys = seq.block_table[t // bs]
        off = t % bs
        K[t] = pool.k[layer, phys, off]
        V[t] = pool.v[layer, phys, off]
    return K, V


def reference_attention(K, V, q, scale):
    """K, V: (L, n_kv_heads, head_dim); q: (n_heads, head_dim)."""
    n_heads = q.shape[0]
    group = n_heads // K.shape[1]
    Kr = np.repeat(K, group, axis=1)        # (L, n_heads, d)
    Vr = np.repeat(V, group, axis=1)
    S = np.einsum('hd,lhd->hl', q, Kr) * scale
    S -= S.max(axis=1, keepdims=True)
    P = np.exp(S)
    P /= P.sum(axis=1, keepdims=True)
    return np.einsum('hl,lhd->hd', P, Vr)


def paged_attention(pool, seq, layer, q, scale):
    """Декод-внимание: цикл по физическим блокам + online softmax."""
    n_heads, d = q.shape
    group = n_heads // pool.n_kv_heads
    m = np.full(n_heads, -np.inf, np.float32)   # running max
    l = np.zeros(n_heads, np.float32)           # running sum
    acc = np.zeros((n_heads, d), np.float32)    # running numerator
    bs = pool.block_size

    for bi, phys in enumerate(seq.block_table):
        start = bi * bs
        n = min(bs, seq.length - start)         # последний блок может быть неполным
        Kb = np.repeat(pool.k[layer, phys, :n], group, axis=1)   # (n, n_heads, d)
        Vb = np.repeat(pool.v[layer, phys, :n], group, axis=1)

        S = np.einsum('hd,nhd->hn', q, Kb) * scale               # (n_heads, n)
        m_new = np.maximum(m, S.max(axis=1))
        alpha = np.exp(m - m_new)                                # -inf -> 0
        P = np.exp(S - m_new[:, None])

        l = l * alpha + P.sum(axis=1)
        acc = acc * alpha[:, None] + np.einsum('hn,nhd->hd', P, Vb)
        m = m_new

    return acc / l[:, None]


# ---------------------------------------------------------------- int8 KV
def quantize_block_int8(Kb):
    """Kb: (n, n_kv_heads, d). Масштаб — на голову внутри блока."""
    amax = np.abs(Kb).max(axis=(0, 2), keepdims=True)
    scale = np.maximum(amax / 127.0, 1e-8).astype(np.float32)
    q = np.clip(np.round(Kb / scale), -127, 127).astype(np.int8)
    return q, scale


def dequantize_block_int8(q, scale):
    return q.astype(np.float32) * scale


# ---------------------------------------------------------------- тесты
def test_fragmentation():
    print("== 09.1 фрагментация ==")
    rng = np.random.default_rng(7)
    n_seq, max_len, bs = 64, 2048, BLOCK_SIZE
    lengths = rng.integers(10, max_len + 1, size=n_seq)

    pool = BlockPool(num_blocks=100_000, n_layers=1, n_kv_heads=1,
                     head_dim=1, block_size=bs)
    tok = np.zeros((1, 1, 1), np.float32)
    for i, L in enumerate(lengths):
        s = Sequence(pool, i)
        for _ in range(int(L)):
            s.append(tok, tok)

    tokens = int(lengths.sum())
    paged_blocks = pool.used
    reserved_blocks = n_seq * (max_len // bs)
    waste_tokens = paged_blocks * bs - tokens
    waste_ratio = waste_tokens / (paged_blocks * bs)

    print(f"tokens={tokens} seqs={n_seq} max_len={max_len}")
    print(f"reserved_blocks={reserved_blocks} paged_blocks={paged_blocks} "
          f"ratio={paged_blocks / reserved_blocks:.3f}")
    print(f"waste_tokens={waste_tokens} waste_ratio={waste_ratio:.4%}")
    assert waste_ratio < 0.04
    assert paged_blocks < 0.6 * reserved_blocks


def test_attention():
    print("\n== 09.2 paged attention vs contiguous ==")
    rng = np.random.default_rng(1)
    n_layers, n_kv, d, n_heads = 2, 2, 8, 4
    pool = BlockPool(num_blocks=64, n_layers=n_layers, n_kv_heads=n_kv, head_dim=d)
    L = 40                                    # 2 полных блока + 8 токенов
    K = rng.normal(size=(n_layers, L, n_kv, d)).astype(np.float32)
    V = rng.normal(size=(n_layers, L, n_kv, d)).astype(np.float32)

    seq = Sequence(pool, "attn")
    for t in range(L):
        seq.append(K[:, t], V[:, t])

    q = rng.normal(size=(n_heads, d)).astype(np.float32)
    scale = 1.0 / np.sqrt(d)

    out_paged = paged_attention(pool, seq, 0, q, scale)
    Kc, Vc = gather_kv(pool, seq, 0)
    out_ref = reference_attention(Kc, Vc, q, scale)

    diff = float(np.abs(out_paged - out_ref).max())
    print(f"L={L} blocks={seq.block_table} max|diff|={diff:.3e}")
    assert np.allclose(out_paged, out_ref, atol=1e-5)


def test_prefix_sharing():
    print("\n== 09.3 prefix sharing + copy-on-write ==")
    pool = BlockPool(num_blocks=1024, n_layers=1, n_kv_heads=1, head_dim=1)
    SYS = 500                                  # 500 = 31*16 + 4, хвост неполный
    tok = np.zeros((1, 1, 1), np.float32)
    base = Sequence(pool, "sys")
    for _ in range(SYS):
        base.append(tok, tok)
    print(f"system prompt: {SYS} tokens -> {len(base.block_table)} blocks, "
          f"used={pool.used}, ref[last]={pool.ref[base.block_table[-1]]}")

    reqs = []
    for i in range(10):
        r = base.fork(f"req{i}")
        for j in range(3):
            r.append(np.full((1, 1, 1), i + 1, np.float32),
                     np.full((1, 1, 1), i + 1, np.float32))
        reqs.append(r)

    shared = set(reqs[0].block_table) & set(reqs[1].block_table)
    shared_count = len(shared)                                # общие блоки префикса
    per_req = -(- (SYS + 3) // BLOCK_SIZE)                    # блоков на запрос без шеринга
    total_blocks = pool.used
    expected_no_sharing = 10 * per_req
    saved = expected_no_sharing - total_blocks
    bytes_per_block = 2 * 32 * BLOCK_SIZE * 8 * 128 * 2        # fp16, полный конфиг
    saved_mb = saved * bytes_per_block / 2**20

    print(f"req0: {reqs[0].block_table}")
    print(f"req1: {reqs[1].block_table}")
    print(f"shared physical blocks (req0 ∩ req1): {shared_count}")
    print(f"total blocks used: {total_blocks} vs no-sharing {expected_no_sharing}, saved {saved} blocks = {saved_mb:.0f} МиБ")
    assert shared_count == SYS // BLOCK_SIZE                   # полные блоки префикса
    assert reqs[0].block_table[-1] != reqs[1].block_table[-1]  # COW разошёлся

    # free() базового запроса: ref_count всех блоков падает на 1.
    # Полные блоки префикса остаются живыми (у них ещё 10 ссылок форков),
    # неполный 32-й блок base живёт только на базовом запросе -> освобождается.
    base.free()
    print(f"after base.free(): pool.used={pool.used}")
    assert pool.used == total_blocks - 1
    for r in reqs:
        r.free()
    assert pool.used == 0
    print("pool empty after freeing all forks")


def test_int8_kv():
    print("\n== квантование KV по блокам ==")
    rng = np.random.default_rng(3)
    Kb = rng.normal(scale=2.0, size=(16, 8, 128)).astype(np.float32)
    q, scale = quantize_block_int8(Kb)
    err = float(np.abs(dequantize_block_int8(q, scale) - Kb).max())
    print(f"int8: scale shape={scale.shape}, max|err|={err:.4f}")
    assert err < 0.1


if __name__ == "__main__":
    test_fragmentation()
    test_attention()
    test_prefix_sharing()
    test_int8_kv()
    print("\nOK")
Как проверить
python paged_kv.py
Ожидаемый вывод:
== 09.1 фрагментация ==
tokens=... reserved_blocks=8192 paged_blocks=... ratio≈0.5
waste_ratio=<0.04

== 09.2 paged attention vs contiguous ==
L=40 max|diff|=~1e-7

== 09.3 prefix sharing + copy-on-write ==
system prompt: 500 tokens -> 32 blocks
shared physical blocks (req0 ∩ req1): 31
total blocks used: 42 vs no-sharing 320, saved 278 blocks = 556 МиБ
after base.free(): pool.used=41
Чеклист:
-
waste_ratio < 0.04на 64 последовательностях со случайными длинами; - paged-внимание совпадает с contiguous-эталоном с
atol=1e-5, включая GQA; - у двух форков совпадают первые 31 запись block table, 32-я различается (COW неполного блока префикса);
-
base.free()не освобождает общие блоки — только снимает по ссылке; - после
free()всех запросов пул пуст.
Сводка
- Резервирование KV-кэша под
max_seq_lenоставляет 60–80% памяти пустыми; PagedAttention снижает потери до <4% (SOSP'23). - KV-кэш = виртуальная память: логические блоки по 16 токенов, физические — из общего пула, маппинг в block table (int32, 8 КиБ на 32k контекста).
- Рост последовательности — append без realloc; непрерывность физической памяти не нужна, внутренние потери ≤ 1 блок (2 МиБ) на последовательность.
- Prefix sharing: форк копирует block table и инкрементирует refcount; запись в общий блок — через copy-on-write. 10 запросов с общим системным промптом 512 токенов экономят 556 МиБ.
- Декод-внимание по страницам — цикл по block table с online-softmax: та же схема, что в paged-attention ядре vLLM и FlashAttention.
- RadixAttention (SGLang, RadixArk) идёт дальше PagedAttention: radix-дерево + LRU удерживают общие префиксы между запросами; цена — память (vLLM ~70 ГБ против ~56 ГБ у SGLang из-за преаллокации KV).
- Attention backend'ы vLLM — FLASH_ATTN (дефолт) и FLASHINFER; для MLA-моделей дефолтные paged-кернелы заменяются ThunderMLA/FlexDecoding.
- Квантование KV per-block/per-head (int8/FP8) удваивает плотность кэша при просадке качества ≤ 0.2 perplexity; дальше идут per-token scales, Hadamard-ротация и кодбуки — 2-битный KV в reasoning-декодинге рабочий режим (KVarN, TurboQuant).
- Ёмкость KV-памяти при memory-bound декоде = throughput: больше последовательностей в пуле — больше токенов/с на батч.
Навигация по курсу: Хаб курса · Предыдущий: Continuous batching и чанкерная префилла · Следующий: Дистрибуция и спекулятивный декодинг