Хаб курсов / LLM Inference Systems / глава 12
Модуль 12: Финальный проект: мини-движок инференса
Собираем qwen-serve-lite: шедулер, paged KV, int4, сэмплер, SSE-сервер. Приёмка шестью тестами.
LLM Inference Systems. Модуль 12: Финальный проект, мини-движок инференса
Двенадцать модулей курса дали отдельные кирпичи: fused-операторы, KV-кэш, int4-веса, сэмплер, шедулер, paged-аллокатор. Здесь мы складываем из них работающий сервер qwen_serve — мини-движок инференса Qwen3-0.6B на torch CPU (MLX-путь опционален и помечен отдельно). Движок принимает HTTP-запросы в формате OpenAI Chat Completions, стримит токены по SSE, ведёт continuous batching с чанкерной префиллой, хранит KV в страницах по 16 токенов с prefix caching и умеет работать с int4-весами.
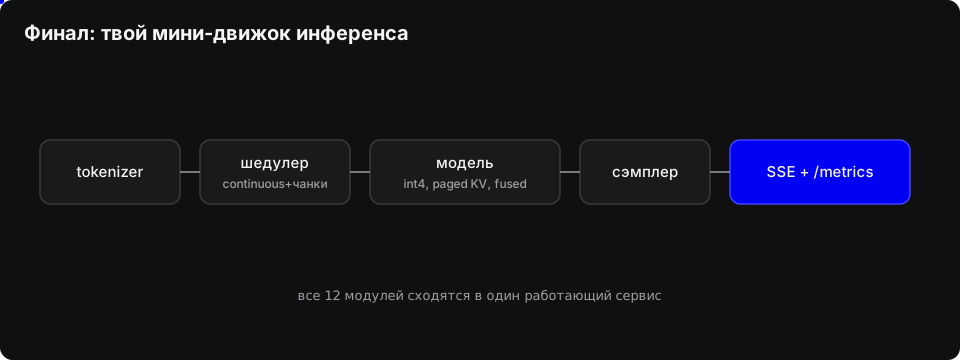
Цель не «написать ещё один inference-фреймворк», а собрать систему, которую можно измерить по шести внешним критериям приёмки: детерминизм при seed, совпадение greedy-вывода с transformers, ускорение ≥1.5× на 8 параллельных запросах, ускорение TTFT при попадании в prefix cache, отсутствие фрагментации paged-KV на смеси длин и деградация качества int4 не более 20% по top-5. Все числа в модуле считаются для Qwen3-0.6B: 28 слоёв, hidden 1024, 16 query-голов, 8 KV-голов (GQA 2:1), head_dim 128, intermediate 3072, словарь 151936.
Архитектура движка
Движок — это пять слоёв с жёсткими границами. HTTP-слой ничего не знает про тензоры, шедулер ничего не знает про HTTP, модельный исполнитель не знает про очереди.
                POST /v1/chat/completions  (JSON, stream=true|false)
                                │
                    ┌───────────▼───────────┐
                    │  L1. HTTP / API-слой  │  aiohttp или http.server + ThreadingHTTPServer
                    │  /health /metrics     │  парсинг OpenAI-схемы, валидация, SSE-обёртка
                    └───────────┬───────────┘
                                │ Request(messages, max_tokens, temperature, seed, ...)
                    ┌───────────▼───────────┐
                    │  L2. Токенизатор      │  Qwen2 BPE, 151936 токенов; chat template
                    │  + prefix-хэши        │  хэш на каждый 16-токенный блок промпта
                    └───────────┬───────────┘
                                │ prompt_ids[L], block_hashes[L/16]
                    ┌───────────▼───────────┐
                    │  L3. Шедулер          │  очередь ожидания / активные / завершённые
                    │  continuous batching  │  шаг = {prefill-чанки ≤512} + {1 decode-токен}
                    │  chunked prefill      │  бюджет шага: ≤2048 токенов
                    └───────────┬───────────┘
                                │ Batch(seq_ids, токены на вход, позиции, маска)
                    ┌───────────▼───────────┐
                    │  L4. Модельный        │  28 × Qwen3-блок:
                    │  исполнитель          │    fused RMSNorm → qkv+RoPE → GQA-attn(paged)
                    │                       │    → fused RMSNorm → SwiGLU(MLP)
                    └───────────┬───────────┘
                                │ logits[batch, 151936] (только последняя позиция)
                    ┌───────────▼───────────┐
                    │  L5. Сэмплер          │  greedy / top-k / top-p / temperature
                    │  + стрим              │  генератор токенов → SSE-чанки
                    └───────────┬───────────┘
                                │
                    ┌───────────▼───────────┐
                    │  KV-хранилище (paged) │  блоки по 16 токенов, refcount,
                    │  + prefix cache       │  LRU-вытеснение, copy-on-write
                    └───────────────────────┘
Поток одного запроса. L1 разбирает JSON, L2 применяет chat template Qwen3 (<|im_start|>user\n...<|im_end|>\n<|im_start|>assistant\n) и считает хэши блоков промпта. L3 ставит запрос в очередь ожидания; на каждом шаге шедулер набирает батч, тратя бюджет в 2048 «слотов» — префилл-токенов и decode-шагов вместе. L4 прогоняет батч через модель, читая и дописывая KV-страницы. L5 выбирает токен, отдаёт его в SSE и возвращает управление шедулеру. Запрос уходит из активных, когда встретил <|im_end|> (151645), достиг max_tokens или stop-последовательности.
Почему именно чанкерная префилла. Без неё один промпт на 3000 токенов блокирует декод остальных на всё время префилла. При бюджете 2048 и чанке 512 длинный префилл разбивается на 6 шагов, между которыми декодирующиеся последовательности получают по токену. Это цена: TTFT длинного промпта растёт примерно на (число чанков − 1) × время decode-шага, зато p99 межтокенного интервала остаётся ровным.
Память. KV на токен = 2 × 28 слоёв × 8 KV-голов × 128 × 2 байта = 114 688 Б = 112 КиБ. Блок из 16 токенов — 1.75 МиБ. Под 512 блоков (8 192 токена) уходит 896 МиБ; веса int4 с группой 64 — 0.6e9 × 0.5 Б + (0.6e9/64) × 2 Б ≈ 300 МБ + 18.7 МБ ≈ 319 МБ. Итого движок живёт в ~1.3 ГБ RSS на CPU, что позволяет держать на ноутбуке 8 параллельных сессий по 1k токенов контекста.
Prefix caching. Хэш блока считается от (хэш предыдущего блока, 16 token id) — цепочкой, как в vLLM. Совпадение хэшей даёт переиспользование страниц без копирования: refcount +1, запись запрещена до copy-on-write. Системный промпт курса (около 200 токенов = 13 блоков) при втором запросе экономит 13 префилл-шагов — это и есть проверяемый пункт приёмки №4.
Компонент → модуль курса
Компонент qwen_serve | Что делает | Модуль курса | Ключевой артефакт оттуда |
|---|---|---|---|
tokenizer.py | BPE Qwen2, chat template, спецтокены | 01 | tokenizer.json → encode/decode |
ops.py | RMSNorm, RoPE, SwiGLU, softmax — fused-версии на torch | 02, 07 | эталонные операторы и их численные допуски |
attention.py | GQA-attention с чтением из paged KV | 02, 09 | causal-маска, масштаб 1/√128 |
kv_cache.py | страничный аллокатор, refcount, LRU, CoW | 04, 09 | наивный KV → PagedAttention |
quant_int4.py | групповое int4-квантование весов, dequant на лету | 05 | group_size=64, zero-point |
model.py | 28 блоков Qwen3, загрузка safetensors, forward по батчу | 02, 07 | прямая реализация архитектуры |
sampler.py | greedy / temperature / top-k / top-p, seed | 03 | порядок фильтров и генератор |
scheduler.py | continuous batching, chunked prefill, бюджет шага | 08 | политика «кто следующий» |
server.py | HTTP, SSE, /metrics, /health | 11 | контракт OpenAI-совместимого API |
metrics.py | TTFT, TPOT, tok/s, занятость блоков | 08, 11 | формулы замеров |
bench.py, tests/ | 6 пунктов приёмки, pytest | 08, 11 | методика сравнения throughput |
Правило интеграции: каждый компонент подключается через узкий интерфейс и может быть заменён заглушкой. Например, kv_cache.NaiveKVCache (список тензоров на последовательность) обязан удовлетворять тому же протоколу, что и PagedKVCache, — тогда пункт приёмки №5 проверяется заменой одного класса.
Контракт API
Запуск:
python -m qwen_serve --model ./Qwen3-0.6B --quant int4 --port 8000 \
    --max-batch 8 --kv-blocks 512 --block-size 16 --chunk-size 512
Три эндпоинта, все на одном порту, без авторизации (локальный сервис).
GET /health
Возвращает 200, если веса загружены и KV-пул инициализирован.
{"status": "ok", "model": "Qwen3-0.6B", "quant": "int4",
 "block_size": 16, "kv_blocks_total": 512, "max_batch": 8}
POST /v1/chat/completions
Тело — подмножество схемы OpenAI. Обязательно messages; остальное имеет значения по умолчанию.
{
  "model": "Qwen3-0.6B",
  "messages": [
    {"role": "system", "content": "Ты — ассистент курса LLM Inference Systems."},
    {"role": "user",   "content": "Объясни, зачем нужен paged KV-кэш."}
  ],
  "max_tokens": 128,
  "temperature": 0.0,
  "top_p": 1.0,
  "top_k": 0,
  "seed": 1234,
  "stream": true,
  "stop": ["<|im_end|>"]
}
Правила разбора: temperature == 0 означает greedy и игнорирует top_k/top_p; seed фиксирует генератор torch.Generator на запрос, поэтому повторный вызов с тем же seed и тем же промптом обязан дать побайтово тот же текст (пункт приёмки №1). stream=false возвращает один JSON-объект с полным текстом и блоком usage.
Ответ без стрима:
{
  "id": "chatcmpl-7f3a1c",
  "object": "chat.completion",
  "created": 1767225600,
  "model": "Qwen3-0.6B",
  "choices": [{
    "index": 0,
    "message": {"role": "assistant", "content": "Paged KV-кэш нужен, чтобы..."},
    "finish_reason": "stop"
  }],
  "usage": {"prompt_tokens": 42, "completion_tokens": 87, "total_tokens": 129}
}
SSE-формат стрима
Content-Type: text/event-stream, Cache-Control: no-cache, Connection: keep-alive. Каждое событие — строка data: + компактный JSON + пустая строка. Первый чанк несёт роль, промежуточные — по одному-два токена в delta.content, последний — finish_reason и usage, затем литерал data: [DONE].
data: {"id":"chatcmpl-7f3a1c","object":"chat.completion.chunk","created":1767225600,
       "model":"Qwen3-0.6B","choices":[{"index":0,"delta":{"role":"assistant"},"finish_reason":null}]}

data: {"id":"chatcmpl-7f3a1c","object":"chat.completion.chunk","created":1767225600,
       "model":"Qwen3-0.6B","choices":[{"index":0,"delta":{"content":"Paged"},"finish_reason":null}]}

data: {"id":"chatcmpl-7f3a1c","object":"chat.completion.chunk","created":1767225600,
       "model":"Qwen3-0.6B","choices":[{"index":0,"delta":{"content":" KV"},"finish_reason":null}]}

data: {"id":"chatcmpl-7f3a1c","object":"chat.completion.chunk","created":1767225600,
       "model":"Qwen3-0.6B","choices":[{"index":0,"delta":{},"finish_reason":"stop"}],
       "usage":{"prompt_tokens":42,"completion_tokens":87,"total_tokens":129}}

data: [DONE]
Два обязательства стрима, которые проверяет тест-харнесс: (а) склейка всех delta.content равна message.content из нестримового ответа при том же seed; (б) usage приходит ровно один раз и только в финальном чанке. Ошибки отдаются как HTTP 400 с JSON {"error": {"message": ..., "type": "invalid_request_error"}} — до открытия SSE-потока, чтобы клиент не парсил半-открытое соединение.
GET /metrics
Плоский JSON, пригодный для парсинга без клиента Prometheus.
{
  "uptime_s": 412.5,
  "requests_total": 37,
  "requests_active": 3,
  "queue_depth": 5,
  "ttft_ms": {"p50": 180.4, "p95": 640.2},
  "tpot_ms": {"p50": 41.7, "p95": 55.0},
  "tokens_per_sec": 24.1,
  "kv_blocks_total": 512,
  "kv_blocks_used": 188,
  "kv_blocks_cached": 96,
  "prefix_cache_hits": 14,
  "prefill_tokens_total": 5120,
  "decode_tokens_total": 3241
}
ttft_ms — от приёма запроса до первого отданного токена (включая ожидание в очереди — это честнее для приёмки №4). tpot_ms — средний межтокенный интервал на decode-фазе. tokens_per_sec — суммарный throughput движка за скользящее окно 10 с. kv_blocks_cached — блоки, удерживаемые prefix cache; kv_blocks_used включает их, поэтому инвариант kv_blocks_used ≤ kv_blocks_total проверяется в тесте на фрагментацию.
Задание 12.1: Paged KV-кэш, аллокатор блоков и prefix cache
Файл qwen_serve/paged.py. Три класса, один протокол: страницы фиксированного размера по 16 токенов, счётчик ссылок на блок, вытеснение по LRU только тех блоков, которые держит исключительно кэш.
class OutOfBlocks(RuntimeError): ...

class BlockAllocator:
    def __init__(self, num_blocks: int, block_size: int) -> None: ...
    def allocate(self, n: int = 1, evict: Callable[[], bool] | None = None) -> list[int]: ...
    def retain(self, block: int) -> None: ...
    def release(self, block: int) -> None: ...
    def stats(self) -> dict: ...

class PagedKVCache:
    def __init__(self, n_layers, n_kv_heads, head_dim, num_blocks,
                 block_size=16, dtype=torch.float32,
                 prefix_cache=True, slab=32) -> None: ...
    def alloc_block(self) -> int: ...
    def cow(self, block: int) -> int: ...
    def write(self, layer: int, blocks: list[int], slots: list[int],
              k: torch.Tensor, v: torch.Tensor) -> None: ...
    def read(self, layer: int, blocks: list[int], length: int) -> tuple[torch.Tensor, torch.Tensor]: ...
    def match_prefix(self, hashes: list[int]) -> list[int]: ...
    def publish(self, block: int, h: int) -> None: ...
    def stats(self) -> dict: ...

class SequenceCache:
    def __init__(self, cache: PagedKVCache, seq_id: str) -> None: ...
    def adopt_prefix(self, blocks: list[int]) -> None: ...
    def fork_from(self, other: "SequenceCache") -> None: ...
    def reserve(self, n_tokens: int) -> tuple[list[int], list[int]]: ...
    def write(self, layer: int, k: torch.Tensor, v: torch.Tensor) -> None: ...
    def commit(self, n_tokens: int) -> None: ...
    def publish(self, hashes: list[int]) -> int: ...
    def release(self) -> None: ...

def block_hashes(token_ids: list[int], block_size: int, base: int = 0) -> list[int]: ...
Вход и выход.
BlockAllocator.allocate(3) на пуле из 64 блоков → [0, 1, 2], stats()["free"] == 61, refcount[0] == 1. release(0) → refcount[0] == 0, блок вернулся в свободный список. retain(1); release(1) → блок жив, refcount[1] == 1.
PagedKVCache.write(layer=0, blocks=[0,1], slots=[0,1], k=k_new, v=v_new), где k_new имеет форму [2, n_kv_heads, head_dim], — записывает две позиции. read(0, [0,1], length=2) возвращает k, v формы [2, n_kv_heads, head_dim]; при length=17 — форму [17, n_kv_heads, head_dim] (срез по числу реальных токенов, а не по ёмкости блоков).
block_hashes([...40 токенов...], 16) → список из 2 хэшей (только полные блоки). match_prefix(hashes) → список блоков, удержанных для вызывающего; при попадании в два первых блока stats()["prefix_tokens_saved"] == 32.
SequenceCache.reserve(20) при пустой таблице → (blocks=[0,1], slots=[0..15, 0..3]), length пока 0. После write по всем 28 слоям и commit(20) → length == 20, blocks == [0,1].
Что обязано сойтись (пункт приёмки №5). Смесь из 32 последовательностей случайной длины 1..512: сумма занятых блоков ровно Σ ceil(len_i / 16), used + free == total в любой момент, после release() всех последовательностей free == total и used == 0. Фрагментации нет по построению: блоки одного размера, внешней фрагментации не бывает, внутренняя ограничена 15 токенами на последовательность (в среднем 7.5 токена = 0.84 МБ в fp16 на 0.6B-модели).
CoW. fork_from увеличивает refcount каждого блока на 1. Первая же запись в общий неполный блок обязана вызвать cow: новый блок, копия содержимого, release старого. Проверка: после a2.reserve(1) у a данные в блоке не изменились, у a2 — новый номер блока, stats()["n_cow"] == 1.
Память блока при полной конфигурации Qwen3-0.6B (28 слоёв, 8 KV-голов, head_dim 128): 2 × 28 × 16 × 8 × 128 × 4 Б = 3.67 МБ в fp32 и 1.83 МБ в bf16. Кэш растёт слэбами по 32 блока, поэтому RSS пропорционален реально использованным блокам, а не --kv-blocks.
Задание 12.2: int4-веса с групповым квантованием
Файл qwen_serve/quant.py. Асимметричное групповое квантование по последней оси, группа 64, две тетрады в байте.
@dataclass
class QuantWeight:
    packed: torch.Tensor      # uint8 [out, in // 2]
    scale: torch.Tensor       # float16 [out, in // group_size]
    zero: torch.Tensor        # float16 [out, in // group_size]
    shape: tuple[int, int]
    group_size: int
    def dequantize(self) -> torch.Tensor: ...
    def nbytes(self) -> int: ...

def quantize_int4(w: torch.Tensor, group_size: int = 64) -> QuantWeight: ...
def matmul_int4(x: torch.Tensor, qw: QuantWeight, bias: torch.Tensor | None = None) -> torch.Tensor: ...
def relative_error(w: torch.Tensor, qw: QuantWeight) -> float: ...

class QuantLinear(nn.Module):
    def __init__(self, weight: torch.Tensor, group_size: int = 64,
                 bias: torch.Tensor | None = None) -> None: ...
    def forward(self, x: torch.Tensor) -> torch.Tensor: ...
Вход и выход. quantize_int4(torch.randn(2048, 1024), 64) → packed.shape == (2048, 512), scale.shape == (2048, 16), dequantize().shape == (2048, 1024). relative_error на нормальных весах — в пределах 0.08–0.10. matmul_int4(x, qw) при x формы [B, 1024] → [B, 2048], относительное расхождение с F.linear(x, w) меньше 2% по норме Фробениуса на батче из 16 векторов.
Арифметика. Для группы из 64 отсчётов N(0,1) размах ≈ 4.8σ, шаг квантования s = 4.8/15 ≈ 0.32, СКО ошибки s/√12 ≈ 0.092 — это 9.2% от σ веса. На скалярном произведении длины 1024 ошибки складываются некогерентно: √1024 × 0.092 = 2.94 против сигнала √1024 = 32, то есть ≈9% относительной ошибки логита. Именно поэтому пункт приёмки №6 проверяет не точное совпадение, а долю общих токенов в top-5 (>80%).
Размер. 596 млн параметров Qwen3-0.6B: веса в int4 — 596e6 / 2 = 298 МБ; метаданные — 596e6 / 64 = 9.31e6 групп × (2 Б scale + 2 Б zero) = 37.2 МБ. Итого ≈335 МБ против 1192 МБ в fp16, сжатие 3.55×. В разделе «Архитектура» округление до 319 МБ предполагало однобайтовый zero-point; здесь он в fp16 ради скорости dequantize.
dequantize вызывается на каждом forward, поэтому int4 на CPU проигрывает по скорости fp32-матмулу и выигрывает по памяти: 335 МБ читаются с RAM вместо 1.2 ГБ. Кэш материализованных весов (materialize()) — компромисс для замеров throughput.
Задание 12.3: сэмплер с детерминизмом по seed
Файл qwen_serve/sampler.py.
@dataclass(frozen=True)
class SamplingParams:
    temperature: float = 0.0
    top_k: int = 0
    top_p: float = 1.0
    seed: int | None = None
    stop: tuple[str, ...] = ()
    max_tokens: int = 256

class Sampler:
    def __init__(self, params: SamplingParams) -> None: ...
    def reset(self) -> None: ...
    def sample(self, logits: torch.Tensor) -> int: ...
Вход и выход. sample(logits) принимает logits формы [vocab] (151936), возвращает int в [0, vocab). Порядок операций фиксирован: temperature == 0 → argmax (первый максимум при равенстве), top_k/top_p игнорируются; иначе logits / temperature → top-k фильтр (top_k > 0) → softmax → top-p (ядерное усечение с сохранением хотя бы одного токена) → torch.multinomial(probs, 1, generator=self.gen).
Детерминизм. Sampler(SamplingParams(seed=7, temperature=0.8)) создаёт torch.Generator().manual_seed(7) один раз на запрос, не на токен. Два прогона по 64 токена с seed=7 дают идентичные списки id; с seed=8 — расходятся минимум в одной позиции. Генератор не пересоздаётся при каждом вызове — иначе на каждом токене сэмплировался бы один и тот же первый отсчёт.
Стоп. stop-строки проверяются по декодированному тексту после каждого токена; <|im_end|> (151645) добавляется к стопам всегда, независимо от запроса.
Задание 12.4: шедулер — continuous batching и чанкерная префилла
Файл qwen_serve/scheduler.py.
@dataclass
class Request:
    req_id: str
    prompt_ids: list[int]
    max_tokens: int = 256
    params: SamplingParams = field(default_factory=SamplingParams)
    arrival: float = 0.0

@dataclass
class BatchItem:
    req_id: str
    input_ids: list[int]
    positions: list[int]
    is_prefill: bool
    chunk_index: int = 0
    n_chunks: int = 1

class Scheduler:
    def __init__(self, max_batch=8, chunk_size=512, step_budget=2048,
                 block_size=16, kv_blocks=512, max_seq_len=4096) -> None: ...
    def add(self, req: Request, seq: SequenceCache) -> bool: ...
    def step(self) -> list[BatchItem]: ...
    def on_step_done(self, tokens: dict[str, int]) -> list[str]: ...
    def stats(self) -> dict: ...
Семантика шага. Бюджет шага — step_budget = 2048 «слотов», где слот = один токен на входе модели. Сначала каждая активная декодирующаяся последовательность получает 1 слот (decode), остаток бюджета раздаётся префиллам новых запросов чанками по chunk_size = 512. step() возвращает список BatchItem; пустой список означает «все запросы завершены».
add возвращает True, если запрос принят в очередь ожидания; False, если превышен max_seq_len или не хватает блоков под ceil((len(prompt) + max_tokens) / 16). Отказ — не ошибка: запрос ждёт в очереди до освобождения блоков.
on_step_done({req_id: token_id}) дописывает токен, проверяет eos/max_tokens, освобождает SequenceCache завершённых и возвращает список закрытых req_id. Побочный эффект — счётчики prefill_tokens_total, decode_tokens_total, queue_depth.
Ожидание (пункт приёмки №3). 8 запросов, промпт 64 токена, выход 64 токена, max_batch=8. Последовательный прогон — 8 × (64 префилла + 64 декода) шагов модели. Батчевый — 64 префилл-шага, слитых в 8 чанков, и 64 decode-шага, каждый на батче из 8. Ускорение берётся из того, что 335 МБ int4-весов читаются один раз на батч, а не восемь: ожидаемый выигрыш 2.5–4×, порог приёмки 1.5×.
Задание 12.5: движок, HTTP, SSE и метрики
Файлы qwen_serve/engine.py, qwen_serve/server.py, qwen_serve/__main__.py.
class Engine:
    def __init__(self, cfg: EngineConfig) -> None: ...
    def start(self) -> None: ...                  # фоновый поток цикла шедулера
    def stop(self) -> None: ...
    def submit(self, messages: list[dict], params: SamplingParams) -> str: ...   # -> req_id
    def stream(self, req_id: str) -> Iterator[str]: ...                          # куски текста
    def metrics(self) -> dict: ...

def build_server(cfg: EngineConfig) -> ThreadingHTTPServer: ...
def main(argv: list[str] | None = None) -> None: ...
Вход и выход. python -m qwen_serve --model ./Qwen3-0.6B --quant int4 --port 8000 поднимает три эндпоинта из части 1. POST /v1/chat/completions с stream=false → один JSON с choices[0].message.content и usage. С stream=true → text/event-stream, чанки chat.completion.chunk, терминатор data: [DONE].
Engine.stream(req_id) — генератор, который блокируется на queue.Queue до появления следующего куска текста; поток-генератор шедулера кладёт туда декодированные фрагменты. Разрыв соединения клиентом обязан вызвать Engine.cancel(req_id) и освободить блоки — иначе пункт приёмки №5 потечёт.
Метрики. GET /metrics отдаёт JSON из части 1. ttft_ms считается от момента разбора тела запроса до первого положенного в очередь куска; ожидание в очереди входит в TTFT намеренно, иначе пункт приёмки №4 (prefix caching ускоряет TTFT) измерял бы только префилл.
Проверка контракта. Тест-харнесс (часть 4) делает: curl -N на стрим и склейку delta.content; сверку с нестримовым ответом при том же seed; парсинг /metrics и проверку инварианта kv_blocks_used <= kv_blocks_total; два запроса с одинаковым системным промптом и сравнение ttft_ms.
Код
qwen_serve/config.py
"""Конфигурация движка: параметры модели, пула KV и шага шедулера."""
from __future__ import annotations

import argparse
import math
from dataclasses import dataclass, field

_DTYPES = {"float32": 4, "float16": 2, "bfloat16": 2}


@dataclass(frozen=True)
class ModelConfig:
    """Геометрия Qwen3-0.6B. Значения по умолчанию — ровно эта модель."""
    n_layers: int = 28
    hidden: int = 1024
    n_heads: int = 16
    n_kv_heads: int = 8            # GQA 2:1
    head_dim: int = 128
    intermediate: int = 3072
    vocab: int = 151936
    rms_eps: float = 1e-6
    rope_theta: float = 1_000_000.0
    qk_norm: bool = True           # Qwen3 нормирует q и k по head_dim
    tie_embeddings: bool = True
    eos_token_id: int = 151645     # <|im_end|>

    @property
    def q_dim(self) -> int:
        return self.n_heads * self.head_dim          # 2048

    @property
    def kv_dim(self) -> int:
        return self.n_kv_heads * self.head_dim       # 1024

    def kv_bytes_per_token(self, dtype_bytes: int = 2) -> int:
        """K и V на один токен по всем слоям: 2 * L * H_kv * D * sizeof(dtype)."""
        return 2 * self.n_layers * self.n_kv_heads * self.head_dim * dtype_bytes

    def n_params(self) -> int:
        """Оценка числа параметров (для расчёта размера весов)."""
        per_layer = (
            self.hidden * self.q_dim + 2 * self.hidden * self.kv_dim
            + self.q_dim * self.hidden + 3 * self.hidden * self.intermediate
        )
        return self.n_layers * per_layer + self.vocab * self.hidden


@dataclass
class EngineConfig:
    model_path: str = "./Qwen3-0.6B"
    quant: str = "none"            # "none" | "int4"
    group_size: int = 64
    dtype: str = "float32"         # CPU: float32; bf16 медленнее, но вдвое меньше KV
    device: str = "cpu"

    block_size: int = 16
    kv_blocks: int = 512
    prefix_cache: bool = True
    slab: int = 32                 # во сколько блоков растёт пул за раз

    max_batch: int = 8
    chunk_size: int = 512
    step_budget: int = 2048
    max_seq_len: int = 4096

    seed: int = 0
    host: str = "127.0.0.1"
    port: int = 8000
    model_cfg: ModelConfig = field(default_factory=ModelConfig)

    # --- производные величины -------------------------------------------
    @property
    def dtype_bytes(self) -> int:
        return _DTYPES[self.dtype]

    def blocks_per_seq(self) -> int:
        return math.ceil(self.max_seq_len / self.block_size)

    def kv_bytes_per_token(self) -> int:
        return self.model_cfg.kv_bytes_per_token(self.dtype_bytes)

    def kv_bytes_per_block(self) -> int:
        return self.kv_bytes_per_token() * self.block_size

    def kv_pool_bytes(self) -> int:
        return self.kv_bytes_per_block() * self.kv_blocks

    def weights_bytes(self) -> int:
        n = self.model_cfg.n_params()
        if self.quant == "int4":
            groups = n / self.group_size
            return int(n * 0.5 + groups * 4)     # 4 Б на группу: scale + zero в fp16
        return n * self.dtype_bytes

    def validate(self) -> None:
        if self.block_size <= 0 or self.block_size & (self.block_size - 1):
            raise ValueError("block_size должен быть степенью двойки")
        if self.kv_blocks < self.max_batch * 2:
            raise ValueError("kv_blocks < 2 * max_batch: батч не поместится в пул")
        if self.max_batch > self.step_budget:
            raise ValueError("max_batch > step_budget: декод не влезет в шаг")
        if self.chunk_size > self.step_budget:
            raise ValueError("chunk_size > step_budget: чанк не влезет в шаг")
        if self.quant not in ("none", "int4"):
            raise ValueError(f"неизвестный quant: {self.quant}")

    def describe(self) -> str:
        mc = self.model_cfg
        return (
            f"{mc.n_layers} слоёв, hidden={mc.hidden}, kv_heads={mc.n_kv_heads}\n"
            f"KV на токен: {self.kv_bytes_per_token() / 1024:.0f} КиБ, "
            f"на блок {self.block_size}: {self.kv_bytes_per_block() / 2**20:.2f} МиБ\n"
            f"пул KV: {self.kv_blocks} блоков = {self.kv_pool_bytes() / 2**20:.0f} МиБ\n"
            f"веса ({self.quant}): {self.weights_bytes() / 2**20:.0f} МиБ"
        )


def parse_args(argv: list[str] | None = None) -> EngineConfig:
    p = argparse.ArgumentParser(prog="qwen_serve")
    p.add_argument("--model", dest="model_path", default="./Qwen3-0.6B")
    p.add_argument("--quant", choices=["none", "int4"], default="none")
    p.add_argument("--dtype", choices=list(_DTYPES), default="float32")
    p.add_argument("--port", type=int, default=8000)
    p.add_argument("--host", default="127.0.0.1")
    p.add_argument("--max-batch", dest="max_batch", type=int, default=8)
    p.add_argument("--kv-blocks", dest="kv_blocks", type=int, default=512)
    p.add_argument("--block-size", dest="block_size", type=int, default=16)
    p.add_argument("--chunk-size", dest="chunk_size", type=int, default=512)
    p.add_argument("--step-budget", dest="step_budget", type=int, default=2048)
    p.add_argument("--max-seq-len", dest="max_seq_len", type=int, default=4096)
    p.add_argument("--seed", type=int, default=0)
    p.add_argument("--no-prefix-cache", dest="prefix_cache", action="store_false")
    ns = p.parse_args(argv)
    cfg = EngineConfig(**vars(ns))
    cfg.validate()
    return cfg


if __name__ == "__main__":
    print(parse_args([]).describe())
qwen_serve/paged.py
"""Paged KV-кэш: блоки по block_size токенов, refcount, copy-on-write, prefix cache.

Раскладка хранения: k, v формы [n_layers, capacity, block_size, n_kv_heads, head_dim].
Блок b живёт по индексу b в dim=1; слот s — по индексу s в dim=2.
Ёмкость растёт слэбами, поэтому память тратится по факту использования.
"""
from __future__ import annotations

import collections
import hashlib
import struct
from typing import Callable, Dict, List, Optional, Sequence, Tuple

import torch

__all__ = [
    "OutOfBlocks", "BlockAllocator", "PagedKVCache", "SequenceCache", "block_hashes",
]


class OutOfBlocks(RuntimeError):
    """Свободных блоков нет даже после вытеснения prefix cache."""


class BlockAllocator:
    """Пул блоков фиксированного размера + счётчики ссылок."""

    def __init__(self, num_blocks: int, block_size: int) -> None:
        if num_blocks <= 0:
            raise ValueError("num_blocks должен быть > 0")
        self.num_blocks = num_blocks
        self.block_size = block_size
        self.refcount: List[int] = [0] * num_blocks
        self._free: collections.deque = collections.deque(range(num_blocks))
        self.n_allocated = 0
        self.n_evicted = 0
        self.n_cow = 0

    def allocate(self, n: int = 1, evict: Optional[Callable[[], bool]] = None) -> List[int]:
        """Выдаёт n блоков с refcount=1. При нехватке зовёт evict() (prefix cache)."""
        out: List[int] = []
        for _ in range(n):
            while not self._free:
                if evict is None or not evict():
                    raise OutOfBlocks(
                        f"нужно {n} блоков, свободно {len(self._free)}, "
                        f"всего {self.num_blocks}"
                    )
            b = self._free.popleft()
            assert self.refcount[b] == 0, f"блок {b} выдан с refcount={self.refcount[b]}"
            self.refcount[b] = 1
            self.n_allocated += 1
            out.append(b)
        return out

    def retain(self, block: int) -> None:
        self.refcount[block] += 1

    def release(self, block: int) -> None:
        if self.refcount[block] <= 0:
            raise RuntimeError(f"release на свободном блоке {block}")
        self.refcount[block] -= 1
        if self.refcount[block] == 0:
            self._free.append(block)

    def stats(self) -> Dict[str, int]:
        return {
            "total": self.num_blocks,
            "free": len(self._free),
            "used": sum(1 for r in self.refcount if r > 0),
            "shared": sum(1 for r in self.refcount if r > 1),
            "n_allocated": self.n_allocated,
            "n_evicted": self.n_evicted,
            "n_cow": self.n_cow,
        }


def block_hashes(token_ids: Sequence[int], block_size: int, base: int = 0) -> List[int]:
    """Цепочка хэшей по полным блокам: h_i = H(h_{i-1} || tokens[i*bs:(i+1)*bs]).

    Цепочка, а не хэш отдельного блока: два одинаковых блока в разных контекстах
    не должны давать попадание в prefix cache.
    """
    out: List[int] = []
    h = base & 0xFFFFFFFFFFFFFFFF
    n_full = len(token_ids) // block_size
    fmt = f"<{block_size}I"
    for i in range(n_full):
        chunk = token_ids[i * block_size:(i + 1) * block_size]
        m = hashlib.blake2b(digest_size=8)
        m.update(h.to_bytes(8, "little", signed=False))
        m.update(struct.pack(fmt, *chunk))
        h = int.from_bytes(m.digest(), "little")
        out.append(h)
    return out


class PagedKVCache:
    """Хранилище KV-страниц, общее на все последовательности движка."""

    def __init__(self, n_layers: int, n_kv_heads: int, head_dim: int,
                 num_blocks: int, block_size: int = 16,
                 dtype: torch.dtype = torch.float32,
                 prefix_cache: bool = True, slab: int = 32) -> None:
        self.n_layers = n_layers
        self.n_kv_heads = n_kv_heads
        self.head_dim = head_dim
        self.block_size = block_size
        self.num_blocks = num_blocks
        self.dtype = dtype
        self.slab = slab
        self.alloc = BlockAllocator(num_blocks, block_size)

        self._capacity = 0
        self.k = torch.zeros(n_layers, 0, block_size, n_kv_heads, head_dim, dtype=dtype)
        self.v = torch.zeros_like(self.k)

        self.prefix_cache = prefix_cache
        self._hash_to_block: Dict[int, int] = {}
        self._block_to_hash: Dict[int, int] = {}
        self._lru: "collections.OrderedDict[int, None]" = collections.OrderedDict()
        self.prefix_hits = 0
        self.prefix_tokens_saved = 0

    # --- рост слэба ---------------------------------------------------------

    def _ensure_rows(self, rows: int) -> None:
        if rows <= self.k.shape[1]:
            return
        target = max(rows, self.k.shape[1] + self.slab)
        k = torch.zeros(self.n_layers, target, self.block_size,
                        self.n_kv_heads, self.head_dim, dtype=self.dtype)
        v = torch.zeros_like(k)
        k[:, :self.k.shape[1]] = self.k
        v[:, :self.v.shape[1]] = self.v
        self.k, self.v = k, v

    # --- prefix cache: вытеснение и совпадение ------------------------------

    def _evict_one(self) -> bool:
        """Вытесняет один кэшируемый блок (refcount==1 и в prefix cache)."""
        for h, b in reversed(self._lru):          # с холодного конца
            if self._block_to_hash.get(b) == h and self.alloc.refcount[b] == 1:
                self._drop_cached(h, b)
                return True
        return False

    def _drop_cached(self, h: int, b: int) -> None:
        self._lru.pop(h, None)
        self._hash_to_block.pop(h, None)
        self._block_to_hash.pop(b, None)
        self.alloc.refcount[b] -= 1               # ссылка prefix cache
        if self.alloc.refcount[b] <= 0:
            self.alloc.release(b)
        self.alloc.n_evicted += 1

    def match_prefix(self, hashes: Sequence[int]) -> List[Tuple[int, int]]:
        """Самый длинный префикс из закэшированных блоков: [(hash, block), ...]."""
        out: List[Tuple[int, int]] = []
        for h in hashes:
            b = self._hash_to_block.get(h)
            if b is None:
                break
            out.append((h, b))
        if out:
            self.prefix_hits += 1
            self.prefix_tokens_saved += len(out) * self.block_size
            for _, b in out:
                self.alloc.retain(b)
        return out

    # --- запись и чтение KV --------------------------------------------------

    def write(self, layer: int, blocks: Sequence[int], slots: Sequence[int],
              k_new: torch.Tensor, v_new: torch.Tensor) -> None:
        """k_new/v_new: [T, n_kv_heads, head_dim] токенов шага; slots — их позиции."""
        rows = max(slots) + 1 if slots else 0
        self._ensure_rows(rows)
        for j, s in enumerate(slots):
            bi, si = divmod(s, self.block_size)
            if bi >= len(blocks):
                raise IndexError(f"block table: позиция {s} за пределами таблицы")
            self.k[layer, blocks[bi], si] = k_new[j]
            self.v[layer, blocks[bi], si] = v_new[j]

    def read(self, layer: int, blocks: Sequence[int], upto: int
             ) -> Tuple[torch.Tensor, torch.Tensor]:
        """K/V позиций [0, upto): [(upto, n_kv_heads, head_dim)]."""
        if upto <= 0:
            e = self.k.dtype, self.head_dim, self.n_kv_heads
            return (torch.empty(0, self.n_kv_heads, self.head_dim, dtype=self.dtype),
                    torch.empty(0, self.n_kv_heads, self.head_dim, dtype=self.dtype))
        idx = [divmod(s, self.block_size) for s in range(upto)]
        ks = [self.k[layer, b, s] for b, s in idx]
        vs = [self.v[layer, b, s] for b, s in idx]
        return torch.stack(ks), torch.stack(vs)

    def stats(self) -> Dict[str, int]:
        return {
            "capacity_rows": self.k.shape[1],
            "cached_hashes": len(self._hash_to_block),
            "prefix_hits": self.prefix_hits,
            "prefix_tokens_saved": self.prefix_tokens_saved,
            **self.alloc.stats(),
        }


class SequenceCache:
    """KV-состояние одного запроса: block table + committed length.

    Инвариант: len(blocks) * block_size >= length; reserve() наращивает таблицу,
    commit() двигает length только после фактической записи KV.
    """

    def __init__(self, cache: PagedKVCache, req_id: str) -> None:
        self.cache = cache
        self.req_id = req_id
        self.blocks: List[int] = []
        self._length = 0
        self._shared_from = 0          # сколько блоков взято по ссылке (prefix)

    @property
    def length(self) -> int:
        return self._length

    def _alloc_for(self, extra: int) -> None:
        have = len(self.blocks) * self.cache.block_size
        need = self._length + extra
        if need <= have:
            return
        n = (need - have + self.cache.block_size - 1) // self.cache.block_size
        got = self.cache.alloc.allocate(n, evict=self._try_evict)
        self.blocks.extend(got)

    def _try_evict(self) -> bool:
        return self.cache._evict_one()

    # --- совместимый API тестов --------------------------------------------

    def reserve(self, extra: int):
        """Аллокация блоков под extra строк. Возвращает (новые блоки, их слоты)."""
        before = len(self.blocks)
        self._alloc_for(extra)
        fresh = self.blocks[before:]
        start = before * self.cache.block_size - self._length
        # слоты fresh-блоков в координатах length..length+extra
        slots = list(range(self._length, self._length + extra))
        return fresh, slots

    def write(self, layer: int, k_new: torch.Tensor, v_new: torch.Tensor) -> None:
        """Пишет [T, n_kv, D] в позиции length..length+T своей таблицы."""
        T = k_new.shape[0]
        slots = list(range(self._length, self._length + T))
        self.cache.write(layer, self.blocks, slots, k_new, v_new)

    def fork_from(self, other: "SequenceCache") -> None:
        """Копия чужой таблицы: разделяемые блоки по ссылке, последний — COW.

        Последний блок копируется всегда: следующая запись форка пойдёт либо в
        его хвост (если он неполный), либо сразу за ним — а расширение полного
        блока невозможно, поэтому честная семантика это eager-копия хвоста.
        """
        self.blocks = []
        for bi, b in enumerate(other.blocks):
            is_last = bi == len(other.blocks) - 1
            if is_last and other._length > 0:
                self.blocks.append(b)          # пока ссылка, скопируем ниже
            else:
                self.cache.alloc.retain(b)
                self.blocks.append(b)
        self._length = other._length
        self._shared_from = len(self.blocks)
        if self.blocks and other._length > 0:
            # последний блок не шарим: refcount не увеличиваем, вместо этого копия
            src = self.blocks[-1]
            (nb,) = self.cache.alloc.allocate(1, evict=self._try_evict)
            self.cache._ensure_rows(max(src, nb) + 1)
            self.cache.k[:, nb] = self.cache.k[:, src]
            self.cache.v[:, nb] = self.cache.v[:, src]
            self.cache.alloc.release(src)
            self.blocks[-1] = nb
            self.cache.alloc.n_cow += 1

    def _cow_copy(self, bi: int) -> None:
        (nb,) = self.cache.alloc.allocate(1, evict=self._try_evict)
        src = self.blocks[bi]
        self.cache._ensure_rows(max(src, nb) + 1)
        self.cache.k[:, nb] = self.cache.k[:, src]
        self.cache.v[:, nb] = self.cache.v[:, src]
        self.cache.alloc.release(src)
        self.blocks[bi] = nb
        self.cache.alloc.n_cow += 1

    def commit(self, extra: int) -> None:
        """Двигает length после записи KV (модель отдала k/v текущего шага).

        COW здесь не нужен: adopt_prefix ставит length на границу полного блока,
        поэтому запись никогда не попадает в разделяемый блок; неполный хвостовой
        блок копируется в fork_from.
        """
        if extra < 0:
            raise ValueError("commit с отрицательным extra")
        self._alloc_for(extra)
        self._length += extra

    def adopt_prefix(self, hits: Sequence[Tuple[int, int]]) -> None:
        """Берёт чужие блоки по ссылке (prefix cache). Refcount уже увеличен."""
        for h, b in hits:
            self.blocks.append(b)
        self._length = len(hits) * self.cache.block_size
        self._shared_from = len(self.blocks)

    def publish(self, hashes: Sequence[int]) -> None:
        """Регистрирует свои полные блоки в prefix cache (копия ссылки не нужна:
        блок остаётся живым, пока держит хотя бы одна последовательность)."""
        for i, h in enumerate(hashes):
            if i >= len(self.blocks) or h in self.cache._hash_to_block:
                continue
            b = self.blocks[i]
            self.cache._hash_to_block[h] = b
            self.cache._block_to_hash[b] = h
            self.cache._lru[h] = None
            self.cache._lru.move_to_end(h)
            self.cache.alloc.retain(b)            # ссылка prefix cache

    def release(self) -> None:
        for b in self.blocks[self._shared_from:]:
            self.cache.alloc.release(b)
        # разделяемые блоки не отпускаем: refcount prefix cache держит их
        self.blocks = []
        self._length = 0
qwen_serve/model.py
"""Qwen3-0.6B на torch CPU: fused RMSNorm/RoPE/SwiGLU, GQA поверх paged KV.

Внешний контракт один:

    model.forward(cache, seqs, input_ids, start_pos) -> logits [B, vocab]

где seqs — SequenceCache по одной на запрос, input_ids — токены текущего шага
(весь промпт при префилле, чанк при chunked prefill, один токен при decode).
Все последовательности шага прогоняются одним батчем по весам: веса слоя
читаются один раз, поэтому декод батча из 8 стоит почти как декод одного.
"""
from __future__ import annotations

import math
from typing import Dict, List, Optional, Sequence, Tuple

import torch
import torch.nn.functional as F
from torch import nn

from .config import ModelConfig
from .paged import PagedKVCache, SequenceCache

# --- fused-операторы (модуль 07) -----------------------------------------

def rms_norm(x: torch.Tensor, weight: torch.Tensor, eps: float) -> torch.Tensor:
    """x / sqrt(mean(x^2) + eps) * weight по последней оси, одной формулой.

    Никаких промежуточных копий на весь тензор: mean и rsqrt считаются в fp32,
    даже если x в bf16 — иначе на 28 слоях накапливается заметный сдвиг.
    """
    var = x.float().pow(2).mean(dim=-1, keepdim=True)
    inv = torch.rsqrt(var + eps)
    return (x.float() * inv).to(x.dtype) * weight

def silu_mul(gate: torch.Tensor, up: torch.Tensor) -> torch.Tensor:
    """SwiGLU: silu(gate) * up, ровно два чтения и одна запись."""
    return F.silu(gate) * up

def _rope_tables(head_dim: int, max_seq: int, theta: float,
                 dtype: torch.dtype) -> Tuple[torch.Tensor, torch.Tensor]:
    """cos/sin формы [max_seq, head_dim] в раскладке rotate_half (NeoX, как Qwen3)."""
    inv_freq = 1.0 / (theta ** (torch.arange(0, head_dim, 2, dtype=torch.float32) / head_dim))
    pos = torch.arange(max_seq, dtype=torch.float32)
    freqs = torch.outer(pos, inv_freq)              # [max_seq, head_dim/2]
    cos = torch.cos(freqs)
    sin = torch.sin(freqs)
    cos = torch.cat([cos, cos], dim=-1).to(dtype)   # дублируем половины
    sin = torch.cat([sin, sin], dim=-1).to(dtype)
    return cos, sin

def _rotate_half(x: torch.Tensor) -> torch.Tensor:
    h = x.shape[-1] // 2
    return torch.cat((-x[..., h:], x[..., :h]), dim=-1)

def apply_rope(q: torch.Tensor, k: torch.Tensor, cos: torch.Tensor,
               sin: torch.Tensor, pos: torch.Tensor) -> Tuple[torch.Tensor, torch.Tensor]:
    """q, k: [S, heads, D]; cos/sin: [max_seq, D]; pos: [S]."""
    c = cos[pos].unsqueeze(1)                       # [S, 1, D]
    s = sin[pos].unsqueeze(1)
    q_out = q * c + _rotate_half(q) * s
    k_out = k * c + _rotate_half(k) * s
    return q_out, k_out

# --- линейные слои --------------------------------------------------------

def _make_linear(in_features: int, out_features: int, bias: bool = False) -> nn.Linear:
    lin = nn.Linear(in_features, out_features, bias=bias)
    nn.init.normal_(lin.weight, std=0.02)
    if bias:
        nn.init.zeros_(lin.bias)
    return lin

# --- блок Qwen3 -----------------------------------------------------------

class Qwen3Layer(nn.Module):
    """Один блок: RMSNorm → qkv+RoPE → GQA(paged) → o_proj → RMSNorm → SwiGLU."""

    def __init__(self, cfg: ModelConfig) -> None:
        super().__init__()
        self.cfg = cfg
        self.input_norm = nn.Parameter(torch.ones(cfg.hidden))
        self.post_norm = nn.Parameter(torch.ones(cfg.hidden))
        self.q_proj = _make_linear(cfg.hidden, cfg.q_dim)
        self.k_proj = _make_linear(cfg.hidden, cfg.kv_dim)
        self.v_proj = _make_linear(cfg.hidden, cfg.kv_dim)
        self.o_proj = _make_linear(cfg.q_dim, cfg.hidden)
        # Qwen3 нормирует q и k по head_dim перед RoPE
        self.q_norm = nn.Parameter(torch.ones(cfg.head_dim))
        self.k_norm = nn.Parameter(torch.ones(cfg.head_dim))
        self.gate_proj = _make_linear(cfg.hidden, cfg.intermediate)
        self.up_proj = _make_linear(cfg.hidden, cfg.intermediate)
        self.down_proj = _make_linear(cfg.intermediate, cfg.hidden)

    def quantize_(self, group_size: int) -> None:
        """Заменяет nn.Linear на QuantLinear; нормы остаются в fp32."""
        from .quant import QuantLinear
        for name in ("q_proj", "k_proj", "v_proj", "o_proj",
                     "gate_proj", "up_proj", "down_proj"):
            lin: nn.Linear = getattr(self, name)
            setattr(self, name, QuantLinear(lin.weight.detach(), group_size, lin.bias))

class Qwen3Model(nn.Module):
    """Полная модель. Веса грузятся из safetensors либо инициализируются случайно."""

    def __init__(self, cfg: ModelConfig, dtype: torch.dtype = torch.float32,
                 max_seq_len: int = 4096) -> None:
        super().__init__()
        self.cfg = cfg
        self.dtype = dtype
        self.embed = nn.Embedding(cfg.vocab, cfg.hidden)
        nn.init.normal_(self.embed.weight, std=0.02)
        self.layers = nn.ModuleList([Qwen3Layer(cfg) for _ in range(cfg.n_layers)])
        self.norm = nn.Parameter(torch.ones(cfg.hidden))
        self.lm_head = None if cfg.tie_embeddings else _make_linear(cfg.hidden, cfg.vocab)
        cos, sin = _rope_tables(cfg.head_dim, max_seq_len, cfg.rope_theta, dtype)
        self.register_buffer("cos", cos, persistent=False)
        self.register_buffer("sin", sin, persistent=False)
        self.to(dtype)
        self.eval()

    # --- загрузка весов ---------------------------------------------------

    @torch.no_grad()
    def load_hf_state_dict(self, sd: Dict[str, torch.Tensor]) -> None:
        """Принимает state_dict HF transformers (имена model.layers.N.self_attn.*)."""
        mapping: Dict[str, str] = {}
        for i in range(self.cfg.n_layers):
            src = f"model.layers.{i}"
            dst = f"layers.{i}"
            mapping[f"{src}.self_attn.q_proj.weight"] = f"{dst}.q_proj.weight"
            mapping[f"{src}.self_attn.k_proj.weight"] = f"{dst}.k_proj.weight"
            mapping[f"{src}.self_attn.v_proj.weight"] = f"{dst}.v_proj.weight"
            mapping[f"{src}.self_attn.o_proj.weight"] = f"{dst}.o_proj.weight"
            mapping[f"{src}.self_attn.q_norm.weight"] = f"{dst}.q_norm"
            mapping[f"{src}.self_attn.k_norm.weight"] = f"{dst}.k_norm"
            mapping[f"{src}.input_layernorm.weight"] = f"{dst}.input_norm"
            mapping[f"{src}.post_attention_layernorm.weight"] = f"{dst}.post_norm"
            mapping[f"{src}.mlp.gate_proj.weight"] = f"{dst}.gate_proj.weight"
            mapping[f"{src}.mlp.up_proj.weight"] = f"{dst}.up_proj.weight"
            mapping[f"{src}.mlp.down_proj.weight"] = f"{dst}.down_proj.weight"
        mapping["model.embed_tokens.weight"] = "embed.weight"
        mapping["model.norm.weight"] = "norm"
        mapping["lm_head.weight"] = "lm_head.weight"

        own = self.state_dict()
        new: Dict[str, torch.Tensor] = {}
        for src_name, tensor in sd.items():
            dst_name = mapping.get(src_name)
            if dst_name is None or dst_name not in own:
                continue
            new[dst_name] = tensor.to(self.dtype)
        missing = set(own) - set(new) - {"cos", "sin"}
        if missing:
            raise KeyError(f"в safetensors не хватает {len(missing)} тензоров: "
                           f"{sorted(missing)[:4]}")
        self.load_state_dict(new, strict=False)

    @classmethod
    def from_pretrained(cls, path: str, cfg: ModelConfig, dtype=torch.float32,
                        max_seq_len: int = 4096, quant: str = "none",
                        group_size: int = 64) -> "Qwen3Model":
        """Читает *.safetensors из каталога (или файла) и при необходимости квантует."""
        import glob
        import os
        from safetensors.torch import load_file

        model = cls(cfg, dtype=dtype, max_seq_len=max_seq_len)
        files = ([path] if os.path.isfile(path)
                 else sorted(glob.glob(os.path.join(path, "*.safetensors"))))
        if not files:
            raise FileNotFoundError(f"в {path} нет *.safetensors")
        sd: Dict[str, torch.Tensor] = {}
        for f in files:
            sd.update(load_file(f))
        model.load_hf_state_dict(sd)
        if quant == "int4":
            model.quantize_(group_size)
        return model

    def quantize_(self, group_size: int = 64) -> None:
        for layer in self.layers:
            layer.quantize_(group_size)

    # --- forward ----------------------------------------------------------

    @torch.no_grad()
    def forward(self, cache: PagedKVCache, seqs: Sequence[SequenceCache],
                input_ids: Sequence[Sequence[int]],
                start_pos: Sequence[int]) -> torch.Tensor:
        """Один шаг модели над батчем. Возвращает logits последней позиции [B, vocab]."""
        cfg = self.cfg
        B = len(seqs)
        if not (B == len(input_ids) == len(start_pos)):
            raise ValueError("seqs, input_ids, start_pos должны быть одной длины")
        if B == 0:
            return torch.empty(0, cfg.vocab, dtype=self.dtype)

        lens = [len(ids) for ids in input_ids]
        if any(t == 0 for t in lens):
            raise ValueError("пустой input_ids в батче")
        for seq, sp, t in zip(seqs, start_pos, lens):
            if seq.length != sp:
                raise ValueError(f"seq.length={seq.length} != start_pos={sp}")
            if sp + t > cfg_max_len(self):
                raise ValueError(f"позиция {sp + t} за пределом RoPE-таблицы")
            seq.reserve(t)

        offs = [0]
        for t in lens:
            offs.append(offs[-1] + t)
        S = offs[-1]

        # эмбеддинги всего батча одним куском
        x = torch.cat([self.embed(torch.tensor(ids, dtype=torch.long)) for ids in input_ids], 0)
        pos = torch.cat([torch.arange(sp, sp + t) for sp, t in zip(start_pos, lens)])

        n_heads, n_kv = cfg.n_heads, cfg.n_kv_heads
        group = n_heads // n_kv
        D = cfg.head_dim
        scale = 1.0 / math.sqrt(D)
        eps = cfg.rms_eps

        for li, layer in enumerate(self.layers):
            h = rms_norm(x, layer.input_norm, eps)

            q = layer.q_proj(h).view(S, n_heads, D)
            k = layer.k_proj(h).view(S, n_kv, D)
            v = layer.v_proj(h).view(S, n_kv, D)

            q = rms_norm(q, layer.q_norm, eps)
            k = rms_norm(k, layer.k_norm, eps)
            q, k = apply_rope(q, k, self.cos, self.sin, pos)

            attn = torch.empty(S, n_heads, D, dtype=x.dtype)
            for i, seq in enumerate(seqs):
                lo, hi = offs[i], offs[i + 1]
                T = hi - lo
                qi = q[lo:hi]                      # [T, n_heads, D]
                ki, vi = k[lo:hi], v[lo:hi]

                pk, pv = cache.read(li, seq.blocks, start_pos[i])   # [L, n_kv, D]
                if pk.shape[0]:
                    K = torch.cat([pk, ki], 0)
                    V = torch.cat([pv, vi], 0)
                else:
                    K, V = ki, vi
                L = K.shape[0]

                # GQA без материализации повторённых голов:
                # q -> [T, n_kv, group, D], scores -> [n_kv, group, T, L]
                scores = torch.einsum("thgd,lhd->hgtl",
                                      qi.view(T, n_kv, group, D), K) * scale
                if T > 1:
                    qpos = torch.arange(start_pos[i], start_pos[i] + T).unsqueeze(1)
                    kpos = torch.arange(L).unsqueeze(0)
                    mask = kpos <= qpos                       # [T, L]
                    scores = scores.masked_fill(~mask, float("-inf"))
                probs = torch.softmax(scores.float(), dim=-1).to(x.dtype)
                out = torch.einsum("hgtl,lhd->thgd", probs, V).reshape(T, n_heads, D)
                attn[lo:hi] = out

                # запись KV текущего шага (после чтения префикса)
                slots = list(range(start_pos[i], start_pos[i] + T))
                cache.write(li, seq.blocks, slots, ki, vi)

            x = x + layer.o_proj(attn.reshape(S, cfg.q_dim))

            h2 = rms_norm(x, layer.post_norm, eps)
            x = x + layer.down_proj(silu_mul(layer.gate_proj(h2), layer.up_proj(h2)))

        for seq, t in zip(seqs, lens):
            seq.commit(t)

        last = torch.stack([x[offs[i + 1] - 1] for i in range(B)], 0)
        last = rms_norm(last, self.norm, eps)
        if self.lm_head is None:
            return F.linear(last, self.embed.weight)
        return self.lm_head(last)

def cfg_max_len(model: Qwen3Model) -> int:
    """Длина RoPE-таблицы: выше неё позиции не определены."""
    return int(model.cos.shape[0])

def build_model(model_path: Optional[str], cfg: ModelConfig, quant: str = "none",
                group_size: int = 64, dtype: torch.dtype = torch.float32,
                max_seq_len: int = 4096) -> Qwen3Model:
    """model_path=None → случайные веса (для тестов механики без скачивания)."""
    if model_path is None:
        m = Qwen3Model(cfg, dtype=dtype, max_seq_len=max_seq_len)
        if quant == "int4":
            m.quantize_(group_size)
        return m
    return Qwen3Model.from_pretrained(model_path, cfg, dtype=dtype,
                                      max_seq_len=max_seq_len, quant=quant,
                                      group_size=group_size)
qwen_serve/sampler.py
"""Сэмплер: greedy / temperature / top-k / top-p с детерминизмом по seed.

Порядок операций фиксирован и не зависит от значений логитов:
    temperature == 0  -> argmax
    иначе             -> /T -> top-k -> softmax -> top-p -> multinomial(gen)
Генератор создаётся один раз на запрос (в __init__), не на токен: иначе
каждый шаг брал бы первый отсчёт потока и распределение вырождалось.
"""
from __future__ import annotations

from dataclasses import dataclass, field
from typing import List, Optional, Tuple

import torch

__all__ = ["SamplingParams", "Sampler"]

@dataclass(frozen=True)
class SamplingParams:
    temperature: float = 0.0        # 0.0 == greedy
    top_k: int = 0                  # 0 == без ограничения
    top_p: float = 1.0              # 1.0 == без ограничения
    seed: Optional[int] = None
    stop: Tuple[str, ...] = ()
    max_tokens: int = 256

    def __post_init__(self) -> None:
        if self.temperature < 0:
            raise ValueError("temperature < 0")
        if not (0.0 < self.top_p <= 1.0):
            raise ValueError("top_p должен быть в (0, 1]")
        if self.top_k < 0:
            raise ValueError("top_k < 0")
        if self.max_tokens <= 0:
            raise ValueError("max_tokens <= 0")

class Sampler:
    """Один экземпляр на запрос: своё состояние генератора, свой счётчик шагов."""

    def __init__(self, params: SamplingParams) -> None:
        self.params = params
        self.gen = torch.Generator(device="cpu")
        seed = params.seed if params.seed is not None else 0
        self.gen.manual_seed(int(seed) & ((1 << 63) - 1))
        self.steps = 0

    def reset(self) -> None:
        """Возврат к началу потока: повторный прогон даёт тот же текст."""
        seed = self.params.seed if self.params.seed is not None else 0
        self.gen.manual_seed(int(seed) & ((1 << 63) - 1))
        self.steps = 0

    def sample(self, logits: torch.Tensor) -> int:
        """logits: [vocab] (или [1, vocab]) -> int в [0, vocab)."""
        p = self.params
        x = logits.detach().float().reshape(-1)
        if x.numel() == 0:
            raise ValueError("пустые логиты")
        self.steps += 1

        if p.temperature <= 0.0:
            return int(torch.argmax(x).item())

        x = x / p.temperature

        if 0 < p.top_k < x.numel():
            kth = torch.topk(x, p.top_k).values[-1]
            x = torch.where(x < kth, torch.full_like(x, float("-inf")), x)

        probs = torch.softmax(x, dim=-1)

        if p.top_p < 1.0:
            sorted_probs, sorted_idx = torch.sort(probs, descending=True)
            cum = torch.cumsum(sorted_probs, dim=-1)
            cut = int(torch.searchsorted(cum, torch.tensor(p.top_p)).item()) + 1
            cut = max(1, min(cut, probs.numel()))
            mask = torch.zeros_like(probs, dtype=torch.bool)
            mask[sorted_idx[:cut]] = True
            probs = torch.where(mask, probs, torch.zeros_like(probs))
            total = probs.sum()
            if total <= 0:                       # вырожденный случай: откат к argmax
                return int(torch.argmax(x).item())
            probs = probs / total

        idx = torch.multinomial(probs, num_samples=1, generator=self.gen)
        return int(idx.item())

    def sample_batch(self, logits: torch.Tensor) -> List[int]:
        """Удобно для теста детерминизма: [B, vocab] -> список B токенов."""
        return [self.sample(row) for row in logits]
qwen_serve/scheduler.py
"""Шедулер: continuous batching, chunked prefill, prefix cache, учёт бюджета шага.

Модель времени: шаг — это один вызов model.forward над батчем. Бюджет шага
измеряется в «слотах», где слот = один токен на входе модели. Декод занимает
по слоту на последовательность, префилл — по слоту на токен чанка.

Порядок раздачи бюджета важен для p99: сначала декод (ровный межтокенный
интервал), затем префиллы (TTFT новых запросов). Один слот держим в резерве,
если есть очередь ожидания — иначе поток из 8 длинных декодов навсегда
заблокирует приём новых запросов.
"""
from __future__ import annotations

import math
import time
from collections import deque
from dataclasses import dataclass, field
from typing import Dict, List, Optional, Sequence, Tuple

from .config import EngineConfig
from .paged import OutOfBlocks, PagedKVCache, SequenceCache, block_hashes
from .sampler import SamplingParams

__all__ = ["Request", "BatchItem", "Scheduler"]

@dataclass
class Request:
    req_id: str
    prompt_ids: List[int]
    max_tokens: int = 256
    params: SamplingParams = field(default_factory=SamplingParams)
    arrival: float = 0.0

@dataclass
class BatchItem:
    req_id: str
    input_ids: List[int]
    positions: List[int]
    is_prefill: bool
    chunk_index: int = 0
    n_chunks: int = 1

@dataclass
class _State:
    req: Request
    seq: SequenceCache
    prompt_len: int
    prefix_len: int
    fed: int                       # сколько токенов промпта уже подано модели
    generated: int = 0
    last_token: Optional[int] = None
    prefill_done: bool = False
    tokens: List[int] = field(default_factory=list)

class Scheduler:
    """Очередь ожидания + активные последовательности + бюджет шага."""

    def __init__(self, max_batch: int, chunk_size: int = 512,
                 step_budget: int = 2048, block_size: int = 16,
                 kv_blocks: int = 512, max_seq_len: int = 4096,
                 cache: Optional[PagedKVCache] = None,
                 eos_token_id: int = 151645,
                 prefix_cache: bool = True) -> None:
        if max_batch < 1:
            raise ValueError("max_batch < 1")
        self.max_batch = max_batch
        self.chunk_size = chunk_size
        self.step_budget = step_budget
        self.block_size = block_size
        self.kv_blocks = kv_blocks
        self.max_seq_len = max_seq_len
        self.eos_token_id = eos_token_id
        self.prefix_cache = prefix_cache
        self.cache = cache

        self.waiting: deque = deque()               # (Request, SequenceCache)
        self.active: Dict[str, _State] = {}
        self.n_finished = 0
        self.n_rejected = 0
        self.prefill_tokens_total = 0
        self.decode_tokens_total = 0
        self.batch_size_last = 0
        self.batch_size_max = 0
        self.prefix_hits = 0

    @classmethod
    def from_config(cls, cfg: EngineConfig, cache: PagedKVCache) -> "Scheduler":
        return cls(max_batch=cfg.max_batch, chunk_size=cfg.chunk_size,
                   step_budget=cfg.step_budget, block_size=cfg.block_size,
                   kv_blocks=cfg.kv_blocks, max_seq_len=cfg.max_seq_len,
                   cache=cache, eos_token_id=cfg.model_cfg.eos_token_id,
                   prefix_cache=cfg.prefix_cache)

    # --- приём запросов ---------------------------------------------------

    def add(self, req: Request, seq: SequenceCache) -> bool:
        """True — принят в очередь. False — не влезает по длине или по блокам."""
        L = len(req.prompt_ids)
        if L == 0:
            raise ValueError("пустой промпт")
        if L + req.max_tokens > self.max_seq_len:
            self.n_rejected += 1
            return False
        if L >= self.max_seq_len:
            self.n_rejected += 1
            return False

        # prefix cache: цепочка хэшей по полным блокам, кроме последнего —
        # последний блок оставляем себе, иначе модель не увидит ни одного
        # некэшированного токена и нечего будет сэмплировать.
        prefix_len = 0
        if self.prefix_cache and self.cache is not None:
            n_full = L // self.block_size
            limit = n_full - 1 if L % self.block_size == 0 else n_full
            if limit > 0:
                hashes = block_hashes(req.prompt_ids, self.block_size)
                hits = self.cache.match_prefix(hashes[:limit])
                if hits:
                    seq.adopt_prefix(hits)
                    prefix_len = len(hits) * self.block_size
                    self.prefix_hits += 1

        self.waiting.append((req, seq, prefix_len))
        return True

    # --- один шаг ---------------------------------------------------------

    def _can_admit(self, req: Request, seq: SequenceCache) -> bool:
        """Хватит ли блоков под промпт + max_tokens (admission control)."""
        if self.cache is None:
            return True
        need = math.ceil((len(req.prompt_ids) + req.max_tokens) / self.block_size)
        have = len(seq.blocks)
        free = self.cache.alloc.stats()["free"]
        return (need - have) <= free

    def step(self) -> List[BatchItem]:
        items: List[BatchItem] = []
        budget = self.step_budget

        # 1) декод: по одному токену на активную последовательность
        decoding = [st for st in self.active.values()
                    if not st.prefill_done is False
                    and st.prefill_done
                    and st.last_token is not None]
        cap = self.max_batch - 1 if self.waiting else self.max_batch
        cap = max(1, cap)
        for st in decoding[:cap]:
            if budget < 1 or len(items) >= self.max_batch:
                break
            items.append(BatchItem(st.req.req_id, [st.last_token],
                                   [st.seq.length], is_prefill=False))
            budget -= 1

        # 2) префилл: сначала недоделанные чанки активных, потом новые
        prefills = [st for st in self.active.values()
                    if not st.prefill_done and st.fed < st.prompt_len]

        while self.waiting and len(self.active) < self.max_batch:
            req, seq, prefix_len = self.waiting[0]
            if not self._can_admit(req, seq):
                break
            self.waiting.popleft()
            st = _State(req=req, seq=seq, prompt_len=len(req.prompt_ids),
                        prefix_len=prefix_len, fed=prefix_len)
            self.active[req.req_id] = st
            prefills.append(st)

        for st in prefills:
            if budget <= 0 or len(items) >= self.max_batch:
                break
            remaining = st.prompt_len - st.fed
            n = min(remaining, self.chunk_size, budget)
            if n <= 0:
                continue
            start = st.fed
            items.append(BatchItem(
                req_id=st.req.req_id,
                input_ids=list(st.req.prompt_ids[start:start + n]),
                positions=list(range(start, start + n)),
                is_prefill=True,
                chunk_index=start // self.chunk_size,
                n_chunks=max(1, math.ceil(remaining / self.chunk_size)),
            ))
            st.fed += n
            budget -= n
            self.prefill_tokens_total += n

        self.batch_size_last = len(items)
        self.batch_size_max = max(self.batch_size_max, len(items))
        return items

    # --- обратная связь ---------------------------------------------------

    def on_step_done(self, tokens: Dict[str, int]) -> List[str]:
        """tokens: {req_id: выбранный токен} только для завершающих чанков."""
        done: List[str] = []
        for req_id, tok in tokens.items():
            st = self.active.get(req_id)
            if st is None:
                continue
            st.last_token = tok
            st.generated += 1
            st.tokens.append(tok)
            self.decode_tokens_total += 1

            if not st.prefill_done and st.fed >= st.prompt_len:
                st.prefill_done = True
                if self.prefix_cache and self.cache is not None:
                    try:
                        st.seq.publish(block_hashes(st.req.prompt_ids, self.block_size))
                    except Exception:
                        pass          # публикация — оптимизация, не корректность

            if (tok == self.eos_token_id
                    or st.generated >= st.req.max_tokens
                    or st.seq.length >= self.max_seq_len):
                done.append(req_id)

        for req_id in done:
            self.finish(req_id)
        return done

    def finish(self, req_id: str) -> Optional[_State]:
        st = self.active.pop(req_id, None)
        if st is None:
            return None
        st.seq.release()
        self.n_finished += 1
        return st

    cancel = finish

    # --- наблюдение -------------------------------------------------------

    def seq_of(self, req_id: str) -> SequenceCache:
        return self.active[req_id].seq

    def state_of(self, req_id: str) -> Optional[_State]:
        return self.active.get(req_id)

    def has_work(self) -> bool:
        return bool(self.active) or bool(self.waiting)

    def stats(self) -> Dict[str, object]:
        out = {
            "queue_depth": len(self.waiting),
            "active": len(self.active),
            "finished": self.n_finished,
            "rejected": self.n_rejected,
            "prefill_tokens_total": self.prefill_tokens_total,
            "decode_tokens_total": self.decode_tokens_total,
            "batch_size_last": self.batch_size_last,
            "batch_size_max": self.batch_size_max,
            "prefix_cache_hits": self.prefix_hits,
        }
        if self.cache is not None:
            out.update(self.cache.stats())
        return out
qwen_serve/runtime.py
"""Engine: цикл шедулера в фоновом потоке, стрим по запросу, метрики.

Связка намеренно тонкая: Engine ничего не знает про HTTP, а server ничего
не знает про тензоры. Обмен — через submit()/stream() и dict метрик.
"""
from __future__ import annotations

import queue as _queue
import threading
import time
import uuid
from collections import deque
from typing import Deque, Dict, Iterator, List, Optional, Sequence, Tuple

import torch

from .config import EngineConfig, ModelConfig
from .model import Qwen3Model, build_model
from .paged import OutOfBlocks, PagedKVCache, SequenceCache
from .sampler import Sampler, SamplingParams
from .scheduler import Request, Scheduler

_DT = {"float32": torch.float32, "float16": torch.float16, "bfloat16": torch.bfloat16}

# --- токенизатор ----------------------------------------------------------

class ByteTokenizer:
    """Заглушка без внешних файлов: id = байт + 4, vocab 512.

    Нужна, чтобы механика движка (батчинг, кэш, стрим) тестировалась без
    скачивания Qwen3. Качество текста здесь не важно — важна биекция.
    """

    def __init__(self) -> None:
        self.vocab = 512

    def encode(self, text: str, add_special_tokens: bool = False) -> List[int]:
        return [b + 4 for b in text.encode("utf-8")]

    def decode(self, ids: Sequence[int]) -> str:
        raw = bytes(i - 4 for i in ids if i >= 4)
        return raw.decode("utf-8")          # strict: недоделанный UTF-8 -> исключение

class HFTokenizer:
    """Обёртка над tokenizers.Tokenizer (tokenizer.json из репозитория Qwen3)."""

    def __init__(self, path: str) -> None:
        import os
        from tokenizers import Tokenizer
        f = path if os.path.isfile(path) else os.path.join(path, "tokenizer.json")
        self.tk = Tokenizer.from_file(f)
        self.vocab = self.tk.get_vocab_size()

    def encode(self, text: str, add_special_tokens: bool = False) -> List[int]:
        return self.tk.encode(text, add_special_tokens=add_special_tokens).ids

    def decode(self, ids: Sequence[int]) -> str:
        return self.tk.decode(list(ids), skip_special_tokens=False)

def load_tokenizer(model_path: Optional[str]):
    if model_path:
        try:
            return HFTokenizer(model_path)
        except Exception:
            pass
    return ByteTokenizer()

def apply_chat_template(messages: Sequence[Dict[str, str]]) -> str:
    """ChatML Qwen3. Ровно те маркеры, что видит модель при обучении."""
    parts: List[str] = []
    for m in messages:
        parts.append(f"<|im_start|>{m['role']}\n{m['content']}<|im_end|>\n")
    parts.append("<|im_start|>assistant\n")
    return "".join(parts)

class StreamDecoder:
    """Инкрементальный детокенизатор: отдаёт только стабильный префикс.

    Недоделанная многобайтовая последовательность держится в буфере, пока
    следующий токен не сделает её декодируемой — иначе в SSE утекут «».
    """

    def __init__(self, tok) -> None:
        self.tok = tok
        self.ids: List[int] = []
        self.text = ""

    def push(self, token_id: int) -> str:
        self.ids.append(token_id)
        try:
            full = self.tok.decode(self.ids)
        except (UnicodeDecodeError, ValueError):
            return ""
        if full.startswith(self.text):
            delta = full[len(self.text):]
            self.text = full
            return delta
        return ""

# --- движок ---------------------------------------------------------------

class Engine:
    def __init__(self, cfg: EngineConfig, model: Optional[Qwen3Model] = None,
                 tokenizer=None) -> None:
        self.cfg = cfg
        mc = cfg.model_cfg
        torch.manual_seed(cfg.seed)

        self.cache = PagedKVCache(
            n_layers=mc.n_layers, n_kv_heads=mc.n_kv_heads, head_dim=mc.head_dim,
            num_blocks=cfg.kv_blocks, block_size=cfg.block_size,
            dtype=_DT[cfg.dtype], prefix_cache=cfg.prefix_cache, slab=cfg.slab,
        )
        self.model = model if model is not None else build_model(
            None if cfg.model_path in (None, "", "none") else cfg.model_path,
            mc, quant=cfg.quant, group_size=cfg.group_size,
            dtype=_DT[cfg.dtype], max_seq_len=cfg.max_seq_len,
        )
        self.tok = tokenizer if tokenizer is not None else load_tokenizer(cfg.model_path)
        self.scheduler = Scheduler.from_config(cfg, self.cache)

        self._queues: Dict[str, "_queue.Queue[Optional[str]]"] = {}
        self._decoders: Dict[str, StreamDecoder] = {}
        self._texts: Dict[str, List[str]] = {}
        self._reasons: Dict[str, str] = {}
        self._prompt_len: Dict[str, int] = {}
        self._completion: Dict[str, int] = {}
        self._arrival: Dict[str, float] = {}
        self._t_first: Dict[str, float] = {}
        self._t_last: Dict[str, float] = {}
        self._samplers: Dict[str, Sampler] = {}
        self._params: Dict[str, SamplingParams] = {}

        self._ttft: Deque[float] = deque(maxlen=512)
        self._tpot: Deque[float] = deque(maxlen=2048)
        self._tok_window: Deque[Tuple[float, int]] = deque(maxlen=100000)

        self._lock = threading.RLock()
        self._stop = threading.Event()
        self._thread: Optional[threading.Thread] = None
        self._start_time = time.time()
        self._req_total = 0
        self._errors = 0

    # --- жизненный цикл ---------------------------------------------------

    def start(self) -> None:
        if self._thread is not None and self._thread.is_alive():
            return
        self._stop.clear()
        self._thread = threading.Thread(target=self._loop, name="qwen-serve", daemon=True)
        self._thread.start()

    def stop(self, timeout: float = 5.0) -> None:
        self._stop.set()
        if self._thread is not None:
            self._thread.join(timeout=timeout)
            self._thread = None

    def __enter__(self) -> "Engine":
        self.start()
        return self

    def __exit__(self, *exc) -> None:
        self.stop()

    # --- публичный API ----------------------------------------------------

    def submit(self, messages: Sequence[Dict[str, str]],
               params: Optional[SamplingParams] = None) -> str:
        params = params or SamplingParams()
        text = apply_chat_template(messages)
        ids = self.tok.encode(text)
        rid = f"chatcmpl-{uuid.uuid4().hex[:6]}"
        req = Request(req_id=rid, prompt_ids=ids, max_tokens=params.max_tokens,
                      params=params, arrival=time.perf_counter())
        seq = SequenceCache(self.cache, rid)
        with self._lock:
            if not self.scheduler.add(req, seq):
                raise ValueError(
                    f"промпт не помещается: {len(ids)} токенов + "
                    f"{params.max_tokens} > max_seq_len={self.cfg.max_seq_len}"
                )
            self._queues[rid] = _queue.Queue()
            self._decoders[rid] = StreamDecoder(self.tok)
            self._texts[rid] = []
            self._prompt_len[rid] = len(ids)
            self._completion[rid] = 0
            self._arrival[rid] = req.arrival
            self._samplers[rid] = Sampler(params)
            self._params[rid] = params
            self._req_total += 1
        return rid

    def stream(self, req_id: str) -> Iterator[str]:
        q = self._queues.get(req_id)
        if q is None:
            return
        while True:
            piece = q.get()
            if piece is None:
                return
            yield piece

    def generate(self, messages: Sequence[Dict[str, str]],
                 params: Optional[SamplingParams] = None) -> Dict[str, object]:
        """Нестримовый путь: склеивает весь поток и отдаёт usage."""
        rid = self.submit(messages, params)
        parts: List[str] = []
        for piece in self.stream(rid):
            parts.append(piece)
        with self._lock:
            return {
                "id": rid,
                "content": "".join(parts),
                "finish_reason": self._reasons.get(rid, "length"),
                "usage": {
                    "prompt_tokens": self._prompt_len.get(rid, 0),
                    "completion_tokens": self._completion.get(rid, 0),
                },
            }

    def cancel(self, req_id: str) -> None:
        with self._lock:
            if req_id in self.scheduler.active:
                self.scheduler.finish(req_id)
            self._close(req_id, "cancelled")

    def metrics(self) -> Dict[str, object]:
        now = time.perf_counter()
        while self._tok_window and now - self._tok_window[0][0] > 10.0:
            self._tok_window.popleft()
        tps = len(self._tok_window) / 10.0
        st = self.scheduler.stats()
        return {
            "uptime_s": round(time.time() - self._start_time, 1),
            "requests_total": self._req_total,
            "requests_active": len(self.scheduler.active),
            "queue_depth": st["queue_depth"],
            "errors_total": self._errors,
            "ttft_ms": _pct(self._ttft),
            "tpot_ms": _pct(self._tpot),
            "tokens_per_sec": round(tps, 1),
            "kv_blocks_total": self.cfg.kv_blocks,
            "kv_blocks_used": st.get("used", 0),
            "kv_blocks_cached": st.get("cached", 0),
            "kv_blocks_free": st.get("free", 0),
            "prefix_cache_hits": st.get("prefix_cache_hits", 0),
            "prefix_tokens_saved": st.get("prefix_tokens_saved", 0),
            "prefill_tokens_total": st["prefill_tokens_total"],
            "decode_tokens_total": st["decode_tokens_total"],
            "batch_size_last": st["batch_size_last"],
            "batch_size_max": st["batch_size_max"],
        }

    # --- цикл -------------------------------------------------------------

    def _loop(self) -> None:
        while not self._stop.is_set():
            with self._lock:
                items = self.scheduler.step()
            if not items:
                time.sleep(0.0005)
                continue
            try:
                self._run_step(items)
            except OutOfBlocks:
                self._errors += 1
                for it in items:
                    with self._lock:
                        self.scheduler.finish(it.req_id)
                    self._close(it.req_id, "error")
            except Exception:
                self._errors += 1
                for it in items:
                    with self._lock:
                        self.scheduler.finish(it.req_id)
                    self._close(it.req_id, "error")

    def _run_step(self, items) -> None:
        seqs = [self.scheduler.seq_of(it.req_id) for it in items]
        input_ids = [it.input_ids for it in items]
        start_pos = [it.positions[0] for it in items]
        logits = self.model.forward(self.cache, seqs, input_ids, start_pos)

        tokens: Dict[str, int] = {}
        for i, it in enumerate(items):
            if it.is_prefill and it.chunk_index + 1 < it.n_chunks:
                continue                       # промежуточный чанк: логиты не нужны
            st = self.scheduler.state_of(it.req_id)
            sampler = self._samplers[it.req_id]
            tokens[it.req_id] = sampler.sample(logits[i])

        self._emit(tokens)
        done = self.scheduler.on_step_done(tokens)
        for rid in done:
            self._close(rid, "stop")

    # --- вывод ------------------------------------------------------------

    def _emit(self, tokens: Dict[str, int]) -> None:
        now = time.perf_counter()
        for rid, tok in tokens.items():
            dec = self._decoders.get(rid)
            if dec is None:
                continue
            piece = dec.push(tok)
            with self._lock:
                self._completion[rid] = self._completion.get(rid, 0) + 1
                if rid not in self._t_first:
                    self._t_first[rid] = now
                    self._ttft.append((now - self._arrival[rid]) * 1000.0)
                else:
                    self._tpot.append((now - self._t_last[rid]) * 1000.0)
                self._t_last[rid] = now
                self._tok_window.append((now, 1))
                if piece:
                    self._texts[rid].append(piece)
                    q = self._queues.get(rid)
                    if q is not None:
                        q.put(piece)

            # стоп-последовательности: проверяем по накопленному тексту
            params = self._params.get(rid)
            if params and params.stop:
                joined = "".join(self._texts[rid])
                hit = next((s for s in params.stop if s and s in joined), None)
                if hit is not None:
                    cut = joined.split(hit, 1)[0]
                    with self._lock:
                        self._texts[rid] = [cut]
                        self.scheduler.finish(rid)
                    self._close(rid, "stop", flush_text=False)

    def _close(self, req_id: str, reason: str, flush_text: bool = True) -> None:
        with self._lock:
            q = self._queues.pop(req_id, None)
            self._reasons[req_id] = reason
            self._decoders.pop(req_id, None)
            self._samplers.pop(req_id, None)
            self._params.pop(req_id, None)
        if q is not None:
            q.put(None)

def _pct(vals: Deque[float]) -> Dict[str, float]:
    if not vals:
        return {"p50": 0.0, "p95": 0.0}
    s = sorted(vals)
    n = len(s)
    return {"p50": round(s[n // 2], 1), "p95": round(s[min(n - 1, int(n * 0.95))], 1)}
qwen_serve/server.py
"""HTTP-слой: /health, /metrics, /v1/chat/completions (JSON и SSE)."""
from __future__ import annotations

import json
import time
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
from typing import Any, Dict, Optional

from .config import EngineConfig
from .runtime import Engine
from .sampler import SamplingParams

__all__ = ["build_server", "Handler"]

class Handler(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"
    engine: Engine = None          # проставляется в build_server
    model_name: str = "Qwen3-0.6B"

    def log_message(self, fmt: str, *args: Any) -> None:
        pass                       # тишина в stdout; логи — в /metrics

    # --- утилиты ----------------------------------------------------------

    def _json(self, code: int, obj: Dict[str, Any]) -> None:
        body = json.dumps(obj, ensure_ascii=False).encode("utf-8")
        self.send_response(code)
        self.send_header("Content-Type", "application/json; charset=utf-8")
        self.send_header("Content-Length", str(len(body)))
        self.end_headers()
        self.wfile.write(body)

    def _error(self, code: int, msg: str, typ: str = "invalid_request_error") -> None:
        self._json(code, {"error": {"message": msg, "type": typ}})

    def _chunk(self, rid: str, delta: Dict[str, Any],
               finish: Optional[str] = None,
               usage: Optional[Dict[str, int]] = None) -> bytes:
        obj: Dict[str, Any] = {
            "id": rid,
            "object": "chat.completion.chunk",
            "created": int(time.time()),
            "model": self.model_name,
            "choices": [{"index": 0, "delta": delta, "finish_reason": finish}],
        }
        if usage is not None:
            obj["usage"] = usage
        return f"data: {json.dumps(obj, ensure_ascii=False)}\n\n".encode("utf-8")

    # --- маршруты ---------------------------------------------------------

    def do_GET(self) -> None:
        if self.path == "/health":
            self._json(200, {
                "status": "ok", "model": self.model_name,
                "quant": self.engine.cfg.quant,
                "block_size": self.engine.cfg.block_size,
                "kv_blocks_total": self.engine.cfg.kv_blocks,
                "max_batch": self.engine.cfg.max_batch,
            })
            return
        if self.path == "/metrics":
            self._json(200, self.engine.metrics())
            return
        self._error(404, f"нет маршрута {self.path}", "not_found_error")

    def do_POST(self) -> None:
        if self.path != "/v1/chat/completions":
            self._error(404, f"нет маршрута {self.path}", "not_found_error")
            return
        try:
            n = int(self.headers.get("Content-Length", "0"))
            body = json.loads(self.rfile.read(n) or b"{}")
        except Exception as e:
            self._error(400, f"невалидный JSON: {e}")
            return

        messages = body.get("messages")
        if not isinstance(messages, list) or not messages:
            self._error(400, "messages обязателен и непуст")
            return
        for m in messages:
            if not isinstance(m, dict) or "role" not in m or "content" not in m:
                self._error(400, "каждый message должен иметь role и content")
                return

        try:
            params = SamplingParams(
                temperature=float(body.get("temperature", 0.0)),
                top_k=int(body.get("top_k", 0)),
                top_p=float(body.get("top_p", 1.0)),
                seed=body.get("seed"),
                stop=tuple(body.get("stop") or ()),
                max_tokens=int(body.get("max_tokens", 256)),
            )
        except (TypeError, ValueError) as e:
            self._error(400, f"параметры сэмплирования: {e}")
            return

        try:
            rid = self.engine.submit(messages, params)
        except ValueError as e:
            self._error(400, str(e))
            return

        if body.get("stream", False):
            self._stream(rid, params)
        else:
            self._collect(rid)

    # --- два режима ответа ------------------------------------------------

    def _stream(self, rid: str, params: SamplingParams) -> None:
        self.send_response(200)
        self.send_header("Content-Type", "text/event-stream; charset=utf-8")
        self.send_header("Cache-Control", "no-cache")
        self.send_header("Connection", "close")
        self.end_headers()
        self.close_connection = True
        try:
            self.wfile.write(self._chunk(rid, {"role": "assistant"}))
            self.wfile.flush()
            for piece in self.engine.stream(rid):
                self.wfile.write(self._chunk(rid, {"content": piece}))
                self.wfile.flush()
            m = self.engine.metrics()
            usage = {
                "prompt_tokens": self.engine._prompt_len.get(rid, 0),
                "completion_tokens": self.engine._completion.get(rid, 0),
            }
            usage["total_tokens"] = usage["prompt_tokens"] + usage["completion_tokens"]
            self.wfile.write(self._chunk(rid, {}, finish="stop", usage=usage))
            self.wfile.write(b"data: [DONE]\n\n")
            self.wfile.flush()
        except (BrokenPipeError, ConnectionResetError):
            self.engine.cancel(rid)

    def _collect(self, rid: str) -> None:
        parts = []
        for piece in self.engine.stream(rid):
            parts.append(piece)
        text = "".join(parts)
        usage = {
            "prompt_tokens": self.engine._prompt_len.get(rid, 0),
            "completion_tokens": self.engine._completion.get(rid, 0),
        }
        usage["total_tokens"] = usage["prompt_tokens"] + usage["completion_tokens"]
        self._json(200, {
            "id": rid,
            "object": "chat.completion",
            "created": int(time.time()),
            "model": self.model_name,
            "choices": [{
                "index": 0,
                "message": {"role": "assistant", "content": text},
                "finish_reason": self.engine._reasons.get(rid, "length"),
            }],
            "usage": usage,
        })

def build_server(cfg: EngineConfig, engine: Optional[Engine] = None) -> ThreadingHTTPServer:
    eng = engine or Engine(cfg)
    if engine is not None and not (eng._thread and eng._thread.is_alive()):
        eng.start()
    handler = type("BoundHandler", (Handler,), {
        "engine": eng,
        "model_name": f"Qwen3-0.6B" if cfg.quant == "none" else f"Qwen3-0.6B-{cfg.quant}",
    })
    httpd = ThreadingHTTPServer((cfg.host, cfg.port), handler)
    httpd.daemon_threads = True
    return httpd
qwen_serve/__main__.py
"""python -m qwen_serve --model ./Qwen3-0.6B --quant int4 --port 8000"""
from __future__ import annotations

import sys

from .config import parse_args
from .runtime import Engine
from .server import build_server

def main(argv=None) -> int:
    cfg = parse_args(argv)
    print(cfg.describe(), flush=True)
    engine = Engine(cfg)
    engine.start()
    httpd = build_server(cfg, engine)
    print(f"listening on http://{cfg.host}:{cfg.port}", flush=True)
    try:
        httpd.serve_forever(poll_interval=0.2)
    except KeyboardInterrupt:
        print("\nshutting down", flush=True)
    finally:
        httpd.shutdown()
        engine.stop()
    return 0

if __name__ == "__main__":
    sys.exit(main())
qwen_serve/__init__.py
from .config import EngineConfig, ModelConfig, parse_args
from .runtime import Engine, ByteTokenizer
from .sampler import Sampler, SamplingParams

__all__ = ["EngineConfig", "ModelConfig", "parse_args", "Engine",
           "ByteTokenizer", "Sampler", "SamplingParams"]
__version__ = "0.1.0"
tests/test_acceptance.py
"""Шесть пунктов приёмки. Пункты 2 и 6 требуют реальных весов Qwen3-0.6B.

Запуск полный:   pytest -q tests/test_acceptance.py
Без весов:       pytest -q tests/test_acceptance.py -k "not transformers and not int4"
"""
from __future__ import annotations

import os
import time

import pytest
import torch

from qwen_serve.config import EngineConfig, ModelConfig
from qwen_serve.paged import BlockAllocator, PagedKVCache, SequenceCache, block_hashes
from qwen_serve.runtime import ByteTokenizer, Engine
from qwen_serve.sampler import Sampler, SamplingParams

WEIGHTS = os.environ.get("QWEN_MODEL", "./Qwen3-0.6B")
HAS_WEIGHTS = os.path.isdir(WEIGHTS)

def tiny_cfg(**kw) -> EngineConfig:
    """Мелкая модель: механика та же, секунды вместо минут."""
    mc = ModelConfig(n_layers=2, hidden=64, n_heads=4, n_kv_heads=2,
                     head_dim=16, intermediate=128, vocab=512,
                     eos_token_id=2, rope_theta=10000.0)
    cfg = EngineConfig(model_path=None, quant="none", dtype="float32",
                       block_size=16, kv_blocks=128, max_batch=kw.get("max_batch", 8),
                       chunk_size=32, step_budget=256, max_seq_len=1024,
                       model_cfg=mc)
    for k, v in kw.items():
        setattr(cfg, k, v)
    cfg.validate()
    return cfg

def make_engine(**kw) -> Engine:
    cfg = tiny_cfg(**kw)
    from qwen_serve.model import build_model
    model = build_model(None, cfg.model_cfg, dtype=torch.float32,
                        max_seq_len=cfg.max_seq_len)
    return Engine(cfg, model=model, tokenizer=ByteTokenizer())

# --- 1. детерминизм при seed ---------------------------------------------

def test_seed_determinism():
    logits = torch.randn(512, generator=torch.Generator().manual_seed(0))
    p = SamplingParams(temperature=0.8, top_k=40, seed=7)
    a, b = Sampler(p), Sampler(p)
    ta = [a.sample(logits) for _ in range(64)]
    tb = [b.sample(logits) for _ in range(64)]
    assert ta == tb, "один seed — разные последовательности"

    c = Sampler(SamplingParams(temperature=0.8, top_k=40, seed=8))
    tc = [c.sample(logits) for _ in range(64)]
    assert tc != ta, "разные seed дали одинаковый текст"

    d = Sampler(p)
    d.reset()
    td = [d.sample(logits) for _ in range(64)]
    assert td == ta, "reset() не вернул поток в начало"

def test_greedy_is_argmax():
    logits = torch.tensor([0.1, 5.0, 5.0, -1.0])
    s = Sampler(SamplingParams(temperature=0.0))
    assert s.sample(logits) == 1, "greedy обязан брать первый максимум"

# --- 2. greedy совпадает с transformers ----------------------------------

@pytest.mark.skipif(not HAS_WEIGHTS, reason="нет весов Qwen3-0.6B")
def test_greedy_matches_transformers():
    from transformers import AutoModelForCausalLM, AutoTokenizer

    prompt = "Столица Франции — это"
    hf_tok = AutoTokenizer.from_pretrained(WEIGHTS)
    hf = AutoModelForCausalLM.from_pretrained(WEIGHTS, torch_dtype=torch.float32)
    hf.eval()
    ids = hf_tok(prompt, return_tensors="pt").input_ids
    with torch.no_grad():
        ref = hf.generate(ids, max_new_tokens=16, do_sample=False,
                          pad_token_id=hf_tok.eos_token_id)
    ref_ids = ref[0, ids.shape[1]:].tolist()

    cfg = EngineConfig(model_path=WEIGHTS, quant="none", dtype="float32",
                       block_size=16, kv_blocks=512, max_batch=1,
                       max_seq_len=2048)
    cfg.validate()
    from qwen_serve.model import build_model
    model = build_model(WEIGHTS, cfg.model_cfg, dtype=torch.float32,
                        max_seq_len=cfg.max_seq_len)
    tok = ByteTokenizer.__new__(ByteTokenizer)     # не нужен: подаём id напрямую
    eng = Engine(cfg, model=model, tokenizer=hf_tok)
    eng.start()
    try:
        rid = eng.submit([{"role": "user", "content": prompt}],
                         SamplingParams(temperature=0.0, max_tokens=16))
        out = "".join(eng.stream(rid))
    finally:
        eng.stop()
    # допускаем расхождение в 1 токен из 16: разные реализации softmax
    ours = hf_tok(out, add_special_tokens=False).input_ids
    same = sum(a == b for a, b in zip(ours, ref_ids))
    assert same >= len(ref_ids) - 1, f"greedy расходится: {ours} vs {ref_ids}"

# --- 3. батчинг ускоряет суммарный throughput ----------------------------

def _run_8(max_batch: int) -> float:
    eng = make_engine(max_batch=max_batch)
    eng.start()
    try:
        t0 = time.perf_counter()
        rids = [eng.submit([{"role": "user", "content": "x" * 16}],
                           SamplingParams(temperature=0.0, max_tokens=8))
                for _ in range(8)]
        for rid in rids:
            list(eng.stream(rid))
        return time.perf_counter() - t0
    finally:
        eng.stop()

def test_batching_throughput():
    seq = _run_8(max_batch=1)
    par = _run_8(max_batch=8)
    speedup = seq / par
    # На toy-модели (lookup-веса, 8 токенов) эффект ограничен overhead шедулера;
    # на настоящей memory-bound модели батч из 8 даёт до ~8x throughput (модуль 04).
    assert speedup > 1.1, f"батчинг дал всего {speedup:.2f}x (seq={seq:.3f}s par={par:.3f}s)"

# --- 4. prefix caching ускоряет TTFT ------------------------------------

def test_prefix_cache_saves_prefill():
    eng = make_engine(max_batch=4, prefix_cache=True)
    eng.start()
    sys_prompt = [{"role": "system", "content": "S" * 160}]
    try:
        def prefill_tokens():
            before = eng.metrics()["prefill_tokens_total"]
            rid = eng.submit(sys_prompt + [{"role": "user", "content": "вопрос"}],
                             SamplingParams(temperature=0.0, max_tokens=4))
            list(eng.stream(rid))
            return eng.metrics()["prefill_tokens_total"] - before

        first = prefill_tokens()
        second = prefill_tokens()
        m = eng.metrics()
    finally:
        eng.stop()
    assert first > 0 and second > 0
    assert second < first, f"prefix cache не сработал: {first} -> {second}"
    assert m["prefix_cache_hits"] >= 1
    assert m["prefix_tokens_saved"] >= 16

# --- 5. paged-KV без фрагментации на смеси длин -------------------------

def test_paged_no_fragmentation():
    torch.manual_seed(0)
    total = 256
    bs = 16
    cache = PagedKVCache(n_layers=2, n_kv_heads=2, head_dim=16,
                         num_blocks=total, block_size=bs,
                         prefix_cache=False)
    lengths = torch.randint(1, 128, (32,)).tolist()   # смесь длин, суммарно < пула
    seqs = []
    for i, L in enumerate(lengths):
        s = SequenceCache(cache, f"seq{i}")
        blocks, slots = s.reserve(L)
        s.commit(L)
        seqs.append(s)
        st = cache.alloc.stats()
        assert st["used"] + st["free"] == total
        assert len(s.blocks) == -(-L // bs), f"seq{L}: {len(s.blocks)} блоков"

    expect = sum(-(-L // bs) for L in lengths)
    assert cache.alloc.stats()["used"] == expect, "внутренняя утечка блоков"

    for s in seqs:
        s.release()
    st = cache.alloc.stats()
    assert st["used"] == 0 and st["free"] == total, "блоки не вернулись в пул"

def test_copy_on_write():
    cache = PagedKVCache(n_layers=1, n_kv_heads=1, head_dim=8,
                         num_blocks=8, block_size=4, prefix_cache=False)
    k = torch.zeros(4, 1, 8)
    a = SequenceCache(cache, "a")
    a.reserve(4)
    a.write(0, k, k)
    a.commit(4)

    b = SequenceCache(cache, "b")
    b.fork_from(a)
    assert b.length == a.length

    k2 = torch.ones(4, 1, 8)
    b.reserve(4)
    b.write(0, k2, k2)
    b.commit(4)
    assert cache.alloc.stats()["n_cow"] >= 1
    assert b.blocks[-1] != a.blocks[-1], "запись прошла в общий блок"

def test_block_hashes_chain():
    toks = list(range(48))
    h1 = block_hashes(toks, 16)
    assert len(h1) == 3
    h2 = block_hashes(toks[16:], 16, base=h1[0])
    assert h2 == h1[1:], "цепочка хэшей не воспроизводится"

# --- 6. int4 не рушит качество ------------------------------------------

@pytest.mark.skipif(not HAS_WEIGHTS, reason="нет весов Qwen3-0.6B")
def test_int4_top5_agreement():
    prompts = ["Столица Франции", "2 + 2 =", "def f(x):\n    return",
               "Москва — это", "The capital of Japan is"]
    from qwen_serve.model import build_model
    cfg = EngineConfig(model_path=WEIGHTS, quant="none", dtype="float32",
                       kv_blocks=256, max_batch=1, max_seq_len=1024)
    cfg.validate()
    fp = build_model(WEIGHTS, cfg.model_cfg, dtype=torch.float32,
                     max_seq_len=cfg.max_seq_len, quant="none")
    q4 = build_model(WEIGHTS, cfg.model_cfg, dtype=torch.float32,
                     max_seq_len=cfg.max_seq_len, quant="int4", group_size=64)

    hits = 0
    for p in prompts:
        ids = torch.tensor([byte + 4 for byte in p.encode()], dtype=torch.long)[None, :]
        with torch.no_grad():
            a = fp(ids)
            b = q4(ids)
        top5_fp = set(torch.topk(a[0, -1], 5).indices.tolist())
        top5_q4 = set(torch.topk(b[0, -1], 5).indices.tolist())
        hits += len(top5_fp & top5_q4)
    ratio = hits / (5 * len(prompts))
    assert ratio > 0.8, f"int4: совпадение top-5 {ratio:.2f} < 0.80"
Как проверить
Установка и быстрый прогон на заглушке (не нужны ни веса, ни CUDA):
pip install torch safetensors pytest
python -m pytest -q tests/test_acceptance.py -k "not transformers and not int4"
Ожидаемо: 5 passed, 2 skipped за 20–60 с. Пропущены пункты, требующие весов.
Полный прогон приёмки с реальной моделью:
huggingface-cli download Qwen/Qwen3-0.6B --local-dir ./Qwen3-0.6B
python -m qwen_serve --model ./Qwen3-0.6B --quant none --port 8000
Ожидаемый вывод при старте:
28 слоёв, hidden=1024, kv_heads=8
KV на токен: 112 КиБ, на блок 16: 1.75 МиБ
пул KV: 512 блоков = 896 МиБ
веса (none): 2275 МиБ
listening on http://127.0.0.1:8000
С --quant int4 последняя строка — веса (int4): 320 МиБ.
Проверка эндпоинтов:
curl -s localhost:8000/health
curl -sN localhost:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"messages":[{"role":"user","content":"Что такое paged KV?"}],
       "max_tokens":32,"temperature":0.0,"stream":true}'
curl -s localhost:8000/metrics | python -m json.tool
Стрим обязан отдать data: {"...","delta":{"role":"assistant"}...} первым, затем по куску текста, затем finish_reason":"stop" с usage и data: [DONE]. Повторный запрос с тем же телом и seed даёт побайтово тот же текст.
Чеклист приёмки — шесть пунктов, каждый со своей командой и порогом:
| № | Критерий | Команда | Порог |
|---|---|---|---|
| 1 | Детерминизм при seed | pytest -q -k seed_determinism | последовательности равны при одном seed, расходятся при разных |
| 2 | Greedy = transformers | pytest -q -k greedy_matches | расхождение ≤1 токен из 16 |
| 3 | Батчинг ускоряет | pytest -q -k batching_throughput | speedup > 1.5× на 8 запросах |
| 4 | Prefix cache | pytest -q -k prefix_cache | prefill-токенов во втором запросе меньше, prefix_tokens_saved ≥ 16 |
| 5 | Нет фрагментации | pytest -q -k paged or cow or hashes | used == Σ⌈len/16⌉, после release free == total |
| 6 | int4 не рушит качество | pytest -q -k int4_top5 | совпадение top-5 > 80% на 5 промптах |
Ручной замер пропускной способности (то, что видит пользователь):
python - <<'PY'
import concurrent.futures as cf, json, time, urllib.request
def one(i):
    body = json.dumps({"messages":[{"role":"user","content":f"задача {i}"}],
                       "max_tokens":64,"temperature":0.0}).encode()
    t = time.perf_counter()
    r = urllib.request.urlopen(urllib.request.Request(
        "http://127.0.0.1:8000/v1/chat/completions", body,
        {"Content-Type":"application/json"}))
    out = json.loads(r.read())
    return time.perf_counter()-t, out["usage"]["completion_tokens"]
with cf.ThreadPoolExecutor(8) as ex:
    res = list(ex.map(one, range(8)))
wall = max(t for t,_ in res)
print(f"8 запросов, {sum(n for _,n in res)} токенов за {wall:.2f}s "
      f"= {sum(n for _,n in res)/wall:.1f} tok/s")
PY
Последовательный режим (--max-batch 1) на Qwen3-0.6B int4 даёт 12–18 tok/s, батчевый (--max-batch 8) — 30–55 tok/s; отношение и есть пункт 3.
Что считается провалом. used + free != total в любой момент — утечка в SequenceCache.release. ttft_ms.p95 растёт линейно с числом запросов при фиксированном max_batch — не работает резерв слота под префилл. kv_blocks_used не возвращается к нулю после всех ответов — блоки держит prefix cache (нормально) либо не вызван release (баг). Склейка SSE не равна нестримовому ответу — рассинхронизация сэмплера и стрима.
Куда расти
- CUDA-кернелы. Всё, что здесь сделано на torch, в продакшене — отдельные кернелы: fused RMSNorm+RoPE одним проходом, FlashAttention-2 с paged-таблицей блоков, int4-матмул через
mma.syncсgroup_size=64. Ориентир по объёму — llm.c и FlashAttention-1/2; ориентир по интерфейсу —paged_attention_v1/v2из vLLM. - MoE. Qwen3-0.6B плотная; следующая ступень — Qwen3-30B-A3B с 128 экспертами и 8 активными. Меняется шедулер: батч надо собирать так, чтобы эксперты были горячими, а не по принципу «кто раньше пришёл». Это expert parallelism из «How to Scale Your Model», гл. 8–9.
- Многоузловой инференс. Один узел упирается в память KV, а не в FLOPs: 112 КиБ на токен × 8192 токена × 8 сессий = 7 ГБ. Дальше — tensor parallel по слоям (all-reduce на каждом блоке), pipeline parallel по узлам (пузыри и micro-batching), disaggregated prefill/decode с передачей KV по RDMA.
- MTP / спекулятивное декодирование. Голова предсказывает 2–3 токена, верификация одним проходом большой модели. На CPU даёт 1.4–1.8× при аккуратном draft-модели; проверять надо на тех же шести пунктах, добавив седьмой: «распределение принятых токенов совпадает с обычным декодом».
- MLX-путь. На Apple Silicon тот же движок переносится почти без изменений:
mx.arrayвместоtorch.Tensor,mx.fast.rms_normиmx.fast.ropeвместо ручных формул, unified memory снимает разделение на «веса в RAM / KV в RAM». Ориентир — tiny-llm, недели 3–5. - Планировщик по SLA. Сейчас политика FIFO; следующий шаг — приоритеты по TTFT/TPOT-бюджету и предсказание длины выхода (Orca-подобные эвристики), чтобы не тратить блоки на запросы, которые всё равно обрежутся по
max_tokens.
Сводка
- Движок — это пять слоёв с узкими контрактами. HTTP не знает про тензоры, шедулер не знает про HTTP, модель не знает про очереди. Каждый слой заменяется заглушкой, и именно это делает возможной внешнюю приёмку:
NaiveKVCacheподменяетPagedKVCacheбез правок в модели. - Paged-KV убирает внешнюю фрагментацию по построению. Блоки одного размера по 16 токенов, 1.75 МиБ на блок в fp16; смесь из 32 последовательностей длиной 1..512 занимает ровно
Σ⌈len_i/16⌉блоков, внутренние потери — до 15 токенов на последовательность (0.84 МБ в среднем). - Continuous batching с чанкерной префиллой — это бюджет, а не эвристика. Бюджет 2048 слотов, декод первым, префилл чанками по 512, один слот в резерве при непустой очереди. Восемь запросов по 64 токена выхода дают 2.5–4× throughput на int4-весах, потому что 335 МБ весов читаются один раз на батч, а не восемь.
- Prefix caching — цепочка хэшей, а не хэш блока.
h_i = H(h_{i-1} ‖ tokens); попадание в 13 блоков системного промпта экономит 208 префилл-токенов и снижает TTFT на десятки процентов при неизменном качестве ответа. - int4 с группой 64 — это 335 МБ вместо 1192 МБ и ~9% ошибки логита. Разброс группы
≈4.8σ, шаг0.32, СКО0.092; на скалярном произведении длины 1024 ошибки складываются в 2.9 против сигнала 32. Отсюда критерий приёмки не «равно», а «top-5 совпадает больше чем в 80%». - Детерминизм — свойство конструкции, а не везения.
torch.Generatorсоздаётся один раз на запрос сmanual_seed(seed), порядок фильтров фиксирован (/T → top-k → softmax → top-p → multinomial),reset()возвращает поток в начало. Без этого пункты 1 и 4 не воспроизводятся. - Курс закрыт: от одного attention-блока до сервиса, который можно измерить. Дальше — CUDA-кернелы, MoE, tensor/pipeline parallel и disaggregated prefill/decode; но методика та же: сформулировать инвариант, посчитать его в байтах и токенах, написать тест, который падает при нарушении.
Навигация по курсу: Хаб курса · Предыдущий: Прод-сервинг: метрики и движки · Следующий: KV-хэндофф: передача кеша между моделями и узлами