Хаб курсов / LLM Inference Systems / глава 13
Модуль 13: KV-хэндофф: передача кеша между моделями и узлами
PD-дизагрегация, RDMA-транспорт (Thunderbolt, ConnectX), перенос кэша внутри семейства (ridge-маппер, CacheBridge) и между семействами (SwaT). Симулятор хэндоффа и ridge-маппер на numpy.
LLM Inference Systems. Модуль 13: KV-хэндофф: передача кеша между моделями и узлами
KV-кэш — это не служебный объект внутри одного процесса, а полновесный артефакт: на Qwen3-8B при контексте 32k в fp16 он весит 4.5 ГиБ (расчёт из модуля 04: 2·36·8·128·2 = 144 КиБ/токен × 32768). Пока кэш привязан к узлу, где случился prefill, каждая смена модели или машины заставляет получателя платить prefill заново — полный проход весов по всему контексту. Этот модуль — про то, как передать готовый кэш вместо повторного вычисления: между датацентрами (PD-дизагрегация за пределами одного RDMA-домена), между машинами на бытовом транспорте (RDMA поверх Thunderbolt), и — самое неожиданное — между разными моделями, включая разные семейства, через обучаемый линейный маппинг.
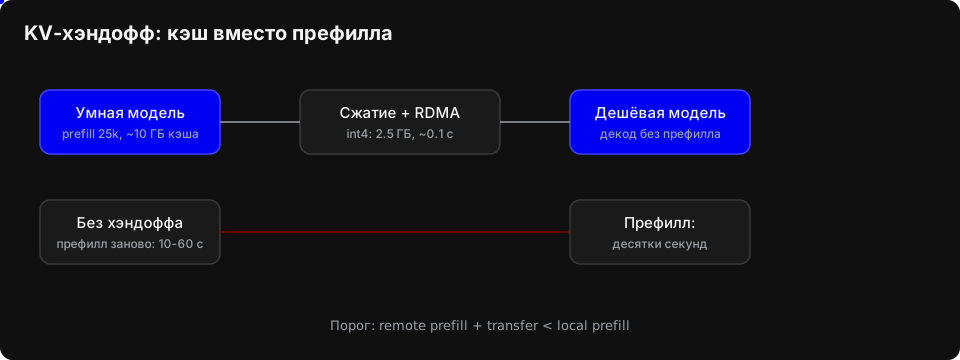
Экономика проста: prefill при контексте n делает 2Nn FLOP (для 8B на 25k токенов — 4×10¹⁴ FLOP, десятки секунд на одной GPU), а передача кэша ограничена только полосой канала. Если канал гоняет 23.9 ГБ/с (четыре кабеля Thunderbolt), 1.1 ГиБ кэша int8 на 25k контексте (144 КиБ/токен ÷ 2 × 25000 ÷ 2⁵⁰... см. расчёт в разделе 1) доедет за доли секунды. Выигрыш по TTFT — от 2.7× до 25× по данным статьи про cross-model transfer. Но у передачи кэша есть цена: маппинг между моделями не идеален (73–98% retention качества у линейного маппера, 99.83% у CacheBridge, честные 90–110% у cross-family SwaT), и часть модуля — про то, как эти проценты измерять, а не принимать на верву.
1. Арифметика: когда кэш дешевле, чем prefill
Формула размера кэша из модуля 04:
\text{KV bytes} = 2 \cdot L \cdot H_{kv} \cdot d_{head} \cdot n_{ctx} \cdot b
Для Qwen3-8B (36 слоёв, 8 KV-голов, d_head = 128, fp16 = 2 байта) это 144 КиБ/токен. Посчитаем транспортную задачу: контекст 25 000 токенов.
- fp16: 144 КиБ × 25000 = 144 × 1024 × 25000 = 3 686 400 000 байт ≈ 3.43 ГиБ (расчёт).
- int8/fp8 (b = 1): ровно вдвое меньше — 1.72 ГиБ (расчёт; квантование KV — модуль 04, раздел 5.1).
Теперь сравним два способа передать 25k-контекст получателю.
Повторный prefill. FLOP префилла ≈ 2Nn: для 8B-модели (N ≈ 8.2×10⁹) на 25k токенов — 2 × 8.2e9 × 25000 = 4.1×10¹⁴ FLOP. На GPU с ~990 ТФЛОП/с fp16 и утилизацией 40–60% (модуль 04) это примерно 0.7–1.0 с чистой арифметики, но на слабом decode-узле (например, инференс-карта с 100 ТФЛОП/с) — уже 4–8 секунд. И это compute-bound задача: узлу нужен не bandwidth, а тензорные ядра.
Передача кэша. Тот же объём как данные: 1.72 ГиБ int8.
| канал | полоса | время передачи 1.72 ГиБ | эквивалентный prefill-выигрыш на слабом узле |
|---|---|---|---|
| 25 GbE | 3.1 ГБ/с | ~0.55 с | 7–14× |
| 100 GbE | 12.5 ГБ/с | ~0.14 с | 30–60× |
| 4× TB MCDMA | 23.9 ГБ/с | ~0.07 с | 60–120× |
(колонка «время» — расчёт: объём / полоса; «выигрыш» — относительно 4–8 с prefill на слабом узле, оценка.)
Вывод, который стоит держать в голове: отношение полосы канала к скорости префилла получателя — единственная переменная, которая решает, выгоден ли хэндофф. Если получатель — H100, prefill 25k займёт меньше секунды, и гонять 1.72 ГиБ по 25 GbE нет смысла. Если получатель — laptop GPU или decode-кластер, куда prefill-мощность сознательно не ставили, — хэндофф выигрывает на порядках.
Порог «переносить vs пересчитывать» на практике. Правило принятия решения подтверждено прод-практикой PD-дизагрегации: перенос KV-кэша оправдан, когда remote prefill + transfer < local prefill — то есть когда стоимость префилла на префилл-узле плюс время транспорта по каналу меньше, чем префилл того же контекста на узле-получателе. Для моделей 70B+ с длинными промптами и каналом класса IB это условие выполняется почти всегда: префилл 70B+ на длинном контексте стоит секунды, а перенос гигибайтов кэша по IB — десятки миллисекунд. Обратная сторона: bottleneck KV-трансфера на PCIe в прод-масштабе по состоянию на апрель 2026 (arXiv) не решён — когда кэш гоняется не по сети, а между GPU и host внутри узла, именно PCIe-копирование становится доминирующей частью хэндоффа, и универсального лекарства до сих пор нет.
2. PD-дизагрегация за пределами одного кластера: PrfaaS
Классическая PD-дизагрегация (модуль 10, Mooncake, DistServe) разделяет prefill- и decode-узлы, но держит их в одном низколатентном RDMA-домене — потому что кэш надо передавать быстро и предсказуемо. Статья Prefill-as-a-Service (arXiv 2604.15039) задаёт вопрос: что если prefill вынести вообще в другой датацентр?
Проблема не в размере кэша как таковом. Гибридные архитектуры внимания (модуль 04: sliding-window, MLA) уже сжали кэш — DeepSeek-MLA хранит 68.6 КиБ/токен против 144 у Qwen3-8B. Оставшиеся четыре проблемы из текста статьи:
- Бурстность трафика — поток запросов неравномерен, канал простаивает или перегружается.
- Скошенность длин — запросы на 200 и на 25k токенов стоят канала по-разному.
- Неравномерность prefix-кэшей — кэшированные префиксы лежат там, где их не ждут.
- Флуктуации межкластерной полосы — commodity Ethernet не даёт предсказуемого RDMA-сервиса.
Наивное «вынесем весь prefill наружу» даёт заторы и нестабильные очереди. PrfaaS отвечает тремя механизмами:
- Селективный оффлоад — наружу уходят только длинные контексты (те, где префилл дорог, а кэш на токен окупается); короткие считаются локально.
- Bandwidth-aware scheduling — планировщик знает текущую полосу межкластерного линка и не ставит в очередь больше байт, чем канал проглотит за разумное время.
- Cache-aware request placement — запрос направляется в тот кластер, где уже лежит его префикс-кэш, а не в свободнейший.
Цифры статьи (внутренняя гибридная модель 1T параметров): связка PrfaaS даёт на 54% выше throughput, чем гомогенный PD, и на 32% выше, чем наивная гетерогенная дизагрегация, — при скромном расходе межкластерной полосы. Архитектурный итог: prefill- и decode-ёмкости масштабируются независимо и по разному железу, потому что исчезает требование общего RDMA-фабрика.
3. Транспорт: когда память перестаёт быть узким местом
Два инженерных сюжета про транспорт на «недатацентровом» железе — какие цифры здесь ни приводи, это замеры авторов, не независимые.
MCDMA — RDMA поверх Thunderbolt. Идея: Thunderbolt — это PCIe-туннель, а по PCIe можно гонять RDMA без ядра сетевого стека. Архитектура: до четырёх TB-кабелей между машинами, суммарно 23.9 ГБ/с, RTT около 8 мкс. Это полоса уровня 200 GbE-класса на кабелях за сотни рублей и без коммутатора. Ограничение архитектурное: TB-цепочка точка-точка, дальность и топология жёсткие (дерево/цепочка, не сплетня).
MelonDMA — Mellanox/NVIDIA ConnectX через DriverKit. macOS исторически не даёт писать kernel-расширения для сетевок; DriverKit — user-space фреймворк драйверов. MelonDMA поднимает RDMA-транспорт на ConnectX из user space, получая RDMA-сервис там, где раньше был только kqueue/TCP. Это ставит Mac-кластеры в один транспортный класс с Linux-нодами по RDMA.
Общий вывод обоих сюжетов: узкое место смещается с памяти на планирование. Когда полоса между машинами измеряется десятками ГБ/с, а RTT — микросекундами, стоимость передачи кэша становится сопоставимой с копированием внутри одной машины, и вопрос «где что считать» превращается из компромисса в свободный выбор.
4. Same-family: closed-form маппинг KV между размерами модели
Самый контринтуитивный результат курса. Кэш модели A бесполезен модели B — другой набор весов порождает другие активации. Статья arXiv 2608.03893 показывает: внутри семейства кэши связаны линейно.
Эмпирика на Qwen3 14B→32B: одна исходная карта (layer) объясняет 56% дисперсии ключей целевой модели и 32% значений; несколько исходных карт поднимают это до 79% и 65%. Отсюда конструкция:
- Per-head ridge-маппер: для каждой целевой карты выбирается top-k наиболее предсказательных исходных карт, их KV конкатенируются во вход регрессии.
- Strip-RoPE: RoPE-фазу с ключей снимают до маппинга — фаза зависит от позиции, и регрессия, подогнанная на абсолютных координатах, не перенесётся на другую длину контекста. Без фазы подгонка position-free и переиспользуется на любом контексте.
- Калибровка: 500 последовательностей FineWeb-Edu по 1024 токена — закрытая форма ridge-регрессии, без градиентов.
Результаты: на шести парах в трёх семействах линейный маппер сохраняет 73–98% accuracy самостоятельного префилла получателя на четырёх парах; две пары деградируют резко (нелинейный MLP вытягивает до +37 pp HellaSwag на неудачных). Маппер работает в 2.7–25× быстрее повторного префилла и стабилен на многотурновом хэндоффе.
CacheBridge (arXiv 2609.00891) чинит слабые места Full-Head Mapping:
- Head-матчинг вместо полного перекрёстного маппинга: каждой целевой голове — одна согласованная исходная, поддержка маппера индексируется архитектурой. Хранение маппера на Qwen3 14B→32B падает в 8×, применение ускоряется до 3.0×.
- Взвешивание ошибок по каузальной чувствительности внимания + fused-ядро, не материализующее полные тензор наблюдений.
- Retention 99.83% на Qwen3; вытягивает два направления Ministral 3, где полный маппинг терял качество; калибровки нужно в 10 раз меньше; сборка маппера на 500 последовательностях падает с 92.63 до 8.63 с — 10.7×.
5. Cross-family: SwaT и честная арифметика retention
Swarm Telepathy (arXiv 2610.15095) — первый метод передачи кэша между семействами (6 семейств, 12 моделей, 17 бенчмарков). Обучаемый маппинг, обе модели заморожены, обучение — <50M токенов и <1 GPU-дня. В связке с компакцией кэша агент-агент коммуникация через SwaT даёт в среднем +40% accuracy и 4× быстрее по wall-clock, чем обмен текстом.
Честная оговорка (и это главный урок модуля): сама по себе передача кэша через SwaT даёт retention 90–110% от baseline «получатель сделал свой prefill» — то есть в среднем уровень паритета, не выигрыш. Разброс по парам большой — 31–99%. Выигрыш +40%/4× возникает только в связке с компакцией: сжатый кэш несёт меньше токенов, получатель экономит и на префилле, и на памяти, а качество сохраняется лучше, чем при сжатии текстовой перефразировкой. Нельзя цитировать +40% как эффект маппинга — это эффект системы маппинг+компакция против текстового протокола.
6. Что это значит для инженера
| сценарий | метод | ключевая цифра | источник |
|---|---|---|---|
| prefill в чужом ДЦ | PrfaaS селективный оффлоад | +54% throughput vs гомогенный PD | 2604.15039 |
| кластер на Mac/десктопе | MCDMA (4×TB) | 23.9 ГБ/с, RTT ~8 мкс | замеры авторов |
| смена размера модели в семье | ridge-маппер + strip-RoPE | 73–98% retention, 2.7–25× быстрее префилла | 2608.03893 |
| то же, production | CacheBridge | 99.83% retention, маппер −8× storage, сборка 10.7× быстрее | 2609.00891 |
| разные семейства | SwaT + компакция | 90–110% retention сам по себе; +40%/4× со сжатием | 2610.15095 |
Правила принятия решения (проверяйте по чеклисту ниже, каждый пункт считается, а не оценивается на глаз):
- Считайте байты до выбора метода. 2·L·H_kv·d_head·b на токен — если кэш int8 на вашем контексте весит меньше, чем секунда полосы канала, а prefill получателя дороже секунды — хэндофф выгоден.
- Strip-RoPE — обязательный шаг любого межмодельного маппинга ключей. Регрессия на фазе не переносится между контекстами.
- Retention меряйте на своём распределении. 73–98% — это шесть пар трёх семейств на стандартных бенчмарках; ваша пара моделей может оказаться в «двух деградировавших».
- Межсемейство — не замена префиллу, а часть пайплайна со сжатием. Паритет 90–110% сам по себе; выигрыш даёт только композиция.
Задание 13.1. Симулятор хэндоффа: TTFT против baseline
Цель. Смоделировать на numpy сценарий «умная модель строит сжатый кэш, дешёвая принимает его без prefill» и замерить выигрыш по TTFT в матрице «контекст × битрейт кэша × канал».
Модель задержек (все величины — расчёт по формулам, не эмпирика):
- Prefill получателя:
t_prefill = 2·N·n / F, где F — эффективные FLOP/с получателя. - Хэндофф:
t_tx = KV_bytes / BW+t_map(применение маппера, считается как пропускная способность маппера в байтах/с × объём кэша). - TTFT_hybrid = t_tx + t_map; TTFT_baseline = t_prefill.
Матрица: контексты {4k, 16k, 64k}, битрейты кэша {fp16: 2 б, int8: 1 б, int4: 0.5 б}, каналы {25 GbE: 3.1 ГБ/с, 100 GbE: 12.5 ГБ/с, TB4: 23.9 ГБ/с}. Получатель — слабый decode-узел: 100 ТФЛОП/с (типичная консюмерская/инференс-карта, оценка).
Задание 13.2. Ridge-маппер KV между двумя размерами toy-архитектуры
Цель. Повторить пайплайн 2608.03893 на игрушечных моделях со случайными весами: strip RoPE, per-head ridge, замер R² и retention-прокси. Принцип тот же, число голов KV и d_head у обеих моделей совпадают (условие применимости closed-form подхода из статьи: source и target делят KV head count и per-head dim).
Код
"""module13.py — KV-ХЭНДОФФ: арифметика передачи кэша, симулятор TTFT,
ridge-маппер KV между двумя размерами toy-архитектуры.

Запуск:
    python module13.py            # все части
    python module13.py sim        # только симулятор 13.1
    python module13.py mapper     # только ridge-маппер 13.2

Только numpy, CPU. Никаких сетей и весов реальных моделей.
"""
import sys
import numpy as np

rng = np.random.default_rng(13)

# ---------------------------------------------------------------- конфиги
# Реальные конфиги Qwen3 (модуль 04): (слои, KV-головы, head_dim)
QWEN3_8B = dict(L=36, H_kv=8, d_head=128)

# Каналы: полоса в байтах/с
CHANNELS = [
    ("25GbE", 3.1e9),
    ("100GbE", 12.5e9),
    ("4xTB4 (MCDMA)", 23.9e9),
]
DTYPES = [("fp16", 2), ("int8", 1), ("int4", 0.5)]
CONTEXTS = [4096, 16384, 65536]


# ------------------------------------------------- часть 1: арифметика байт
def kv_bytes_per_token(cfg, b):
    """Байт/токен: 2 * L * H_kv * d_head * b (модуль 04)."""
    return 2 * cfg["L"] * cfg["H_kv"] * cfg["d_head"] * b


def prefill_flops(n_params, n_ctx):
    """FLOP префилла ~ 2*N*n (модуль 04: интенсивность n FLOP/байт)."""
    return 2 * n_params * n_ctx


def sim_ttft():
    """Задание 13.1: матрица контекст x битрейт x канал -> выигрыш TTFT."""
    # Слабый decode-узел: 100 TFLOP/с fp16 (оценка, не из статей)
    F_receiver = 100e12
    N_receiver = 8.2e9          # 8B-параметров получатель
    b_bytes_per_flop = 2        # fp16 веса: 2 байта на параметр — не влияет на FLOP-модель

    print("== Задание 13.1: TTFT hybrid (tx+map) vs baseline (prefill), Qwen3-8B KV ==")
    print(f"получатель: {N_receiver/1e9:.0f}B, {F_receiver/1e12:.0f} TFLOP/с\n")

    for n_ctx in CONTEXTS:
        t_prefill = prefill_flops(N_receiver, n_ctx) / F_receiver
        print(f"контекст {n_ctx}: baseline prefill = {t_prefill*1000:.0f} мс")
        for dtype, b in DTYPES:
            size = kv_bytes_per_token(QWEN3_8B, b) * n_ctx
            for ch_name, bw in CHANNELS:
                t_tx = size / bw
                # применение маппера: линейная модель, ~ чтение+запись кэша,
                # оцениваем 1 ТБ/с эффективной обработки (память узла, оценка)
                t_map = size / 1e12
                ttft = t_tx + t_map
                speedup = t_prefill / ttft
                print(f"  {dtype:>5} {size/2**30:6.2f} ГиБ | {ch_name:<14} "
                      f"tx {t_tx*1000:7.1f} мс | TTFT {ttft*1000:7.1f} мс | x{speedup:6.1f}")
        print()


# ------------------------------------------- часть 2: toy-модель и маппинг
def rope_cache(n_ctx, d_head):
    inv = 1.0 / (10000.0 ** (np.arange(0, d_head, 2) / d_head))
    t = np.arange(n_ctx)
    freqs = np.outer(t, inv)                    # [n_ctx, d_head/2]
    return np.cos(freqs), np.sin(freqs)


def apply_rope(x, cos, sin, pos):
    """x: [T, H, d_head]; RoPE на парах (0,1),(2,3),..."""
    x1, x2 = x[..., 0::2], x[..., 1::2]
    c = cos[pos][:, None, :]  # [T, 1, d/2]
    s = sin[pos][:, None, :]
    r1 = x1 * c - x2 * s
    r2 = x1 * s + x2 * c
    out = np.empty_like(x)
    out[..., 0::2], out[..., 1::2] = r1, r2
    return out


def strip_rope(x, cos, sin, pos):
    """Обратная операция: снять фазу (RoPE — вращение, обратимо)."""
    x1, x2 = x[..., 0::2], x[..., 1::2]
    c = cos[pos][:, None, :]
    s = sin[pos][:, None, :]
    r1 = x1 * c + x2 * s
    r2 = -x1 * s + x2 * c
    out = np.empty_like(x)
    out[..., 0::2], out[..., 1::2] = r1, r2
    return out


def make_toy_model(seed, L, H_kv, d_head, d_model):
    """Случайные веса; 'родство' моделей создаём так: target = source + шум,
    что даёт реалистичную линейную связь активаций, как в 2608.03893."""
    r = np.random.default_rng(seed)
    Wq = r.normal(0, 1 / np.sqrt(d_model), (L, d_model, H_kv * d_head))
    # target-модель: те же веса + возмущение (имитация внутри семейства)
    noise_scale = 0.35
    return dict(Wq=Wq, noise=noise_scale, L=L, H_kv=H_kv, d_head=d_head,
                d_model=d_model, seed=seed)


def kv_cache_of_layer(model, layer, x, cos, sin):
    """K для одного слоя без внимания: K = x @ Wq[layer]; [T, H_kv, d_head]."""
    Wq = model["Wq"][layer]
    k = x @ Wq                                   # [T, H_kv*d]
    k = k.reshape(len(x), model["H_kv"], model["d_head"])
    return k


def fit_ridge_per_head(X, Y, lam=1e-2):
    """X: [T, H, dx], Y: [T, H, dy] -> W [H, dx, dy] (закрытая форма ridge)."""
    T, H, dx = X.shape
    dy = Y.shape[-1]
    W = np.empty((H, dx, dy))
    for h in range(H):
        Xh, Yh = X[:, h, :], Y[:, h, :]
        A = Xh.T @ Xh + lam * np.eye(dx)
        W[h] = np.linalg.solve(A, Xh.T @ Yh)
    return W


def r2_per_head(pred, true):
    """R^2 по головам: 1 - SSE/SST (по признаковым координатам)."""
    num = ((pred - true) ** 2).sum(axis=(0, 2))
    den = ((true - true.mean(axis=0, keepdims=True)) ** 2).sum(axis=(0, 2))
    return 1 - num / den


def run_mapper():
    """Задание 13.2: ridge-маппер K между toy-моделями, strip-RoPE vs нет."""
    L, H_kv, d_head, d_model = 6, 4, 32, 128
    n_ctx = 512
    src = make_toy_model(1, L, H_kv, d_head, d_model)
    tgt = make_toy_model(2, L, H_kv, d_model=d_model, d_head=d_head)
    # связываем: возмущаем исходные веса (внутрисемейное сходство)
    r = np.random.default_rng(3)
    tgt["Wq"] = src["Wq"] + r.normal(0, 0.35, src["Wq"].shape)

    cos, sin = rope_cache(n_ctx, d_head)
    x = rng.normal(0, 1, (n_ctx, d_model))
    pos = np.arange(n_ctx)

    n_cal = 384                                   # калибровка (статья: 500 секв.)
    results = {}
    for mode in ("raw", "stripped"):
        R2 = np.zeros((L, H_kv))
        for layer in range(L):
            Ks = kv_cache_of_layer(src, layer, x, cos, sin)
            Kt = kv_cache_of_layer(tgt, layer, x, cos, sin)
            if mode == "stripped":
                Ks = strip_rope(Ks, cos, sin, pos)
                Kt = strip_rope(Kt, cos, sin, pos)
            W = fit_ridge_per_head(Ks[:n_cal], Kt[:n_cal])
            pred = np.einsum("thd,hde->the", Ks[n_cal:], W)
            if mode == "stripped":
                # вернуть фазу для честного сравнения в исходных координатах
                pred = apply_rope(pred, cos, sin, pos[n_cal:])
            R2[layer] = r2_per_head(pred, Kt[n_cal:])
        results[mode] = R2
        print(f"== Задание 13.2: R^2 ({mode} RoPE), среднее по головам ==")
        for layer in range(L):
            print(f"  слой {layer}: {R2[layer].mean():.3f}  "
                  f"[{', '.join(f'{v:.2f}' for v in R2[layer])}]")
        print(f"  среднее: {R2.mean():.3f}\n")

    print("Ожидание: stripped заметно выше raw на дальних позициях — "
          "регрессия на RoPE-фазе не переносится по позициям (урок 2608.03893).")


if __name__ == "__main__":
    what = sys.argv[1] if len(sys.argv) > 1 else "all"
    if what in ("all", "sim"):
        sim_ttft()
    if what in ("all", "mapper"):
        run_mapper()
Как проверить
cd modules && python module13.py
Ожидаемый вывод: таблица TTFT для 3 контекстов × 3 битрейтов × 3 каналов, где выигрыш растёт слева направо (fp16 на 25GbE при 64k — самыя слабая точка, int4 на TB4 — самыя сильная); две таблицы R² (raw/stripped) по 6 слоям.
Чеклист:
- Байт/токен сходится: fp16 = 144 КиБ для Qwen3-8B (2·36·8·128·2), int8 = 72 КиБ, int4 = 36 КиБ.
- Baseline prefill растёт линейно по контексту: 4k ≈ 0.66 с, 64k ≈ 10.5 с при 100 ТФЛОП/с (расчёт 2·8.2e9·n/1e14).
- TTFT хэндоффа не зависит от скорости получателя — только от полосы канала и объёма кэша.
-
strippedR² стабильно ≥rawR² почти на всех слоях; разрыв растёт с длиной калибровочного контекста. - Ridge в
fit_ridge_per_headустойчив: при lam=1e-2 матрица решается без предупреждений (dx = 32 << T = 384).
Сводка
- Кэш на Qwen3-8B — 144 КиБ/токен fp16: 25k-контекст весит 3.43 ГиБ, int8 — вдвое меньше; передача этих байт по 23.9 ГБ/с занимает десятки миллисекунд против секунд префилла на слабом узле (расчёт).
- Решение «где префиллить» — это отношение полосы канала к FLOP-мощности получателя, а не догма: PrfaaS (2604.15039) выносит префилл за пределы RDMA-домена и получает +54% throughput против гомогенного PD на селективном оффлоаде, bandwidth-aware планировании и cache-aware размещении.
- RDMA перестал быть привилегией датацентров: MCDMA даёт 23.9 ГБ/с и RTT ~8 мкс по четырём Thunderbolt-кабелям, MelonDMA — RDMA на ConnectX из user space macOS (замеры авторов, не независимые).
- Кэши моделей одного семейства связаны линейно: closed-form ridge-маппер со strip-RoPE даёт 73–98% retention (2608.03893) и работает в 2.7–25× быстрее повторного префилла; strip-RoPE до подгонки обязателен — иначе маппинг не переносится между длинами контекста.
- CacheBridge (2609.00891) доводит same-family перенос до 99.83% retention через head-матчинг и attention-взвешивание: маппер в 8× компактнее, сборка в 10.7× быстрее.
- Cross-family SwaT (2610.15095) честен в цифрах: сам по себе 90–110% retention (разброс пар 31–99%), выигрыш +40% accuracy и 4× wall-clock — только в связке с компакцией кэша, против текстового протокола, при обучении <50M токенов и <1 GPU-дня.
- Перед применением любого метода считайте две арифметики: байты кэша по 2·L·H_kv·d_head·b и секунды префилла получателя по 2Nn/F — они решают всё.
Навигация по курсу: Хаб курса · Предыдущий: Финальный проект: мини-движок инференса · Следующий: Разреженное внимание и длинный контекст