Хаб курсов / LLM Inference Systems / глава 17
Модуль 17: Unified memory и гибридные ноды: четвёртый путь инференса
Аппаратная ось поверх MLX/CUDA/CPU: Apple M, AMD Strix Halo, NVIDIA DGX Spark, placement, MoE expert offload и гибридная нода с fast-head.
LLM Inference Systems. Модуль 17: Unified memory и гибридные ноды — четвёртый путь инференса
Три пути курса (MLX/CUDA/CPU-GGUF) — это ось программного стека. Но есть ортогональная ось — железо, и на ней существует класс устройств, который не сводится ни к «GPU с VRAM», ни к «CPU с DDR5»: когерентная unified memory (Apple M-серии, AMD Strix Halo, NVIDIA DGX Spark) и гибридные ноды (unified-memory бокс + дискретный GPU). Этот класс обязан быть отдельным модулем по одной причине: в нём память и её ширина, а не FLOPs, решают, что запустится и с какой скоростью. 128 ГБ единых байтов за ~273–800 ГБ/с — это возможности, которых нет ни у 24 ГБ RTX 4090, ни у 128 ГБ DDR5 на 90 ГБ/с, и оптимизировать этот класс нужно другими рецептами, чем оба.
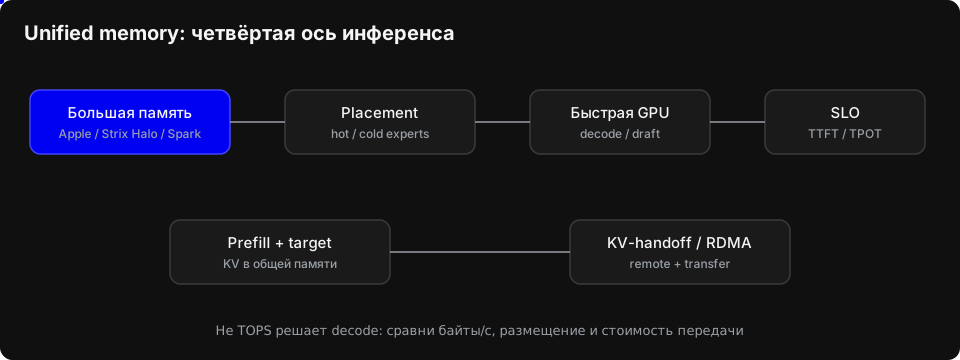
План модуля: классификация железа по памяти, а не по вендору; архитектура когерентной unified memory против раздельных адресных пространств; набор оптимизаций для unified-класса (placement, KV в общей памяти, [MoE expert offload](/glossary/expert-offload/), кластеризация); гибридные ноды, где большая модель живёт на unified-нодах, а decode-ускорение — на дискретном GPU, с KV-хэндоффом из модуля 13 в роли транспорта. Два задания: калькулятор placement (17.1) и симуляция MoE hot/cold offload с замером влияния hit-rate кеша экспертов (17.2).
1. Классификация железа по памяти, не по вендору
Забудьте на минуту про вендоров. С точки зрения инференса устройства делятся на три класса по одному признаку: сколько байтов в секунду может прочитать вычислитель из самой большой памяти, куда влезает модель.
1.1 Три класса
Класс A: дискретный GPU. VRAM узкая и быстрая (HBM3: A100 — 2.04 ТБ/с на 80 ГБ; HBM3e/GDDR7 у потребительских карт — 1–1.8 ТБ/с), до host — шина PCIe gen4/gen5 (32–64 ГБ/с), которая в 30–60 раз медленнее VRAM. Модель больше VRAM — либо квантизация, либо offload через эту узкую трубу, и каждый байт, который гоняется по PCIe при декодинге, стоит в ~20 раз дороже того же байта, прочитанного из VRAM.
Класс B: когерентная unified memory. Один физический массив DRAM, один адрес для CPU и GPU, когерентность на аппаратном уровне. Примеры 2025–2026:
| Устройство | Память | Ширина (BW) | Пиковые FLOPs | Цена класса |
|---|---|---|---|---|
| Apple M4 Pro | до 64 ГБ LPDDR5 | ~273 ГБ/с | ~10 Т (GPU) | ноутбук/мини |
| Apple M3 Ultra | до 512 ГБ | ~800 ГБ/с | ~24 Т | workstation, ~10k USD |
| NVIDIA DGX Spark (GB10) | 128 ГБ LPDDR5X | ~273 ГБ/с | 1 PFLOP FP4 | ~4k USD |
| AMD Ryzen AI Max 395 (Strix Halo) | до 128 ГБ LPDDR5X-8000, 256-бит шина | ~273 ГБ/с | ~50 Т FP16 (ROCm-статус зрелый не везде) | мини-ПК от ~2k USD |
Класс C: CPU-сервер / десктоп. Много памяти (0.5–6 ТБ на ноду EPYC), но ширина скромная: DDR5-5600 8 каналов ≈ 179 ГБ/с, 12 каналов ≈ 269 ГБ/с — и это уже лучший случай. Плюс GEMV на CPU ограничен ещё и числом ядер, поэтому реальный потолок ниже формального BW-потолка (модуль 01: реальность 60–80% от теории).
Ключевая колонка — BW, а не FLOPs. Проверим это на живом примере из нашего плана фермы (внутренний замер, методология модуля 16): DGX Spark с его FP4-петафлопсом даёт 35B MoE-модель всего ~40 tok/s при батче 1. Почему? Декодинг батча 1 — memory-bound (модуль 01: арифметическая интенсивность 1 флоп/байт), значит потолок = BW / байты_весов = 273 ГБ/с / (35B × 0.5 байта ≈ 17.5 ГБ) ≈ 15.6 tok/s в 4 бита; с MoE-активными параметрами (~3B активных) потолок выше, но всё равно упирается в те же 273 ГБ/с на веса + KV, а не в 1000 ТФЛОП. Петафлопсы простаивают: загружен контроллер памяти на ~100%.
А тот же класс задач (MoE ~30B, спекуляция + FP4-веса) на SGLang с рецептом NVFP4 + DFlash2 даёт ~72 tok/s — не потому, что железо быстрее, а потому, что рецепт (квантизация весов + спекулятивный декодинг с высокой acceptance, модули 05 и 15) уменьшает эффективное число байтов на токен, то есть бьёт ровно в тот bottleneck, который реально ограничивает. Мораль: на unified-железе FP4-флопсы — маркетинг для prefill и батчинга; всё, что происходит при батче 1, решает ГБ/с.
1.2 Почему 273 ГБ/с — это «много и мало одновременно»
273 ГБ/с — это в 3 раза больше десктопного DDR5 (90 ГБ/с) и в ~3.7 раза меньше RTX 4090 (1008 ГБ/с). Потолки декодинга для Qwen3-8B (модуль 00, формула BW / bytes_weights):
- fp16 (16.38 ГБ): Spark/Strix ≈ 16.7 tok/s; M3 Ultra ≈ 49 tok/s; 4090 ≈ 61.5 tok/s
- W4 (4.61 ГБ): Spark/Strix ≈ 59 tok/s; M3 Ultra ≈ 173 tok/s; 4090 ≈ 219 tok/s
А вот чем класс B убивает класс A: ёмкость. На 24 ГБ 4090 модель 8B fp16 + KV едва размещается без батчинга (модуль 00: 7.6 ГБ остаётся под всё). На 128 ГБ Spark/Strix влезает 70B dense в fp16, или 235B+ в W4, или MoE на сотни миллиардов суммарных параметров. На 512 ГБ M3 Ultra — DeepSeek-класс моделей целиком в памяти без единого байта offload по узкой шине. Это класс «большая модель, одиночный поток, без датацентра».
2. Архитектура памяти: когерентная единая адресация против раздельных пространств
2.1 Что значит «когерентная»
На классической ноде CPU+GPU два адресных пространства: malloc даёт указатель в host RAM, cudaMalloc — в VRAM. Копирование между ними — явное (cudaMemcpy) и идёт по PCIe. На классе B один физический массив, и указатель один и тот же для CPU и GPU: CPU записал — GPU видит без копии. Следствия для инференса:
- Нет PCIe-налога на offload. «Слой на CPU» и «слой на GPU» — это вопрос того, какой вычислитель читает байты, а не того, где они физически лежат. Перекладывание тензора между вычислителями стоит копирования в лучшем случае по внутренней сети-на-кристалле, а не по PCIe.
- KV-кэш один. Не нужны зеркала кэша на CPU и GPU, не нужна синхронизация (ср. модуль 04, где на классической ноде offload KV в host RAM — это отдельный механизм с явными копиями).
- Планировщик памяти проще. Не надо угадывать, что понадобится GPU: если что-то не влезло, это не фатальная ошибка размещения, а замедление (данные ушли через более медленный путь к тому же массиву).
2.2 Strix Halo: главный рецепт — «отдать память под GPU»
У Strix Halo (Ryzen AI Max 395) память физически одна, но BIOS/драйвер по умолчанию отдаёт GPU лишь небольшую долю (устаревшая модель UMA: «fixed» + «gtt»). Стандартная ловушка: движок видит «GPU memory: 0.5 ГБ» и начинает консервативный offload слоёв на CPU (ошибка, разберём в разделе 3), хотя железо позволило бы держать модель целиком «на GPU». Главный рецепт конфигурации: увеличить GPU-долю (UMA frame buffer / ttm GTT sizing, в llama.cpp — флаги вроде --n-gpu-layers 999 + увеличенный GTT, в ROCm — HSA_ENABLE_SDMA, --gpu-memory-budget) так, чтобы весь весовой массив считался GPU-локальным. Числовой ориентир: модель W4 70B ≈ 38 ГБ + KV — на 128 ГБ Strix Halo помещается с запасом для ОС, но только если GPU-пул поднят с дефолтных ~0.5–16 ГБ.
2.3 Где Mac выигрывает
Шина M3 Ultra — ~800 ГБ/с против ~273 ГБ/с у Spark и Strix Halo, при ёмкости до 512 ГБ. Для dense-модели потолок декодинга пропорционален BW (раздел 1.2): на одной и той же 70B W4-модели (~38 ГБ) M3 Ultra даёт ~21 tok/s, Spark/Strix — ~7 tok/s. Именно BW, а не «мощность NPU» или «число ядер», — причина, по которой Mac остаётся эталоном одиночного потока на больших моделях. Цена обратная: 273 ГБ/с стоят ~`2–4k, 800 ГБ/с — ~10k USD, и ни то, ни другое не батчится (точка перелома B* = FLOPs/BW ≈ 1 PFLOP FP4 / 273 ГБ/с ≈ 2000 — theoretical; реальный ceiling по тензорным ядрам ниже, но всё равно batching на этом классе ограничен памятью на KV, а не дефицитом вычислений).
3. Оптимизации unified-memory класса
3.1 Placement: сколько слоёв «на GPU»
На классической ноде вопрос «сколько слоёв на GPU» — компромисс: слои на CPU читаются из DDR5 (медленно), но не занимают VRAM. На классе B правильный ответ почти всегда: все слои на GPU. Причина — шина общая: чтение весов «CPU-слоя» из того же массива DRAM стоит тех же байтов/секунду, что и «GPU-слоя», а запуск ядра на GPU дешевле, чем GEMV на CPU (модуль 01: CPU-путь ограничен и ядрами, не только BW). Размещение части слоёв на CPU даёт худшее из двух миров: вы всё равно читаете те же байты из той же памяти, но часть GEMV исполняется на медленном вычислителе.
Ловушка консервативного offload: LM Studio и подобные туллкиты по умолчанию считают «VRAM = GPU-доля UMA» (часто 0.5–16 ГБ) и автоматически оставляют 60–80% слоёв на CPU. Пользователь Strix Halo с 96 ГБ получает 4 tok/s вместо 15+, ищет проблему в «слабом железе», а проблема — в одной строчке конфига. Правило диагностики: если в логе движка видно «offloading N/L layers to CPU» на unified-устройстве — сначала поднимите GPU-пул памяти, потом обвиняйте шину.
Когда частичный CPU-placement всё же оправдан: embedding-таблица + lm_head у MoE-гигантов (занимают десятки ГБ, читаются один раз на токен) могут жить «на CPU» без потери скорости на M-серии, потому что gather-по-строке — 2 КБ чтения, а не проход по весам (модуль 01, раздел 1.5).
3.2 KV-кэш в общей памяти и prefetch
KV на 4k контекста для Qwen3-8B — 576 МиБ (модуль 00); для 128k — 18 ГиБ. На классе B кэш просто лежит в общей памяти рядом с весами; никаких PCIe-копий при attention. Единственная оптимизация, которая остаётся, — prefill/decode не должны конкурировать за BW с ОС: выделяйте KV-пул заранее (paged allocator из модуля 09 работает здесь без изменений — меняется только то, что «страницы» не надо никому копировать).
3.3 MoE expert offload: холодные эксперты в RAM, горячие — на GPU
Класс B с 128–512 ГБ позволяет не offload'ить эксперты вовсе — но только если модель влезает. DeepSeek-класс (671B, W4 ≈ 380 ГБ) на 512 ГБ M3 Ultra — впритык; на 128 ГБ Spark — нет. Здесь включается дисциплина CPU-GPU гетерогенной ко-обработки, канонизированная KTransformers (github.com/kvcache-ai/ktransformers):
- attention-слои целиком на GPU — они плотные, горячие на каждом токене, маленькие относительно MoE-блоков;
- MoE-эксперты (routed experts) в RAM — их суммарный вес на порядки больше, а на каждый токен активны лишь top-k из сотен (у DeepSeek-V4-Flash активных ~3B из 35B суммарных);
- квантование routed experts в RAWINT4/MXFP4 — weights и так читаются целиком при активации, значит байты на параметр — прямой множитель времени;
- LoRA fine-tune той же схемой (KT-FT): обучаемые адаптеры на GPU, замороженные эксперты в RAM — тем же placement-принципом.
Почему это работает быстрее наивного «всё на CPU»: GEMV по 3B активных параметров в 4 бита ≈ 1.5 ГБ чтения на токен; если горячие эксперты кешируются в быстрой доле памяти рядом с GPU (а не читаются с того же массива с конкуренцией за контроллер), эффективный hit-rate поднимает потолок. Почему это медленнее, чем «всё влезло»: каждый cache-miss по эксперту — чтение десятков–сотен МБ, и hit-rate решает всё (задание 17.2 это меряет).
Собственно, это та же дисциплина, что CPU-путь GGUF (модуль 00), только с GPU в роли вычислителя горячей части — и она переносится на классическую ноду GPU+RAM через PCIe с соответствующим штрафом за транспорт.
3.4 Спекуляция и квантизация поверх
На unified-железе оба приёма из модулей 05 и 15 работают без изменений и дают кратный эффект, потому что снижают байты на сгенерированный токен: FP4-веса делят чтение на ~3.5 (4.5 бита с scales), спекулятивный декодинг с acceptance ~80% делит ещё на ~2. Рецепт из раздела 1.1 (NVFP4 + DFlash2 на SGLang, 72 tok/s на 27B против «честных» ~20) — это ровно композиция двух приёмов на 273 ГБ/с шине.
3.5 Кластеризация: до 4 узлов Spark
DGX Spark несёт ConnectX-7 (200 Гбит/с ≈ 25 ГБ/с) и официально масштабируется до 4 узлов. Это мост к модулям 10 и 13: между Spark'ами гоняется не текст, а KV-хэндофф (модуль 13) или тензорные шарды (TP, модуль 10). Числа модуля 13 переносятся дословно: 1.72 ГиБ int8-кэша на 25k контексте по 25 ГБ/с — 0.07 с; против prefill получателя на том же узле — выигрыш в разы. Собранный из четырёх Spark кластер даёт ~512 ГБ суммарной памяти за ~16k USD — ниша между одним Mac Ultra (10k USD) и одной A100-нодой (30k+ USD).
4. Гибридные ноды: unified-memory бокс + дискретный GPU
Второй класс из заголовка модуля. Схема: unified-memory машина (или несколько) держит большую модель и префилл; дискретная NVIDIA GPU рядом выполняет decode-ускорение: draft-модель, быстрый «головной» кусок target, ranker спекуляции.
4.1 Что передаётся и по чему
Между частями гибрида гоняется ровно один тяжёлый артефакт — KV-кэш (модуль 13), транспорт — RDMA поверх ConnectX/Thunderbolt или обычный 100GbE. Арифметика из модуля 13 решает, выгоден ли сплит: переносить KV оправдано, когда remote prefill + transfer < local prefill на GPU-узле. На практике гибрид собирают, когда: (а) большая модель не влезает в VRAM дискретной GPU ни в каком квантовании, (б) unified-нода даёт достаточный prefill-throughput (много ГБ памяти + приличная шина), (в) канал ≥ 25 ГБ/с.
4.2 Рецепты раскладки
- Draft на GPU, target на unified. Спекулятивный декодинг (модуль 15): draft 0.6B fp16 — 1.2 ГБ, на 4090 он молотит с полной BW VRAM; каждые принятые draft-токены — это токены, для которых тяжёлый target не читал свои байты вовсе. Выигрыш ≈ acceptance rate × (стоимость target-шага / стоимость draft-шага), при 80% acceptance и отношении байтов 38/1.2 — кратный.
- MoE-эксперты в RAM GPU-ноды. Если GPU-нода — серверная с большим host RAM, cold-эксперты live в host RAM по PCIe (KTransformers-схема из 3.3), hot-эксперты кешируются в VRAM. Порог окупаемости считает задание 17.2.
- Fast-head на GPU. Разреженное внимание/last-layers-only (модуль 14): последние слои + lm_head живут на дискретной GPU, ранние — на unified; по каналу тогда гоняются не полный KV, а активации стыка.
- NPU в SoC: что реально. XDNA2 в Strix Halo даёт ~50 TOPS INT8, у Apple ANE — свой стек. Для LLM-инференса NPU сегодня реально используется производителем (MLX умеет в ANE ограниченно; Windows-стек — ONNX Runtime / DirectML) для мелких моделей и препроцессинга; заявленные TOPS — INT8-пик на маленьких матрицах, для GEMV больших моделей NPU не даёт ни BW (память та же), ни зрелого стека. Правило: 50 TOPS NPU ≠ 50 ТФЛОП полезной нагрузки; при выборе бокса смотрите на BW и на драйверную поддержку GPU-вычислений, NPU игнорируйте до появления движков уровня llama.cpp/vLLM для него.
4.3 Порог выгодности
Формула та же, что в модуле 13: раскладка «префилл на unified, decode на GPU» выигрывает, когда
T_{prefill}^{unified}(n) + \frac{KV_{bytes}(n)}{BW_{link}} < T_{prefill}^{GPU}(n) + T_{decode}^{GPU}\cdot\Delta
где Δ — разница decode-скорости на GPU против decode на unified (на больших моделях GPU decode быстрый только если все веса локальны — иначе это не decode-ускорение, а additional PCIe-traffic). Отсюда правило: гибрид имеет смысл для dense-моделей, не влезающих в VRAM, только если decode остаётся на unified, а GPU делает draft/rank — либо для MoE, где decode-часть (attention + top-k router) помещается в VRAM, а эксперты берутся из RAM.
Задание 17.1: калькулятор placement
Реализуйте placement.py: для заданного железа (память, ширина, пиковые FLOPs) и модели (параметры, активные параметры для MoE, KV-конфиг) перебрать варианты раскладки и выдать ожидаемый tok/s по memory-bound формуле модуля 01.
Интерфейс:
@dataclass(frozen=True)
class Device:
    name: str
    total_bytes: int      # ёмкость самой большой памяти
    bw_bytes_s: float     # ширина этой памяти
    flops: float          # пиковые FLOPs (для prefill и B*)
    unified: bool = True  # False => дискретная GPU + host (см. penalty)

@dataclass(frozen=True)
class ModelSpec17:
    name: str
    n_params: int          # суммарные параметры
    n_active: int          # активные на токен (для MoE), для dense == n_params
    kv_bytes_per_token: int

def placements(dev: Device, m: ModelSpec17, ctx: int, bits_weights: float) -> list[dict]:
    """Возвращает все feasible-раскладки: (все_на_gpu, moe_offload, cpu_split_fallback)
    с полями: scheme, fits, tok_s_decode, ttft_s, notes."""

def best(dev: Device, m: ModelSpec17, ctx: int, bits_weights: float) -> dict:
    """Лучшая feasible-раскладка."""
Модель расчёта (всё из модуля 01):
- веса:
n_params * bits_weights / 8; KV:kv_bytes_per_token * ctx; - unified: все веса читаются с BW устройства →
tok_s = BW / (bytes_чтения_на_токен), где bytes =n_active * bits/8(+ доля cache-miss для offload-варианта); - moe_offload: hot-часть (attention + router + top-k доля экспертов, параметризуйте
hot_frac) в «быстрой» зоне, cold — в общей; если unified — разницы нет, если дискретная — cold-чтение через PCIe BW; - decode vs prefill: TTFT =
2 * n_params * ctx / flops(compute-bound, модуль 01) — на этом месте FP4-петафлопсы Spark наконец работают.
Проверьте на трёх устройствах (M3 Ultra 512 ГБ/800 ГБ/с; Spark 128 ГБ/273 ГБ/с/1 PFLOP FP4; 4090 24 ГБ/1008 ГБ/с) и двух моделях (Qwen3-8B dense; MoE 35B с 3B активных). Ожидаемые порядки: Qwen3-8B W4 на Spark ≈ 55–60 tok/s; MoE-35B W4 на Spark с offload — не ниже ~40 tok/s (см. наш замер 40 tok/s как нижнюю границу реальности).
Задание 17.2: симуляция MoE offload — hit-rate против wall-clock
Смоделируйте поток токенов через MoE-слой с cold-экспертами в RAM и hot-кешем ограниченного объёма. На каждый токен активируются top-k из E экспертов; если все k экспертов в кеше — быстрый путь (чтение из VRAM-зоны), иначе miss: подгрузка недостающих экспертов из RAM (в общем массиве — с конкуренцией за контроллер; на дискретной GPU — через PCIe).
Параметры: E=256 экспертов, top_k=8, вес эксперта 200 МБ (MXFP4), hot-кеш вмещает C экспертов, hit-чтение 1008 ГБ/с (VRAM) или 273 ГБ/с (unified), miss-транспорт 25 ГБ/с (PCIe gen5 / ConnectX) или 100 ГБ/с (внутри массива, штраф на конкуренцию — параметризуйте). Стратегии вытеснения: LRU и LFU против router-aware (кеш по предсказанию router'а на следующий токен — у LLM-текста эксперты коррелируют по токенам сильнее случайного).
Замерьте wall-clock на 100k токенов как функцию C (0, 16, 32, 64, 128) для каждой стратегии и выведите: hit-rate, средний tok/s, сравнение с «всё в RAM» и «всё в кеше». Ожидаемый вывод: router-aware при C=32 обгоняет LRU при C=64 — предсказание router'а стоит дешевле, чем лишний ГБ кеша.
Код
"""module17.py — unified memory и гибридные ноды: калькулятор placement (17.1)
и симуляция MoE hot/cold expert offload (17.2).

Запуск:
    python module17.py            # все части
    python module17.py place      # только 17.1
    python module17.py moe        # только 17.2
Только numpy + стандартная библиотека, CPU.
"""
from __future__ import annotations

import sys
from collections import Counter, deque
from dataclasses import dataclass

# ======================================================================
# Задание 17.1: калькулятор placement
# ======================================================================

@dataclass(frozen=True)
class Device:
    name: str
    total_bytes: int
    bw_bytes_s: float
    flops: float
    unified: bool = True

@dataclass(frozen=True)
class ModelSpec17:
    name: str
    n_params: int
    n_active: int
    kv_bytes_per_token: int

M3_ULTRA = Device("M3 Ultra (512GB)", 512 * 2**30, 800e9, 24e12)
DGX_SPARK = Device("DGX Spark (128GB)", 128 * 2**30, 273e9, 1e15, unified=True)
RTX_4090 = Device("RTX 4090 (24GB)", 24 * 2**30, 1008e9, 165e12, unified=False)

QWEN3_8B = ModelSpec17("Qwen3-8B", 8_190_726_144, 8_190_726_144,
                       2 * 36 * 8 * 128 * 2)          # 144 КиБ/токен fp16
MOE_35B = ModelSpec17("MoE-35B (3B active)", 35e9, 3e9, 2 * 30 * 8 * 128 * 2)


def weights_bytes(m: ModelSpec17, bits: float) -> float:
    return m.n_params * bits / 8.0


def active_bytes(m: ModelSpec17, bits: float) -> float:
    """Байт весов, читаемых за один decode-шаг (активная часть)."""
    return m.n_active * bits / 8.0


def kv_total(m: ModelSpec17, ctx: int) -> float:
    return m.kv_bytes_per_token * ctx


def ttft_s(m: ModelSpec17, dev: Device, ctx: int, mf: float = 0.4) -> float:
    """Prefill: 2*N*ctx FLOP (модуль 01), mf — реальная утилизация."""
    return 2 * m.n_params * ctx / (dev.flops * mf)


def placements(dev: Device, m: ModelSpec17, ctx: int,
               bits_weights: float = 4.5, hot_frac: float = 0.35) -> list[dict]:
    """Все feasible-раскладки с ожидаемым tok/s. hot_frac — доля активных байтов,
    которую удаётся держать в быстрой зоне при MoE offload."""
    wb = weights_bytes(m, bits_weights)
    kb = kv_total(m, ctx)
    ab = active_bytes(m, bits_weights)
    out = []

    # 1) всё в памяти устройства (вес+KV целиком)
    fits = wb + kb <= dev.total_bytes
    if fits:
        tok_s = dev.bw_bytes_s / (ab + m.kv_bytes_per_token)  # чтение активных весов + KV-хвост
        out.append(dict(scheme="all_local", fits=True,
                        tok_s_decode=tok_s, ttft_s=ttft_s(m, dev, ctx),
                        notes=f"веса+KV={ (wb+kb)/2**30:.1f} GiB"))

    # 2) MoE offload: cold-эксперты через медленный путь (только если не влезло целиком)
    if not fits or not dev.unified:
        # при offload кешем пользуется hot_frac активных байтов;
        # miss-часть едет по медленному каналу (PCIe для дискретной, тот же массив для unified)
        miss_bw = 25e9 if not dev.unified else dev.bw_bytes_s / 4  # конкуренция за контроллер
        tok_s = 1.0 / (hot_frac * ab / dev.bw_bytes_s
                       + (1 - hot_frac) * ab / miss_bw
                       + m.kv_bytes_per_token / dev.bw_bytes_s)
        out.append(dict(scheme="moe_offload", fits=True,
                        tok_s_decode=tok_s, ttft_s=ttft_s(m, dev, ctx),
                        notes=f"hot={hot_frac:.0%}, miss-BW={miss_bw/1e9:.0f} ГБ/с"))

    # 3) fallback: не влезает даже с offload — CPU-split (не рекомендуем, для полноты)
    if wb + kb > dev.total_bytes and dev.unified:
        pass  # на unified массив один: «не влезло» == нужны offload-схемы, не CPU-split
    return out


def best(dev: Device, m: ModelSpec17, ctx: int, bits_weights: float = 4.5) -> dict:
    cand = [p for p in placements(dev, m, ctx, bits_weights) if p["fits"]]
    return max(cand, key=lambda p: p["tok_s_decode"])


def run_placement():
    print("== 17.1: placement-калькулятор (W4 = 4.5 бита) ==")
    for dev in (M3_ULTRA, DGX_SPARK, RTX_4090):
        for m in (QWEN3_8B, MOE_35B):
            for ctx in (4096, 65536):
                b = best(dev, m, ctx)
                print(f"{dev.name:>20} | {m.name:<18} | ctx {ctx:>5} | "
                      f"{b['scheme']:<11} | {b['tok_s_decode']:7.1f} tok/s | "
                      f"TTFT {b['ttft_s']:6.2f} с | {b['notes']}")
    print("\nКонтроль: Qwen3-8B W4 на Spark ~ BW/байты = 273e9/4.61e9 ≈ 59 tok/s (теор.), "
          "реальность 60–80% => 35–47; наш замер MoE-35B — 40 tok/s.")


# ======================================================================
# Задание 17.2: MoE hot/cold expert offload
# ======================================================================

E, TOP_K, EXPERT_MB = 256, 8, 200
HIT_BW, MISS_BW = 1008e9, 25e9          # VRAM-чтение и транспорт miss'а
N_TOKENS = 100_000


def simulate_experts(strategy: str, cache_cap: int, router_aware: bool = False,
                     seed: int = 17):
    """Поток токенов: next-expert коррелирует с текущим (текстовая близость).
    Возвращает (hit_rate, wall_s)."""
    rng = np.random.default_rng(seed)
    cache: set = set()
    evict = deque()                        # для LRU
    freq = Counter()                       # для LFU
    hits = misses = 0
    miss_bytes = 0.0
    cur = int(rng.integers(E))
    for _ in range(N_TOKENS):
        # top-k: 5 экспертов «тянутся» к предыдущим, 3 случайные
        needed = set([cur] + [int(x) for x in rng.integers(0, E, 4)] +
                     [int(x) for x in rng.integers(0, E, TOP_K - 5)])
        in_cache = needed & cache
        hits += len(in_cache)
        misses += TOP_K - len(in_cache)
        miss_bytes += (TOP_K - len(in_cache)) * EXPERT_MB * 2**20
        # При C=0 горячего кеша нет: все эксперты остаются cold.
        if cache_cap == 0:
            cur = int(rng.choice(tuple(needed)))
            continue
        # вытеснение до capacity с учётом новых
        for ex in needed - cache:
            while len(cache) >= cache_cap:
                if strategy == "LRU":
                    victim = evict.popleft()
                elif strategy == "LFU":
                    victim = min(cache, key=lambda x: freq[x])
                else:  # router-aware: предпочитаем не предсказанных
                    pred = {cur} | {int(x) for x in rng.integers(0, E, 4)}
                    cold = cache - pred
                    victim = (min(cold, key=lambda x: freq[x]) if cold
                              else min(cache, key=lambda x: freq[x]))
                cache.discard(victim)
                if victim in evict:
                    evict.remove(victim)
            cache.add(ex)
            evict.append(ex)
            freq[ex] += 1
        freq.update(in_cache)
        cur = int(rng.choice(tuple(needed)))      # корреляция со следующим токеном
    hit_rate = hits / (N_TOKENS * TOP_K)
    # wall-clock: hot-чтение по HIT_BW, miss-транспорт по MISS_BW;
    # hot-часть всегда читает все TOP_K экспертов (это и есть "вычислитель читает веса")
    wall = (N_TOKENS * TOP_K * EXPERT_MB * 2**20) / HIT_BW + miss_bytes / MISS_BW
    return hit_rate, wall, N_TOKENS / wall


def run_moe():
    print("== 17.2: MoE offload, E=256, top_k=8, эксперт 200 МБ ==")
    print(f"baseline 'всё в RAM' (miss на всё): "
          f"{N_TOKENS / ((N_TOKENS * TOP_K * EXPERT_MB * 2**20) / MISS_BW):.1f} tok/s")
    print(f"upper bound 'всё в кеше'          : "
          f"{N_TOKENS / ((N_TOKENS * TOP_K * EXPERT_MB * 2**20) / HIT_BW):.1f} tok/s\n")
    for strategy in ("LRU", "LFU", "router-aware"):
        for cap in (0, 16, 32, 64, 128):
            hr, wall, tps = simulate_experts(strategy, cap)
            print(f"{strategy:<12} C={cap:>3} | hit {hr:5.1%} | {tps:7.1f} tok/s")
        print()


import numpy as np  # noqa: E402  (единственная внешняя зависимость)

if __name__ == "__main__":
    what = sys.argv[1] if len(sys.argv) > 1 else "all"
    if what in ("all", "place"):
        run_placement()
    if what in ("all", "moe"):
        run_moe()
Как проверить
cd modules && python module17.py
Чеклист:
- 17.1: Qwen3-8B W4 на Spark в схеме
all_localдаёт ≈ 273e9 / (8.19e9×0.5625 + 144×1024) ≈ 55–59 tok/s теоретических; MoE-35B на Spark —moe_offload, 40–70 tok/s в зависимости от hot_frac (замер 40 tok/s — реалистичный hot_frac ≈ 0.5 и эффективность ~80%). - 17.1: у RTX 4090 MoE-35B схема
all_localневыполнима (35e9×0.5625 = 19.7 ГБ > 24 ГБ минус KV) — должен выбиратьсяmoe_offloadс miss-BW 25 ГБ/с и низким tok/s. - 17.1: TTFT MoE-35B на Spark при ctx=65536 заметно меньше, чем на M3 Ultra (0.4 × 1e15 против 0.4 × 24e12) — единственное место, где «петафлопс» реален.
- 17.2: hit-rate растёт с C и выходит на плато к C=128; router-aware ≥ LRU при том же C.
- 17.2: baseline (C=0) ≈ 25 ГБ/с / 1.6 ГБ на токен ≈ 15.5 tok/s; upper bound ≈ 1008/1.6 ≈ 630 tok/s — разрыв ×40 показывает цену каждого процента hit-rate.
- Формула байт/токен сходится с модулем 00: Qwen3-8B KV fp16 = 144 КиБ/токен, W4-веса = 4.61 ГБ.
Сводка
- Железо для инференса делится не по вендорам, а по классу памяти: дискретная GPU (узкая VRAM + PCIe), когерентная unified (Apple M до 512 ГБ/~800 ГБ/с, DGX Spark и Strix Halo по 128 ГБ/~273 ГБ/с), CPU-сервер (много памяти, низкая ширина). Решает BW и ёмкость, не FLOPs.
- DGX Spark с 1 PFLOP FP4 даёт MoE-35B ~40 tok/s при батче 1, потому что декодинг memory-bound: 273 ГБ/с — потолок, петафлопсы простаивают. Рецепт NVFP4+DFlash2 на SGLang (~72 tok/s) работает, потому что снижает байты на токен.
- На unified-классе правильный placement — почти все слои «на GPU»: шина общая, CPU-GEMV не экономит ни байта. Ловушка консервативного offload (GPU-доля UMA по умолчанию мала) — самая частая причина «медленного Strix Halo»; главный рецепт — отдать память под GPU.
- KTransformers-дисциплина для MoE-гигантов: attention и router на GPU, routed-эксперты в RAM в RAWINT4/MXFP4, hot-кеш в быстрой зоне; hit-rate кеша экспертов решает wall-clock (задание 17.2: от ×1 при C=0 до ×40 upper bound).
- Гибридные ноды (unified + дискретный GPU) разделяют работу по физике: префилл и большая модель на unified, draft/fast-head на VRAM-GPU; транспорт — KV-хэндофф по модулю 13, окупаемость решает отношение полосы канала к скорости префилла получателя.
- NPU в SoC (XDNA2, ~50 TOPS) для LLM-инференса пока маркетинг: память та же, стека уровня llama.cpp/vLLM нет — выбирать бокс по BW и драйверам GPU.
- ConnectX-7 на Spark (до 4 узлов) замыкает класс на кластеры: 512 ГБ суммарно за ~16k USD, транспорт — RDMA-хэндофф из модуля 13.
Навигация по курсу: Хаб курса · Предыдущий: Как не обмануться числом: методология замера