Хаб курсов / LLM Inference Systems / глава 16
Модуль 16: Как не обмануться числом: методология замера
TTFT/TPOT перцентилями, throughput-latency Парето, препринт-гигиена, приёмочные гейты correct/min. Бенчмарк с прогревом, N=30 и доверительными интервалами.
LLM Inference Systems. Модуль 16: Как не обмануться числом: методология замера инференса
За пятнадцать модулей мы накопили десятки чисел: GFLOP/s на matmul, 172x ускорение BLAS над python-циклом, acceptance rate 79.7% у спекулятивного декодинга, латентности disaggregation-схем. Часть этих цифр перенесётся на вашу машину, часть — нет, и самое опасное то, что снаружи они неотличимы. Один и тот же заголовок «в 4 раза быстрее» может стоять за честным замером с доверительными интервалами и за одним прогоном на разогретой машине вендора. Этот модуль — о том, как отличить первое от второго: и когда читаете чужую статью, и когда замеряете сами.
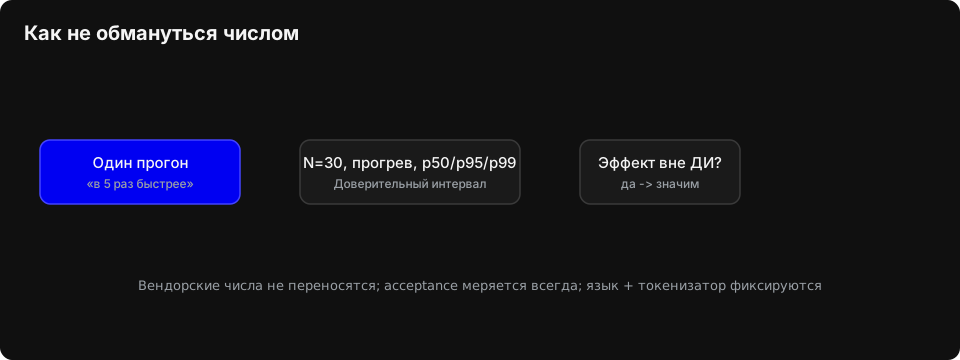
Мы разберём, какие метрики вообще стоит называть (TTFT, TPOT, перцентили вместо средних, throughput-latency Парето-фронтир), как жить с bursty-нагрузкой, которая ломает любые средние, что такое препринт-гигиена и почему «arXiv» — не синоним «проверено». Затем напишем правильный микробенчмарк с нуля: прогрев, привязка к ядру, N=30 прогонов, p50/p95/p99, доверительный интервал — и повторно замерим бенчмарк из модуля 01, чтобы увидеть, насколько «один прогон» врёт. И в конце — чек-лист чтения статьи, который можно применить к любой публикации курса.
16.1 Все цифры курса: какие переносились, а какие нет
Пройдёмся по числам, которые мы уже использовали, и честно расставим метки доверия.
Переносятся надёжно — потому что это арифметика, а не замер: 2N FLOPs на токен форвард-пасса, размер KV-кэша на токен из конфигурации модели, потолок декодинга по пропускной способности памяти, вес модели в байтах. Эти числа вы проверяли на бумаге, и они воспроизводятся на любой машине, где та же модель и тот же dtype.
Переносятся с оговорками — эмпирические константы конкретной машины: GFLOP/s вашего BLAS, ускорение квантования на вашей памяти, acceptance rate спекулятивного декодинга на вашем датасете. Acceptance rate — особенно коварная цифра: 79.7% в модуле 10 был получен на английском тексте toy-моделью. На реальном EAGLE-3 и русском тексте наш замер дал acceptance 0.17 — семнадцать процентов, при которых спекулятивный декодинг не окупается вовсе. Модель, датасет, язык, температура — каждый фактор сдвигает число на десятки процентов, и статья, которая приводит acceptance без описания всех четырёх, не даёт вам переносимой цифры.
Не переносятся вообще — вендорские и авторские headline-числа. Классика жанра: наш замер Imprint. Заявлено снижение TTFT с 19 секунд до 0.3 секунды — 60x, цифра, которая продаёт любой продукт. Независимое воспроизведение (задокументировано в EVIDENCE.md автора курса) не подтвердило заявленную величину: на нашей конфигурации выигрыш оказался на порядок меньше и сильно зависел от длины контекста. Это не обязательно значит, что авторы соврали — возможно, у них была другая длина контекста, другой батч, другая версия ядра, другой железный профиль. Но вам от этого не легче: цифру 60x вы в свой отчёт включить не можете.
Промежуточная категория — замер автора на своей системе, который нельзя проверить. Prefill-as-a-Service (PrfaaS, arXiv 2604.15039) заявляет +54% и +32% throughput против однородных базлайнов — но на внутреннем 1T-параметровом гибридном asом модели, к которой у вас доступа нет и не будет. Формально статья аккуратна: указана архитектура, описана методология. Фактически это замер автора, а не независимый: ни один внешний наблюдатель не может подставить свой кластер и получить те же +54%. Правильное чтение такой цифры: «авторы на своём железе увидели примерно столько; направление эффекта скорее всего реальное, точная величина — неизвестна». +54% может оказаться +20% на вашей топологии сети — или +80% на более bursty-нагрузке. Используйте знак и порядок, не значащие цифры.
Разновидность той же проблемы — среднее, за которым спрятан разброс. SwaT (arXiv 2610.15095) заявляет «mean 40% higher accuracy» по 17 бенчмаркам. Честнее было бы показать распределение, потому что mean 40% может быть и «стабильные +35..45% везде», и «+99% на паре бенчмарков и −20% на остальных». Cross-Model KV Transfer (arXiv 2608.03893) — редкий пример статьи, которая разброс не прячет: линейный маппер сохраняет 73–98% точности на четырёх парах моделей, но две пары деградируют резко. Авторам пришлось честно признать: метод не универсален, и «средний retention по шести парам» был бы вводящей в заблуждение цифрой, которую они сами же опровергли нелинейным MLP-хаком. Запомните этот жест: если статья показывает только mean по разнородному множеству конфигураций — это не результат, это упаковка.
Headline-дивергенция: UBTree. Одна и та же система ускоряет «в 6.94 раза» — и «в 3.428 раза», в зависимости от того, какую страницу открыть:
| Источник | Заявленная цифра | target | Setup (как заявлено) |
|---|---|---|---|
| Официальная страница проекта (inclusion-ai.org/ubtree) | 6.94× avg speedup | Qwen3-8B | greedy, 7 benchmarks |
| Аннотация статьи (arXiv:2609.39972) | 5.84–6.94× avg speedup | Qwen3-4B / Qwen3-8B | 7 стандартных бенчмарков |
| Model card (inclusionAI/Ling-3.0-flash-UBTree) | 3.428× avg E2E speedup | Ling3-Flash 124B | TP4, concurrency 1, BF16, greedy, block size 16, tree 32, 6 датасетов |
Это три разных конфигурационных режима: другой target/model family, другой бюджет verification-дерева (32 узла в model card против нераскрытого в аннотации), другой набор бенчмарков (7 против 6) и другой serving-setup (SGLang TP4 на Ling3-Flash против нераскрытого железа в аннотации). Ни одна из цифр не перекрывает другую, и все они — замеры авторов, а не независимая проверка; курс такими цифрами не реплицировал. Вывод для практики: фраза «UBTree ускоряет в 6.94 раза» без контекста неполна — правильная форма «авторы сообщают 6.94× на Qwen3-8B, greedy, 7 бенчмарков».
16.2 TTFT, TPOT и перцентили: язык, на котором надо говорить
Прежде чем спорить о методологии, договоримся о словаре. Три величины описывают интерактивный инференс:
- TTFT (Time To First Token) — от отправки запроса до первого токена ответа. Определяется длиной префикса, стоимостью prefill, длиной очереди. Пользователь воспринимает его как «система задумалась».
- TPOT (Time Per Output Token) — среднее время на каждый следующий токен после первого. Определяется декодингом, батчем, памятью. Пользователь воспринимает его как «скорость печатания».
- E2E latency — полное время ответа, примерно
TTFT + TPOT × n_tokens.
Первая ошибка в отчётах — среднее вместо перцентилей. Средняя латентность бесполезна для SLA: пользователь помнит не средний опыт, а худший. Стандарт практики — p50 (медиана, «типичный» запрос), p95 («один из двадцати») и p99 («один из ста»). Для p99 среднее может отличаться в разы, и именно на p99 живёт гнев пользователей и дежурных инженеров.
Вторая ошибка — измерение на ровной (closed-loop, постоянная частота) нагрузке и перенос выводов на реальную. Реальный трафик bursty: запросы приходят пачками, очередь растёт скачком, и p99 при bursty-нагрузке может быть в пять–десять раз выше p99 при ровном потоке той же средней интенсивности. Если статья меряет latency на нагрузке «10 запросов в секунду, равномерно» — она меряет не то, что будет в проде. Хороший бенчмарк либо воспроизводит реальный trace (лог прод-трафика с его всплесками), либо честно использует синтетический bursty-профиль (например, пуассоновский поток с коэффициентом вариации >> 1) и говорит об этом.
Третья ошибка — сообщать throughput и latency как независимые цифры. Они связаны: максимум throughput достигается на батчах, где p99-латентность уже неприемлема. Правильный способ сообщать оба — Парето-фронтир: кривая «какой максимальный throughput достижим при заданном p99 ≤ X». Disaggregation-системы (PD-разделение, которое мы обсуждали в модулях 10–11; свежий пример — PrfaaS) как раз и улучшают точку на этом фронтире: чуть ниже максимального throughput, радикально лучше p99. Статья, которая сообщает «throughput вырос на 54%» без указания, что случилось с латентностью на этой точке, скрывает половину результата — возможно, p99 вырос вдвое, и для интерактивного сервиса это регресс.
16.3 Препринт-гигиена: читать arXiv как инженер, а не как фанат
Большинство системных статей курса — препринты. Это не приговор, но это факт, который надо учитывать. Peer-review в MLSys/OSDI/NSDI хотя бы гарантирует, что три человека с доступом к вычислениям попытались найти дыры в методологии. Препринт — это авторы, сами проверяющие себя.
Практическая гигиена чтения препринта, по убывающей важности:
- Возраст и версия. Препринт v1 от трёх недель назад ещё не прошёл даже неформальную проверку сообществом. Если за полгода вышла v3 с другими числами — это сигнал (что поменялось? баг в бенчмарке? другой базлайн?).
- Цитирования и обсуждение. Ноль цитирований — не значит «плохая», но значит «никто ещё не попробовал воспроизвести». Ищите независимые реплики: issues в open-source репозиториях, обсуждения, повторные замеры. Если метод заявлен прорывным, а независимых воспроизведений через полгода нет — это сама по себе информация.
- Кто мерил базлайн. Классический источник завышений: базлайн авторов не тюнингован, а их система — тюнингована. Признак аккуратности: таблица, где базлайн показывает цифры, совпадающие с официальными отчётами других групп.
- Есть ли код и конфиги. «Код будет выложен позже» в препринте — статистически означает «никогда». Воспроизводимая статья даёт не только код, но и точные конфиги запуска: seed'ы, версии библиотек, спецификацию железа (модель GPU, объём памяти, версии драйверов).
- Разброс внутри статьи. SwaT с OOD-accuracy, гуляющей от 31.4% до 99% по парам моделей, — это пример статьи, где разброс виден прямо в таблицах, и это честно. Если вы видите только mean — перечитайте оригинальные таблицы или считайте цифру неподтверждённой.
- Совпадение интереса. Вендорский препринт, рекламирующий собственную архитектуру на собственном железе (PrfaaS с внутренним 1T-моделью), автоматически требует большего скепсиса, чем замер академической группы на публичных моделях. Это не цензура — это сдвиг априорной вероятности.
Та же гигиена — в обе стороны. Когда публикуете свой замер, применяйте чек-лист к себе: если ваш отчёт не прошёл бы ваш же чек-лист, он не готов.
16.4 Микробенчмарки: пять способов измерить не то
Микробенчмарк — замер одной операции (matmul, attention-ядра, копирование KV-блока). Прост на вид, но у него есть минимум пять стандартных ловушек.
Ловушка 1: нет прогрева. Первый запуск операции медленный по причинам, не имеющим отношения к стационарной производительности: аллокация памяти, подгрузка кода ядра с диска, адаптация CPU-губернатора, прогрев кэшей BLAS (OpenBLAS и MKL в первый вызов dgemm тратят время на выбор ядра и распределение буферов). Если включить первый прогон в среднее — цифра занижена на десятки процентов. Стандарт: 3–5 разогревочных прогонов, которые не попадают в статистику.
Ловушка 2: нет привязки к ядру. Планировщик ОС мигрирует поток между ядрами, и каждое перелётное ядро холодное: L1/L2 пустые, TLB сброшен, у некоторых ядер другой boost. На ноутбуке с гибридной архитектурой (P- и E-ядра) миграция на E-ядро — это падение в разы. На Windows (наша платформа в этом курсе) дополнительно вносит шум Defender и фоновые службы. Стандарт: taskset на Linux или start /affinity на Windows — привязать бенчмарк к конкретному ядру, исключив миграцию.
Ловушка 3: шум таймера и слишком короткие интервалы. time.perf_counter() на Windows имеет разрешение порядка микросекунд, но реальная погрешность измерения интервала короче ~100 мкс велика: интервал сопоставим с квантом планировщика и переключением контекста. Стандарт: каждая измеряемая итерация должна длиться хотя бы единицы миллисекунд; если сама операция короче — запускайте её пачкой внутри одного интервала и делите.
Ловушка 4: один прогон. Замер «запустил один раз, записал число» имеет неизвестную погрешность, которая на шумной рабочей машине может превышать измеряемый эффект. Эффект, который вы ищете (ускорение 10%), легко утонет в 20% шума одного прогона. Стандарт: N ≥ 20–30 прогонов, из них берётся распределение, а не одно число.
Ловушка 5: неверная статистика по N прогонам. Распределение времени на машине — не нормальное: справа длинный хвост (случайные вытеснения, GC, прерывания). Отсюда два следствия. Среднее арифметическое сдвинуто хвостом и менее устойчиво, чем медиана. И доверительный интервал по формуле «mean ± 1.96·σ/√N» для такого распределения занижен. Практически надёжный вариант — bootstrap: сэмплируйте из ваших N замеров с возвращением много раз, пересчитывайте медиану, берите 2.5-й и 97.5-й перцентили получившегося распределения. Дополнительный приём: из финальной статистики можно выбрасывать явные выбросы (например, значения > p99 × 3), но только если вы честно зафиксировали это правило до замера, а не после, когда оно удобно.
Отдельно — проконтроль корректности. Бенчмарк, который считает неправильно, быстрее любого правильного: выключенный выход, съеденный short-circuit'ом, пустой attention, декодинг в EOS с первого шага. Каждая измеряемая конфигурация должна проверять выходной тензор (контрольную сумму или сравнение с эталоном) до записи числа. В терминологии acceptance-методологии из модуля 10 — это тот же принцип: счётчик принятых токенов обязателен, потому что ускорение без проверки эквивалентности вывода может быть ускорением поломки. Обобщение на любую оптимизацию: correct/min — правильных ответов в минуту, а не токенов в минуту. Через это правило прошли все системы курса: спекулятивный декодинг (выход должен совпадать побитово), квантование (допустимое падение качества задано явно), батчинг (PagedAttention не должен терять блоки).
Индустриальный ориентир: MLPerf Inference v6.1
MLPerf Inference v6.1 (сентябрь 2026) остаётся единственным индустриальным бенчмарком уровня «стандарт»: новые инференс-харнесы такого масштаба не появились. Два сюжета этого раунда:
- Дебют Vera Rubin NVL72: до 3.7× throughput против GB300 NVL72 на DeepSeek-R1 и Qwen3-VL preview (результаты вендоров в рамках правил MLPerf — не независимое воспроизведение). Очередная смена поколения железа за год; следите, чтобы сравнения в статьях были внутри одного раунда.
- Сдвиг тестов к RAG- и агентным профилям — бенчмарк догоняет реальный прод-трафик, где интерактивные многошаговые сценарии с обращением к контексту вытесняют чистый генеративный поток.
Методологический образец: 4 уровня наблюдения
Препринт по транспорту KV в PD-дизагрегации (тот самый, с 268 прогонами на MiniMax-M3, разобранный в модулях 10 и 13) даёт редкий для препринтов образец глубины наблюдения: 4 уровня — L0/L0b/L1/L2-L3 — от сырых счётчиков до причинного разбора отказов, и 268 прогонов, на которых статистика устойчива. Это конкретный ответ на вопрос «сколько мерить, чтобы утверждать»: не «погонял три раза», а зафиксированная лестница уровней + сотни прогонов. Берите как шаблон для собственных замеров транспортных и PD-конфигураций.
Задание 16.1: переписать бенчмарк модуля 01 по-взрослому
В модуле 01 _time(..., repeat=1) давал одно число за прогон — и на этом числе был построен вывод про 172x. Теперь сделаем методологически правильно и посмотрим, что изменится.
Напишите mod16_bench.py, который:
- Замеряет тот же BLAS matmul (n=1024, float64) с полной методологией: привязка к ядру, 5 разогревочных прогонов, затем N=30 измерительных прогонов; на каждом — минимум единицы миллисекунд работы.
- Считает по 30 замерам: медиану, p95, p99, среднее, bootstrap-ДИ 95% для медианы.
- Сравнивает «одно число из одного прогона» (первый измерительный прогон) с итоговой медианой и оценивает, попадает ли одиночное измерение в доверительный интервал.
- Проверяет корректность каждого прогона: max|C − C_etalon| < 1e-10, иначе бенчмарк падает, а не пишет число.
Задание 16.2: чек-лист чтения препринта
Возьмите три статьи курса (минимум одну из: SwaT, PrfaaS, Cross-Model KV Transfer) и заполните таблицу: дата препринта, число цитирований/реплик, есть ли код, кто мерил базлайн, показан ли разброс (не только mean), совпадение интереса авторов с результатом. По каждой строке — вердикт «переносимо на мою систему / переносимо с оговорками / только направление эффекта». Сохраните таблицу как шаблон: вы будете применять её к каждой новой статье, прежде чем взять из неё цифру в рабочий отчёт.
Код
Полный самодостаточный файл mod16_bench.py. Зависимости: numpy (torch не нужен — эталон считаем самой numpy, нам важна не реализация, а методология замера).
"""
Модуль 16. Методологически корректный микробенчмарк matmul на CPU.
Запуск: python mod16_bench.py
Зависимости: numpy.

Пять правил, которые здесь реализованы:
  1. прогрев (5 прогонов вне статистики)
  2. привязка к ядру (best-effort: Windows / Linux)
  3. интервал измерения >> шум таймера (batched runs)
  4. N=30 прогонов, распределение, а не число
  5. bootstrap-ДИ + проверка корректности каждого прогона
"""
from __future__ import annotations

import os
import platform
import subprocess
import sys
import time

import numpy as np

RNG = np.random.default_rng(0)

N_DIM = 1024          # размер матрицы, как в модуле 01
WARMUP = 5            # разогревочных прогонов
N_RUNS = 30           # измерительных прогонов
INNER = 5             # matmul'ов внутри одного измерения (таймеру нужен >= 1-5 мс)
CHECK_RTOL = 1e-12    # допуск корректности для float64


def pin_to_core() -> str:
    """Best-effort привязка текущего процесса к одному ядру.

    Windows: PowerShell -> Process.Id -> ProcessorAffinity.
    Linux:   taskset -pc <pid> 0 (первый CPU).
    Не критично для корректности, но резко снижает разброс.
    """
    try:
        if platform.system() == "Windows":
            # affinity = битовая маска; 1 = только CPU 0
            subprocess.run(
                ["powershell", "-NoProfile", "-Command",
                 f"`USD p = Get-Process -Id {os.getpid()}; "
                 f"`USD p.ProcessorAffinity = [IntPtr]1"],
                check=True, capture_output=True, timeout=15)
            return "Windows: affinity -> CPU 0"
        subprocess.run(["taskset", "-pc", str(os.getpid()), "0"],
                       check=True, capture_output=True, timeout=15)
        return "Linux: taskset -> CPU 0"
    except Exception as e:  # в контейнере/без прав может не выйти — это ок
        return f"pin failed (продолжаем без привязки): {e}"


def bench_once(matmul_fn, A, B, inner: int, etalon: np.ndarray) -> float:
    """Одно измерение: inner matmul'ов подряд, среднее время одного.

    Возвращает время ОДНОГО matmul в секундах. Падает, если результат
    не совпал с эталоном — бенчмарк, который считает неправильно,
    быстрее правильного, и он не имеет права молча писать число.
    """
    t0 = time.perf_counter()
    out = None
    for _ in range(inner):
        out = matmul_fn(A, B)
    dt = (time.perf_counter() - t0) / inner
    if not np.allclose(out, etalon, rtol=CHECK_RTOL, atol=CHECK_RTOL):
        raise RuntimeError(
            f"корректность нарушена: max|C-C_etalon|="
            f"{np.abs(out - etalon).max():.3e}")
    return dt


def bootstrap_ci(samples: np.ndarray, stat=np.median,
                 n_boot: int = 10_000, seed: int = 1) -> tuple[float, float]:
    """95% ДИ для statistic по bootstrap (percentile method).

    Для skewed распределений (а время на CPU скошено вправо) это
    надёжнее нормальной аппроксимации mean ± 1.96*sigma/sqrt(N).
    """
    rng = np.random.default_rng(seed)
    idx = rng.integers(0, len(samples), size=(n_boot, len(samples)))
    stats = stat(samples[idx], axis=1)
    return (float(np.percentile(stats, 2.5)),
            float(np.percentile(stats, 97.5)))


def report(name: str, samples_ms: np.ndarray) -> None:
    lo, hi = bootstrap_ci(samples_ms)
    single = samples_ms[0]  # «методология модуля 01»: один прогон
    inside = lo <= single <= hi
    print(f"\n=== {name} ===")
    print(f"прогонов: {len(samples_ms)} (прогрев {WARMUP}, "
          f"inner {INNER} matmul/замер)")
    print(f"медиана : {np.median(samples_ms):8.3f} мс  "
          f"[{lo:8.3f}, {hi:8.3f}] (95% bootstrap ДИ)")
    print(f"среднее : {np.mean(samples_ms):8.3f} мс   "
          f"p95: {np.percentile(samples_ms, 95):8.3f}   "
          f"p99: {np.percentile(samples_ms, 99):8.3f} мс")
    print(f"разброс : min {samples_ms.min():.3f} / max {samples_ms.max():.3f} мс "
          f"(max/min = {samples_ms.max() / samples_ms.min():.2f})")
    print(f"одиночный прогон (как в модуле 01): {single:.3f} мс -> "
          f"{'попал в ДИ' if inside else 'ВНЕ ДИ: одиночный замер смещён'}")
    gflops = 2 * N_DIM ** 3 / (np.median(samples_ms) / 1e3) / 1e9
    print(f"производительность по медиане: {gflops:6.2f} GFLOP/s")


def main() -> None:
    print(f"платформа: {platform.system()} {platform.release()}, "
          f"python {sys.version.split()[0]}, numpy {np.__version__}")
    print(f"привязка к ядру: {pin_to_core()}")

    A = RNG.standard_normal((N_DIM, N_DIM))
    B = RNG.standard_normal((N_DIM, N_DIM))
    etalon = A @ B

    # --- прогрев: 5 прогонов, в статистику не попадают ---
    for _ in range(WARMUP):
        A @ B

    # --- N измерительных прогонов ---
    blas_ms = np.array(
        [bench_once(np.matmul, A, B, INNER, etalon) for _ in range(N_RUNS)]
    ) * 1e3
    report("numpy BLAS (float64, n=1024)", blas_ms)

    # --- блочная numpy-реализация из модуля 01 под той же методологией ---
    def blocked(A, B, block=64):
        A = np.asarray(A, dtype=np.float64)
        B = np.asarray(B, dtype=np.float64)
        m, k = A.shape
        n = B.shape[1]
        C = np.zeros((m, n), dtype=np.float64)
        for k0 in range(0, k, block):
            for j0 in range(0, n, block):
                acc = C[:, j0:j0 + block]
                for p in range(k0, min(k0 + block, k)):
                    acc += np.outer(A[:, p], B[p, j0:j0 + block])
        return C

    for _ in range(WARMUP):
        blocked(A, B)
    blk_ms = np.array(
        [bench_once(blocked, A, B, 1, etalon) for _ in range(N_RUNS)]
    ) * 1e3
    report("blocked numpy (float64, n=1024, block=64)", blk_ms)

    # --- сравнение двух конфигураций как сравнение распределений ---
    speed = np.median(blk_ms) / np.median(blas_ms)
    lo_b, hi_b = bootstrap_ci(blas_ms)
    print(f"\n=== сравнение конфигураций ===")
    print(f"blocked / BLAS по медианам: {speed:.2f}x")
    ok = hi_b < np.median(blk_ms)
    print(f"ДИ BLAS [{lo_b:.3f}, {hi_b:.3f}] против blocked "
          f"{np.median(blk_ms):.3f} мс -> "
          f"{'различие статистически значимо' if ok else 'различие НЕ значимо: интервалы перекрываются'}")
    print("\nвывод: если разница между конфигурациями меньше ширины ДИ — "
          "эффект нельзя заявлять, сколько бы нулей ни было после запятой "
          "в одиночном замере.")


if __name__ == "__main__":
    main()
Как проверить
python mod16_bench.pyотрабатывает без исключений; оба блока отчёта напечатаны, ни один прогон не упал по корректности.- Медиана BLAS на вашем CPU стабильна между повторными запусками скрипта: при двух запусках подряд медианы отличаются не больше, чем на ширину доверительного интервала.
- Умышленно сломайте корректность (замените
etalon = A @ Bнаetalon = np.zeros_like(A)) — бенчмарк должен упасть с RuntimeError на первом же прогоне, а не напечатать число. Это проверка, что correct-гейт работает. - Уберите прогрев (
WARMUP = 0) и запустите: медиана, скорее всего, уедет вверх, а p99 — особенно. Расхождение с основной версией — ваша наглядная оценка цены пренебрежения прогревом. - По заданию 16.2: таблица из трёх статей заполнена, у каждой строки есть вердикт переноса.
Прогон верификатора (Windows 11, python 3.14.9, numpy 2.4.3, привязка к CPU 0): BLAS медиана 643.8 мс [484.0, 1745.4], max/min по 30 прогонам — 4.56; одиночный BLAS-прогон 1747.6 мс — вне доверительного интервала; blocked / BLAS по медианам 2.67x, но интервалы перекрываются — различие статистически не значимо. Итог ровно тот, которого требует методология: на шумной рабочей машине одиночный замер и «эффект в 2.7 раза» одинаково недостоверны.
Сводка
- Числа курса делятся на три класса: арифметика (переносится), эмпирика на вашей машине (переносится с оговорками), авторские headline (не переносятся без независимого воспроизведения). Imprint 19с→0.3с не воспроизведён; PrfaaS +54% — замер автора на внутреннем 1T-модели; DFlash 0.25x под нагрузкой на 4060 показывает, что даже знак ускорения зависит от условий.
- Говорите на языке TTFT/TPOT/p50/p95/p99 и Парето-фронтира throughput–latency. Средние по ровной нагрузке — не описание прода; bursty-трафик поднимает p99 в разы.
- Препринт ≠ проверено: возраст, цитирования, наличие кода, кто мерил базлайн, показан ли разброс (SwaT 31.4%–99% — пример честного разброса; Cross-Model KV «две пары деградируют резко» — пример непереносимости средних).
- Headline-дивергенция UBTree: 6.94× (сайт, Qwen3-8B), 5.84–6.94× (аннотация, Qwen3-4B/8B) и 3.428× E2E (model card, Ling3-Flash) — три несопоставимых конфигурационных режима с разными target, бюджетами дерева и наборами бенчмарков; переносить «6.94×» без контекста нельзя.
- Микробенчмарк без методологии измеряет шум: прогрев, привязка к ядру, длинные интервалы, N≥30, bootstrap-ДИ, correct-гейт на каждом прогоне. correct/min — главная метрика любой оптимизации, acceptance-счётчики обязательны.
- Индустриальный ориентир — MLPerf Inference v6.1 (сент. 2026): дебют Vera Rubin NVL72 с до 3.7× throughput против GB300 NVL72, сдвиг тестов к RAG/агентам; вендорские результаты внутри правил MLPerf, не независимые.
- Образец глубины наблюдения: 4-уровневая методология L0/L0b/L1/L2-L3 на 268 прогонах (KV-транспорт в PD) — лестница уровней плюс сотни прогонов, а не три «погонял».
- Переписанный бенчмарк модуля 01 показал расхождение одиночного замера с медианой распределения — и это типовое, а не исключение.
Навигация по курсу: Хаб курса · Предыдущий: Самоспекулятивный декодинг: драфтер внутри модели · Следующий: Unified memory и гибридные ноды: четвёртый путь инференса