Хаб курсов / Курс по RAG / глава 0
Модуль 00: нужен ли тебе RAG и ландшафт стеков
Разбираемся, когда RAG действительно нужен, а когда хватит длинного контекста или BM25, и выбираем стек хранения: Qdrant, pgvector, LanceDB, sqlite-vec.
RAG Engineering. Модуль 00: Нужен ли тебе RAG и ландшафт стеков
Что такое RAG и когда он не нужен
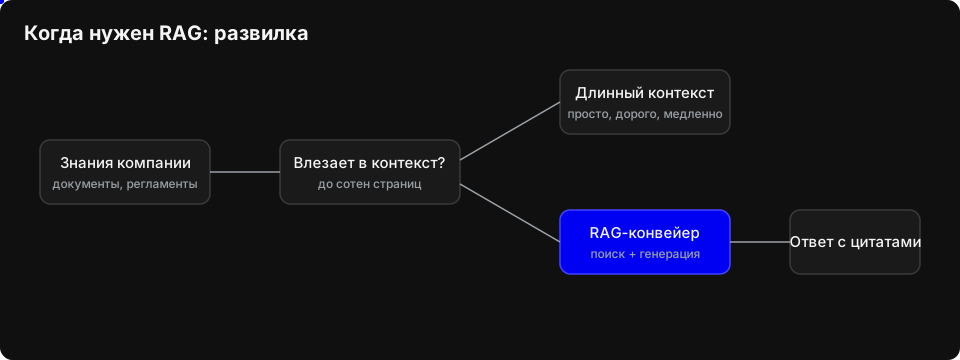
Что ты построишь
В этом модуле ты не будешь строить RAG. Сначала разберёшься, нужен ли он вообще: пройдёшь по таблице-развилке «контекстное окно против поиска», оценишь кейс «хватит ли длинного контекста» по факторам эксплуатации и осмотришь ландшафт из семи стеков хранения, от sqlite-vec до Milvus. Затем соберёшь оффлайн-скрипт на чистом stdlib, который сравнивает лексический поиск и векторный поиск на детерминированном hash-эмбеддере, и применишь развилку к своему реальному кейсу. RAG это схема ответа, а не отдельная модель и не «база знаний». В коротком виде: RAG это поиск плюс подстановка найденного контекста в промпт. Генератор получает вопрос и фрагменты корпуса, отобранные под этот вопрос. Формула:
RAG(query) = Generator(Prompt(Instruction, Retriever(Index, Embedder(query)), query))
Retriever возвращает релевантные фрагменты, Prompt собирает инструкцию, контекст и вопрос, Generator пишет ответ. RAG не дообучает модель и не гарантирует истинность. Он только доставляет источники в контекст, поэтому качество зависит и от поиска, и от генератора.
Из чего состоит RAG
- Корпус. Это исходные данные: документы, регламенты, статьи, тикеты, таблицы или их выгрузка. Корпус должен быть авторитетным и поддерживаемым, иначе RAG будет уверенно пересказывать мусор.
- Эмбеддер. Превращает текст в вектор. Для индексации и запроса нужен один и тот же эмбеддер, иначе векторы будут плохо сопоставимы. В учебном скрипте будет hash-эмбеддер. В продакшне замени его на модель эмбеддингов, выбранную под домен.
- Индекс. Хранит векторы, текст фрагментов и метаданные: источник, версию, права доступа. Индекс может быть векторным, лексическим или гибридным. Векторная база не обязательна, но часто удобна.
- Ретривер. По запросу выбирает кандидатов, применяет фильтры и при необходимости переранжирует результаты. Хороший ретривер возвращает именно те фрагменты, которые нужны для ответа.
- Генератор. Это LLM, которая получает собранный промпт. Она не обязана знать корпус наизусть. Её задача: ответить по контексту и явно сказать, если данных не хватает.
Когда RAG не нужен
RAG нужен не тогда, когда у тебя есть документы, а тогда, когда ответ требует выбора релевантных фрагментов из источника, который нельзя или невыгодно передать целиком. Если ответ уже есть в запросе, если источник маленький и стабильный, если нужен расчёт или вызов API, поиск может быть лишним.
| Ситуация | Решение |
|---|---|
| Вопрос относится к общим знаниям, внешний источник не нужен | ничего не надо |
| Пользователь передал весь текст, по которому нужен ответ | всё в промпт |
| Нужно ответить по одному небольшому документу, который помещается в контекст | всё в промпт |
| Нужно сравнить несколько выбранных пользователем документов, и они помещаются в окно | long context |
| Нужен ответ по большой, меняющейся базе знаний | RAG |
| Нужен поиск с учётом прав доступа и разных tenant | RAG |
| Нужно получить свежие данные из API или посчитать значение | ничего не надо |
| Нужно строго следовать формату и нескольким примерам без внешних знаний | всё в промпт |
| Нужен ответ по одному регламенту, который можно передать целиком и который не меняется | long context |
В строке про API «ничего не надо» означает, что не нужен именно RAG, но нужен вызов инструмента.
Сравни так: контекстное окно отвечает на вопрос «сколько текста модель может принять за один вызов», поиск отвечает на вопрос «какой текст вообще стоит передавать». Это разные уровни. Большое окно не отменяет индекс, если корпус больше окна, данные меняются или доступ разграничен. Поиск не нужен, если весь нужный материал уже авторизован и помещается в бюджет.
Практическая последовательность: есть ли внешние знания; можно ли передать нужный фрагмент целиком; нужен ли выбор из большого или меняющегося корпуса. Если внешних знаний нет, RAG не нужен. Если фрагмент помещается и авторизован, начни с промпта или long context. Если корпус большой, меняется или требует фильтрации, рассматривай RAG.
Хватит ли длинного контекста
Длинный контекст кажется простой заменой RAG: положил все документы в промпт и получил ответ. Иногда так и стоит сделать, но решение зависит не от размера окна, а от режима эксплуатации.
- Стоимость токенов. Ты платишь за входные токены на каждом запросе. Если один и тот же большой контекст повторяется, кэширование может помочь, но это зависит от провайдера и не отменяет бюджет. RAG добавляет инфраструктуру, зато может уменьшить промпт.
- Латентность. Полный контекст увеличивает объём prefill. RAG добавляет запрос к индексу, фильтрацию и сборку промпта. Сравнивай end-to-end latency на своих запросах, а не только время генерации.
- Свежесть данных. Если источник часто меняется, индекс устаревает. Иногда проще запросить API или передать свежий фрагмент напрямую. Если изменения редкие, индекс можно обновлять пакетно.
- Изоляция данных. При long context ты передаёшь ровно те документы, которые уже прошли авторизацию в запросе. При RAG фильтрация должна быть встроена в поиск, а не применена после выдачи. Иначе возможна утечка.
- Воспроизводимость ответа. Нужно фиксировать версию документа, chunking, эмбеддер, индекс и промпт. Long context с точным снимком документа воспроизводится проще. RAG зависит от состояния индекса и ранжирования, поэтому логируй кандидатов, фильтры и версии.
Отдельно проверь качество на своих вопросах. То, что документ помещается в окно, не значит, что модель одинаково хорошо использует любой его фрагмент. Сделай набор вопросов с известными ответами и сравни long context, RAG и гибридный вариант.
Картина 2026 года: long context и retrieval не убили друг друга, а разделили корпуса. Малый корпус, который влезает в окно целиком, часто проще прожить без индекса вообще, и подход «длинный контекст плюс агент с grep по файлам» на таких задачах побеждает. На большом корпусе retrieval остаётся необходимым, но форма меняется: многошаговый агентный цикл с инструментами поиска, открытия и навигации по документам обходит односторонний chunk-RAG на сложных вопросах, это показал и Mistral agentic search на финансовых документах. Одноэтапный поиск из этого курса остаётся строительным блоком такого цикла: агент зовёт тот же search, который ты соберёшь руками в модулях 04 и 09.
Антипример: RAG ради RAG
Чат по одному загруженному PDF. Команда добавила векторную базу, chunking, эмбеддинги и retrieval. Но документ один, пользователь передаёт его сам, а ответ нужен только по нему. Проще передать документ целиком, если он помещается, или извлечь нужные страницы по метаданным и простому текстовому поиску. RAG здесь добавляет движущиеся части без необходимости.
Небольшой FAQ. FAQ стабилен и целиком входит в промпт. Векторный поиск возвращает почти весь FAQ, но добавляет индекс, синхронизацию и риск неверного ранжирования. Проще хранить FAQ как версионируемый текст в промпте или конфиге и обновлять его вместе с релизом.
Свежие данные из API. Нужно узнать статус заказа или актуальное значение из внутренней системы. Команда построила RAG по выгрузкам, хотя ответ вычисляется, а не ищется в документах. Проще вызвать API или tool. RAG здесь маскирует отсутствие интеграции.
Что запомнить
RAG нужен для поиска по большому или меняющемуся корпусу. Long context нужен, когда материал помещается в окно и его проще передать целиком. Промпт без поиска нужен, когда знаний в запросе или инструкции достаточно. RAG не нужен, когда задача решается вызовом API, расчётом или прямым доступом к авторизованному документу.
Ландшафт стеков хранения
Выбор хранилища для RAG начинается не с рейтинга векторных баз, а с вопроса, нужен ли вообще векторный поиск. Векторный индекс не создает смысл сам по себе: он ускоряет поиск по эмбеддингам, качество которых зависит от модели, домена и качества чанков. Сначала проверь гипотезу на лексическом поиске и реальных запросах, затем добавляй dense-представления, если они дают измеримый прирост. Стеки ниже различаются скоростью, моделью эксплуатации, изоляцией данных и способом синхронизации с основной БД. Отдельно про фреймворки: LangChain, LlamaIndex и Haystack в этом курсе не используются намеренно. Они собирают пайплайн из готовых блоков и заодно прячут ровно те слои, которые здесь собираются руками: чанкинг, гибрид, слияние, метрики. Пройдя механику, ты прочитаешь фреймворк как конструктор из уже знакомых деталей, но не наоборот.
Qdrant. Специализированная векторная база с коллекциями, фильтрацией по payload и возможностями распределенного развертывания. Ее стоит рассматривать, когда векторный поиск является отдельной рабочей нагрузкой, нужны гибкие фильтры по метаданным и команда готова администрировать отдельный сервис. Для небольшого проекта она может быть избыточна, если уже есть PostgreSQL или SQLite.
pgvector. Расширение PostgreSQL, которое хранит векторы рядом с обычными таблицами и позволяет искать по ним SQL-запросами. Бери его, когда данные уже живут в Postgres, важны транзакционная согласованность, привычные бэкапы, права и joins с бизнес-сущностями. На больших коллекциях придется отдельно продумать индексы, партиционирование, вакуум и ресурсы, но это часто дешевле, чем второй источник истины.
Weaviate. Векторная база со схемой данных, гибридным поиском и встроенными механизмами мультитенантности. Она подходит, когда нужен готовый сервис с гибридными запросами и изоляцией тенантов без сборки всего из отдельных компонентов. Перед выбором проверь, насколько тебе подходит ее модель схемы, модулей и обновлений, потому что это тоже часть ops-нагрузки.
Milvus. Распределенная векторная база, рассчитанная на большие объемы данных и высокую нагрузку на вставку и поиск. Ее берут, когда масштаб и требования к отказоустойчивости оправдывают отдельную платформу с несколькими компонентами и выделенную команду эксплуатации. Для небольшого корпоративного поиска это обычно слишком тяжелая инфраструктура.
Chroma. База с простым API и удобным локальным режимом, популярная для прототипов и небольших RAG-приложений. Начинать с нее удобно, когда нужно быстро проверить retrieval-пайплайн и не хочется поднимать полноценный кластер. Перед продакшн-нагрузкой оцени отдельно режим развертывания, резервное копирование, изоляцию и поведение при отказах.
LanceDB. Встроенная векторная база на колоночном формате Lance, которая может работать локально и с данными в объектном хранилище. Она интересна для приложений, где нужен embedded-подход, работа с большими локальными наборами или аналитические сценарии рядом с поиском. Это не замена универсальной транзакционной БД, поэтому синхронизацию и конкурентный доступ нужно проектировать явно.
sqlite-vec. Расширение SQLite для векторного поиска в одном файле, без отдельного сервера. Хороший вариант для десктопных приложений, CLI, edge-сценариев, локальных ассистентов и тестов, где важны простота и автономность. Для многопользовательского сервиса с высокой конкурентностью или очень большим индексом смотри на серверные хранилища. Учти зрелость: проект до сих пор до версии 1.0, стабильная линия правит ошибки, а настоящие ANN-индексы вроде DiskANN идут в альфа-ветке.
zvec. Встроенная векторная база от Alibaba (open source под Apache 2.0, версия 0.8.0 на октябрь 2026), которая живёт прямо в процессе приложения: без сервера и конфигурации, с плотными и sparse-векторами, полнотекстовым поиском и гибридом в одной библиотеке, с журналом упреждающей записи на случай падения процесса. Читают несколько процессов одновременно, пишет один. По набору возможностей это самый полный embedded-движок на сегодня: то, для чего раньше требовались серверная база плюс отдельный полнотекстовый движок, здесь лежит в одном пакете. Для десктопа, edge и локальных ассистентов это прямой конкурент sqlite-vec и Chroma; проверь поддержку твоей платформы и зрелость API, версия ещё не дошла до единицы.
За рамками таблицы остаются нишевые игроки, о которых стоит знать, чтобы не изобретать своё. DuckDB VSS добавляет векторный поиск прямо в аналитический SQL, когда корпус уже живёт в DuckDB. GPU-индексы вроде Milvus GPU_CAGRA на базе NVIDIA cuVS ускоряют поиск на больших корпусах, когда обычного CPU-индекса перестаёт хватать. Ниша у обеих узкая, но именно на стыках таких сценариев люди чаще всего пишут лишние велосипеды.
Рядом с хранилищами живут три класса, которые часто путают с самим RAG. Managed-поиск (Pinecone, Turbopuffer) снимает с тебя эксплуатацию за деньги: у Pinecone есть плоский тариф и расширение pg_pinecone для поиска прямо из Postgres, Turbopuffer берёт за хранение и запросы по факту. Смысл класса не в фичах, а в том, что бэкапы, репликация и апгрейды уже чьи-то. Крайняя форма той же идеи: retrieval как встроенный инструмент LLM-платформы, когда своего хранилища нет вовсе. У OpenAI это File search, встроенный инструмент, который ищет по загруженным файлам перед ответом; у Claude это MCP connector, который подключает внешние MCP-серверы прямо в запрос к API. Удобно для старта, но данные и качество поиска остаются внутри чужой платформы. Memory-слои (mem0, Graphiti от Zep, Cognee) решают соседнюю задачу: долгосрочная память агента, которая помнит факты о пользователе и событиях между сессиями; под капотом у них всё тот же векторный поиск или темпоральный граф, поэтому механика этого курса применима и там. Portable memory (memvid с форматом .mv2) упаковывает корпус с индексами в один переносимый файл; класс молодой, самый заметный игрок в нём именно memvid, и это удобный формат для передачи базы знаний между машинами. Ни один из трёх классов не заменяет векторную базу из этого модуля: они либо над ней, либо рядом.
| Критерий | Что проверить | Практический вывод |
|---|---|---|
| Масштаб: тысячи векторов | Хватит ли встроенного решения, насколько часто меняются данные, нужен ли поиск на ноутбуке или в браузере | Обычно достаточно sqlite-vec, Chroma или LanceDB; pgvector тоже уместен, если данные уже в Postgres |
| Масштаб: миллионы векторов | Нагрузка на запись, задержка поиска, размер индекса, требования к репликации | Смотри на pgvector после настройки, Qdrant, Weaviate или LanceDB; решение проверяй нагрузочным тестом |
| Масштаб: миллиарды векторов | Нужны ли шардирование, репликация, отдельный кластер и команда эксплуатации | Кандидаты: Milvus и распределенные конфигурации Qdrant или Weaviate; без реального профиля нагрузки выбор будет случайным |
| Мультитенантность | Изоляция через фильтры, схемы, коллекции или отдельные инстансы; риск утечки данных и стоимость шумного тенанта | Для малого числа тенантов часто хватает фильтров, для строгой изоляции нужны отдельные коллекции, схемы или инстансы |
| Ops-нагрузка | Кто администрирует сервис, кто делает бэкапы, обновления, мониторинг и восстановление после сбоя | sqlite-vec и LanceDB уменьшают число сервисов; pgvector ложится на команду Postgres; Qdrant, Weaviate и Milvus требуют отдельной эксплуатации |
| Консистентность с транзакционной БД | Нужно ли видеть документ и его вектор в одной транзакции, допустима ли eventual consistency | pgvector и sqlite-vec удобны для согласованности внутри одной БД; внешний векторный сервис синхронизируй через outbox или CDC и проверяй отставание |
Когда хватает BM25 и rerank
Часто можно услышать, что в большинстве случаев хватает BM25 с rerank. Это не результат исследования и не норматив, а напоминание: не начинай с векторов по умолчанию. Если пользователи ищут точные термины, артикулы, коды ошибок, названия функций, номера договоров или фрагменты кода, лексический поиск часто дает более предсказуемую выдачу. BM25 хорошо ранжирует документы по совпадению редких слов, а reranker затем переставляет верхних кандидатов с учетом смысла запроса.
Главное ограничение: rerank не расширяет воронку кандидатов. Если BM25 не нашел документ из-за синонима или перефразировки, reranker не сможет его восстановить. Поэтому связка BM25 с rerank особенно хороша при низкой полисемии, когда язык запросов близок к языку документов. Например, во внутренней базе инцидентов запрос с точным кодом ошибки или именем сервиса редко требует эмбеддингов. Для кода, юридических ссылок, артикулов и технических регламентов лексический поиск часто является основным, а не запасным вариантом.
Эмбеддинги действительно нужны, когда запрос и документ используют разные слова для одного смысла. Это синонимы, перефразировки, естественные вопросы к инструкциям, разговорные формулировки и кросс-язычный поиск. Dense-поиск также полезен, когда пользователь описывает задачу своими словами, а в базе лежат формальные описания. Но даже там эмбеддинги не гарантируют recall: модель может не знать доменных сокращений, плохо работать с длинными чанками или смешивать близкие сущности.
Практичнее не выбирать между BM25 и векторами навсегда, а собрать гибридную схему и измерить вклад каждого компонента на своем наборе запросов. Рабочий минимум: BM25, dense-поиск, объединение кандидатов и rerank. Если BM25 с rerank уже закрывает качество, не добавляй векторную базу только ради модности. Если добавляешь, заранее реши вопросы версионирования эмбеддингов, полной переиндексации при смене модели, хранения метаданных и синхронизации с источником истины.
Практика: сравниваем лексический поиск и hash-эмбеддинги
Ниже собран оффлайн-скрипт, который на одном и том же корпусе регламентов запускает два способа поиска. Лексический поиск считает tf*idf по точным совпадениям токенов и хорошо находит документы, где встречаются слова запроса. Векторный поиск превращает текст в hash-эмбеддинги, нормализует векторы и сравнивает их через скалярное произведение. Запусти скрипт без установки зависимостей, затем меняй запросы и смотри, где расходятся top-2 выдачи.
import hashlib
import math
import re


def tokenize(text: str) -> list[str]:
    # Простая токенизация для русского и латинского текста.
    return re.findall(r"[a-zа-яё0-9]+", text.lower())


def embed(text: str, dim: int = 64) -> list[float]:
    # Детерминированный hash-эмбеддер для офлайн-демонстрации.
    # для продакшена замените на живой эмбеддер.
    vector = [0.0] * dim
    for token in tokenize(text):
        digest = hashlib.sha256(token.encode("utf-8")).digest()
        index = int.from_bytes(digest[:4], "big") % dim
        sign = 1.0 if digest[4] % 2 == 0 else -1.0
        vector[index] += sign
    norm = math.sqrt(sum(value * value for value in vector))
    if norm == 0.0:
        return vector
    return [value / norm for value in vector]


CORPUS = [
    "Для удаленной работы используйте только корпоративный VPN. Личный VPN запрещен, а подключение к внутренним системам без него блокируется.",
    "Заявление на отпуск подается через портал не позднее чем за две недели. Согласование руководителя обязательно, перенос дат обсуждается отдельно.",
    "Резервные копии критичных данных создаются ежедневно. Раз в месяц дежурная команда проверяет восстановление на тестовом контуре.",
    "Доступ к общим папкам выдается по заявке в службу поддержки. Права пересматриваются при переводе сотрудника или смене проекта.",
    "Пароли к рабочим сервисам нельзя передавать коллегам. При подозрении на утечку смените пароль и сообщите в информационную безопасность.",
    "Инциденты с оборудованием фиксируются в общем журнале. После устранения сбоя исполнитель добавляет краткое описание причины."
]

DOC_TOKENS = [tokenize(document) for document in CORPUS]
DOC_VECTORS = [embed(document) for document in CORPUS]
DF = {}
for tokens in DOC_TOKENS:
    for token in set(tokens):
        DF[token] = DF.get(token, 0) + 1
IDF = {token: math.log(len(CORPUS) / frequency) for token, frequency in DF.items()}


def lex_score(query_tokens, doc_tokens):
    # Считаем tf*idf по точным совпадениям токенов запроса и документа.
    if not query_tokens or not doc_tokens:
        return 0.0
    score = 0.0
    for token in set(query_tokens):
        if token not in doc_tokens:
            continue
        tf = doc_tokens.count(token) / len(doc_tokens)
        qtf = query_tokens.count(token) / len(query_tokens)
        score += tf * IDF.get(token, 0.0) * qtf
    return score


def cosine(left, right):
    # Векторы уже нормализованы, поэтому косинус равен dot product.
    return sum(a * b for a, b in zip(left, right))


def lexical_search(query: str, limit: int = 2):
    query_tokens = tokenize(query)
    ranked = []
    for index, tokens in enumerate(DOC_TOKENS):
        ranked.append((lex_score(query_tokens, tokens), index))
    ranked.sort(reverse=True)
    return ranked[:limit]


def vector_search(query: str, limit: int = 2):
    query_vector = embed(query)
    ranked = []
    for index, document_vector in enumerate(DOC_VECTORS):
        ranked.append((cosine(query_vector, document_vector), index))
    ranked.sort(reverse=True)
    return ranked[:limit]


def main() -> None:
    queries = [
        "Как получить доступ к VPN из дома?",
        "Сколько дней отпуска можно взять без сохранения зарплаты?",
        "Где хранятся резервные копии и как часто их проверяют?",
    ]
    for query in queries:
        print(f"\nЗапрос: {query}")
        print("Лексический top-2:")
        for score, index in lexical_search(query):
            print(f"  {score:.3f} | {CORPUS[index]}")
        print("Векторный top-2:")
        for score, index in vector_search(query):
            print(f"  {score:.3f} | {CORPUS[index]}")


if __name__ == "__main__":
    main()
Hash-эмбеддер полезен как учебный стенд: он детерминирован, быстрый и не требует сети. Но семантики у него нет. Он не понимает синонимы, может столкнуть разные токены в одну координату из-за коллизий, а при суммировании теряет порядок слов и часть синтаксиса. Поэтому совпадение по косинусу здесь означает близость hash-представлений, а не близость смыслов. Сравнение ниже показывает не преимущество метода, а разницу в сигналах, которые получает ранжировщик. Дальше по курсу мы заменим этот слой на живой эмбеддер, сохранив ту же схему: индексация, top-k, сравнение метрик и анализ ошибок. Так ты увидишь, какие проблемы решает обученная модель, а какие остаются у любого поиска.
Лаба: реши развилку для своего кейса
Возьми реальный кейс из работы. Если своего нет, используй учебный: 50 документов регламентов, команда из 3 человек, обновление раз в месяц. Опиши корпус, типичные запросы пользователей и ограничения команды. Дальше пройди по таблице-развилке из теории и письменно ответь на 4 вопроса.
- Поместится ли корпус в контекст? Считай сами документы, системную инструкцию, историю диалога и запас на ответ. Если корпус помещается с запасом, сначала проверь полный контекст, а не добавляй RAG автоматически.
- Важна ли свежесть? Определи, как часто меняются документы и что будет, если модель ответит по устаревшей версии. Если цена ошибки высокая, опиши, как будешь обновлять индекс и проверять актуальность.
- Нужен ли поиск по точным терминам? Проверь, есть ли в запросах артикулы, коды, фамилии, аббревиатуры, номера пунктов и формулы. Для таких сущностей лексический поиск обычно надёжнее, чем hash-эмбеддер.
- Какая ops-нагрузка допустима? Учти, кто будет обновлять индекс, следить за качеством выдачи, разбирать ошибки и хранить данные. Если команда маленькая, отдельная векторная БД может оказаться лишней.
После письменных ответов запусти скрипт из модуля на своих 10 документах. Подготовь несколько запросов, включая запросы с точными терминами и перефразировками. Сравни выдачу лексического поиска и hash-поиска. Запиши, где результаты разошлись и почему: hash-поиск не понимает синонимы, лексический поиск цепляется за точное совпадение, оба могут ошибаться на коротких запросах.
Критерий выполнения лабы: одна строка-вердикт и полный вывод скрипта. Вердикт формулируй так: «Берём полный контекст, потому что корпус мал и обновляется редко» или «Берём гибридный поиск, потому что важны точные термины и свежесть». Вывод скрипта приложи целиком, без пересказа.
Критерий готовности
- Объясняешь, в каких случаях RAG не нужен и его можно заменить полным контекстом.
- Называешь критерии выбора между pgvector и отдельной векторной БД.
- Запускаешь скрипт из модуля на чистом Python без установки внешних пакетов.
- Понимаешь ограничение hash-эмбеддера и не используешь его как доказательство качества продакшн-поиска.
- Формулируешь вердикт по своему кейсу и подтверждаешь его выводом скрипта.
Чеклист самопроверки
- Почему hash-эмбеддер не ловит синонимы, если слова означают одно и то же?
- Что дешевле по токенам в твоём кейсе: полный контекст или RAG с небольшим набором найденных фрагментов?
- Когда BM25 обгонит векторный поиск и почему это не делает векторный поиск бесполезным?
- Как частота обновления документов влияет на выбор между полным контекстом и индексом?
- Почему хороший top-k ещё не гарантирует хороший ответ?
- В каком месте твоего пайплайна hash-эмбеддер начнёт искажать оценку качества и что там поставить в продакшне?
Материалы главы: текст главы в репо · код · иллюстрации · подписка на обновления курса