Хаб курсов / Курс по RAG / глава 1
Модуль 01: мини-RAG руками, без фреймворков
Пишем мини-RAG на чистом Python: эмбеддинги, косинусное сходство, top-k и ответ с цитатами. Полный скрипт без фреймворков, запускается оффлайн.
RAG Engineering. Модуль 01: Мини-RAG руками, без фреймворков
Эмбеддинги, косинус и top-k: минимум математики
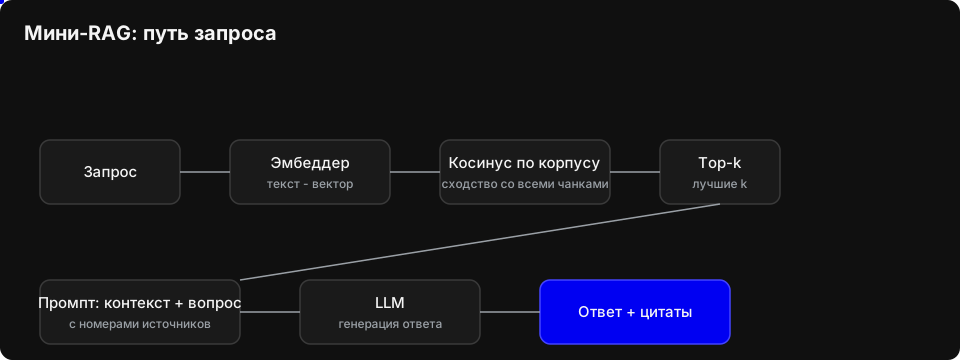
Поиск в RAG начинается не с генерации, а с выбора фрагментов. Тебе нужно превратить текст в объект, который можно сравнивать, а затем отобрать кандидатов. Для этого хватает трех идей: эмбеддинг, косинусное сходство и top-k.
Эмбеддинг: смысл как координаты
Эмбеддинг это список чисел фиксированной длины. Для каждого чанка и для запроса получается вектор. Числа это координаты в пространстве, которое построила модель. Отдельная координата обычно не имеет понятного человеку имени, но направления в этом пространстве отражают закономерности текста. Смысловая близость здесь превращается в геометрическую близость векторов: чем ближе векторы, тем больше общего модель видит в текстах.
Представь игрушечное пространство с двумя осями: «живое» и «техника». У слов «кошка» и «котёнок» координаты будут близки, а у «кошка» и «автомобиль» далеко. В настоящем эмбеддинге осей намного больше, и они не подписаны. Ты не можешь сказать: «третья координата отвечает за кулинарию». Зато можешь сравнить два вектора целиком.
На практике эмбеддинг считается для чанка, а не для всего документа. Чанк это кусок текста, который достаточно мал, чтобы говорить об одной мысли, и достаточно велик, чтобы не потерять контекст. Вектор чанка это сжатый отпечаток его содержания. Поэтому качество нарезки влияет на поиск не меньше, чем сам эмбеддер.
Отсюда главное правило: запрос и документы должны быть в одном пространстве. Если корпус закодирован одним эмбеддером, запрос кодируй тем же эмбеддером. Иначе координаты несопоставимы, и поиск будет выдавать случайный шум.
Косинус: сравниваем направление
Косинусное сходство отвечает на вопрос: насколько два вектора смотрят в одну сторону. Словами формула такая: скалярное произведение векторов делится на произведение их длин.
cos(a, b) = (a · b) / (||a|| * ||b||)
Скалярное произведение это сумма попарных произведений координат. Длины это длины векторов. Для ненулевых векторов результат лежит в диапазоне [-1, 1].
Почему 1 значит одинаковое направление? Потому что угол между векторами равен нулю, а косинус нуля равен единице. Векторы могут быть разной длины, но указывать в одну сторону. Почему 0 значит ортогональность? Потому что векторы расположены под прямым углом и не имеют общего направления. Для текстов это сигнал, что сходства по выбранным признакам нет. Значение -1 означает противоположные направления.
Косинус не сводит сходство к длине вектора: вектор может быть длиннее, но направление останется тем же. Он сравнивает форму направления. Но это не вероятность и не гарантия смысла. Высокий скор означает «похоже по представлению эмбеддера», а не «пользователь точно получил ответ».
Если заранее нормализовать каждый вектор, то есть сделать его длину равной единице, знаменатель становится единицей. Тогда:
cos(a, b) = a · b
То есть для нормализованных векторов косинус это просто скалярное произведение. На практике нормализуют и векторы чанков, и вектор запроса. Это упрощает код и убирает влияние длины. Если нормализации нет, обычное скалярное произведение смешивает направление и длину, и пороги становятся менее предсказуемыми.
Top-k: как выбрать кандидатов
Когда векторы готовы, поиск выглядит так. Ты считаешь скор запроса с доступными чанками, сортируешь результаты по убыванию и берешь первые k. В маленьком демо можно честно перебрать весь корпус. В большом проекте вместо полного перебора используют индекс, но логика отбора остается той же: получить кандидатов, отсортировать, ограничить.
Слишком маленький k экономит контекст, но повышает риск не найти нужный факт. Модель получит неполный набор фрагментов и может ответить уверенно, но неверно. Слишком большой k добавляет шум, дубли, слабые совпадения и конфликтующие фрагменты. Растет стоимость промпта, а полезный сигнал размывается. k это не «чем больше, тем лучше», а баланс между полнотой поиска и бюджетом контекста.
Порог отсечки по скору задает минимальное сходство, ниже которого кандидат не попадает в промпт. Работать лучше так: сначала отбросить все, что ниже порога, затем взять не больше k лучших. Если после порога ничего не осталось, честно верни «не найдено» или задай уточняющий вопрос, а не подставляй случайный чанк.
Порог нельзя брать универсальным. Он зависит от эмбеддера, корпуса и языка. Подбирай его на своих примерах: смотри, какие фрагменты действительно нужны для ответа, и проверяй, не отсекает ли порог полезные попадания. Хорошая практика: хранить скор рядом с кандидатом и логировать, почему фрагмент попал или не попал в контекст.
top-k это не финальный ответ, а список кандидатов. После отбора полезно убрать дубли, проверить, что фрагменты не противоречат друг другу, и сохранить идентификаторы источников. Если кандидаты слабые, не пытайся лечить это огромным k: сначала проверь эмбеддер, нарезку и формулировку запроса.
Что косинус считает похожим, а что нужно пользователю
| Что считает релевантным косинус | Что хочет пользователь |
|---|---|
| Высокий скор у текста с той же темой и похожими словами | Ответ на вопрос, даже если формулировка другая |
| Высокий скор у почти одинаковых служебных абзацев | Разные факты, а не дубли |
| Низкий скор у синонима, который эмбеддер плохо различает | Нахождение нужного смысла при смене формулировки |
| Высокий скор у похожей конструкции, но с противоположным смыслом | Правильное понимание отрицания и условий |
Эта таблица напоминает: косинус это инструмент ранжирования, а не судья истины. Его задача дать хороших кандидатов, которых потом можно проверить, отранжировать точнее или передать в промпт с цитатами.
Что ты построишь
Ты построишь мини-RAG на чистом Python, без фреймворков и внешних сервисов: загрузку корпуса, нарезку на чанки, эмбеддинги, индекс в памяти, поиск top-k и сборку промпта. В демо будешь использовать hash-эмбеддер, который запускается оффлайн на stdlib; он нужен только для механики, а не для качества семантического поиска. В продакшене заменишь его на настоящий эмбеддер и сохранишь тот же контракт: вектор для чанка, вектор для запроса, косинус и top-k. В конце соберешь промпт из выбранных фрагментов с цитатами, чтобы ответ можно было проверить по источнику.
Разбор решений: почему именно так
Ниже разбор решений, которые ты принимаешь в мини-RAG: что даёт каждый механизм и где он создаёт ограничения.
1. Cosine вместо евклидова расстояния
Решение. Для поиска используем косинусную близость между векторами запроса и чанка.
Почему так. Косинус сравнивает направление векторов, а не их абсолютную длину. Для текстовых эмбеддингов направление обычно кодирует смысл, тогда как длина может зависеть от количества слов, особенностей токенизации и масштаба значений. На нормализованных векторах порядок результатов у косинуса и евклидова расстояния совпадает. Это следует из формулы ||a-b||^2 = 2 - 2 * dot(a,b): чем больше скалярное произведение, тем меньше расстояние. Поэтому выбор не в том, что косинус даст другой порядок после нормализации, а в том, что косинус естественно интерпретируется как близость направлений и удобен для порогов. Евклидово расстояние на ненормализованных векторах сильнее реагирует на масштаб и длину, а тебе нужно сравнивать смысл, а не размер документа.
Чем платим. Косинус игнорирует магнитуду вектора, а она иногда несет полезную информацию: уверенность эмбеддера, интенсивность признака, аномальность текста. Для hash-эмбеддера это особенно заметно: длинный документ получает больше ненулевых признаков, и без нормализации он может доминировать. Кроме того, косинус требует аккуратной обработки нулевых векторов, иначе получишь деление на ноль или неопределенный скор.
2. L2-нормализация векторов
Решение. После построения вектора делим его на L2-норму: v_norm = v / ||v||. Затем сравниваем запрос и документы через скалярное произведение.
Почему так. После нормализации все векторы лежат на единичной сфере. Косинус превращается в обычный dot product, а значит, поиск можно свести к быстрой операции без повторного вычисления норм. Это убирает влияние длины документа на скор: документ не получает преимущества только потому, что в нем больше токенов или признаков. Нормализация также делает геометрию предсказуемой: евклидово расстояние и косинус начинают давать одинаковый порядок результатов, поэтому можно выбирать реализацию по удобству и скорости.
Чем платим. Мы сознательно выбрасываем информацию о длине и масштабе вектора. Иногда она полезна, например для определения пустых, слишком коротких или аномально длинных чанков. Нулевой вектор нормализовать нельзя, нужен явный fallback. Если эмбеддер уже возвращает нормализованные векторы, операция избыточна, но обычно безвредна. Главное, не смешивать нормализованные и ненормализованные векторы в одном индексе.
3. Предобработка текста
Решение. Перед построением hash-эмбеддинга приводим текст к нижнему регистру, разбиваем на токены, убираем лишнюю пунктуацию и делаем простую нормализацию словоформ.
Почему так. Lowercasing уменьшает число вариантов одного и того же слова. Токенизация задает единицы, по которым строится вектор. Для русского языка формы слов сильно меняются: кот, кота, коту, коты могут попасть в разные признаки, хотя смысл близок. В учебном hash-эмбеддере приходится использовать костыль: обрезать частые окончания, сравнивать основы или добавлять символьные n-граммы. Это повышает совпадение запроса и документа без внешних моделей.
Чем платим. Lowercasing ломает регистрозначимые сущности: названия, аббревиатуры, идентификаторы. Простая обрезка окончаний ошибается на исключениях и склеивает разные слова. Токенизация по пробелам и пунктуации не понимает морфологию, контекст и синонимы. В итоге предобработка это дешевый компромисс для оффлайн-демо, а не замена живому эмбеддеру. В продакшене такие правила надо либо заменить моделью, либо тщательно тестировать на реальных запросах.
4. Чанки вместо целых документов
Решение. Документы режем на чанки и индексируем каждый отдельно.
Почему так. Чанк дает точную цитату: в ответ можно вернуть не весь документ, а конкретный фрагмент, где находится ответ. Это уменьшает размер промпта и стоимость генерации. Скор тоже становится гранулярным: мы сравниваем запрос с небольшим смысловым блоком, а не размываем сигнал по всему документу. Практический диапазон для мини-RAG: примерно 200-500 токенов на чанк и перекрытие 10-20%. Перекрытие помогает не потерять смысл на границе, но не должно быть слишком большим. Эти диапазоны зависят от структуры документов, длины запросов и эмбеддера.
Чем платим. Появляются границы, которые могут разрезать мысль, таблицу или список. Возникают дубли: один и тот же факт попадает в несколько чанков. Растет размер индекса и число кандидатов на поиск. Нужны метаданные: source, chunk_id, позиция, заголовок. Если чанк слишком мал, теряется контекст. Если слишком велик, падает точность цитаты и растет промпт. Размер чанка это гиперпараметр, который надо проверять на своих данных, а не выбирать по памяти.
5. Обязательные ссылки на источник в промпте
Решение. Каждый чанк получает стабильный идентификатор и метаданные источника. В промпт передаем фрагменты вместе с source и chunk_id, а модель просим ссылаться на них в ответе.
Почему так. Ссылка делает ответ проверяемым: человек может открыть источник и убедиться, что утверждение не выдумано. При ошибке видно, был ли плохой retrieval, неверный чанк или модель проигнорировала контекст. Это резко упрощает отладку RAG: можно отдельно проверить, нашли ли мы нужный фрагмент, попал ли он в промпт и сослалась ли на него генерация. Без ссылок ответ выглядит убедительно, но его нельзя надежно проверить.
Чем платим. Метаданные занимают место в промпте и увеличивают его размер. Модель может поставить неверную ссылку, сослаться на несколько источников или проигнорировать инструкцию. Нужна постпроверка: все ли идентификаторы существуют, соответствует ли цитата тексту, нет ли утверждений без источника. Поэтому ссылки это не украшение ответа, а часть контракта между retrieval, генерацией и проверкой.
Практика: мини-RAG за 150 строк
Скрипт проходит пять шагов: превращает текст в детерминированные hash-эмбеддинги; режет документы на чанки по предложениям; строит плоский индекс с метаданными; ищет top-3 по косинусу; собирает промпт с контекстом и ссылками. Все данные лежат в DOCS, поэтому пример запускается оффлайн без установки пакетов. Сначала прочитай блок DOCS и функцию chunk, затем проверь, как search возвращает скоры. В main выполняются два запроса, печатаются лучшие фрагменты и готовый промпт для первого запроса. Сравни порядок выдачи со своим ожиданием: так проще увидеть ограничения hash-поиска.
import hashlib
import math
import re


def embed(text: str, dim: int = 96) -> list[float]:
    # Детерминированный hash-эмбеддер для учебного примера.
    # Для продакшена замените на живой эмбеддер.
    vector = [0.0] * dim
    tokens = re.findall(r"[a-zа-яё0-9]+", text.lower())
    if not tokens:
        return vector

    for token in tokens:
        # Берем несколько позиций из SHA-256 и раскладываем токен по вектору.
        digest = hashlib.sha256(token.encode("utf-8")).digest()
        for offset in range(0, 8, 2):
            position = int.from_bytes(digest[offset:offset + 2], "big") % dim
            sign = 1.0 if digest[offset + 2] % 2 == 0 else -1.0
            vector[position] += sign

    # L2-нормализация превращает скалярное произведение в косинус.
    norm = math.sqrt(sum(value * value for value in vector))
    if norm:
        vector = [value / norm for value in vector]
    return vector


def chunk(text, max_chars=220):
    # Делим текст на предложения, затем собираем их в чанки.
    sentences = re.split(r"(?<=[.!?])\s+", text.strip())
    chunks = []
    current = ""

    for sentence in sentences:
        sentence = sentence.strip()
        if not sentence:
            continue
        if len(sentence) > max_chars:
            # Слишком длинное предложение режем по словам.
            words = sentence.split()
            piece = ""
            for word in words:
                candidate = (piece + " " + word).strip()
                if len(candidate) > max_chars and piece:
                    chunks.append(piece)
                    piece = word
                else:
                    piece = candidate
            if piece:
                if current:
                    chunks.append(current)
                    current = ""
                chunks.append(piece)
            continue
        candidate = (current + " " + sentence).strip()
        if len(candidate) <= max_chars:
            current = candidate
        else:
            if current:
                chunks.append(current)
            current = sentence

    if current:
        chunks.append(current)
    return chunks


def build_index(docs):
    # Создаем плоский список чанков с метаданными и векторами.
    index = []
    for doc in docs:
        for number, piece in enumerate(chunk(doc["text"]), start=1):
            index.append({
                "doc_id": doc["id"],
                "title": doc["title"],
                "chunk_id": number,
                "text": piece,
                "vector": embed(piece),
            })
    return index


def search(query, index, k=3):
    # Векторы нормализованы, поэтому косинус равен скалярному произведению.
    query_vector = embed(query)
    hits = []
    for item in index:
        score = sum(a * b for a, b in zip(query_vector, item["vector"]))
        hits.append({**item, "score": score})
    hits.sort(key=lambda item: item["score"], reverse=True)
    return hits[:k]


def build_prompt(query, hits):
    # Собираем промпт с нумерованным контекстом и требованием цитировать источники.
    lines = [
        "Ты помощник по внутренним регламентам компании.",
        "Отвечай только по блоку КОНТЕКСТ и не добавляй внешние знания.",
        "",
        "КОНТЕКСТ:",
    ]
    for number, hit in enumerate(hits, start=1):
        lines.append(f"[{number}] {hit['title']}")
        lines.append(hit["text"])
        lines.append("")
    lines.extend([
        "ВОПРОС:",
        query,
        "",
        "ПРАВИЛА ОТВЕТА:",
        "1. Опирайся только на блок КОНТЕКСТ.",
        "2. После каждого утверждения ставь ссылку вида [1].",
        "3. Если данных не хватает, прямо скажи, что ответа в контексте нет.",
    ])
    return "\n".join(lines)


DOCS = [
    {"id": "d1", "title": "Отпуска: ежегодный отпуск", "text": "Ежегодный оплачиваемый отпуск составляет двадцать восемь календарных дней. Даты отпуска согласует руководитель отдела с учетом графика. Заявление подают через кадровую систему не позднее чем за четырнадцать дней."},
    {"id": "d2", "title": "Отпуска: перенос и компенсация", "text": "Перенести отпуск можно по согласованию с руководителем и отделом кадров. Заменять отпуск денежной компенсацией запрещено, кроме случаев увольнения. Накопленные дни отображаются в личном кабинете."},
    {"id": "d3", "title": "VPN: подключение", "text": "Корпоративный VPN используют только для рабочих ресурсов. Подключение выдают сотрудникам после подтверждения учетной записи службой поддержки. Личные устройства подключать к VPN запрещено."},
    {"id": "d4", "title": "VPN: потеря устройства", "text": "При потере ноутбука с VPN сотрудник немедленно звонит в службу поддержки. Доступ к VPN блокируют, а инцидент передают в информационную безопасность. Самостоятельно восстанавливать подключение нельзя."},
    {"id": "d5", "title": "Бэкапы: расписание", "text": "Резервные копии рабочих систем создаются ежедневно. Полные копии формируются раз в неделю и хранятся отдельно от основного контура. Восстановление данных выполняет дежурная смена."},
    {"id": "d6", "title": "Бэкапы: проверка", "text": "Служба эксплуатации ежемесячно проверяет выборочное восстановление файлов. Результаты проверки фиксируют в журнале. При ошибке создают заявку и повторяют резервное копирование."},
    {"id": "d7", "title": "Доступы: выдача и отзыв", "text": "Доступ к внутренним системам выдают по заявке руководителя. Права должны соответствовать рабочим обязанностям. При увольнении или смене роли доступ отзывают в тот же рабочий день."},
    {"id": "d8", "title": "Командировки: оформление", "text": "Командировку согласует руководитель до покупки билетов. Сотрудник оформляет поездку в системе и прикладывает маршрут. Расходы возмещают по подтверждающим документам после возвращения."},
]


def main():
    # Индексируем документы один раз и выполняем два демонстрационных запроса.
    index = build_index(DOCS)
    queries = [
        "Сколько дней отпуска положено и как подать заявление?",
        "Что делать при потере ноутбука с VPN?",
    ]
    for query_number, query in enumerate(queries, start=1):
        print(f"\nЗАПРОС {query_number}: {query}")
        hits = search(query, index, k=3)
        for rank, hit in enumerate(hits, start=1):
            print(f"{rank}. [{hit['doc_id']}] {hit['title']} | score={hit['score']:.4f}")
        if query_number == 1:
            print("\nГОТОВЫЙ ПРОМПТ ДЛЯ ПЕРВОГО ЗАПРОСА:")
            print(build_prompt(query, hits))


if __name__ == "__main__":
    main()
В учебном скрипте два компонента намеренно упрощены. embed заменяет настоящую модель: для продакшена замени hash-эмбеддер на живой эмбеддер, сохранив интерфейс и нормализацию. Для русского корпуса на 2026 год рабочие варианты открытых моделей: bge-m3 как лёгкий мультиязычный дефолт, deepvk USER-bge-m3 и открытая Giga-Embeddings-instruct от Сбера как русскоязычные кандидаты, Qwen3-Embedding как тяжёлый мультиязычный топ с matryoshka-усечением размерности. Выбор между ними принимается замером на своём корпусе, не по позициям в лидербордах: лидерборды (MMTEB, вторая версия MTEB, arXiv 2502.13595) меняются каждый месяц: например, Microsoft в марте 2026 выложила открытое семейство эмбеддеров Harrier-OSS (270M/0.6B/27B), которое за полгода набрало сотни тысяч скачиваний. Генератор здесь отсутствует: build_prompt только подготавливает запрос, а для продакшена замени печать промпта вызовом генератора с проверкой цитат. Ещё добавь фильтрацию по правам доступа, дедупликацию чанков, обработку пустых результатов и оценку качества поиска на размеченном наборе вопросов. Не переноси hash-поиск в продакшн: он чувствителен к форме слов и не понимает синонимы. Отдельная засада, о которую спотыкаются боевые системы: опечатки. Пользователь пишет «реглмаент» вместо «регламент», токен не совпадает ни с одним словом корпуса, и лексический поиск молча возвращает мусор или пустоту, вместо того чтобы сказать «не понял». Живой эмбеддер частично прощает такие ошибки, но не полностью, поэтому в проде рядом с поиском живут нормализация запроса, лемматизация и нечёткое сопоставление для коротких полей вроде артикулов и имён. И ещё одна ловушка уже живых эмбеддеров: пространство должно быть одним. Индекс построен векторами одной модели, и запрос обязан считаться той же моделью, тем же препроцессингом. Подмена выглядит безобидно: сервис эмбеддингов переехал на другой рантайм, fallback-модель подхватилась «прозрачно», размерность та же. Наш замер показал, что косинус между вектором запроса из одного рантайма и вектором того же текста из другого падает до 0.33 при единичной норме: это не «чуть хуже», это разные пространства, и поиск по такому индексу возвращает мусор. Правило: индекс и запросчик всегда из одной ветки, фолбэк на другую модель валиден только для веток, которые не читают старый индекс, а при смене модели индекс пересобирается и качество замеряется до и после. Запусти скрипт, измени запросы и тексты DOCS, затем проверь, какие чанки попадают в контекст и хватает ли им метаданных для ответа.
Лаба: свои 20 документов и ответы с цитатами
Собери корпус из 20 своих текстов: заметок, регламентов, тикетов, инструкций. Бери фрагменты от 200 до 1000 символов, в которых есть законченная мысль. Замени DOCS в скрипте на свой список. У каждого документа должен быть стабильный id, чтобы ссылка в ответе указывала на конкретный источник. Сначала прогони 5 реальных запросов, которые ты действительно задал бы по этим материалам. Для каждого запроса выведи top-3, покажи цитату из каждого найденного документа и оцени попадание: угадал или мимо. Не подгоняй формулировки под hash-эмбеддер, иначе проверка потеряет смысл.
Собери ответ по найденным фрагментам. В промпте потребуй опираться только на переданный контекст, ставить номер источника после каждого утверждения и писать, что ответа в корпусе нет, если опоры не хватает. Заполни таблицу:
| Запрос | top-1 | top-2 | top-3 | После k=5 |
|---|---|---|---|---|
| 1. ... | цитата и вердикт | цитата и вердикт | цитата и вердикт | да или нет и причина |
| 2. ... | цитата и вердикт | цитата и вердикт | цитата и вердикт | да или нет и причина |
| 3. ... | цитата и вердикт | цитата и вердикт | цитата и вердикт | да или нет и причина |
| 4. ... | цитата и вердикт | цитата и вердикт | цитата и вердикт | да или нет и причина |
| 5. ... | цитата и вердикт | цитата и вердикт | цитата и вердикт | да или нет и причина |
Затем увеличь k до 5 и ответь, стал ли результат полезнее. Считай полезность по тому, появились ли в ответе новые опоры для вывода, а не по количеству найденных документов. Если новые фрагменты только шумят, напиши это прямо.
В отчёте добавь еще один абзац о провалах hash-эмбеддера. Он опирается на совпадение токенов и плохо работает там, где запрос и документ говорят об одном разными словами: синонимы, перефразирования, аббревиатуры, отрицания, местоимения и сложные вопросы. Он также путается, когда важные слова совпадают, но смысл разный, например в юридическом и бытовом контексте. Поэтому запросы с точными терминами он часто закрывает, а смысловые и переформулированные запросы проваливает.
Критерий готовности
- Собрал мини-RAG на чистом Python stdlib, запустил его оффлайн и получил ответ по корпусу.
- Заменил демонстрационные
DOCSна 20 своих документов и сохранил их идентификаторы. - Объяснил, почему для сравнения направления векторов используешь косинус, а не евклидово расстояние.
- Проверил, что промпт требует цитаты с номерами источников и отказ при отсутствии опоры.
- Сравнил top-3 и top-5 и назвал, что заменить на продакшн-эмбеддер и векторный индекс.
Чеклист самопроверки
- Что сломается в ранжировании, если не нормализовать векторы перед косинусом?
- Почему ты индексируешь чанки, а не целиком длинные документы?
- Зачем в промпте нужны ссылки на номера источников?
- Чем опасен слишком большой k для качества ответа и стоимости?
- Как ты проверишь, что модель не придумала ответ без опоры в цитатах?
- Что изменится, если заменить hash-эмбеддер на продакшн-модель?
Материалы главы: текст главы в репо · код · иллюстрации · подписка на обновления курса