Хаб курсов / Курс по RAG / глава 8
Модуль 08: agentic RAG и MCP-сервер базы знаний
Превращаем поиск в MCP-сервер базы знаний: инструменты search и get_document и agentic RAG, где модель сама решает, когда искать.
RAG Engineering. Модуль 08: Agentic RAG и MCP: сервер базы знаний
Pipeline против агента: кто решает искать
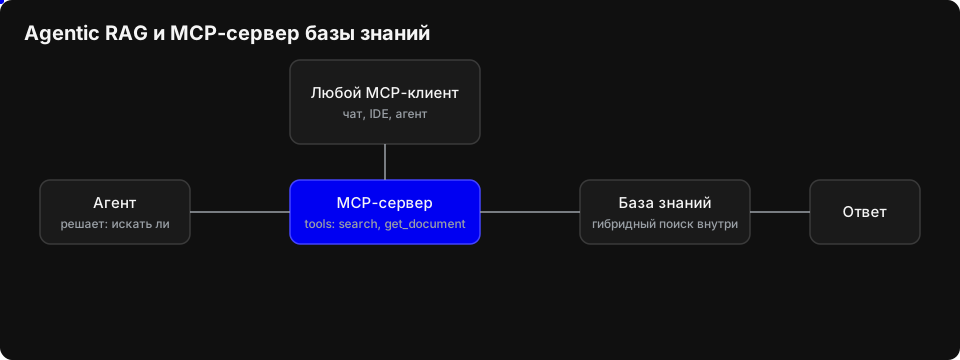
В модуле 04 поиск запускался всегда: пришёл запрос, сработали bm25_search и dense_search, результаты объединил rrf_fuse, затем генератор собрал ответ по найденным фрагментам. Это классический RAG-pipeline. Маршрут известен заранее и не зависит от содержания вопроса. Такая предсказуемость не ограничение, а главное свойство pipeline.
Pipeline: фиксированный маршрут
Pipeline удобно описывать как функцию без ветвлений, связанных с решением модели. Каждый запрос проходит одни и те же этапы, а поиск выполняется безусловно.
def pipeline_answer(query: str, k: int = 5) -> str:
    """Фиксированный маршрут: запрос, поиск, генерация."""
    # Гибридный поиск из модуля 04
    bm25_hits = bm25_search(query, k=k)
    dense_hits = dense_search(query, k=k)  # для продакшена замените на живой эмбеддер
    # k=60 внутри rrf_fuse это константа сглаживания RRF, не глубина выдачи;
    # глубину отрезаем срезом после слияния
    chunks = rrf_fuse([bm25_hits, dense_hits])[:k]

    context = "\n\n".join(chunk["text"] for chunk in chunks)
    return generate(query, context)  # заглушка вызова LLM
Здесь нет вопроса «искать ли». Ответ на приветствие всё равно вызовет поиск, а вопрос «сколько будет 17 умножить на 23» всё равно получит пять фрагментов регламента. Зато число обращений к поисковому индексу и генератору известно заранее, задержка предсказуема, а поведение системы легко объяснить.
Агент: решение передаётся модели
В агентном RAG модель получает набор инструментов и сама выбирает действие. Инструментом может быть поиск по регламентам, поиск по другому корпусу, калькулятор или обращение к базе данных. Модель решает, нужен ли инструмент вообще, какой именно, с какими аргументами, сколько раз его вызвать и когда выдать финальный ответ.
Минимальный цикл агента на чистом Python выглядит так:
TOOLS = {
    "search_regulations": {
        "description": "Поиск по служебным регламентам",
        "run": lambda query: search_regulations(query),
    },
    "calculate": {
        "description": "Вычисление арифметического выражения",
        # eval даже с пустыми __builtins__ не песочница: выражение вида
        # ().__class__.__bases__[0].__subclasses__() вылезает наружу.
        # В боевом коде здесь строгий парсер арифметики, см. safe_calculate ниже.
        "run": lambda expression: safe_calculate(expression),
    },
}

def run_agent(question: str, max_steps: int = 4) -> str:
    """Цикл вызова инструментов с жёстким ограничением шагов."""
    messages = [{"role": "user", "content": question}]

    for _ in range(max_steps):
        decision = llm_step(messages, tools=list(TOOLS.keys()))

        if decision["type"] == "final":
            return decision["text"]

        name = decision.get("tool")
        if name not in TOOLS:
            # Модель выбрала несуществующий инструмент
            messages.append({"role": "tool", "content": "Неизвестный инструмент"})
            continue

        result = TOOLS[name]["run"](**decision.get("args", {}))
        messages.append({"role": "tool", "name": name, "content": str(result)})

    return "Не удалось получить ответ за отведённое число шагов."
Главное отличие от pipeline: ветвление появляется внутри выполнения. Один и тот же код может ответить без поиска, вызвать поиск один раз или собрать данные из двух источников. Именно это делает агент гибким и одновременно менее предсказуемым.
Когда агент оправдан
Агент полезен там, где маршрут действительно неизвестен заранее.
- Запрос может не требовать поиска: приветствие, благодарность, просьба посчитать, переформулировать текст.
- Задача многошаговая: сначала найти регламент, затем уточнить срок в связанном документе, затем сравнить два правила.
- Источники разнородны: часть ответа лежит в текстовых регламентах, часть в таблице, часть вычисляется.
- Пользователь задаёт вопросы свободной формы, и жёстко перечислить все сценарии заранее не получается.
Во всех этих случаях pipeline будет делать лишнюю работу или окажется слишком грубым. Агент позволяет пропустить ненужный этап и выбрать подходящий инструмент.
Когда pipeline лучше
Pipeline выигрывает, когда поток запросов однотипен. Служба поддержки отвечает по регламентам, сотрудники задают вопросы об отпусках, согласованиях и сроках. Поиск нужен почти всегда, а дополнительная свобода модели только добавляет риски.
Pipeline также предпочтителен при жёстких требованиях к задержке и стоимости. Один поисковый запрос и одна генерация дешевле и быстрее цикла из нескольких вызовов модели. Для регламентных ответов важна воспроизводимость: одинаковый вопрос должен приводить к одинаковому маршруту, а найденные фрагменты должны легко проверяться.
Наконец, pipeline проще тестировать. В модуле 06 золотой набор GOLD позволяет прогнать фиксированный сценарий и сравнить метрики. Для агента к метрикам качества добавляются метрики поведения: сколько шагов сделано, какие инструменты вызваны, не было ли лишних обращений.
Цена агентности
Агентность не бесплатна. Появляются циклы вызовов, и задержка перестаёт быть константой. Один запрос может уложиться в один шаг, а другой займёт несколько итераций. Стоимость растёт вместе с числом обращений к модели и инструментам.
Добавляются новые режимы отказа. Модель может не вызвать инструмент, хотя он был нужен. Может вызвать не тот инструмент. Может передать неверные аргументы или зациклиться. Поэтому агенту нужны ограничение числа шагов, валидация аргументов, обработка неизвестных инструментов и понятный ответ при исчерпании лимита.
Компромисс
Практичное решение состоит не в выборе одной крайности, а в разделении обязанностей. Pipeline остаётся маршрутом по умолчанию для типовых запросов. Агент подключается там, где маршрут действительно неизвестен заранее: в открытом чате, в многошаговых задачах, при работе с несколькими источниками.
Промежуточный вариант: лёгкий классификатор или правило определяет тип запроса, а дальше запускается либо прямой pipeline, либо агентский цикл. Это сохраняет предсказуемость для основной массы обращений и оставляет гибкость для сложных случаев. Проверять оба режима стоит на одном и том же наборе GOLD, чтобы сравнение было честным.
MCP: протокол, чтобы давать модели инструменты
До сих пор наш поиск жил внутри одного скрипта: функция hybrid_search вызывалась напрямую из кода, который тут же готовил промпт и отправлял его модели. Пока приложение одно, это работает. Но как только источников знаний становится несколько, а клиентов больше одного, каждая новая связка модель + база требует отдельной интеграции. MCP решает именно эту проблему.
Что такое MCP
Model Context Protocol, или MCP, это открытый протокол обмена между двумя сторонами: клиентом и сервером. Клиент это хост-приложение, внутри которого работает LLM: чат, IDE, агентный раннер. Сервер это отдельный процесс, который предоставляет клиенту три вида возможностей:
- tools: функции, которые модель может вызвать, например
searchилиget_document; - resources: данные только для чтения, которые клиент подгружает в контекст, например файл регламента или запись из справочника;
- prompts: заранее заготовленные шаблоны подсказок, которые сервер отдаёт клиенту.
Суть протокола в том, что он описывает не конкретную библиотеку, а контракт: как стороны договариваются о возможностях и как передают вызовы. Внутри сервера может быть что угодно: наша гибридная выдача, SQL-база, файловая система, вызов внешнего API.
Зачем это нужно
Без общего протокола каждая пара приложение + источник данных пишет свою интеграцию. Чат с базой регламентов, IDE с той же базой и внутренний агент снова и снова повторяют один и тот же код, только в разных обёртках. С MCP источник данных описывается один раз как сервер, и любой совместимый клиент подключается к нему штатно. Выигрыш не в том, что исчезает код, а в том, что он перестаёт дублироваться: интеграция пишется на стороне сервера, а не на стороне каждого приложения.
Как это связано с RAG
Для нас MCP это естественная упаковка того, что уже построено в модулях 04 и 06. База знаний превращается в MCP-сервер с двумя инструментами:
search(query, k): гибридный поиск, внутри вызываетсяrrf_fuse(bm25_search(query), dense_search(query));get_document(doc_id): полный текст документа, чтобы модель могла дочитать найденный фрагмент.
Дальше клиент получает поиск по регламентам без переделки: не нужно встраивать наш код в приложение, достаточно подключиться к серверу. Золотой набор GOLD при этом остаётся инструментом контроля: если после правок в сервере метрики просели, это видно на том же раннере из модуля 06.
Транспорты
Протокол не привязан к способу передачи сообщений. Для локальных серверов используется stdio: клиент сам запускает сервер как дочерний процесс и общается с ним через стандартный ввод и вывод. Это удобно для оффлайн-работы: ничего не нужно поднимать в сети, сервер живёт ровно столько, сколько живёт клиент. Для удалённых серверов используется HTTP: сервер развёрнут отдельно, а клиенты подключаются к нему по сети.
Как выглядит вызов
Последовательность всегда одна и та же. Клиент открывает сессию и инициализирует её, затем запрашивает список инструментов. Модель, увидев описания, выбирает подходящий инструмент и формирует аргументы. Клиент выполняет call_tool и возвращает результат обратно модели, которая продолжает рассуждение уже с данными.
Минимальный сервер на MCPServer:
# server.py: MCP-сервер базы знаний регламентов
from mcp.server import MCPServer

mcp = MCPServer("knowledge-base")

@mcp.tool()
def search(query: str, k: int = 5) -> list[str]:
    """Гибридный поиск по корпусу регламентов."""
    # здесь вызывается rrf_fuse(bm25_search(query), dense_search(query))
    # для продакшена замените hash-эмбеддер на живой
    return hybrid_search(query, k=k)

@mcp.tool()
def get_document(doc_id: str) -> str:
    """Возвращает полный текст документа по идентификатору."""
    # .get вместо обращения по индексу: несуществующий id не должен ронять сервер
    return DOCS.get(doc_id, "Документ не найден.")
import ast
import operator

# Строгий калькулятор: только числа и четыре операции, никакой оценки строк.
# eval здесь не подходит: даже с пустыми __builtins__ выражение через
# ().__class__.__bases__[0].__subclasses__() добирается до os и выполняет код.
_ALLOWED_BINOPS = {
    ast.Add: operator.add,
    ast.Sub: operator.sub,
    ast.Mult: operator.mul,
    ast.Div: operator.truediv,
}

def safe_calculate(expression: str) -> str:
    tree = ast.parse(expression, mode="eval")

    def visit(node):
        if isinstance(node, ast.Expression):
            return visit(node.body)
        if isinstance(node, ast.Constant) and isinstance(node.value, (int, float)):
            return node.value
        if isinstance(node, ast.BinOp) and type(node.op) in _ALLOWED_BINOPS:
            return _ALLOWED_BINOPS[type(node.op)](visit(node.left), visit(node.right))
        if isinstance(node, ast.UnaryOp) and isinstance(node.op, ast.USub):
            return -visit(node.operand)
        raise ValueError(f"не поддерживается: {type(node).__name__}")

    return str(visit(tree))
Проверка на практике: safe_calculate("2 + 2 * 3") вернёт 8, а safe_calculate("().__class__.__bases__[0].__subclasses__()") упадёт с ValueError, хотя eval с пустыми __builtins__ такой вызов выполняет. Запусти оба варианта и держи второй как тест на регрессию: инструменты для модели должны быть не удобными, а узкими.
И ещё одна развилка, которая в боевых системах решается до того, как в дело пойдёт агент: классификация запроса и маршрутизация. Вопрос вида INT-6515 не требует агента: он по форме сам говорит, что нужно искать в трекере, и его можно направить туда за миллисекунды регуляркой. Практика показывает то, что интуиция подсказывает не сразу: keyword-классификатор по ключевым словам и шаблонам обгоняет LLM-классификатор и по цене на три порядка, и по точности на типовых классах, потому что LLM тратит контекст на рассуждение о вопросе, ответ на котором лежит в его форме. Дешёвый роутинг решает заранее: какой коннектор спросить, нужен ли веб, включать ли тяжёлый агентный цикл. Агент включается там, где класс не распознан или вопрос реально требует цепочки решений. Замеряй оба варианта на своих запросах до того, как платить за LLM в горячем пути: класс «точный идентификатор» для keyword-классификатора это ловушка наоборот, он обычно самый лёгкий.
Клиент, который подключается по stdio:
# client.py: подключение к серверу через stdio
import asyncio
from mcp import ClientSession
from mcp.client.stdio import StdioServerParameters, stdio_client

async def main() -> None:
    params = StdioServerParameters(command="python", args=["server.py"])
    async with stdio_client(params) as (read, write):
        async with ClientSession(read, write) as session:
            await session.initialize()
            # получаем список инструментов и их описания
            tools = await session.list_tools()
            print([t.name for t in tools.tools])
            # имитируем выбор модели и выполняем вызов
            result = await session.call_tool("search", {"query": "отпуск", "k": 3})
            print(result.content)

asyncio.run(main())
Практический вывод: MCP не заменяет поиск и не улучшает качество выдачи сам по себе. Он меняет точку сборки: retrieval становится сервисом с явным контрактом, а приложение перестаёт знать, как устроен индекс. Дальше можно добавлять инструменты, не трогая клиентов, и проверять каждое изменение через GOLD.
Что ты построишь
К концу этого раздела у тебя будет работающий MCP-сервер базы знаний и клиент, который с ним разговаривает.
Сервер строится на официальном python-SDK: пакет называется mcp и ставится командой pip install "mcp>=2". Больше никаких зависимостей не нужно. Внутри сервера живёт тот же гибридный поиск, что ты собрал в модуле 04: bm25_search, dense_search и rrf_fuse. Вся эта логика остаётся на чистом stdlib, поэтому поиск работает оффлайн, без сети и без внешних сервисов. Пакет mcp нужен только для транспортного слоя, то есть для самого протокола.
Ты откроешь наружу два инструмента. Первый, search(query), принимает строку запроса и возвращает топ-3 документа в компактном виде: идентификатор, заголовок и фрагмент текста. Второй, get_document(doc_id), отдаёт полный текст регламента по идентификатору или честно сообщает, что такого документа нет. Сервер запускается по stdio, то есть общается с клиентом через стандартные потоки ввода и вывода, а не через сетевой порт.
Дальше ты напишешь клиент. Он поднимает kb_server.py как подпроцесс, открывает сессию, получает список инструментов, вызывает search с реальным запросом и печатает ответ в консоль. Ты увидишь полный цикл: запрос, маршрутизация вызова, гибридный поиск и текстовый результат. Этот же сервер потом сможет подключить любой MCP-совместимый клиент.
Практика: MCP-сервер базы знаний
Сервер строится вокруг класса MCPServer из пакета mcp. Ты создаёшь объект mcp = MCPServer("kb"), а дальше просто помечаешь функции декоратором @mcp.tool(). SDK сам читает сигнатуру функции, собирает схему аргументов и регистрирует инструмент под именем функции. Руками описывать протокол не нужно. В старых туториалах класс назывался FastMCP и жил в mcp.server.fastmcp: во второй версии SDK его переименовали в MCPServer, а старый импорт удалили. Если старый код падает с No module named 'mcp.server.fastmcp', это оно: либо переименуй класс, либо закрепи mcp<2 до поры, но для нового кода пиши сразу на MCPServer.
Два правила делают инструмент удобным для модели. Первое: явная типизация аргументов. Если написано query: str, схема говорит модели, что нужна строка, и клиент может проверить вызов до отправки. Второе: docstring. SDK берёт текст docstring и отдаёт его как описание инструмента, ровно то, что модель видит в list_tools и по чему решает, когда звать search, а когда get_document. Поэтому docstring пишется для модели, а не для тебя: коротко, что делает инструмент и что возвращает. Расплывчатое описание приводит к неверным вызовам.
Функции инструментов объявлены как async def. Это требование асинхронного рантайма SDK: внутри нет сетевых запросов, но SDK всё равно ждёт корутину. Сам поиск остаётся синхронным и быстрым, поэтому ничего не блокируется.
В конце файла вызывается mcp.run(). Без аргументов это stdio-транспорт: сервер читает сообщения из stdin и пишет ответы в stdout. Отсюда важное правило: не печатай в stdout ничего лишнего через print, иначе сломаешь поток сообщений. Отладочные сообщения отправляй в stderr.
Клиент запускает сервер так же, как ты запускаешь обычный скрипт. StdioServerParameters описывает команду и аргументы, stdio_client поднимает подпроцесс и отдаёт пару потоков чтения и записи, а ClientSession поверх них ведёт рукопожатие. После initialize клиент знает возможности сервера, list_tools показывает инструменты, а call_tool("search", {"query": ...}) выполняет вызов. Ответ приходит списком блоков контента, обычно это текстовые блоки, которые остаётся напечатать.
Обрати внимание: клиент ничего не знает про bm25 и rrf. Он видит только имена инструментов и их описания. В этом и смысл MCP: логика поиска спрятана за стабильным интерфейсом, а заменить stdlib-эмбеддер на живой можно, не трогая клиент.
# файл: kb_server.py
# MCP-сервер базы знаний: гибридный поиск на stdlib, транспорт stdio
import math
import re
from collections import Counter

from mcp.server import MCPServer

# Корпус служебных регламентов
DOCS = [
    {
        "id": "REG-2024-101",
        "title": "Регламент приёма заявок",
        "text": "Заявка регистрируется в течение одного рабочего дня. "
                "Ответственный сотрудник проверяет полноту данных и присваивает "
                "заявке статус «в работе». Неполные заявки возвращаются автору "
                "с перечнем недостающих полей.",
    },
    {
        "id": "REG-2024-104",
        "title": "Порядок обработки обращений",
        "text": "Обращения делятся на срочные и обычные. Срочные обрабатываются "
                "в день поступления, обычные в течение трёх рабочих дней. "
                "Каждое обращение получает номер и попадает в журнал учёта.",
    },
    {
        "id": "REG-2024-112",
        "title": "Согласование договоров",
        "text": "Проект договора направляется на согласование юридической службе "
                "и финансовому отделу. Срок согласования не превышает пяти рабочих "
                "дней. Замечания фиксируются в листе согласования.",
    },
    {
        "id": "REG-2024-118",
        "title": "Резервное копирование и восстановление данных",
        "text": "Резервные копии служебных систем создаются ежедневно. Полная "
                "копия формируется раз в неделю. Восстановление данных выполняется "
                "по заявке администратора, проверка целостности копии обязательна "
                "перед восстановлением.",
    },
    {
        "id": "REG-2024-121",
        "title": "Доступ к служебной информации",
        "text": "Доступ выдаётся по принципу минимальных прав. Заявка на доступ "
                "согласуется с руководителем подразделения. Права пересматриваются "
                "не реже одного раза в год и отзываются при увольнении сотрудника.",
    },
    {
        "id": "REG-2024-130",
        "title": "Передача документов в архив",
        "text": "Документы передаются в архив по описи. Опись подписывает "
                "ответственный за делопроизводство. Документы с истёкшим сроком "
                "хранения уничтожаются по акту в установленном порядке.",
    },
]

def tokenize(text):
    """Простая токенизация: нижний регистр, буквы и цифры."""
    return re.findall(r"[a-zа-яё0-9]+", text.lower())

def embed(text, dim=64):
    # для продакшена замените на живой эмбеддер
    vec = [0.0] * dim
    for tok in tokenize(text):
        h = 0
        for ch in tok:
            h = (h * 31 + ord(ch)) % 1000003
        vec[h % dim] += 1.0
    norm = math.sqrt(sum(v * v for v in vec)) or 1.0
    return [v / norm for v in vec]

def bm25_search(query, docs, top_k=5, k1=1.5, b=0.75):
    """Разреженный поиск BM25 на stdlib."""
    corpus = {d["id"]: tokenize(d["title"] + " " + d["text"]) for d in docs}
    n = len(docs)
    avgdl = sum(len(t) for t in corpus.values()) / max(n, 1)

    df = Counter()
    for toks in corpus.values():
        for term in set(toks):
            df[term] += 1

    q_terms = tokenize(query)
    scores = {}
    for d in docs:
        toks = corpus[d["id"]]
        tf = Counter(toks)
        dl = len(toks)
        score = 0.0
        for term in q_terms:
            if tf[term] == 0:
                continue
            idf = math.log(1 + (n - df[term] + 0.5) / (df[term] + 0.5))
            denom = tf[term] + k1 * (1 - b + b * dl / avgdl)
            score += idf * tf[term] * (k1 + 1) / denom
        scores[d["id"]] = score

    ranked = sorted(scores.items(), key=lambda kv: kv[1], reverse=True)
    return [doc_id for doc_id, s in ranked[:top_k] if s > 0]

def dense_search(query, docs, top_k=5):
    """Плотный поиск по косинусу на hash-эмбеддере."""
    q = embed(query)
    scored = []
    for d in docs:
        v = embed(d["title"] + " " + d["text"])
        sim = sum(a * c for a, c in zip(q, v))
        scored.append((d["id"], sim))
    scored.sort(key=lambda kv: kv[1], reverse=True)
    return [doc_id for doc_id, _ in scored[:top_k]]

def rrf_fuse(rankings, k=60):
    """Reciprocal Rank Fusion: сливаем несколько ранжирований в одно."""
    scores = {}
    for ranking in rankings:
        for pos, doc_id in enumerate(ranking, start=1):
            scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k + pos)
    return [doc_id for doc_id, _ in sorted(scores.items(), key=lambda kv: kv[1], reverse=True)]

def hybrid_search(query, top_k=3):
    """Гибрид: BM25 плюс плотный поиск, слияние через RRF."""
    sparse = bm25_search(query, DOCS, top_k=5)
    dense = dense_search(query, DOCS, top_k=5)
    return rrf_fuse([sparse, dense])[:top_k]

# Создаём сервер; имя видно клиенту в метаданных
mcp = MCPServer("kb")

@mcp.tool()
async def search(query: str) -> str:
    """Гибридный поиск по базе регламентов.

    Возвращает топ-3 документа в формате «id | title | фрагмент текста».
    """
    doc_ids = hybrid_search(query)
    if not doc_ids:
        return "Ничего не найдено."

    by_id = {d["id"]: d for d in DOCS}
    lines = []
    for doc_id in doc_ids:
        d = by_id[doc_id]
        snippet = d["text"][:80].replace("\n", " ")
        lines.append(f"{d['id']} | {d['title']} | {snippet}")
    return "\n".join(lines)

@mcp.tool()
async def get_document(doc_id: str) -> str:
    """Вернуть полный текст регламента по идентификатору, например REG-2024-118."""
    for d in DOCS:
        if d["id"] == doc_id.strip():
            return f"{d['id']} | {d['title']}\n\n{d['text']}"
    return f"Документ {doc_id} не найден."

if __name__ == "__main__":
    # stdio-транспорт по умолчанию; ничего лишнего в stdout не пишем
    mcp.run()
# файл: kb_client.py
# MCP-клиент: запускает kb_server.py по stdio и вызывает инструменты
import asyncio
import sys

from mcp import ClientSession, StdioServerParameters
from mcp.client.stdio import stdio_client

async def main() -> None:
    # Описываем, как поднять сервер: тот же интерпретатор плюс путь к файлу
    params = StdioServerParameters(
        command=sys.executable,
        args=["kb_server.py"],
    )

    async with stdio_client(params) as (read, write):
        async with ClientSession(read, write) as session:
            # Рукопожатие: обмен возможностями
            await session.initialize()

            # Смотрим, какие инструменты сервер объявил
            tools = await session.list_tools()
            print("Доступные инструменты:")
            for tool in tools.tools:
                print(f"- {tool.name}: {tool.description}")

            # Вызываем поиск и печатаем текстовые блоки ответа
            result = await session.call_tool(
                "search", {"query": "резервное копирование данных"}
            )
            print("\nРезультат search:")
            for block in result.content:
                text = getattr(block, "text", None)
                if text:
                    print(text)

if __name__ == "__main__":
    asyncio.run(main())
Лаба: подними сервер и дёрни инструмент
В этой лабе ты поднимаешь MCP-сервер поверх гибридного поиска из модуля 04 и вызываешь его инструменты из клиента. Сервер и клиент лежат в двух файлах, kb_server.py и kb_client.py; оба запускаются оффлайн, на stdlib и официальном python-SDK mcp.
Шаг 1. Установка и первый запуск.
pip install "mcp>=2"
Сохраняй kb_server.py и kb_client.py из практики. Сервер создаёт MCPServer("kb"), регистрирует search(query: str) и get_document(doc_id: str), а внутри вызывает rrf_fuse(bm25_search(query), dense_search(query)) по корпусу DOCS. Клиент поднимает процесс сервера через stdio_client, открывает ClientSession, делает initialize() и list_tools().
# kb_client.py, фрагмент
from mcp import ClientSession
from mcp.client.stdio import stdio_client

# server_params из практики: команда запуска kb_server.py по stdio
async with stdio_client(server_params) as (read, write):
    async with ClientSession(read, write) as session:
        await session.initialize()
        tools = await session.list_tools()
        print([t.name for t in tools.tools])  # ожидаем search и get_document
        result = await session.call_tool(
            "search", {"query": "порядок согласования отпуска"}
        )
        print(result.content[0].text)
Запусти python kb_client.py. В выводе должно быть два имени инструментов, а search возвращает текст документа, релевантного запросу. Если список пуст или процесс падает, проверь, что сервер импортирует DOCS и rrf_fuse без ошибок и не печатает посторонние сообщения в stdout: stdout занят протоколом stdio.
Шаг 2. Свой документ и свой вопрос.
Добавь в DOCS запись с новыми id, title и text, например регламент про выдачу пропусков. Затем в клиенте замени запрос на свой вопрос по этому тексту и перезапусти пару. Критерий: search вернул именно новый документ, а не соседний по корпусу. Помни, что embed в модуле 04 это hash-эмбеддер: формулируй вопрос словами из документа, иначе dense-часть даст слабое совпадение, и результат будет держаться только на BM25.
Шаг 3. Опционально: третий инструмент. Добавь в сервер инструмент без аргументов:
@mcp.tool()
def list_documents() -> list[dict]:
    """Возвращает id и title всех документов корпуса."""
    return [{"id": d["id"], "title": d["title"]} for d in DOCS]
В клиенте вызови call_tool("list_documents", {}) и напечатай результат. Проверь, что в списке есть и старые документы, и твой новый.
Критерий выполнения. Клиент вывел список из двух инструментов, search по новому вопросу вернул новый документ, а list_documents, если ты его добавил, вернул корректный список пар id и title.
Что меняется в агенте. В жёстком клиенте ты сам выбираешь функцию. В агенте выбор делает модель: она читает описания search, get_document и list_documents и решает, что вызвать. Вопрос по смыслу уходит в search, уточнение по найденному id в get_document, а обзор корпуса в list_documents. Поэтому описания инструментов становятся частью контракта: чем точнее указано, что принимает и возвращает каждый инструмент, тем меньше ошибочных вызовов.
Критерий готовности
- Объяснил разницу pipeline и агента: кто решает, искать ли вообще, и привёл по примеру в пользу каждого.
- Назвал цену агентности: циклы вызовов, непредсказуемая латентность, новые режимы отказа и способы их ограничить.
- Описал устройство MCP: tools, resources, transports и почему типизация и docstring это часть контракта с моделью.
- Поднял MCP-сервер с инструментами search и get_document поверх гибридного поиска из модуля 04.
- Подключился клиентом по stdio, получил список инструментов и осмысленный результат search.
Чеклист самопроверки
- Почему в pipeline ответ на «сколько будет 17 умножить на 23» всё равно уходит в поиск?
- Какие два поля описания инструмента видит модель и от чего зависит её выбор?
- Почему внутри MCP-сервера на stdio-транспорте нельзя печатать в stdout?
- Что делает клиент, если модель назвала несуществующий инструмент, и где это ограничивать?
- Когда агенту лучше остаться pipeline и каким прогоном на GOLD это проверить?
- Что придётся изменить в клиенте, если внутри сервера заменить hash-эмбеддер на живой?
Материалы главы: текст главы в репо · код · иллюстрации · подписка на обновления курса