Хаб курсов / Курс по RAG / глава 7
Модуль 07: паттерны HyDE, multi-hop, CRAG, GraphRAG
HyDE, multi-hop, Corrective RAG и GraphRAG по одной схеме: что решает, сколько стоит и когда паттерн оверкилл.
RAG Engineering. Модуль 07: Продвинутые паттерны: HyDE и когда паттерн оверкилл
Паттерны это не бесплатное улучшение
После модуля 05 у тебя есть рабочий baseline: BM25 и dense ищут кандидатов, RRF сливает списки, cross-encoder переранжирует верхушку. На этом фоне естественно хочется добавить «умные» паттерны: переформулировку запроса, несколько поисковых запросов, декомпозицию сложного вопроса, проверку ответа, повторный поиск после неудачной попытки. Каждый такой паттерн может дать прирост. Но каждый из них также меняет систему, и это изменение нужно считать целиком, а не только по красивой демонстрации.
У любого паттерна есть три вида цены. Первая: латентность. Дополнительный вызов LLM почти всегда последовательный, поэтому он добавляет задержку в среднем и в хвосте, причём хвост страдает сильнее: время паттерна прибавляется к каждому запросу. Пользователь замечает именно p95, а не медиану. Вторая: деньги. Переформулировка запроса, несколько вариантов поиска и проверка результата расходуют токены на каждом запросе, а не один раз при разработке. При росте трафика эта цена умножается. Третья: точки отказа. Упал один шаг, и весь пайплайн может упасть или выдать результат хуже baseline. Внешний сервис может ответить таймаутом, вернуть невалидный JSON, упереться в rate limit или просто изменить поведение. Если у паттерна нет fallback и деградации до базового гибрида, он превращает локальную ошибку в отказ всего поиска.
Поэтому правило курса звучит жёстко: паттерн принимается только если на твоём золотом наборе метрики выросли больше, чем цена. Это не формальность. «Больше, чем цена» означает, что прирост recall@k, MRR или nDCG устойчив, воспроизводим и оправдывает дополнительную латентность, расход токенов и усложнение эксплуатации.
Каждый паттерн в этом модуле разбирается по одной схеме. Первый пункт: что решает. Нужно назвать конкретный тип ошибок на GOLD, а не абстрактное «станет умнее». Паттерн должен адресовать именно этот сбой. Второй пункт: цена. В неё входят дополнительные вызовы LLM, токены, рост p95, новые зависимости, вероятность отказа и стоимость поддержки. Третий пункт: когда НЕ надо. Паттерн не нужен, если baseline уже хорошо закрывает этот тип запросов, если бюджет латентности исчерпан, если нет надёжного fallback, если прирост получен только на демо-вопросе или если паттерн дублирует то, что уже делает cross-encoder.
Самая типичная ловушка выглядит так. Инженер берёт один показательный вопрос, добавляет переформулировку, видит красивый ответ и делает вывод, что паттерн работает. На среднем по набору прирост исчезает, а часть запросов начинает деградировать. Демо-вопрос не является доказательством. Доказательством является сравнение baseline и кандидата на одном и том же GOLD, с одним и тем же k, одним и тем же пулом кандидатов и одним и тем же реранкером.
Именно поэтому каждый паттерн этого модуля оценивается eval-раннером из модуля 06. Процедура фиксирована: сначала замерь baseline, затем включи паттерн, затем сравни recall@k, MRR и nDCG в среднем и по отдельным запросам. Смотри, на каких вопросах стало лучше, на каких хуже, сколько выросла латентность и сколько токенов добавилось. Отдельно проверь поведение при ошибке внешнего вызова: пайплайн должен уметь вернуться к базовому гибриду, а не падать целиком. Если прирост нестабилен или цена превышает выигрыш, паттерн отклоняется.
Паттерн не является признаком зрелой системы. Зрелость в том, чтобы для каждого усложнения иметь измеримую причину, известную цену и понятный план отказа. Если этой причины нет, правильное решение звучит скучно: оставить baseline.
HyDE: гипотетический документ вместо запроса
HyDE это гипотетический документ вместо запроса (Gao и др., 2022). Проблема начинается с несовпадения формы запроса и формы документа. Пользователь пишет коротко: «почему задача падает после ретрая», «как откатить миграцию», «где задаётся таймаут». Документы в индексе длинные, с другим словарём, другим порядком мыслей и большим количеством служебных деталей. Эмбеддинг короткого запроса может попасть в область векторного пространства, которая плохо пересекается с областью полезных документов.
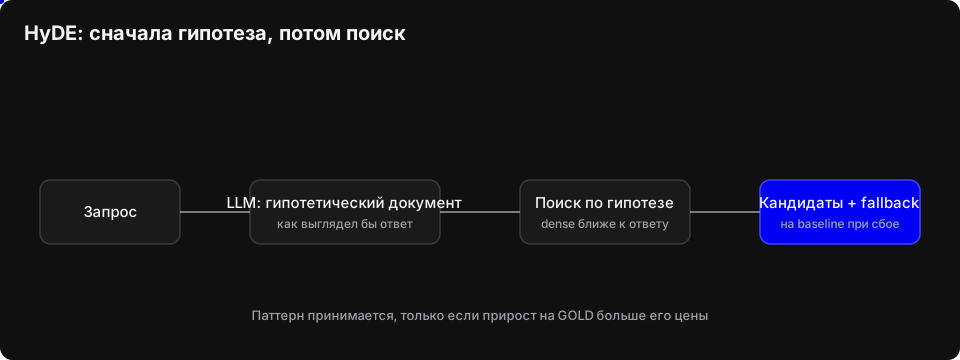
HyDE предлагает изменить не индекс, а представление запроса. Сначала LLM просят написать гипотетический документ, который мог бы отвечать на запрос. Это не ответ пользователю и не источник фактов. Это правдоподобный фрагмент текста, близкий по форме к реальным документам. Затем ты считаешь эмбеддинг этого фрагмента и ищешь по нему dense-поиском. Исходный запрос при этом не выбрасывай: его полезно добавить вторым списком в RRF, чтобы сохранить точные слова, артикулы и названия функций. Гипотетический документ никогда не показывай пользователю как ответ и не считай его доказательством.
Поток запроса выглядит так:
запрос -> LLM -> гипотетический документ -> embed -> dense_search -> RRF с BM25 по исходному запросу -> rerank -> top-k
Мини-пример на Python:
def hyde_search(query: str, dim: int = 64, k: int = 10):
    # Просим LLM написать правдоподобный фрагмент документа, а не готовый ответ.
    hypothetical = llm(
        "Напиши короткий фрагмент документа, который отвечает на запрос. "
        "Не добавляй ссылки и не гарантируй факты.\n"
        f"Запрос: {query}"
    )

    # Ищем по эмбеддингу гипотетического документа.
    hyde_hits = dense_search(embed(hypothetical, dim=dim), k=k)

    # Исходный запрос сохраняем отдельным списком: точные слова всё ещё важны.
    original_hits = bm25_search(query, k=k)

    # Слияние и реранк не меняются: HyDE подменяет только один источник кандидатов.
    fused = rrf_fuse([hyde_hits, original_hits])
    return rerank(query, fused)[:k]
Здесь важно, что HyDE не заменяет весь поисковый конвейер. Он добавляет ещё один способ получить кандидатов. Гибрид BM25+dense+RRF и cross-encoder реранкер остаются на месте. Если генерация недоступна или вернула пустой текст, разумно откатиться к обычному гибридному поиску, а не ронять весь запрос.
Цена у паттерна понятная. На каждый запрос добавляется вызов LLM: это латентность и деньги. Появляется зависимость от качества генерации. Если LLM пишет слишком общий текст, эмбеддинг уходит в «среднюю» область и приносит бесполезные документы. Если она выдумывает конкретные идентификаторы, поиск может зацепиться за похожие, но неверные сущности. Кэширование ответов LLM снижает цену повторов, но не отменяет главного: у паттерна появилась ещё одна точка отказа.
Когда HyDE не надо применять. Первый случай: запросы с точными идентификаторами. Артикулы, коды ошибок, имена функций, номера тикетов и версии конфигурации это работа BM25. Гипотетический документ здесь скорее вреден: LLM может написать правдоподобный, но несуществующий код, и dense-поиск начнёт искать по этому шуму. Второй случай: dense-поиск уже хорошо работает на твоих запросах. Тогда сначала докажи пользу HyDE на золотом наборе, и только потом добавляй его «для современности». Третий случай: жёсткий бюджет латентности, нет доступной LLM или запрос уже длинный и похож на документ. Четвёртый случай: нет eval-раннера, который умеет сравнивать варианты на GOLD.
Проверка должна быть честной. Сначала зафиксируй базовую линию: гибридный поиск плюс реранкер. Затем включи HyDE и сравни на одном и том же GOLD по recall@k, MRR и nDCG. Среднее значение может скрыть регрессию, поэтому полезно смотреть срезы: концептуальные вопросы отдельно, запросы с идентификаторами отдельно. Тогда правильное решение не «включить везде», а маршрутизация: HyDE только для запросов без идентификаторов, BM25 для точных сущностей, базовый гибрид для остальных.
Цена и эффект
| паттерн | что решает | цена | когда НЕ надо |
|---|---|---|---|
| HyDE | Сближает короткий запрос с пространством длинных документов, помогает при словарном разрыве | Дополнительный вызов LLM на запрос, задержка, деньги, зависимость от качества генерации | Запросы с артикулами, кодами ошибок, именами функций; жёсткий бюджет латентности; уже хороший dense-поиск без доказанного прироста |
| multi-hop | Вопросы, где нужно собрать факты из нескольких документов и связать их | Несколько шагов поиска и генерации, больше латентности и точек отказа | Одиночный факт, простой lookup, запрос с точным идентификатором |
| Corrective RAG | Проверяет релевантность найденного и при необходимости переформулирует запрос или повторяет поиск | Дополнительные вызовы LLM и повторный поиск, усложнение цикла | Чистый корпус, стабильные запросы, строгий бюджет латентности |
| GraphRAG | Вопросы про связи сущностей и обзорные ответы по корпусу | Построение и поддержка графа, дорогая индексация, сложная эксплуатация | Простой локальный факт, отсутствие выраженных связей между сущностями |
Multi-hop, Corrective RAG, GraphRAG
К модулю 06 у тебя есть рабочая база: золотой набор GOLD, гибридный поиск BM25 + dense + RRF, cross-encoder реранкер и eval-раннер с recall@k, MRR и nDCG. Дальше начинается соблазн добавить «умные» паттерны. Три из них разобраны ниже по одной схеме: что решает, цена, когда НЕ надо. Рамка та же: паттерн добавляет латентность и точки отказа, поэтому принимается только после проверки на GOLD, а не по вере.
Multi-hop
Что решает. Вопрос требует цепочки фактов из разных документов: сначала найти A, затем из ответа вывести B и подтвердить B в другом месте. Одношаговый retrieval такие вопросы проваливает, потому что запрос описывает только первый шаг, а второй факт лежит в документе, который не попал в top-k.
Реализация: итеративный поиск, где каждый hop уточняет запрос по уже найденному. Цикл ограничен, и на каждом шаге проверяется, появился ли новый релевантный чанк.
def multi_hop_answer(question, max_hops=3):
    context, seen, query = [], set(), question
    for _ in range(max_hops):
        docs = retrieve(query)  # гибрид BM25 + dense + RRF + реранк
        fresh = [d for d in docs if d.id not in seen]
        if not fresh:
            break  # новых фактов нет, продолжать бессмысленно
        context += fresh
        seen.update(d.id for d in fresh)
        query = make_followup(question, context)  # следующий подвопрос
        if is_answerable(question, context):
            break
    return generate(question, context)
Цена. Несколько циклов retrieval-generation. Латентность растёт кратно числу hop: каждый hop это поиск, реранк и вызов LLM для уточнения. Плюс риск ухода не туда: модель строит следующий запрос по неверному промежуточному ответу, и дальнейшие hop закрепляют ошибку.
Когда НЕ надо. Однофактные вопросы и вопросы по одному документу. Если ответ лежит в одном чанке, multi-hop добавляет циклы без пользы. Проверка простая: на GOLD считается доля вопросов, где первый retrieval уже содержит ответ. Если доля высокая, паттерн не нужен.
Corrective RAG
Что решает. Оценка качества найденного контекста до генерации. Если контекст плохой, стратегия переключается: перезапрос, web-поиск или честный отказ. Это защита от уверенного ответа по мусору.
def corrective_answer(question):
    docs = retrieve(question)
    verdict = judge_context(question, docs)  # good / retry / reject
    if verdict == "good":
        return generate(question, docs)
    if verdict == "retry":
        return generate(question, retrieve(rewrite(question)))
    return "В корпусе нет надежных данных для ответа."  # отказ лучше галлюцинации
Цена. Судья-вызов LLM на каждый запрос, даже когда поиск сработал. Это дополнительная латентность и стоимость. Главный риск: ложные отказы. Судья ошибается на пограничных чанках, и система отказывает там, где ответ был. Порог надо калибровать на GOLD, а не назначать на глаз.
Когда НЕ надо. Корпус стабильный и поиск надёжно попадает. Если recall@k и MRR на GOLD высокие и не проседают на новых вопросах, corrective слой добавляет вызов судьи почти без выигрыша. Сначала почини retrieval, потом добавляй коррекцию.
GraphRAG
Что решает. Вопросы, где важны связи между сущностями и агрегаты по ним: кто с кем связан, какие документы образуют сообщество, что общего у группы. Чанки сами по себе такие связи не видят, граф делает их явными.
def graph_retrieve(question, graph, chunks):
    seeds = [e for e in extract_entities(question) if e in graph]
    if not seeds:
        return retrieve(question)  # граф не помог, откат к гибриду
    related = traverse(graph, seeds, depth=2)  # обход по связям
    return [chunks[i] for i in collect_chunk_ids(graph, related)]
Цена. Построение и сопровождение графа: извлечение сущностей, разрешение дублей, переиндексация при обновлении корпуса. Это отдельная инфраструктура и отдельный контур ошибок.
Когда НЕ надо. Плоские FAQ-корпуса без связей между документами. Если каждый ответ живет в одном чанке, граф только добавляет стоимость. На GOLD это видно по составу вопросов: если среди них нет агрегатных и вопросов про связи, GraphRAG нечего проверять.
Стек, если решаешься. Прототип собирается на NetworkX: граф в памяти, извлечение сущностей любым способом хоть по словарю, обход двумя строчками, и этого достаточно, чтобы проверить на GOLD, помогает ли граф твоему корпусу вообще. Для продакшена с ростом корпуса смотри на Neo4j: у него календарные релизы (2026.10 на октябрь 2026) и официальный тулкит neo4j-graphrag-python, который закрывает построение графа из текста и retrieval по нему. Лёгкая альтернатива между этими полюсами: LightRAG, открытый фреймворк, который сам строит граф из корпуса и отдаёт retrieval-эндпоинт; референсная реализация от Microsoft жива, но коммитит пару человек, это скорее спецификация подхода, чем сервис для боя. Если граф нужен live и небольшой, смотри на Memgraph и FalkorDB (шестая мажорная версия на октябрь 2026, Graphiti с ним совместим). И один урок про зависимости, который этот стек иллюстрирует лучше любых слов: Kuzu, embedded графовая база, которую в 2024-2025 рекомендовали в десятках туториалов, закрылась в 2026, репозиторий заархивирован. Выбирая графовый движок, проверяй, кто и как часто его релизит, а не только статью, в которой он понравился.
Как это проверять на GOLD
Добавь в GOLD отдельные срезы: вопросы-цепочки для multi-hop, вопросы с заведомо плохим контекстом для corrective, агрегатные вопросы для GraphRAG. Для каждого паттерна сравни с базой (гибрид + реранк) по recall@k, MRR и nDCG, а также по латентности и числу вызовов LLM. Паттерн проходит, только если выигрыш на своем срезе перекрывает цену. Иначе он отправляется в архив, и это нормальный результат.
Вывод
Multi-hop, Corrective RAG и GraphRAG решают реальные классы задач, но каждый добавляет латентность и точки отказа. В типичном проекте большинство таких паттернов оказывается оверкиллом. Это не провал, а результат честной проверки: база с гибридным поиском и реранком закрывает большинство вопросов, а сложные паттерны включаются точечно, под подтвержденный срез GOLD.
Что ты построишь
В этом разделе ты добавишь HyDE к гибридному поиску из модуля 04 и проверишь его на золотом наборе GOLD, не выходя в сеть. Идея HyDE проста: вместо поиска по исходному вопросу ты просишь LLM написать гипотетический документ-ответ и ищешь по его эмбеддингу, потому что такой текст лексически ближе к целевым документам, чем короткий вопрос.
Живой LLM в оффлайн-упражнении недоступен, поэтому ты реализуешь детерминированную заглушку make_hyde_stub(query). Она собирает псевдодокумент из шаблонных фраз и токенов запроса, разворачивая вопрос в утвердительные предложения в стиле регламента. Это не генерация, но форма трюка сохраняется, и весь конвейер запускается без API, ключей и сетевых задержек.
Дальше HyDE встраивается в конвейер: вектор гипотетического документа комбинируется с вектором исходного запроса, dense-поиск идёт по этому объединённому вектору, BM25 остаётся по исходному запросу, а два списка сливаются через rrf_fuse. Скрипт прогоняет GOLD, считает recall@5 для baseline rrf и для варианта rrf+HyDE, печатает результат по каждому вопросу и в среднем, затем выносит вердикт: выросла метрика или нет.
Смысл упражнения в другом: получить честный ответ, помогает ли HyDE на твоих данных, вместо того чтобы просто прикрутить модный паттерн. HyDE добавляет латентность и точку отказа, поэтому он не включается по умолчанию, пока не покажет прирост на GOLD.
Практика: HyDE с оффлайн-заглушкой LLM
Начни с данных и метрики. Шесть документов регламентов режутся на предложения, и поиск идёт по чанкам, а не по документам целиком: на корпусе из шести документов recall@5 почти всегда равен единице и ничего не различает. Каждый чанк помнит свой doc_id, поэтому метрика остаётся документной: попадание засчитывается, если в топ-5 оказался хотя бы один чанк нужного регламента.
Токенизация намеренно простая: нижний регистр, регулярка по словам и грубое отсечение частых русских окончаний. Это не морфология, а дешёвый способ свести «журналы» и «журналов» к одной основе. BM25 считается по стандартной формуле с насыщением и нормализацией длины, dense-поиск работает на hash-эмбеддере embed(text, dim=64): каждый токен детерминированно раскладывается в измерение через md5, вектор нормализуется. В продакшене этот эмбеддер заменяется на живой, интерфейс функции при этом не меняется.
Заглушка hyde_expand, она же make_hyde_stub из первой части, собирает гипотетический документ из шаблонных фраз в стиле регламента и самого запроса: вопрос превращается в утверждение, к нему добавляются типовые формулировки про порядок, сроки и ответственное подразделение. hyde_search усредняет вектор гипотетического документа с вектором исходного запроса, ищет по нему dense-кандидатов, а BM25 оставляет по исходному запросу и сливает два списка через rrf_fuse.
main() прогоняет GOLD в двух режимах, печатает recall@5 по каждому вопросу, средние значения и вердикт. Обрати внимание на честность эксперимента: заглушка воспроизводит только форму трюка, реальный прирост даёт живая LLM, и только если он подтверждён на золотом наборе. В конце файла оставлен закомментированный каркас generate_hyde_via_api, который показывает, куда встроить настоящий вызов, но в этом скрипте не вызывается.
"""Сравнение baseline RRF и RRF+HyDE на золотом наборе. Только стандартная библиотека."""

import hashlib
import math
import re

# --- Корпус: 6 документов регламентов --------------------------------------
DOCS = {
    "REG-2024-101": (
        "Пароли сотрудников хранятся только в корпоративном менеджере секретов. "
        "Передавать пароли в мессенджерах запрещено. "
        "Плановая смена пароля выполняется каждые девяносто дней."
    ),
    "REG-2024-104": (
        "Резервные копии баз данных создаются ежедневно. "
        "Срок хранения резервной копии составляет тридцать дней. "
        "Восстановление из копии проверяется ежеквартально."
    ),
    "REG-2024-111": (
        "Об инциденте безопасности сотрудник сообщает в дежурную службу в течение часа. "
        "Дежурная служба регистрирует инцидент в журнале. "
        "Владелец системы уведомляется о каждом инциденте."
    ),
    "REG-2024-118": (
        "Журналы доступа к информационным системам хранятся двенадцать месяцев. "
        "Порядок хранения журналов утверждает руководитель службы безопасности. "
        "Выгрузка журналов выполняется по запросу аудитора."
    ),
    "REG-2024-123": (
        "Внешний подрядчик получает доступ только после подписания соглашения о конфиденциальности. "
        "Список систем для подрядчика согласует владелец системы. "
        "Доступ подрядчика пересматривается раз в полгода."
    ),
    "REG-2024-127": (
        "Каждый сотрудник проходит обучение по информационной безопасности при приёме на работу. "
        "Повторное обучение проводится ежегодно. "
        "Результаты обучения хранятся в кадровой системе."
    ),
}

# Золотой набор: вопрос и документ, который считаем релевантным
GOLD = [
    ("Сколько времени хранят журналы доступа к системам?", "REG-2024-118"),
    ("Что делать сотруднику при обнаружении инцидента?", "REG-2024-111"),
    ("Как часто проверяют восстановление резервных копий?", "REG-2024-104"),
    ("Какие условия доступа есть у внешних подрядчиков?", "REG-2024-123"),
    ("Где разрешено хранить пароли сотрудников?", "REG-2024-101"),
]

# --- Чанки: одно предложение = один чанк, помним родительский документ -----
CHUNKS = []  # (chunk_id, doc_id, text)
for doc_id, text in DOCS.items():
    sentences = [s.strip() for s in text.split(". ") if s.strip()]
    for i, sentence in enumerate(sentences):
        CHUNKS.append((f"{doc_id}#{i}", doc_id, sentence))

CHUNK_DOC = {cid: doc_id for cid, doc_id, _ in CHUNKS}
CHUNK_TEXT = {cid: text for cid, _, text in CHUNKS}

# --- Токенизация и очень грубый стеммер ------------------------------------
_SUFFIXES = (
    "тся", "ся", "иями", "ями", "ами", "ого", "его", "ому", "ему", "ыми", "ими",
    "ов", "ев", "ах", "ях", "ам", "ям", "ой", "ый", "ая", "ое", "ые", "ий",
    "ия", "ии", "ом", "ем", "ую", "юю", "а", "я", "ы", "и", "о", "е", "у", "ю", "ь",
)

def stem(token):
    for suffix in _SUFFIXES:
        if len(token) - len(suffix) >= 4 and token.endswith(suffix):
            return token[: -len(suffix)]
    return token

def tokenize(text):
    return [stem(t) for t in re.findall(r"[а-яёa-z0-9]+", text.lower())]

# --- BM25 -------------------------------------------------------------------
K1, B = 1.5, 0.75

CHUNK_TOKENS = {cid: tokenize(text) for cid, text in CHUNK_TEXT.items()}
AVG_LEN = sum(len(toks) for toks in CHUNK_TOKENS.values()) / len(CHUNK_TOKENS)

DF = {}
for toks in CHUNK_TOKENS.values():
    for token in set(toks):
        DF[token] = DF.get(token, 0) + 1
N = len(CHUNK_TOKENS)

def bm25_search(query, k=None):
    query_tokens = tokenize(query)
    scores = {}
    for cid, toks in CHUNK_TOKENS.items():
        tf = {}
        for token in toks:
            tf[token] = tf.get(token, 0) + 1
        score = 0.0
        for token in query_tokens:
            if token not in tf:
                continue
            idf = math.log(1 + (N - DF[token] + 0.5) / (DF[token] + 0.5))
            denom = tf[token] + K1 * (1 - B + B * len(toks) / AVG_LEN)
            score += idf * tf[token] * (K1 + 1) / denom
        scores[cid] = score
    ranked = [cid for cid, _ in sorted(scores.items(), key=lambda x: (-x[1], x[0]))]
    return ranked if k is None else ranked[:k]

# --- Dense: hash-эмбеддер ---------------------------------------------------
DIM = 64

def normalize(vec):
    norm = math.sqrt(sum(v * v for v in vec))
    return [v / norm for v in vec] if norm else vec

def embed(text, dim=DIM):
    # для продакшена замените на живой эмбеддер
    vec = [0.0] * dim
    for token in tokenize(text):
        h = int(hashlib.md5(token.encode("utf-8")).hexdigest(), 16)
        vec[h % dim] += 1.0
    return normalize(vec)

CHUNK_VECS = {cid: embed(text) for cid, text in CHUNK_TEXT.items()}

def dense_search(query, k=None, query_vec=None):
    qv = query_vec if query_vec is not None else embed(query)
    scores = {
        cid: sum(a * b for a, b in zip(qv, vec)) for cid, vec in CHUNK_VECS.items()
    }
    ranked = [cid for cid, _ in sorted(scores.items(), key=lambda x: (-x[1], x[0]))]
    return ranked if k is None else ranked[:k]

# --- Слияние RRF ------------------------------------------------------------
def rrf_fuse(rankings, k=60, top=5):
    scores = {}
    for ranking in rankings:
        for rank, cid in enumerate(ranking, start=1):
            scores[cid] = scores.get(cid, 0.0) + 1.0 / (k + rank)
    ranked = [cid for cid, _ in sorted(scores.items(), key=lambda x: (-x[1], x[0]))]
    return ranked[:top]

# --- HyDE с оффлайн-заглушкой ----------------------------------------------
# Шаблоны намеренно общие: заглушка имитирует только форму трюка (вопрос
# разворачивается в утверждения на языке предметной области), а не смысл.
# Реальный прирост даёт только живая LLM, и лишь если он виден на GOLD.
HYDE_TEMPLATES = (
    "Регламент устанавливает требования и порядок по вопросу: {q}.",
    "Ответственное подразделение утверждает правила, сроки хранения и порядок доступа.",
    "Документ описывает, кто, когда и в каком порядке выполняет требуемое действие.",
)

def hyde_expand(query):
    """Детерминированная заглушка вместо вызова LLM."""
    return " ".join(tpl.format(q=query) for tpl in HYDE_TEMPLATES)

def hyde_search(query, k=5):
    hypothetical = hyde_expand(query)
    # Гипотетический документ плюс исходный запрос: складываем и нормализуем
    combined = normalize(
        [a + b for a, b in zip(embed(hypothetical), embed(query))]
    )
    dense_ranking = dense_search(query, query_vec=combined)
    return rrf_fuse([bm25_search(query), dense_ranking], top=k)

# --- Метрика и main ---------------------------------------------------------
def recall_at_5(ranked_chunk_ids, gold_doc):
    return 1.0 if any(CHUNK_DOC[cid] == gold_doc for cid in ranked_chunk_ids) else 0.0

def main():
    base_scores, hyde_scores = [], []
    print("Сравнение на золотом наборе, метрика recall@5:")
    for question, gold_doc in GOLD:
        base_rank = rrf_fuse([bm25_search(question), dense_search(question)], top=5)
        hyde_rank = hyde_search(question, k=5)
        r_base = recall_at_5(base_rank, gold_doc)
        r_hyde = recall_at_5(hyde_rank, gold_doc)
        base_scores.append(r_base)
        hyde_scores.append(r_hyde)
        print(f"  rrf={r_base:.2f}  rrf+hyde={r_hyde:.2f}  | {question}")

    mean_base = sum(base_scores) / len(base_scores)
    mean_hyde = sum(hyde_scores) / len(hyde_scores)
    print(f"\nСредний recall@5: baseline={mean_base:.2f}, rrf+hyde={mean_hyde:.2f}")

    if mean_hyde > mean_base:
        print("Вердикт: метрика выросла, на этом наборе HyDE дал прирост.")
    elif mean_hyde < mean_base:
        print("Вердикт: метрика упала, HyDE навредил на этом наборе.")
    else:
        print("Вердикт: метрика не изменилась, прироста нет.")

# --- Опционально: настоящий HyDE через LLM (в этом скрипте не вызывается) ---
# Требует сетевого клиента и ключа, поэтому в оффлайн-скрипт не включён.
# Проверяйте прирост на GOLD так же, как для заглушки.
#
# def generate_hyde_via_api(query, model="<ваша модель>", api_key=None):
#     """Просит LLM написать гипотетический документ по запросу."""
#     prompt = (
#         "Напиши короткий фрагмент регламента, который отвечает на вопрос. "
#         f"Вопрос: {query}"
#     )
#     response = call_your_llm_provider(prompt, model=model, api_key=api_key)
#     return response.text

if __name__ == "__main__":
    main()
Лаба: паттерн против золотого набора
Цель лабы: проверить HyDE на своих данных и своих вопросах, а не на вере в то, что переписывание запроса помогает. HyDE работает так: LLM генерирует гипотетический ответ на вопрос, этот ответ кодируется эмбеддером, и полученный вектор идёт в dense-канал вместо вектора исходного запроса. BM25 продолжает работать по исходному тексту запроса, слияние делает rrf_fuse из модуля 04, реранкер из модуля 05 подключается поверх как обычно.
Шаг 1. Baseline. Берёшь свой корпус и золотой набор GOLD из модуля 03. Прогоняешь eval-раннер из модуля 06 на текущем гибриде без HyDE и сохраняешь метрики по каждому вопросу: recall@k, MRR, nDCG. Это твоя точка отсчёта, менять её по ходу лабы нельзя.
Шаг 2. HyDE с заглушкой. Сначала без LLM. Заглушка возвращает шаблонный псевдодокумент, собранный из текста запроса. Это контрольная сборка: она показывает, сколько даёт сама подмена канала, без генерации.
import re

# Заглушка HyDE: без LLM, только шаблонное расширение запроса
def hyde_stub(query: str) -> str:
    return (
        f"Справочная статья, отвечающая на вопрос: {query}. "
        "В ней описаны условия, порядок действий и ограничения."
    )

def hyde_dense_search(query: str, k: int = 10):
    # Гипотетический документ заменяет запрос в dense-канале
    hypo = hyde_stub(query)
    return dense_search(hypo, k=k)  # embed внутри dense_search, dim=64

def hyde_pipeline(query: str, k: int = 10):
    # BM25 по исходному запросу, dense по гипотетическому документу
    bm25_hits = bm25_search(query, k=k)
    dense_hits = hyde_dense_search(query, k=k)
    return rrf_fuse([bm25_hits, dense_hits], k=k)
Шаг 3. Живая LLM, опционально. Меняешь hyde_stub на вызов API с промптом вида «напиши короткий фрагмент документа, который отвечает на вопрос». Кэшируй ответы по тексту запроса, иначе замеры будут плавать между прогонами. Замеряй латентность каждого запроса отдельно: время LLM плюс время поиска.
Шаг 4. Таблица. Заполняешь по вопросам и средним:
| Вопрос | recall@k base | recall@k HyDE | MRR base | MRR HyDE | nDCG base | nDCG HyDE |
|---|---|---|---|---|---|---|
| Q1 | ||||||
| Q2 | ||||||
| Q3 | ||||||
| Q4 | ||||||
| Q5 | ||||||
| Среднее |
Шаг 5. Артикульный кейс. Отдельно прогоняешь запрос с точным идентификатором REG-2024-118. Здесь HyDE почти наверняка проиграет: генератор перепишет запрос в общие слова и потеряет строку, по которой BM25 находил документ точно. Проверь это на своём корпусе и зафиксируй, что произошло с позицией нужного чанка.
EXACT_ID = re.compile(r"\b[A-Z]{2,}-\d{4}-\d{3}\b")

def route(query: str):
    # Точные идентификаторы HyDE не переписываем
    if EXACT_ID.search(query):
        return hybrid_pipeline  # гибрид из модуля 04
    return hyde_pipeline
Шаг 6. Вердикт. Три строки, без вкусовых оценок. Пример формата: «Прирост есть на вопросах типа X, в среднем по recall@k и MRR, на артикулах прироста нет и есть просадка». «Цена: латентность выросла на ..., плюс вызов LLM на каждый запрос и новая точка отказа». «Паттерн своей цены не стоит / стоит только для класса запросов X, включать через маршрутизацию».
Критерий сдачи: таблица baseline против HyDE на своих данных, проверенный кейс REG-2024-118, вердикт со словами «прирост» и «цена».
Критерий готовности
- Сформулировал цену каждого паттерна: латентность, деньги, точки отказа, и привёл случай, когда паттерн это оверкилл.
- Объяснил механику HyDE и почему он бесполезен или вреден на запросах с точными идентификаторами.
- Запустил HyDE с оффлайн-заглушкой на золотом наборе и зафиксировал: прирост есть, нет или отрицательный.
- Проверил HyDE на артикульном кейсе REG-2024-118 и объяснил словами, что произошло с позицией нужного документа.
- Написал вердикт о паттерне в терминах «прирост против цены» на своих данных, а не на демо-вопросе.
Чеклист самопроверки
- Почему гипотетический документ HyDE нельзя показывать пользователю как ответ?
- Что происходит с хвостовой латентностью при добавлении одного LLM-вызова на каждый запрос?
- Как по золотому набору понять заранее, что multi-hop не понадобится?
- Чем опасен судья в Corrective RAG и на чём его калибруют?
- Каким должно быть содержимое корпуса, чтобы GraphRAG вообще было что проверять?
- Каким одним прогоном ты отличаешь рабочий паттерн от красивой демонстрации?
Материалы главы: текст главы в репо · код · иллюстрации · подписка на обновления курса