Хаб курсов / Курс по RAG / глава 10
Модуль 10: федеративный RAG, поиск по многим источникам
Соединяем коннекторы с health-проверками и provenance каждого фрагмента: координатор спрашивает все источники, сливает выдачу и деградирует на упавших.
RAG Engineering. Модуль 10: Федеративный RAG, поиск по многим источникам
Зачем объединять источники и что ломается без федерации
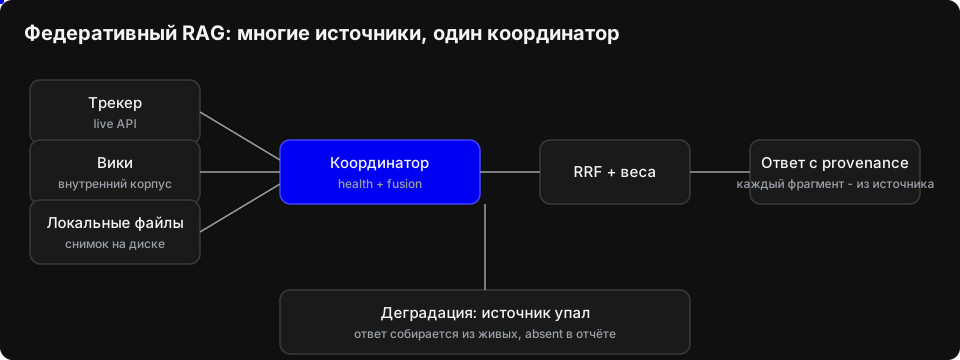
До этого места курс работал с одним корпусом: список документов в памяти, векторная база, поиск по ней. Боевая система почти никогда не выглядит так. Знания компании размазаны по трекеру задач, вики, файловым шарам, локальным каталогам и открытой документации, и вопрос пользователя не говорит, в каком из источников лежит ответ. Если поиск ходит только в один корпус, он либо молча не находит то, что живёт в другом месте, либо заставляет пользователя угадывать, куда идти.
Федеративный RAG это способ собрать поиск поверх многих источников, не сливая их в один индекс. У каждого источника свой коннектор: он умеет искать по своим данным, сообщать о своём состоянии и возвращать результат с прозрачным происхождением. Координатор спрашивает все доступные источники, сливает выдачи, подписывает каждый фрагмент тем, откуда он пришёл, и деградирует на тех, что отвалились. Один индекс на все источники тоже возможен, но у него есть цена: синхронизация прав и актуальности, пересборка при каждом изменении и невозможность спросить источник напрямую там, где его собственный поиск умнее, чем пересобранный индекс.
Этот модуль написан по опыту боевого шлюза, который ходит в трекер, вики и локальный снимок одновременно. Главный урок того опыта: «поиск сломан» почти всегда означает «один источник недоступен» или «в источник не доезжает часть контента», и без health-проверок и телеметрии по источникам ты этого не увидишь.
Три контракта коннектора
Коннектор источника закрывает три вопроса. Первый: поиск. Функция search(query, k) возвращает топ-k фрагментов в едином формате независимо от того, что под ней: REST API трекера, файлы на диске или чужая векторная база. Второй: живость. Функция health() коротким запросом отвечает, доступен ли источник сейчас; её вызов дешевле поискового и не считается запросом к знаниям. Третий: происхождение. Каждый результат несёт метку источника и ссылку на исходный документ, чтобы ответ собирался с цитатами вида «из трекера», «из вики», а объединение не теряло информацию о том, кому принадлежит фрагмент.
# file: federated_search.py
# Федеративный поиск по многим источникам: коннекторы, health, fusion, provenance.
# Оффлайн, чистый stdlib. Имена источников и корпуса учебные.
import json
import os
import time

# Корпус источников. В бою под этим слоем стоят REST API, файлы, чужие индексы.
CORPORA = {
    "tracker": [
        {"id": "INT-6515", "title": "Стенд ИИ-платформы", "text": "Стенд разворачивается через ansible, доступ по VPN, токен в vault. Инструкции по поднятию стенда в приложенном документе."},
        {"id": "INT-6601", "title": "Миграция синкера", "text": "Синкер переносит пользователей и группы. При конфликте DN запись пишется в отчёт расхождений, миграция продолжается."},
    ],
    "wiki": [
        {"id": "wiki/rag-faq", "title": "FAQ по поиску", "text": "Гибридный поиск сочетает лексический и векторный сигналы. RRF сливает списки без калибровки скоров."},
        {"id": "wiki/onboarding", "title": "Онбординг инженера", "text": "Первая неделя: доступы, окружение, чтение регламентов. Наставник проверяет критерии готовности."},
    ],
    "local_docs": [
        {"id": "file/runbook-vpn", "title": "Ранбук VPN", "text": "Если VPN не подключается, проверить сертификат и время на машине. Время, сбитое на час, ломает рукопожатие TLS."},
    ],
}


class Connector:
    """Коннектор источника: поиск, живость, происхождение."""

    def __init__(self, name, docs):
        self.name = name
        self._docs = docs

    def health(self):
        # В бою здесь HEAD-запрос или чтение индикатора. Дешёвая проверка,
        # которая говорит координатору: источник жив, ходи.
        return {"source": self.name, "available": True}

    def search(self, query, k=3):
        # Учебный лексический поиск. Контракт важнее содержимого:
        # на входе строка запроса, на выходе фрагменты с origin.
        tokens = query.lower().split()
        scored = []
        for doc in self._docs:
            text = (doc["title"] + " " + doc["text"]).lower()
            score = sum(1 for t in tokens if t in text)
            if score > 0:
                scored.append((score, doc))
        scored.sort(key=lambda pair: -pair[0])
        hits = []
        for score, doc in scored[:k]:
            hits.append({
                "id": doc["id"],
                "title": doc["title"],
                "text": doc["text"],
                "origin": self.name,
            })
        return hits


def build_connectors():
    return [Connector(name, docs) for name, docs in CORPORA.items()]
Происхождение не украшение. Без метки источника слияние превращает выдачу в кашу, из которой нельзя собрать ответ с цитатами, невозможно отладить, какой источник тащит мусор, и не проверить права: у трекера и вики они разные.
Health-проверки и деградация по источникам
Источник бывает недоступен тривиально: сеть, таймаут, чужой релиз. Координатор, который спрашивает все источники подряд без проверки живости, превращает недоступность в паузу на весь ответ: пользователь ждёт таймаут трекера, хотя вики ответила мгновенно. Поэтому координатор работает так: опросить health всех источников, спрашивать поиск только у живых, в ответ пометить, какие источники отсутствовали.
# file: federated_search.py (продолжение)
import itertools


def rrf_fuse(rankings, k=60):
    """RRF из модуля 04: сливаем выдачи источников в один список."""
    scores = {}
    for ranking in rankings:
        for pos, hit in enumerate(ranking, start=1):
            key = hit["id"]
            scores.setdefault(key, {"hit": hit, "score": 0.0})
            scores[key]["score"] += 1.0 / (k + pos)
    ranked = sorted(scores.values(), key=lambda item: -item["score"])
    return [item["hit"] for item in ranked]


class Coordinator:
    def __init__(self, connectors):
        self._connectors = {c.name: c for c in connectors}
        # Спросить health один раз на старте и кэшировать на короткое время:
        # в бою health-опрос дешёвый, но не бесплатный.
        self._health = {}
        self.refresh_health()

    def refresh_health(self):
        self._health = {}
        for name, conn in self._connectors.items():
            try:
                self._health[name] = conn.health()
            except Exception as exc:
                # источник недоступен - это штатная ситуация, а не ошибка поиска
                self._health[name] = {"source": name, "available": False, "reason": str(exc)}

    def available_sources(self):
        return [name for name, state in self._health.items() if state.get("available")]

    def search(self, query, k=3):
        t0 = time.perf_counter()
        sources_used, rankings = [], []
        for name in self.available_sources():
            try:
                hits = self._connectors[name].search(query, k=k)
            except Exception:
                # поиск в живом источнике может упасть на самом запросе:
                # деградируем на остальных, а не на всём ответе
                self._health[name] = {"source": name, "available": False, "reason": "search failed"}
                continue
            if hits:
                sources_used.append(name)
                rankings.append(hits)
        fused = rrf_fuse(rankings)[:k] if rankings else []
        return {
            "results": fused,
            "sources_used": sources_used,
            "sources_absent": [name for name in self._health if name not in sources_used],
            "latency_ms": round((time.perf_counter() - t0) * 1000, 1),
        }


if __name__ == "__main__":
    coordinator = Coordinator(build_connectors())
    for query in ["как поднять стенд", "vpn не подключается", "синкер миграция"]:
        answer = coordinator.search(query)
        print(f"запрос: {query}")
        for hit in answer["results"]:
            print(f"  [{hit['origin']}] {hit['id']}: {hit['title']}")
        print(f"  источники: {answer['sources_used']}, "
              f"нет: {answer['sources_absent']}, {answer['latency_ms']} мс")
Запусти скрипт. На каждый вопрос ответ собирается из тех источников, где есть совпадения, каждый фрагмент подписан происхождением, а служебные поля говорят, кого опросили и кто не ответил. Поменяй health одного из коннекторов на недоступный и перезапусти: ответ соберётся из оставшихся, и в отчёте будет видно, кого не хватало. Это и есть деградация: система отдаёт лучший доступный ответ вместо ошибки, при этом честно сообщает, что часть знаний была вне игры.
Правило про provenance и деградацию вместе: ответ, собранный из трёх источников из пяти, помечается как неполный. Пользователь имеет право знать, что вики недоступна, когда вопрос был именно про вики.
Слияние с весами источников
RRF из модуля 04 сливает списки одинаково. Между живыми источниками равенство не всегда честно: локальный снимок может отвечать мгновенно, но с устаревшими данными, а трекер медленный, но свежий. В координаторе закладываются веса источников: множитель к вкладу каждой выдачи в RRF, который растёт из замеров полезности, а не из ощущений. Учебный вариант добавляет один множитель и один счётчик попаданий.
# file: federated_search.py (продолжение)
class WeightedCoordinator(Coordinator):
    """Координатор с весами источников и телеметрией попаданий."""

    def __init__(self, connectors):
        super().__init__(connectors)
        self._weights = {name: 1.0 for name in self._connectors}
        self._hits = {name: 0 for name in self._connectors}
        self._queries = 0

    def search(self, query, k=3):
        rankings = []
        for name in self.available_sources():
            try:
                hits = self._connectors[name].search(query, k=k)
            except Exception:
                continue
            if hits:
                rankings.append(hits)
        weighted = []
        for ranking in rankings:
            weighted.append([
                {**hit, "origin": hit["origin"]} for hit in ranking
            ])
        scores = {}
        for ranking in weighted:
            origin = ranking[0]["origin"] if ranking else None
            weight = self._weights.get(origin, 1.0)
            for pos, hit in enumerate(ranking, start=1):
                entry = scores.setdefault(hit["id"], {"hit": hit, "score": 0.0})
                entry["score"] += weight / (60 + pos)
        fused = [item["hit"] for item in sorted(scores.values(), key=lambda item: -item["score"])]
        fused = fused[:k]
        # Телеметрия: источник считается полезным, если его фрагмент попал в топ.
        top_origins = {hit["origin"] for hit in fused}
        self._queries += 1
        for name in top_origins:
            self._hits[name] = self._hits.get(name, 0) + 1
        return {"results": fused, "sources_used": sorted(top_origins)}

    def report(self):
        return {
            "queries": self._queries,
            "hit_share": {
                name: (self._hits[name] / self._queries if self._queries else 0.0)
                for name in self._connectors
            },
        }
Замер попаданий по источникам отвечает на вопрос, который без телеметрии не ответит никогда: какие источники реально отвечают на вопросы пользователей. Источник, который ни разу не попал в топ за сотню запросов, это кандидат на пересборку индекса или на отключение, а не на автоматический буст.
Отдельное правило про источники-подсказки. Рядом с живыми источниками часто живёт слой эпизодической памяти: локальный снимок прошлых сессий, кэш найденного, личные заметки. Он незаменим офлайн и полезен как намёк, и ровно поэтому опасен как замена. Подсказка из памяти и свежий ответ живого источника не равны: память помнит, что было в прошлый четверг, а пользователь спрашивает про сегодня. Первая версия боевого шлюза грешила коротким замыканием: если слой подсказок что-то вернул, живые источники не опрашивались вовсе, и пользователь получал вчерашние данные вместо сегодняшних. Правило простое и стоит его держать в тесте: подсказки идут вместе с живыми источниками, никогда вместо них; обогащение ответа из памяти включается только после того, как живой источник подтвердил результат.
Что ты построишь
К концу этого раздела у тебя будет федеративный поиск по трём учебным источникам: коннекторы с health и provenance, координатор с деградацией, взвешенное слияние и отчёт по попаданиям источников. Ты увидишь, как ответ собирается из нескольких систем и как система ведёт себя, когда одна из них падает.
В боевом шлюзе этот же каркас живёт поверх MCP: каждый источник это коннектор с тем же контрактом, координатор опрашивает health параллельно запросам, provenance едет в ответе до самого интерфейса. Телеметрия пишется в лог и раз в месяц сверяется с golden set: вопросы, на которые система отвечала плохо, попадают в набор и становятся регрессионными.
Лаба: четвёртый источник и контролируемая деградация
Добавь четвёртый источник, например web_docs, с двумя документами. Проверь три сценария и заполни таблицу: все источники живы; один источник недоступен (health возвращает False); поиск в живом источнике падает (оберни search в исключение).
| Сценарий | Источники в ответе | provenance топ-1 | отсутствуют в отчёте |
|---|---|---|---|
| все живы | ... | ... | ... |
| wiki лежит | ... | ... | ... |
| search падает в tracker | ... | ... | ... |
Критерий выполнения: в каждом сценарии ответ непустой там, где это возможно, provenance каждого фрагмента корректен, а отчёт называет отсутствующие источники. Если при падении одного источника падает весь поиск, координатор написан неправильно: это самая частая ошибка федеративных систем первого года.
Критерий готовности
- Объяснил, почему федеративный поиск не то же самое, что один общий индекс, и когда каждый вариант дешевле.
- Показал health-проверку, деградацию на недоступном источнике и честный отчёт о том, кого не хватало.
- Каждый фрагмент ответа несёт происхождение, и по нему можно собрать цитаты.
- Померил долю попаданий по источникам и объяснил, что она говорит про веса.
Чеклист самопроверки
- Что ломается, если health проверять раз в сутки, а не перед поиском?
- Почему provenance нужен на каждом фрагменте, а не на всём ответе?
- Как понять по телеметрии, что источник стоит отключить?
- Что делать, если два источника возвращают один документ с разными правами?
Связь с остальным курсом
Гибридный поиск из модуля 04 здесь работает внутри каждого источника и между источниками: RRF сливает и способы поиска, и сами системы. Права доступа из модуля 09 поднимаются на уровень источников: у каждого коннектора своя модель прав, и слияние не должно смешивать фрагменты, которые один пользователь не имеет права видеть вместе. Golden set из модуля 03 расширяется срезами по источникам: для каждого источника свои вопросы, чтобы доля попаданий считалась по каждому отдельно.
Материалы главы: текст главы в репо · код · иллюстрации · подписка на обновления курса