Хаб курсов / Курс по RAG / глава 11
Финальный проект: production-ready RAG с цитатами
Собираем всё: RAG с цитатами, золотой набор от 30 вопросов, eval одной командой и приёмка по чеклисту.
RAG Engineering. Финальный проект
Что ты построишь
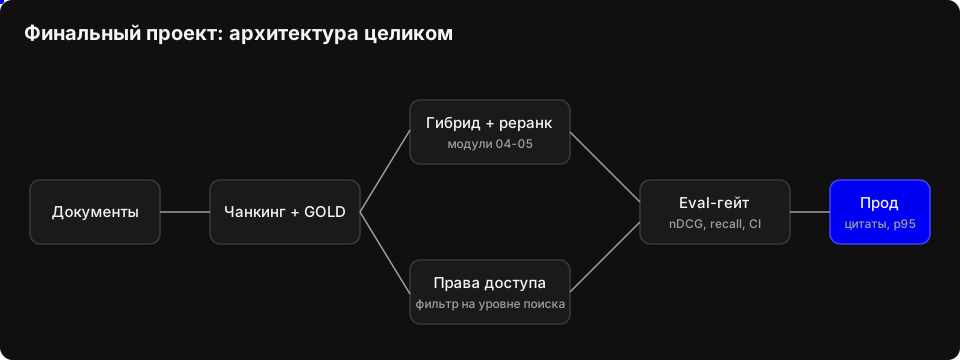
Финальный проект собирает курс в один артефакт: production-ready RAG с цитатами на своём корпусе. Индексация с чанкингом и метаданными прав из модулей 03 и 09, гибридный поиск с реранком из модулей 04 и 05, генерация с цитатами, eval-раннер из модуля 06, сервис с HTTP-поиском и фильтром прав из модуля 09. Проект принимается не на словах, а по чеклисту приёмки: каждый пункт проверяется командой или тестом с чистой копии репозитория.
Условие проекта
За курс ты собрал по отдельной детали: гибридный поиск на BM25 и плотных векторах со слиянием через RRF, cross-encoder реранкер поверх слияния, обоснованную стратегию чанкинга, золотой набор GOLD в формате JSONL, eval-раннер с recall@k, MRR и nDCG, рамку оценки паттернов «прирост против цены», agentic-надстройку с MCP-сервером и сервисный каркас. Каждая деталь по отдельности уже проверена. Задача финала другая: собрать из них согласованное целое, где качество не разваливается при переходе от одного шага к следующему.
Результат курса: production-ready RAG-система, которая отвечает на вопросы по документам и всегда подкрепляет ответ цитатами. Ключевое слово здесь «production-ready»: систему можно запустить, измерить и объяснить, а не только показать один удачный ответ на заранее подобранном примере.
Важное условие: корпус твой собственный. Демо-корпус курса со служебными регламентами (отпуска, VPN, бэкапы, доступы, командировки, компенсации, REG-2024-118) для проекта не подходит. Возьми документы, с которыми реально работаешь: внутреннюю базу знаний, набор инструкций, техническую документацию, архив политик. Минимум 30 документов, и они должны различаться по объёму и структуре, иначе чанкинг и поиск не проверишь по-настоящему.
В системе обязаны присутствовать следующие компоненты.
Индексация с чанкингом и метаданными прав. Каждый документ разбивается на чанки по выбранной и обоснованной стратегии; у чанка есть стабильный идентификатор, ссылка на исходный документ, позиция внутри него и метаданные прав доступа.
Гибридный поиск с реранком. BM25 и плотный поиск идут параллельно, результаты сливаются через RRF, верхушка пересортировывается реранкером.
Генерация с цитатами и отказом при нехватке данных. Ответ строится на найденных чанках, каждая содержательная фраза подкреплена ссылкой на конкретный чанк. Если релевантных данных нет, система отказывается отвечать, а не достраивает ответ из общих знаний модели.
Eval-раннер на золотом наборе. Метрики recall@k, MRR и nDCG считаются по твоему GOLD, у прогона есть пороги и однозначный вердикт.
Сервис с HTTP-поиском и фильтром прав. Эндпоинт принимает запрос и идентификатор пользователя, отдаёт чанки и ответ, при этом документы вне прав пользователя не попадают ни в выдачу, ни в цитаты.
Документация запуска. README описывает установку, индексацию, прогон eval и старт сервера, и всё это работает оффлайн на стандартной библиотеке Python.
Сдавай проект как репозиторий: код, корпус, GOLD, конфиги и README. Ниже требования разложены по пунктам, чтобы проверка была однозначной.
Требования по пунктам
-
Свой корпус, минимум 30 документов. Документы не из демо-корпуса курса, разного объёма и структуры. В README укажи, откуда корпус и почему он размечен именно так.
-
Золотой набор от 30 вопросов. Формат JSONL: вопрос и список идентификаторов релевантных документов или чанков. Вопросы покрывают разные документы и включают хотя бы несколько составных запросов, где нужен гибридный поиск.
-
Индексация с чанкингом и метаданными прав. Стратегия чанкинга обоснована в README: размер, перекрытие, границы разделов. У каждого чанка есть идентификатор, ссылка на документ, позиция и метаданные прав.
-
Гибридный поиск со слиянием и реранком. BM25 и плотный поиск работают вместе, результаты сливаются через RRF, затем верхушка проходит через реранкер. В README зафиксируй, сколько кандидатов берётся на слияние и сколько уходит в реранк.
-
Цитаты в каждом ответе. Любое утверждение в ответе сопровождается ссылкой на конкретный чанк с идентификатором документа. Ответ без цитат считается дефектом, а не стилистической мелочью.
-
Отказ при нехватке данных. Если после реранка релевантность ниже порога, система отвечает, что данных в корпусе нет, вместо генерации по общим знаниям. Поведение отказа проверяется отдельными вопросами из GOLD.
-
Eval одной командой с порогами. Один вызов запускает прогон по золотому набору, печатает recall@k, MRR и nDCG, сравнивает их с порогами из конфига. При падении метрик команда завершается с ненулевым кодом, чтобы регрессию ловил CI.
-
Права доступа с проверкой изоляции. Фильтр применяется до ранжирования, а не после генерации ответа. Обязательный тест: пользователь А не видит документ Б, причём ни в выдаче чанков, ни в цитатах.
-
Сервис с HTTP-эндпоинтом поиска. Эндпоинт принимает запрос и идентификатор пользователя, возвращает ответ с цитатами и найденные чанки. Рядом задокументирована латентность p95 на твоём железе с указанием метода замера.
-
README с командами запуска. Отдельно описаны индексация корпуса, прогон eval и старт сервера, каждая команда проверена с чистого окружения. Запуск оффлайн, только стандартная библиотека Python, без скрытых зависимостей.
Чеклист приёмки
Проект сдаётся по этому чеклисту. Каждый пункт проверяется командой или тестом, а не на словах, и принимается только тогда, когда его удаётся повторить с чистой копии репозитория: клонировал, поставил зависимости по инструкции, выполнил команду, получил тот же результат. Если пункт держится на устном заверении, он не принят, даже когда код внутри выглядит правильным. Ниже семь пунктов, и у каждого указан способ проверки, который занимает минуты и не требует доверия к автору.
- Золотой набор содержит не меньше 30 вопросов и лежит в репозитории. Проверяю командой
python -m eval.check_gold --min 30, которая читает JSONL, считает строки и падает, если вопросов меньше или в какой-то строке пустой список id. - nDCG@10 на золотом наборе не ниже порога, зафиксированного в конфиге eval, причём порог выбран по своему baseline и закоммичен до начала полировки. Проверяю прогоном eval и сверкой метрики с полем
ndcg_thresholdв конфиге, а также смотрюgit logна файле конфига, чтобы порог не менялся после первых замеров. - Каждый ответ содержит цитаты со ссылками на id чанков, и это закреплено тестом. Запускаю
pytest tests/test_citations.py: тест требует непустой списокchunk_idв каждом ответе и проверяет, что каждый id реально существует в индексе. - Eval запускается одной командой из README и выходит с ненулевым кодом при падении метрик. Копирую команду из README, намеренно порчу ретривер, например обнуляю слияние, и убеждаюсь, что код возврата ненулевой, а не просто печатается грустная таблица.
- Тест прав «пользователь А не видит документ Б» зелёный, а при удалении фильтра красный. Комментирую строку с фильтром по правам в поиске, гоняю тест, вижу красный, возвращаю строку и вижу зелёный.
- p95 латентности поиска измерен на своей машине, и число записано в README. Запускаю бенчмарк-скрипт из репозитория и сравниваю его вывод с числом в README, отмечая, что замер сделан на локальной машине без продакшн-нагрузки.
- README позволяет запустить индексацию, eval и сервер, не читая код. Прохожу README на чистой копии шаг за шагом, ничего не додумывая по исходникам, и фиксирую каждое место, где пришлось заглядывать в код, как дефект документации.
Критерии оценки результата
Формально сданный проект и сильный проект отличаются не объёмом кода, а тем, насколько результату можно верить. Пять критериев ниже и задают эту разницу.
Воспроизводимость. Другой человек берёт чистую копию, ставит зависимости по README и повторяет индексацию, eval и запуск сервера без переписки с автором. Если для запуска нужны устные уточнения, скрытые переменные окружения или файл, который лежит только на машине автора, проект не воспроизводим, и остальные достоинства уже не спасают.
Честность eval. Золотой набор собран до подгонки параметров, порог зафиксирован заранее и не двигался под результат. Сильный проект показывает историю: вот baseline, вот порог, вот что изменилось и как это отразилось на метриках. Слабая работа выглядит иначе: метрика подтянута под уже полученный ответ, а вопросы набора подозрительно совпадают с формулировками документов.
Безопасность. Тест прав краснеет при самом простом способе сломать фильтр: убрал условие, поменял местами роли, передал чужой идентификатор. Проверка на одном счастливом сценарии ничего не доказывает, ценность в том, что негативный тест падает именно там, где должен.
Поведенческая зрелость. Когда данных в корпусе нет, система отказывается отвечать, а не собирает правдоподобный текст из ближайших чанков. Деградация помечается явно: пустой результат поиска, сработавший предохранитель, ответ с оговоркой. Молчаливая выдумка это самый дорогой дефект, потому что выглядит как работающая функция.
Понятность документации. README объясняет, зачем нужен каждый шаг, какие команды запускать и что считать успехом. Хорошая документация позволяет новому человеку отличить норму от сбоя без чтения исходников.
Сильный проект это портфолио-артефакт, и показывает он не знание библиотек, а инженерную дисциплину: измерять, фиксировать пороги, проверять права, документировать. Библиотеки меняются, а привычка сначала измерить, потом зафиксировать, потом проверить границы остаётся и переносится на любую новую систему.
Что дальше учить
Финальный проект закрывает базовый цикл: корпус, поиск, генерация, оценка, наблюдаемость. Дальше стоит выбирать направление под свою задачу, а не проходить всё подряд.
-
Продакшен-инфраструктура. Упакуй сервис в контейнер, опиши сборку и тесты в CI, добавь health-check и понятный запуск. Поверх логов из модуля 09 построй метрики и алерты: рост доли отказов, всплеск латентности, пустые ответы после фильтрации.
-
Масштабирование поиска. Разберись, как шардировать индекс и обновлять документы без полной пересборки. Отдельная тема: multi-tenant, где права проверяются на уровне индекса или чанка, а не в промпте.
-
Качество генерации. Освой структурированные ответы со схемой и валидацией, self-check по цитатам, аккуратную работу с таблицами и кодом в корпусе. Полезный навык: отказывать, когда контекста не хватает.
-
Агентные схемы поверх MCP. Собери многоинструментного агента, где у каждого инструмента свои права и лимиты. Продумай аудит вызовов и то, как агент деградирует при отказе одного инструмента.
-
Доменные данные. Подбирай эмбеддер под язык и домен, проверяя его на своём золотом наборе. Дообучение реранкера на собственных логах кликов и оценок может дать заметный прирост там, где общий реранкер путается.
-
Чтение чужого кода. Открытые RAG-проекты полезны как источник паттернов: смотри, как устроены чанкинг, кеширование, деградация и тесты. Сравнивай решения со своими и переноси только то, что решает твою проблему.
-
Инженерная гигиена. Веди золотой набор как живой артефакт, добавляй в него случаи из реальных ошибок. Настрой регрессионный прогон так, чтобы изменение промпта или модели не проходило молча.
Лучший следующий шаг это реальный корпус и реальный пользователь, хотя бы один. Работа с настоящими вопросами быстро вскрывает пробелы, которые учебные данные скрывают: кривые формулировки, устаревшие документы, конфликтующие регламенты. Продакшен учит быстрее второго учебного проекта, потому что цена ошибки видна сразу, а обратная связь приходит от человека, которому нужен ответ.
Материалы главы: текст главы в репо · код · иллюстрации · подписка на обновления курса