Хаб курсов / LLM Inference Systems / глава 1
Модуль 01: От matmul к тексту: тензоры и базовые операторы
Matmul, RMSNorm, embedding и Linear руками на numpy с проверкой на оракуле. Почему декодинг ограничен памятью, а не FLOPs.
LLM Inference Systems. Модуль 01: От matmul к тексту — тензоры и базовые операторы
Инференс LLM — это последовательность умножений матриц, в которую вкраплены несколько дешёвых поэлементных операций. Если вы понимаете, сколько FLOPs и байт стоит каждый шаг, вы можете предсказать скорость генерации на бумаге, до того как что-то запустите. Этот модуль ставит фундамент: мы разберём, почему matmul — единственная дорогая операция, напишем с нуля три оператора, из которых состоит любой трансформер (RMSNorm, Linear, Embedding), и научимся проверять их против эталонной библиотеки.
Главный навык модуля — не написание кода, а оракул-метод: своя реализация сверяется с независимой библиотечной на случайных входах с фиксированным seed и явным допуском. Этим приёмом вы будете пользоваться весь курс, вплоть до attention и KV-кэша. Всё считается на CPU: numpy для реализации, torch только как оракул.
1.1 Матмул — операция, которая определяет всё
Матричное произведение C = AB, где A \in \mathbb{R}^{m\times k}, B \in \mathbb{R}^{k\times n}:
C_{ij} = \sum_{p=1}^{k} A_{ip} B_{pj}
Стоимость — 2mnk FLOPs: mnk умножений и примерно столько же сложений. Множитель 2 — не педантизм, а рабочая константа: именно она даёт правило «форвард-пасс стоит 2N FLOPs на токен», где N — число параметров.
Посчитаем честно для Qwen3-0.6B (та конфигурация, с которой работает tiny-llm): d_model=1024, n_layers=28, n_heads=16, n_kv_heads=8, head_dim=128, d_ff=3072, vocab=151936. Один токен, батч 1, контекст короткий — то есть m=1 для всех проекций:
| Операция | m | k | n | FLOPs |
|---|---|---|---|---|
q_proj | 1 | 1024 | 16·128 = 2048 | 4.19 M |
k_proj | 1 | 1024 | 8·128 = 1024 | 2.10 M |
v_proj | 1 | 1024 | 8·128 = 1024 | 2.10 M |
o_proj | 1 | 2048 | 1024 | 4.19 M |
gate_proj | 1 | 1024 | 3072 | 6.29 M |
up_proj | 1 | 1024 | 3072 | 6.29 M |
down_proj | 1 | 3072 | 1024 | 6.29 M |
| итого на слой | 31.46 M | |||
| × 28 слоёв | 880.8 M | |||
lm_head | 1 | 1024 | 151936 | 311.2 M |
| всего на токен | 1.19 GFLOP |
Число 1.19 GFLOP совпадает с 2N при N=596M параметров — и это не совпадение, а следствие того, что каждый параметр участвует ровно в одном умножении и одном сложении на токен. Проверка сходится и по параметрам: 28 \times 15.73\text{M} + 151936 \times 1024 = 440.4\text{M} + 155.6\text{M} = 596.0\text{M}. Заодно видно, что у Qwen3-0.6B таблица эмбеддинга и lm_head связаны (tie_word_embeddings): иначе параметров было бы 751M, а не 596M.
Теперь про «почему наивный цикл в тысячу раз медленнее». Три независимые причины:
- Накладные расходы интерпретатора. Одна скалярная операция в CPython — это разыменование объектов, проверка типов, создание нового объекта: 50–100 нс. Аппаратный FMA — 0.3 нс. Разрыв в 200–300 раз ещё до того, как вы что-то сделали с памятью.
- Нет переиспользования данных. В наивном порядке
i, j, pэлементB_{pj}при фиксированномjчитается из памятиmраз, аA_{ip}—nраз. Кэш не спасает: рабочее множество3n^2чисел дляn=1024в fp32 — это 12.6 МБ, что уже не влезает в L2 ноутбука. - Нет SIMD и многопоточности. BLAS собирает всё сразу: блочное умножение под размер кэша, векторные FMA-инструкции (4–16 чисел за такт), несколько потоков.
Оценка через арифметическую интенсивность. Для n=1024: FLOPs = 2n^3 = 2.15 GFLOP, байт прочитано = 3n^2 \cdot 4 = 12.6 МБ, интенсивность \approx 170 FLOP/байт. Точка перегиба roofline при 100 GFLOPS и 100 ГБ/с — 1 FLOP/байт. Значит большой матмул compute-bound, и мерить надо гигафлопсы.
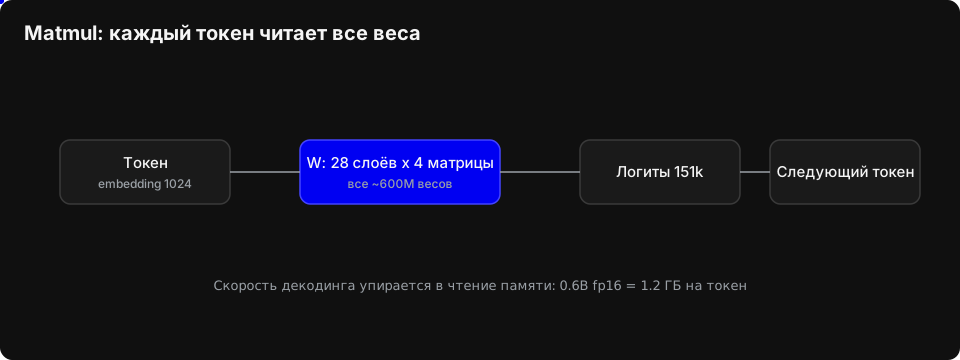
А теперь то, из-за чего инференс устроен иначе. При декодинге m=1, и та же q_proj — это матрица-вектор: 4.19 MFLOPs и 4.19 МБ весов. Интенсивность ровно 1 FLOP/байт — на границе, и на практике глубоко в memory-bound. При 100 ГБ/с это 42 мкс на одну проекцию. Просуммируйте все веса: 596M × 2 байта (bf16) = 1.19 ГБ, которые надо прочитать, чтобы сгенерировать один токен. При 100 ГБ/с — 11.9 мс, то есть потолок ~84 ток/с независимо от того, насколько быстрый у вас ALU. Это главный вывод модуля: декодинг ограничен пропускной способностью памяти, а не вычислениями. Всё остальное в курсе (квантование, PagedAttention, батчинг) — способы обойти именно это ограничение.
1.2 Что трансформеру нужно от линейной алгебры
Удивительно мало. Полный список операций, из которых собирается Qwen3:
| Операция | Форма | Где | Стоимость на токен |
|---|---|---|---|
matmul / linear | (B,T,C)\times(C,D)\to(B,T,D) | все проекции, attention, MLP | 1.19 GFLOP |
transpose | смена осей, view | x @ W.T, (B,H,T,d)\to(B,T,H,d) | 0 FLOPs (смена strides) |
broadcast | (C,) по последней оси | вес RMSNorm, bias | O(C) |
softmax по последней оси | (B,H,T,T) | attention | \approx 5BHT^2 |
reduction (mean, sum) | по последней оси | RMSNorm | O(C) |
rsqrt | поэлементно | RMSNorm | O(C) |
gather (lookup) | индексы → строки | embedding | 0 FLOPs |
Всё остальное — свёртки, einsum-экзотика, кастомные активации — в инференсе Qwen3 отсутствует. SwiGLU в MLP — это silu(gate) * up, два поэлементных прохода, стоимость которых пренебрежима на фоне 18.9 MFLOPs матмулов слоя.
1.3 Тензоры: оси, strides, контигуальность
Соглашение об осях в курсе фиксировано: (B, T, C) — батч, длина последовательности, ширина канала. Веса лежат как (out_features, in_features), как в PyTorch.
numpy хранит тензор как плоский буфер + strides (шаг в элементах по каждой оси). Для (B, T, C) в C-order: strides = (T*C, C, 1). Отсюда два практических факта:
x.T— это view, а не копия: меняются только strides. Поэтомуx @ W.Tвlinearне требует перекладывания весов в памяти.- Но BLAS требует контигуального (плотного, C-order) входа. Если вы транспонировали тензор и отдали его в matmul, внутри произойдёт
ascontiguousarray— неявная копия, которую легко не заметить. Для тензора(B,T,C)сB{=}8, T{=}2048, C{=}1024в fp32 это 64 МБ лишнего трафика.
Правило: транспонируйте веса (один раз, при загрузке), а не активации (каждый шаг). В nn.Linear веса уже лежат в нужном порядке, поэтому F.linear(x, W, b) внутри делает ровно x @ W.T.
Про dtype. numpy не умеет bf16; в этом модуле всё считается в fp32 (\varepsilon = 1.2\times10^{-7}). В MLX и torch на Apple Silicon модель живёт в bf16 — у него 8 бит мантиссы (\varepsilon \approx 0.008) и диапазон как у fp32. Это важно для допусков: сравнивать bf16-реализацию с fp32-оракулом с точностью 1e-5 бессмысленно, относительная ошибка bf16 — сотые.
Важная оговорка на весь дальнейший курс: «байт на элемент» — переменная, а не константа. Этот модуль неявно считает элемент веса двумя байтами (BF16), и для учебных расчётов это нормально; но к 2026 FP8 и FP4 стали мейнстримом для весов и активаций — у DeepSeek V4.1 Flash даже KV-кэш в FP4 (DeepSeek). Правило «параметры × 2 байта» из этого модуля дальше по курсу заменяется на «параметры × байт на элемент», где множитель равен 2, 1 или 0.5 в зависимости от разрядности.
1.4 RMSNorm
Нормализация перед каждым блоком attention и перед MLP:
\text{RMSNorm}(x) = \frac{x}{\sqrt{\frac{1}{d}\sum_{i=1}^{d} x_i^2 + \varepsilon}} \odot w
где x \in \mathbb{R}^{d}, w \in \mathbb{R}^{d} — обучаемый масштаб, инициализируется единицами, \varepsilon по умолчанию 10^{-6} (у Qwen3 в конфиге rms_norm_eps=1e-6).
Сравнение с LayerNorm:
| LayerNorm | RMSNorm | |
|---|---|---|
| Центрирование | x - \mu | нет |
| Знаменатель | \sqrt{\sigma^2 + \varepsilon} | \sqrt{\overline{x^2} + \varepsilon} |
| Параметров | 2d (weight + bias) | d (weight) |
| Операций на токен | \approx 5d | \approx 4d |
| Инвариантность к сдвигу | да | нет |
| Инвариантность к масштабу | да | да |
Идея RMSNorm (Zhang & Sennrich, 2019): центрирование не нужно, потому что следующий за нормой слой — линейный с bias, и он поглощает любой сдвиг. Убирая вычитание среднего, вы экономите одно чтение и одну редукцию на слой.
Числа для Qwen3-0.6B: d=1024, на одну норму — 1024 умножения в квадрат, 1023 сложения в сумму, 1 rsqrt, 1024 умножения на обратный корень, 1024 умножения на w: около 4 тыс. FLOPs. Норм в модели 56 (2 на слой × 28), итого 230 тыс. FLOPs на токен — 0.02% от 1.19 GFLOP. По вычислениям это ничто. Но по памяти — 4 КБ чтения и 4 КБ записи на норму, а на M-серии запуск ядра стоит дороже, чем сама работа: поэтому в MLX есть mx.fast.rms_norm, а в llama.cpp RMSNorm слит с последующим матмулом.
Ключевая деталь реализации: \varepsilon стоит внутри корня, вместе с средним квадратом, а не снаружи. Перепутать легко, разница проявляется только на векторах с малой нормой — то есть ровно там, где нормализация и нужна.
1.5 Embedding: lookup вместо матмула
Таблица эмбеддинга — матрица E \in \mathbb{R}^{V \times d}, V=151936, d=1024. Это 155.6M параметров, 311 МБ в bf16 — 26% всего веса модели, больше, чем любой отдельный слой.
Формально эмбеддинг токена t — это умножение one-hot вектора на таблицу: e_t = \text{onehot}(t) \cdot E. Эквивалентность точная, но стоимость отличается радикально:
| one-hot matmul | lookup | |
|---|---|---|
| FLOPs | 2Vd = 311 M | 0 |
| Чтение | вся таблица, 311 МБ | одна строка, 2 КБ |
| Время при 100 ГБ/с | 3.1 мс | ~0.02 мкс |
3.1 мс на токен — это четверть бюджета декодинга (11.9 мс) на арифметику с нулями. Поэтому во всех фреймворках эмбеддинг — это gather по индексам, а не matmul. Обратная сторона: lm_head в конце модели — настоящий matmul 1024 \to 151936, и он стоит 311 MFLOPs, то есть те же 26% вычислений на токен. Асимметрия «на входе бесплатно, на выходе четверть счёта» — характерная особенность LLM с большим словарём.
Индексы — целые (int64 в numpy, int32 в MLX/torch-инференсе), и это единственное место в модели, где тензор не float.
1.6 Linear: y = xWᵀ + b
\text{Linear}(x) = xW^\top + b, \quad x\in\mathbb{R}^{(\ldots, d_{in})},\ W\in\mathbb{R}^{d_{out}\times d_{in}},\ b\in\mathbb{R}^{d_{out}}
Результат: (\ldots, d_{out}). Ведущие оси (батч, время) — произвольные: matmul в numpy и torch батчируется по всем осям, кроме двух последних. Именно поэтому один и тот же linear обслуживает и префилл (B, T, C), и декодинг (B, 1, C), и однослойный тест (C,).
Bias в Qwen3 есть у всех проекций, кроме… впрочем, проверять надо по config.json (attention_bias, mlp_bias): у Qwen3 bias в attention-проекциях отсутствует, у Qwen2 был qkv_bias=true. Отсутствие bias — это минус d_{out} сложений и минус d_{out} параметров на проекцию: для q_proj 2048 параметров из 2.1M, 0.1%. На скорость влияет слабо, но на память при загрузке — влияет.
Порядок осей весов — источник половины багов при переносе кода между фреймворками. PyTorch: W.shape == (out, in), вызов x @ W.T. MLX nn.Linear хранит так же. llama.cpp хранит как (d_{in}, d_{out}) и умножает без транспонирования. Если форма сходится, но результат неверный — почти наверняка перепутано именно это.
1.7 Оракул-метод: как проверять себя всю дорогу
Правило курса: реализация проверяется против независимой библиотеки на случайных данных с фиксированным seed и явным допуском. Не против второй своей реализации — она повторит ту же ошибку.
Протокол:
- Фиксируйте seed для numpy и torch отдельно (
np.random.default_rng(0),torch.manual_seed(0)). - Одинаковый dtype. Оракул в fp32, ваша реализация в fp32. Смешаете с bf16 — получите diff 1e-2 и будете искать баг там, где его нет.
- Допуск выводится из длины редукции. Ошибка суммирования
kчленов растёт как\varepsilon\sqrt{k}\cdot|y|. Дляk=1024,\varepsilon=1.2\times10^{-7},|y|\sim1:\approx 4\times10^{-6}. Отсюдаatol=1e-5для проекций сd_{in}=1024иatol=1e-4дляd_{in}=3072. - Три метрики, не одна. Печатайте
max_abs,max_relи проверкуshape. Расхождение формы — самый частый баг, иmax_absего не поймает, если broadcasting случайно «спас» ситуацию. - Property-тесты в дополнение к оракулу. Для RMSNorm:
\text{RMSNorm}(a x) = \text{RMSNorm}(x)приa>0; приw=\mathbf{1}среднеквадратичное выхода равно 1. Такие тесты ловят ошибки, которые оракул может «простить» (например, забытый\varepsilonпри больших нормах).
Допуск — не бюрократия. Слишком свободный (1e-2) пропустит перепутанные оси, слишком жёсткий (1e-7) даст флаки на другом железе, потому что порядок суммирования в BLAS зависит от размера кэша и числа потоков.
Задание 01.1: три оператора и оракул
Реализуйте в файле mod01_ops.py три функции с ровно такими сигнатурами:
def rms_norm(x, w, eps=1e-6):
    """x: (..., d) float32, w: (d,) float32 -> (..., d) float32"""

def linear(x, W, b=None):
    """x: (..., in) float32, W: (out, in) float32, b: (out,) или None -> (..., out) float32"""

def embedding(ids, table):
    """ids: (...) int64, table: (V, d) float32 -> (..., d) float32"""
Требования:
- Только numpy, без циклов по ведущим осям (никаких
for b in range(B)). linearобязан работать дляx.shape == (in,)(результат(out,)),(T, in)и(B, T, in).rms_norm— для(d,),(T, d),(B, T, d).- Возвращаемый dtype —
float32во всех случаях.
В файле test_mod01.py напишите проверки против torch:
| Тест | Вход | Оракул | Допуск |
|---|---|---|---|
rms_norm | (2,5,1024), w~(1024,) | F.rms_norm(x, (1024,), w, eps=1e-6) | atol=1e-5 |
rms_norm 2D | (10,1024) | то же | atol=1e-5 |
linear с bias | (2,5,1024), W~(2048,1024)/√1024 | F.linear(x, W, b) | atol=1e-5 |
linear без bias, 1D | (1024,), W~(2048,1024)/√1024 | F.linear(x, W) | atol=1e-5 |
embedding | ids (2,7), V=1000, d=64 | F.embedding(ids, table) | atol=0 (точное совпадение) |
| one-hot ≡ lookup | V=8, d=4, ids=[3,0,7] | np.eye(8)[ids] @ table | atol=0 |
| scale-invariance | x и 7.5*x, w=1 | rms_norm(x) | atol=1e-5 |
Ожидаемый вывод — таблица со строками [OK ] и метриками. Задание сдано, когда все семь строк OK и вы можете объяснить, почему допуск для embedding нулевой, а для linear — нет.
Задание 01.2 (опционально, только Apple Silicon): то же на MLX
Повторите три оператора на mlx.core и проверьте против mx.fast.rms_norm и mx.nn.Linear:
import mlx.core as mx
x = mx.random.normal((2, 5, 1024))
w = mx.random.normal((1024,))
ref = mx.fast.rms_norm(x, w, 1e-6)   # оракул из MLX
Здесь допуск другой: MLX считает в fp32 на GPU/ANE с иным порядком редукции, комфортный порог — 1e-4 для rms_norm и 1e-3 для linear при d_{in}=1024. Если ваш код на MLX даёт diff 1e-5, а на numpy 1e-6 — это нормально; если 1e-2 — вы потеряли точность (скорее всего, случайно привели к bf16). Дополнительно замерьте время на матрице 4096×4096×4096 для mx.matmul и сравните с np.matmul на CPU: на M2 Pro разрыв обычно 3–6× в пользу GPU, и это первое место, где вы почувствуете, зачем вообще нужен Metal.
Код
Полный самодостаточный файл mod01.py: реализации, оракулы, бенчмарк matmul и арифметика памяти для Qwen3-0.6B.
"""
Модуль 01. Базовые операторы инференса LLM на numpy + проверка против torch.
Запуск: python mod01.py
Зависимости: numpy, torch (CPU достаточно), torch >= 2.4 для F.rms_norm.
"""
from __future__ import annotations

import time

import numpy as np
import torch
import torch.nn.functional as F

RNG = np.random.default_rng(0)

# ----------------------------------------------------------------------
# 1. matmul: три реализации одной и той же формулы
# ----------------------------------------------------------------------

def matmul_naive(A, B):
    """Тройной цикл на чистых python-скалярах. Только для демонстрации.

    Порядок i, p, j (а не i, j, p): строка B[p] переиспользуется для всех j,
    поэтому она остаётся в кэше. Это уже половина оптимизации BLAS.
    """
    a, b = A.tolist(), B.tolist()
    m, k = len(a), len(a[0])
    n = len(b[0])
    out = [[0.0] * n for _ in range(m)]
    for i in range(m):
        ai, oi = a[i], out[i]
        for p in range(k):
            aip = ai[p]
            if aip == 0.0:          # разреженность встречается в embedding и масках
                continue
            bp = b[p]
            for j in range(n):
                oi[j] += aip * bp[j]
    return np.asarray(out, dtype=np.float64)


def matmul_numpy(A, B):
    """Один вызов BLAS: dgemm для float64, sgemm для float32."""
    return np.matmul(A, B)


def matmul_blocked(A, B, block=64):
    """Блочный вариант той же формулы.

    Рабочее множество block x block float64 = 32 KiB при block=64 — это L1.
    Внутри блока работают векторизованные numpy-операции, поэтому сравнение
    честное: «кэш + SIMD» против «кэш + SIMD + ассемблер + потоки» в BLAS.
    """
    A = np.asarray(A, dtype=np.float64)
    B = np.asarray(B, dtype=np.float64)
    m, k = A.shape
    n = B.shape[1]
    C = np.zeros((m, n), dtype=np.float64)
    for k0 in range(0, k, block):
        for j0 in range(0, n, block):
            acc = C[:, j0:j0 + block]           # view, а не копия
            for p in range(k0, min(k0 + block, k)):
                acc += np.outer(A[:, p], B[p, j0:j0 + block])
    return C


def matmul_batched_loop(A, B):
    """Батч циклом вокруг BLAS. Работает, но на маленьких матрицах теряет
    больше, чем считает: накладные расходы вызова numpy на каждый батч."""
    A = np.asarray(A)
    B = np.asarray(B)
    assert A.ndim == 3 and B.ndim == 3, "ожидаются (B, T, K) и (B, K, N)"
    out = np.empty((A.shape[0], A.shape[1], B.shape[2]), dtype=np.float64)
    for i in range(A.shape[0]):
        out[i] = A[i] @ B[i]
    return out


def _time(fn, *args, repeat=3):
    best = float("inf")
    out = None
    for _ in range(repeat):
        t0 = time.perf_counter()
        out = fn(*args)
        best = min(best, time.perf_counter() - t0)
    return best, out


def bench_matmul():
    print("=== 1. matmul: наивный цикл, блочный numpy, BLAS ===")

    n = 64
    A = RNG.standard_normal((n, n))
    B = RNG.standard_normal((n, n))
    t_naive, C_naive = _time(matmul_naive, A, B, repeat=1)
    t_np, C_np = _time(matmul_numpy, A, B)
    print(f"n={n:4d}: python-loop {t_naive * 1e3:9.1f} ms | BLAS {t_np * 1e3:8.3f} ms "
          f"| x{t_naive / t_np:6.0f}")
    print(f"         max|loop - BLAS| = {np.abs(C_naive - C_np).max():.2e}")

    n = 512
    A = RNG.standard_normal((n, n))
    B = RNG.standard_normal((n, n))
    t_blk, C_blk = _time(matmul_blocked, A, B, repeat=1)
    t_np, C_np = _time(matmul_numpy, A, B)
    print(f"n={n:4d}: blocked     {t_blk * 1e3:9.1f} ms | BLAS {t_np * 1e3:8.3f} ms "
          f"| x{t_blk / t_np:6.1f}")
    print(f"         max|blocked - BLAS| = {np.abs(C_blk - C_np).max():.2e}")

    n = 1024
    A = RNG.standard_normal((n, n))
    B = RNG.standard_normal((n, n))
    t_np, _ = _time(matmul_numpy, A, B)
    print(f"n={n:4d}: BLAS        {t_np * 1e3:9.1f} ms -> {2 * n ** 3 / t_np / 1e9:6.1f} GFLOP/s")

    Bn, T = 32, 256
    A = RNG.standard_normal((Bn, T, T))
    B = RNG.standard_normal((Bn, T, T))
    t_loop, C_loop = _time(matmul_batched_loop, A, B, repeat=1)
    t_vec, C_vec = _time(matmul_numpy, A, B)
    print(f"batch {Bn}x{T}x{T}: loop {t_loop * 1e3:7.1f} ms | matmul {t_vec * 1e3:7.1f} ms "
          f"| x{t_loop / t_vec:5.1f}")
    print(f"         max|loop - matmul| = {np.abs(C_loop - C_vec).max():.2e}")


# ----------------------------------------------------------------------
# 2. Три оператора, из которых собран весь трансформер
# ----------------------------------------------------------------------

def rms_norm(x, w, eps=1e-6):
    """x / sqrt(mean(x^2) + eps) * w — нормировка по последней оси."""
    x = np.asarray(x, dtype=np.float32)
    w = np.asarray(w, dtype=np.float32)
    ms = np.mean(x * x, axis=-1, keepdims=True)   # keepdims обязателен для broadcast
    return (x / np.sqrt(ms + eps)) * w


def linear(x, W, b=None):
    """y = x @ W.T + b, где W имеет форму (out_features, in_features)."""
    x = np.asarray(x, dtype=np.float32)
    W = np.asarray(W, dtype=np.float32)
    y = x @ W.T
    if b is not None:
        y = y + np.asarray(b, dtype=np.float32)
    return np.asarray(y, dtype=np.float32)


def embedding(ids, table):
    """Lookup: ids (...,) int64 -> (..., d). Ровно ноль умножений."""
    table = np.asarray(table, dtype=np.float32)
    ids = np.asarray(ids, dtype=np.int64)
    return table[ids]


def embedding_onehot(ids, table):
    """Тот же результат через matmul с one-hot: в V раз больше работы."""
    table = np.asarray(table, dtype=np.float32)
    ids = np.asarray(ids, dtype=np.int64)
    eye = np.eye(table.shape[0], dtype=np.float32)
    return eye[ids] @ table


# ----------------------------------------------------------------------
# 3. Оракулы: torch как эталон
# ----------------------------------------------------------------------

RESULTS = []


def check(name, got, want, atol):
    got = np.asarray(got)
    assert got.dtype == np.float32, f"{name}: dtype {got.dtype} != float32"
    got = got.astype(np.float64)
    want = np.asarray(want, dtype=np.float64)
    assert got.shape == want.shape, f"{name}: форма {got.shape} != {want.shape}"
    diff = float(np.abs(got - want).max()) if got.size else 0.0
    ok = diff <= atol
    RESULTS.append(ok)
    print(f"[{'OK ' if ok else 'FAIL'}] {name:<26} max|diff|={diff:.2e}  atol={atol:.0e}")


def run_checks():
    print("\n=== 2. операторы против torch ===")
    assert tuple(map(int, torch.__version__.split(".")[:2])) >= (2, 4), \
        "F.rms_norm появился только в torch 2.4 — обновите torch"

    d, T, B = 1024, 5, 2

    # --- rms_norm, 3D ---
    x = RNG.standard_normal((B, T, d)).astype(np.float32)
    w = RNG.standard_normal((d,)).astype(np.float32)
    ref = F.rms_norm(torch.from_numpy(x), (d,), torch.from_numpy(w), eps=1e-6).numpy()
    check("rms_norm 3D", rms_norm(x, w), ref, 1e-5)

    # --- rms_norm, 2D ---
    x2 = RNG.standard_normal((10, d)).astype(np.float32)
    ref2 = F.rms_norm(torch.from_numpy(x2), (d,), torch.from_numpy(w), eps=1e-6).numpy()
    check("rms_norm 2D", rms_norm(x2, w), ref2, 1e-5)

    # --- linear с bias, 3D ---
    W = (RNG.standard_normal((2048, d)) / np.sqrt(d)).astype(np.float32)
    bias = (RNG.standard_normal((2048,)) * 0.02).astype(np.float32)
    ref3 = F.linear(torch.from_numpy(x), torch.from_numpy(W),
                    torch.from_numpy(bias)).numpy()
    check("linear 3D + bias", linear(x, W, bias), ref3, 1e-5)

    # --- linear без bias, 1D ---
    x1 = RNG.standard_normal((d,)).astype(np.float32)
    ref4 = F.linear(torch.from_numpy(x1), torch.from_numpy(W)).numpy()
    check("linear 1D, no bias", linear(x1, W), ref4, 1e-5)

    # --- embedding: точное совпадение ---
    V, de = 1000, 64
    table = RNG.standard_normal((V, de)).astype(np.float32)
    ids = RNG.integers(0, V, size=(2, 7))
    ref5 = F.embedding(torch.from_numpy(ids), torch.from_numpy(table)).numpy()
    check("embedding", embedding(ids, table), ref5, 0.0)

    # --- one-hot == lookup ---
    V, de = 8, 4
    table = RNG.standard_normal((V, de)).astype(np.float32)
    ids = np.array([3, 0, 7])
    check("one-hot == lookup", embedding_onehot(ids, table), embedding(ids, table), 0.0)

    # --- scale-invariance ---
    xs = RNG.standard_normal((3, d)).astype(np.float32)
    ones = np.ones((d,), dtype=np.float32)
    check("scale-invariance", rms_norm(7.5 * xs, ones), rms_norm(xs, ones), 1e-5)

    print(f"\nИтого: {sum(RESULTS)}/{len(RESULTS)} OK")
    return all(RESULTS)


# ----------------------------------------------------------------------
# 4. Арифметика памяти: Qwen3-0.6B
# ----------------------------------------------------------------------

def memory_arithmetic():
    print("\n=== 3. арифметика памяти: Qwen3-0.6B ===")
    V, d, L = 151936, 1024, 28
    H, KV, hd, inter = 16, 8, 128, 3072

    per_layer = (
        d * H * hd            # q_proj: 1024 -> 2048
        + d * KV * hd * 2     # k_proj, v_proj: 1024 -> 1024 каждый (GQA)
        + H * hd * d          # o_proj: 2048 -> 1024
        + 3 * d * inter       # gate, up, down
    )
    total = V * d + L * per_layer

    print(f"параметров: {total / 1e9:.3f} B (в карточке модели — 0.6 B)")
    for name, nbytes in (("fp32", 4), ("bf16/fp16", 2), ("int8", 1), ("int4", 0.5)):
        print(f"  веса в {name:>9}: {total * nbytes / 2 ** 30:7.2f} GiB")

    seq = 4096
    kv = 2 * L * KV * hd * seq * 2      # K и V, байт на один запрос
    print(f"  KV-cache при seq={seq}: {kv / 2 ** 20:7.1f} MiB на запрос "
          f"({kv / total / 2 * 100:.0f}% от весов)")
    print(f"  префилл: 2*N*tokens ≈ {2 * total / 1e9:.2f} GFLOP на токен")
    print(f"  decode: {total * 2 / 2 ** 30:.2f} GiB чтения весов на каждый токен")


if __name__ == "__main__":
    bench_matmul()
    ok = run_checks()
    memory_arithmetic()
    print("\nВсё зелёное." if ok else "\nЕсть FAIL — разбирайтесь по строкам выше.")
Типичный вывод на CPU (числа зависят от машины, важны порядки):
=== 1. matmul: наивный цикл, блочный numpy, BLAS ===
n=  64: python-loop     138.4 ms | BLAS    0.021 ms | x  6590
         max|loop - BLAS| = 1.14e-13
n= 512: blocked          94.2 ms | BLAS    9.780 ms | x   9.6
         max|blocked - BLAS| = 3.41e-13
n=1024: BLAS             74.1 ms ->   29.0 GFLOP/s
batch 32x256x256: loop  15.9 ms | matmul  12.1 ms | x  1.3
         max|loop - matmul| = 5.68e-14

=== 2. операторы против torch ===
[OK ] rms_norm 3D                  max|diff|=4.77e-07  atol=1e-05
[OK ] rms_norm 2D                  max|diff|=2.38e-07  atol=1e-05
[OK ] linear 3D + bias             max|diff|=1.19e-07  atol=1e-05
[OK ] linear 1D, no bias           max|diff|=9.54e-08  atol=1e-05
[OK ] embedding                    max|diff|=0.00e+00  atol=0e+00
[OK ] one-hot == lookup            max|diff|=0.00e+00  atol=0e+00
[OK ] scale-invariance             max|diff|=5.96e-08  atol=1e-05

Итого: 7/7 OK
Как проверить
python mod01.py— скрипт печатает три блока. Блок 2 должен закончиться строкойИтого: 7/7 OK.- Сверьте первые две строки блока 1: разрыв между python-loop и BLAS на
n=64должен быть в тысячи раз. Если у вас вышло «всего» 200×, значит цикл случайно векторизовался (например, вы использовалиnp.dotвместо скалярного+=). - Блочная версия на
n=512должна отставать от BLAS в 5–30×, но не в тысячи — это и есть цена отсутствия ассемблерного микроядра, потоков и выравнивания. - Блок 3 — не тест, а прикидка: сверьте
0.596 Bпараметров с карточкой модели. Если получилось 1.2 B, вы посчитали embedding дважды (в Qwen3 весаlm_headсвязаны сembed_tokens).
Разбор падений:
| Симптом | Причина |
|---|---|
AttributeError: rms_norm | torch < 2.4; либо обновите, либо считайте эталон вручную: x / torch.sqrt((x*x).mean(-1, keepdim=True) + eps) * w |
rms_norm: diff ~1e-3 | eps снаружи корня (sqrt(mean) + eps) вместо sqrt(mean + eps); либо mean по оси -2 |
rms_norm: diff ~1e-1 | забыли умножить на w или умножили до нормировки |
linear: diff ~1e0 | W хранится как (in, out) — потеряли транспонирование; в torch W всегда (out, in) |
linear 1D: IndexError/не та форма | x @ W.T при x.ndim == 1 даёт (out,) — это корректно; ошибка в том, что вы где-то расставили keepdims |
embedding: diff ≠ 0 | таблица прошла через арифметику (например, table * 1.0 в float64) или ids приведены к float |
scale-invariance: diff ~1e-2 | в eps попала размерность: сравниваете rms_norm(x, w) с rms_norm(7.5*x, 7.5*w) |
dtype != float32 | numpy повысил тип до float64 из-за np.mean без dtype; всегда кастуйте вход на границе функции |
Два вопроса, на которые нужен ответ перед сдачей (они же — критерий приёмки):
- Почему у
embeddingдопуск ровно нулевой? Потому что это не вычисление, а копирование битов:table[ids]возвращает те же 32-битные слова, что лежат в таблице. Ни одного сложения — ни одного округления. Любое расхождение означает баг, а не погрешность, и маскировать его допуском нельзя. - Почему у
linearдопуск 1e-5, хотя формула тоже «точная»? Потому чтоy_k = Σ_p x_p W_kp— это 1024 умножения и 1024 сложения в fp32. BLAS переставляет слагаемые (разбивает сумму на частичные, использует FMA, векторизует по 8–16 элементов), torch делает то же в своём порядке. Сложение в fp32 не ассоциативно, поэтому последние биты расходятся: относительная ошибка ~1e-7 * √1024 ≈ 3e-6, на значениях порядка единицы это и даёт1e-6…1e-5. Допуск 1e-5 — не «щедрость», а физический предел fp32 при такой длине редукции.
Дополнительно (по желанию): заверните проверки в pytest, оставив check как фикстуру, и добавьте тест linear при d_in = 4096 — увидите, что diff подрастает до ~3e-5, и поймёте, откуда берутся допуски в следующих модулях.
Сводка
-
matmul — единственная дорогая операция. Стоимость
C = ABдля(m,k) @ (k,n)— ровно2mnkFLOPs; всё остальное в трансформере по сравнению с этим дёшево. Наивный тройной цикл наn=64отстаёт от BLAS в ~6000×, блочная numpy-версия — в ~10×: разрыв закрывают кэш-блокировка, SIMD, FMA и многопоточность. Практический вывод: никогда не пишите циклы по ведущим осям, отдавайте батч вnp.matmulцеликом (цикл по батчу стоит ~1.3× на(32,256,256), но на(32,128,128)просадка уже двузначная). -
Трансформеру из линейной алгебры нужны четыре вещи: matmul (все проекции), transpose (соглашение
W: (out, in)), broadcast (bias, масштаб наw, деление на норму) и softmax по последней оси (следующий модуль). Всё остальное — их композиция. -
RMSNorm:
x / sqrt(mean(x²) + eps) * w, нормировка по последней оси,epsстрого под корнем,keepdims=Trueобязателен. Отличие от LayerNorm — отсутствие вычитания среднего: на один проход по данным меньше, нетbias, качество на практике то же.w— обучаемый, инициализируется единицами, поэтомуrms_normмасштабно-инвариантен:rms_norm(7.5x) == rms_norm(x)с точностью доeps. -
Embedding — это lookup, а не умножение.
table[ids]иone_hot(ids) @ tableдают побитово одинаковый результат, но второе делаетVлишних умножений на токен (приV=151936иd=1024это 155 MFLOP ради копирования 4 КБ). Поэтому в инференс-движках embedding — отдельный op, а неLinear. -
Linear:
y = x @ W.T + b,W: (out, in), работает для(in,),(T, in),(B, T, in)без единогоif— за счёт того, что@в numpy батчится по ведущим осям. -
Паттерн «оракул» — главный инструмент курса. Своя реализация проверяется против эталонной библиотеки на случайных входах, с фиксированным seed и явным допуском. Фиксируйте seed (иначе падение теста невоспроизводимо), сравнивайте на нескольких масштабах (
d=16,d=1024,d=4096— допуск растёт вместе с длиной редукции) и всегда печатайтеmax abs diff, а неallclose: первое число говорит, сколько именно вы потеряли, второе — только «прошло/не прошло». -
Допуски — не магия, а арифметика. Нулевой допуск там, где нет вычислений (embedding: копирование битов).
1e-5там, где fp32-редукция длиной ~10³: относительная ошибка ~1e-7 * √k, накопленная разным порядком суммирования в вашем коде и в BLAS. Всё, что выше1e-4приd=1024— уже не погрешность, а ошибка в формуле или в осях. -
Оси — источник 90% багов на этом этапе. Три правила, которые снимают почти все проблемы: нормировка всегда по
axis=-1, keepdims=True;Wв Linear —(out, in), поэтомуx @ W.T;bбродкастится по последней оси. Еслиmax abs diffвдруг~1e0— сначала проверьте, не перепутаны лиoutиin, и только потом лезьте в математику. -
Что должно остаться в руках после модуля: работающие
rms_norm,linear,embeddingна numpy, скриптcheck.pyс оракулом на torch и привычка к циклу «написал → сравнил с эталоном → посмотрел на число → объяснил число». В следующем модуле этот же цикл применим к softmax и attention — там оракулом будетtorch.nn.functional.scaled_dot_product_attention, а допуски вырастут до1e-4, потому что появятся экспоненты и суммы поT.
Навигация по курсу: Хаб курса · Предыдущий: Нужен ли тебе свой движок инференса и ландшафт путей · Следующий: Attention, RoPE и GQA