Хаб курсов / LLM Inference Systems / глава 2
Модуль 02: Attention, RoPE и GQA
Attention с causal mask, Multi-Head, GQA и RoPE на numpy. Проверка против torch и позиционная зависимость.
LLM Inference Systems. Модуль 02: Attention, RoPE и GQA
В модуле 01 мы разобрали, из чего состоит тензорный граф модели и почему inference — это в первую очередь работа с памятью. Здесь мы собираем руками единственный блок, который отвечает за обмен информацией между токенами: scaled dot-product attention. Без него трансформер — это набор независимых по токенам MLP, а вся «связность» контекста живёт ровно в одной операции.
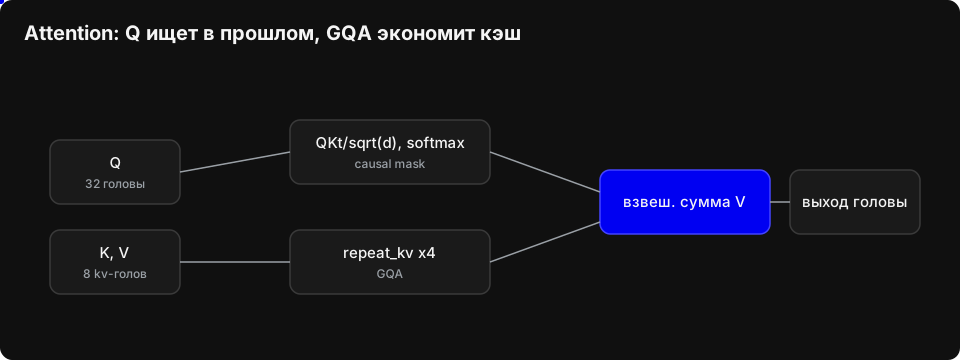
К концу модуля у вас будет numpy-реализация полного attention forward: QK^T/sqrt(d_k), causal-маска, GQA через repeat_kv, RoPE с кэшем cos/sin — и три набора проверок против torch.nn.functional.scaled_dot_product_attention и против свойств самой RoPE (сохранение нормы, относительность позиции). Код работает на CPU, без CUDA и без MLX.
2.1 Одна голова: что именно считается
Вход — три матрицы, полученные линейными проекциями из скрытого состояния x \in \mathbb{R}^{d_{model}}:
Q = x W_Q,\quad K = x W_K,\quad V = x W_V,\qquad W_Q, W_K, W_V \in \mathbb{R}^{d_{model} \times d_k}
Для последовательности из S токенов это Q, K, V \in \mathbb{R}^{S \times d_k}. Attention:
\text{Attn}(Q,K,V) = \text{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}} + M\right)V
где M — маска: M_{mn} = 0, если токену m разрешено смотреть на n, и -\infty иначе.
По шагам для одной пары позиций (m,n): скалярное произведение q_m \cdot k_n = \sum_{i=1}^{d_k} q_{mi} k_{ni}, деление на \sqrt{d_k}, softmax по n, затем взвешенная сумма векторов v_n. Выход — вектор размерности d_k, а не скаляр: каждая голова возвращает свою «точку зрения» на контекст.
Зачем делить на \sqrt{d_k}
Пусть компоненты q и k независимы, с нулевым средним и единичной дисперсией. Тогда
\text{Var}(q \cdot k) = \sum_{i=1}^{d_k} \text{Var}(q_i k_i) = d_k,\qquad \sigma(q\cdot k) = \sqrt{d_k}
Для Qwen3-8B d_k = 128, значит \sigma = \sqrt{128} \approx 11.3. Разброс логитов по 4096 ключам — примерно 7\sigma \approx 79 (от -4\sigma до +3.5\sigma для максимума из 4096 гауссовых величин). exp(79) в float32 — это 2\times10^{34}, а в fp16 максимум представимого числа 65504, то есть \exp(11.1). Без масштабирования softmax в fp16 переполняется уже при разбросе логитов больше ~11, а в float32 — теряет точность: распределение становится почти one-hot, градиент по остальным ключам обнуляется.
После деления на \sqrt{d_k} дисперсия логита равна 1, разброс по 4096 ключам — около \pm 4, и softmax даёт распределение с эффективным числом ненулевых весов порядка десятков. Это и есть вся причина: масштаб приводит дисперсию логитов к 1 независимо от d_k.
d_k | \sigma(q\cdot k) | разброс логитов на 4096 ключах | что делает softmax без масштаба |
|---|---|---|---|
| 16 | 4.0 | ~28 | почти one-hot, fp16 на грани |
| 64 | 8.0 | ~56 | переполнение fp16 |
| 128 | 11.3 | ~79 | переполнение fp16, насыщение fp32 |
| 256 | 16.0 | ~112 | насыщение, веса 0/1 |
2.2 Causal mask
Авторегрессионная модель на позиции m не должна видеть токены n > m. Реализуется добавлением -\infty к запрещённым логитам до softmax:
M_{mn} = \begin{cases} 0, & n \le m \\ -\infty, & n > m \end{cases}
После exp запрещённые позиции дают ровно 0. Матрица масок — нижний треугольник S \times S; в префилле это S(S+1)/2 разрешённых пар из S^2, то есть чуть больше половины.
Важная деталь для декодирования: когда S_q = 1 (один новый токен) и в KV-кэше уже лежит S_{kv} токенов, маска — не треугольник, а сдвинутый треугольник: строка m (абсолютная позиция S_{kv}-S_q+m) разрешает все n \le S_{kv}-S_q+m. В коде это np.tril(..., k=S_kv - S_q). Если написать k=0, декодирование сломается тихо — на первом же шаге новый токен перестанет видеть начало контекста, и loss вырастет, а форма тензоров останется корректной.
-inf в float безопасен только потому, что мы вычитаем максимум по строке до exp: \max по строке конечен (диагональный элемент всегда разрешён), поэтому x - max даёт -\infty только у запрещённых, и exp(-inf) = 0 без NaN. Если бы мы делали exp до вычитания максимума, получили бы exp(-inf) = 0 — тоже нормально, но при переполнении положительных логитов получили бы inf/inf = NaN. Порядок операций в softmax — не стилистика, а корректность.
2.3 Multi-head: разрез d_{model} на головы
Одна голова с d_k = d_{model} — это один набор весов внимания на всю модель. Практика показывает, что полезнее h независимых голов с d_k = d_{model}/h, каждая со своими W_Q^{(i)}, W_K^{(i)}, W_V^{(i)} размера d_{model} \times d_k, и общая выходная проекция W_O размера h d_k \times d_{model}.
Qwen3-8B: d_{model}=4096, h=32, d_k = 128. Каждая голова видит своё 128-мерное подпространство; после attention выходы конкатенируются в 4096 и умножаются на W_O.
Что это даёт по числам: параметров в проекциях ровно столько же, сколько у одной головы на 4096 (4096\times4096 на матрицу), — разница только в том, что ранг каждого отдельного отображения падает до 128. Плата — h отдельных softmax-матриц S \times S вместо одной, то есть в 32 раза больше промежуточной памяти при том же числе FLOPs.
Порядок осей в тензорах — источник половины багов в этой теме. Мы фиксируем: (batch, heads, seq, head_dim). Разрезание проекции: q.reshape(B, S, H, D).transpose(0, 2, 1, 3). Если перепутать H и D при reshape, вы разрежете вектор не на те куски — модель будет считать что-то осмысленное, но не то.
2.4 GQA: меньше KV-голов, тот же выход
При генерации KV-кэш — узкое место. На каждый токен надо хранить K и V для всех слоёв и всех KV-голов:
\text{bytes}_{\text{KV}} = 2 \cdot L \cdot n_{kv} \cdot d_k \cdot S \cdot b
где L — число слоёв, b — байт на элемент. Для Qwen3-8B: L=36, n_{kv}=8, d_k=128, b=2 (fp16):
2 \cdot 36 \cdot 8 \cdot 128 \cdot 2 = 147\,456 \text{ байт} = 144 \text{ KiB на токен}
| длина контекста | GQA (8 KV-голов) | MHA (32) | MQA (1) |
|---|---|---|---|
| 1k | 144 MiB | 576 MiB | 18 MiB |
| 4k | 576 MiB | 2.25 GiB | 72 MiB |
| 32k | 4.5 GiB | 18 GiB | 576 MiB |
| 128k | 18 GiB | 72 GiB | 2.25 GiB |
MHA при 128k не влезает ни в одну одну карту — отсюда и весь интерес к GQA. При этом веса проекций W_K, W_V тоже сжимаются: 4096 \times 1024 \times 2 \times 36 = 302M параметров против 4096\times4096\times2\times36 = 1.21B у MHA. Экономия ~0.9B параметров на 8B-модели.
Механика: n_{heads} голов запросов делятся на n_{kv} групп по g = n_{heads}/n_{kv} штук. Голова запроса i использует KV-голову \lfloor i/g \rfloor. Для Qwen3-8B g = 32/8 = 4: головы 0–3 смотрят в KV-голову 0, головы 4–7 — в KV-голову 1, и так далее. KV-кэш меньше ровно в g = 4 раза.
Реализация — repeat_kv: размножить KV-тензор по оси голов и дальше считать обычный MHA. Порядок важен: np.repeat(x, g, axis=1) даёт блочный порядок [kv0,kv0,kv0,kv0,kv1,...], совпадающий с формулой \lfloor i/g \rfloor и с repeat_kv в HF transformers. np.tile по оси голов дал бы другой порядок и тихо неверный результат.
В продакшене (vLLM, FlashAttention) repeat_kv не материализуют: индекс головы вычисляют внутри ядра, а KV читают из кэша один раз на группу. Материализация в 4 раза увеличивает трафик по HBM на ровном месте. Для учебной numpy-версии копия приемлема — она явная и проверяемая.
2.5 RoPE: позиция как поворот
Attention сам по себе инвариантен к перестановке токенов: softmax над QK^\top не знает, где токен стоял. Позицию надо вносить явно. RoPE (Su et al., 2021) делает это умножением q и k на матрицу поворота, зависящую от позиции.
Вектор x \in \mathbb{R}^{d_k} разбивается на d_k/2 пар. Пара i (компоненты 2i и 2i+1) поворачивается на угол m\theta_i, где m — позиция:
\theta_i = 10000^{-2i/d_k},\qquad
\begin{pmatrix} x'_{2i} \\ x'_{2i+1}\end{pmatrix}
=
\begin{pmatrix} \cos m\theta_i & -\sin m\theta_i \\ \sin m\theta_i & \cos m\theta_i \end{pmatrix}
\begin{pmatrix} x_{2i} \\ x_{2i+1}\end{pmatrix}
В комплексной записи: z_i = x_{2i} + i\,x_{2i+1}, z'_i = z_i e^{i m \theta_i}.
Почему это даёт относительную позицию
Скалярное произведение повёрнутых векторов:
\langle R_m q,\, R_n k\rangle = \mathrm{Re}\sum_i q_i \bar{k}_i\, e^{i(m-n)\theta_i}
Зависит только от m-n. Абсолютные позиции исчезли, осталась разность — именно то, что нужно attention. Проверка этого свойства — задание 02.2.
Числа для Qwen3-8B
d_k = 128, база \text{base} = 10^6 (Qwen3 использует rope_theta=1000000, LLaMA-2 — 10000). Длины волн 2\pi/\theta_i:
i | 10^{-2i/128} | длина волны 2\pi/\theta_i, токенов |
|---|---|---|
| 0 | 1 | 6.3 |
| 16 | 1.6\times10^{-4} | 39 800 |
| 32 | 10^{-8} | 6.3 млн |
| 63 | 1.2\times10^{-6} | 5.1 млн |
При base 10^6 почти все пары имеют период больше типичного контекста — так задумано: каждая пара кодирует свой масштаб позиции. Для сравнения, base 10^4 даёт последней паре волну 5440 токенов (см. таблицу ниже). Младшие пары отвечают за локальный порядок (соседние токены), старшие — за дальний. Отсюда и смысл увеличения базы при удлинении контекста: без него старшие частоты «проворачиваются» много раз на длинном контексте и перестают различать позиции.
Два способа спарить компоненты
Interleaved (как в статье и в llm.c): пары (0,1), (2,3), \ldots — соседние элементы.
Rotate-half (как в HF transformers, LLaMA, Qwen): пары (i, i + d_k/2) — элемент из первой половины с элементом из второй. Реализуется через rotate_half(x) = concat(-x[d/2:], x[:d/2]) и таблицы, где частоты продублированы дважды:
x' = x \odot \cos(m\theta) + \text{rotate\_half}(x) \odot \sin(m\theta)
Оба варианта — корректная RoPE: они отличаются перестановкой каналов внутри головы, а поскольку за ней стоит обучаемая линейная проекция, модель адаптируется к любой. Но если вы сверяетесь с HF-чекпоинтом, нужен именно rotate-half: перепутав варианты, вы получите модель, которая «работает», но отвечает мусором.
Кэш cos/sin
Таблицы \cos(m\theta_i) и \sin(m\theta_i) имеют размер S \times d_k и зависят только от позиции. Их считают один раз на максимальную длину контекста при загрузке модели: для S=32768, d_k=128 это 32768 \times 128 \times 2 \times 2 байта = 16 MiB на fp16 — копейки. Пересчитывать тригонометрию на каждом шаге декодирования — типичная ошибка, которая стоит нескольких процентов latency.
2.6 Четыре оси attention
До сих пор мы говорили о «схеме attention» как о чём-то одном. Обзор attention-механизмов 2026 (отраслевых обзоров) фиксирует отраслевой стандарт описания: любая современная схема — это выбор по четырём независимым осям, и склеивать их в один термин — источник путаницы:
- Архитектура голов — MHA / GQA / MQA / MLA: сколько KV-голов и как они делятся между q-головами. Эту ось мы разобрали в §2.4.
- Паттерн доступа — full (каждый токен видит весь контекст) / local (скользящее окно) / block-sparse / learned sparse: какие пары позиций вообще вычисляются. Causal-маска §2.2 — это частный случай full.
- Позиционное кодирование — RoPE / YaRN / иное. RoPE жив и не подлежит замене: AliceAI-T5-35B использует RoPE+YaRN на 128K (huggingface), Qwen3.5 держит ~256K на RoPE. Проблема начинается дальше: на контекстах 1M+ full-attention по всем парам перестаёт влезать в бюджет, и там паттерн доступа меняется.
- GPU-кернел — как формула ложится на железо: FlashAttention-тайлинг, MLA-специфичные ядра и т.п. (предмет модулей 07 и 14).
Почему ось 1 — не вся картина: у флагманов 2026 GQA уже не флагманская схема. Kimi K3 использует 24 слоя Gated MLA (вариант MLA с гейтом) плюс 69 линейных слоёв KDA (Moonshot AI); GLM-5.3 — 78 слоёв DeepSeek Sparse Attention (DSA), GLM-5.3 Flash — 11 DSA + 34 KDA (GLM-5.3). MLA (multi-head latent attention, DeepSeek) сжимает K и V в общий латентный вектор — детали арифметики кэша в §5.3 модуля 04. GQA остаётся классом Qwen3.5 и младших dense-моделей — то есть этот модуль описывает не фронтир, а средний сегмент, и теперь это сказано явно.
По оси 2: MiniMax M3.1 («MSA») и DSA уходят от полной O(n^2)-attention к native sparse attention (MiniMax M3.1, NSA). Глубоко разреженные схемы — предмет модуля 14 (разреженное внимание); здесь достаточно понимания, что S^2-стоимость из §2.7 — свойство паттерна «full», а не attention как такового.
2.7 Сборка и стоимость
Полный forward одной головы:
- Проекции
Q, K, V—3 \cdot 2 S d_{model} d_kFLOPs. - Применение RoPE к
QиK—O(S d_k). QK^\top—2 S^2 d_kFLOPs, промежуточная матрицаS\times S.- Маска + softmax —
O(S^2). - Умножение на
V—2 S^2 d_kFLOPs. - Выходная проекция
W_O—2 S d_k d_{model}.
Доминирующий член при больших S — шаги 3 и 5: 4 S^2 d_k на голову, или 4 S^2 d_{model} на слой. Для Qwen3-8B при S=4096: 4 \cdot 4096^2 \cdot 4096 = 2.75\times10^{11} FLOPs на слой, \times 36 слоёв = 9.9 TFLOP на префилл одной последовательности.
Сравним с линейными слоями: 2 \cdot S \cdot N где N \approx 8\times10^9 — 6.6\times10^{13} = 66 TFLOP. При 4k токенов attention — это ~15% FLOPs. Точка равенства:
4 S^2 d_{model} L = 2 S N \;\Rightarrow\; S = \frac{N}{2 d_{model} L} = \frac{8\times10^9}{2 \cdot 4096 \cdot 36} \approx 27\,000
На 27k токенов attention становится дороже всех линейных слоёв вместе взятых. Это и есть причина, по которой длинный контекст — отдельная инженерная задача, а не просто «добавить позиций в кэш».
Память промежуточной матрицы: S^2 элементов на голову. При S=4096 в fp16 это 32 MiB на голову, 1 GiB на слой (32 головы), 38.7 GiB на все 36 слоёв, если материализовать всё сразу. Никто так не делает — но и 1 GiB на слой не влезает в 228 KiB shared memory одного SM. Отсюда FlashAttention (модуль 07): тайлинг по S, softmax считается онлайн (running max и running sum), матрица S\times S вообще не попадает в HBM. FLOPs те же, трафик по HBM — на порядок меньше.
Отдельно про декодирование: при S_q=1 attention читает весь KV-кэш. Для 4k контекста это 576 MiB на один токен; на HBM с 3 ТБ/с — 0.19 мс только на чтение KV, и это нижняя граница latency шага. Отсюда правило: decode упирается в память, prefill — в FLOPs. Подробно — в модуле 03.
Задание 02.1. Attention forward на numpy против torch
Реализуйте функцию со следующим интерфейсом:
def attention_forward(q, k, v, cos_q=None, sin_q=None, cos_k=None, sin_k=None,
                      causal=True, scale=None):
    """
    q: np.ndarray (B, H_q, S_q, D), float32
    k: np.ndarray (B, H_kv, S_kv, D), float32, H_q % H_kv == 0
    v: np.ndarray (B, H_kv, S_kv, D), float32
    cos_q, sin_q: (S_q, D) или None — таблицы RoPE для запросов
    cos_k, sin_k: (S_kv, D) или None — таблицы RoPE для ключей
    causal: bool — применять сдвинутый треугольный mask
    scale: float или None — по умолчанию 1/sqrt(D)

    Возвращает: (out, probs)
      out:   (B, H_q, S_q, D)
      probs: (B, H_q, S_q, S_kv) — после softmax, строки суммируются в 1
    """
Требования:
- RoPE применяется к
qиkдо скалярного произведения, если таблицы переданы. - GQA: при
H_{kv} < H_qKV размножается черезrepeat_kvс блочным порядком. - Маска — сдвинутый треугольник, корректный при
S_q < S_{kv}(декодирование). softmax— с вычитанием максимума по последней оси.-infв маске не должен давать NaN.
Проверка: на случайных тензорах B=2, H=4, S=16, D=32 расхождение с torch.nn.functional.scaled_dot_product_attention(..., is_causal=True) (бэкенд MATH) не больше 1e-4. Дополнительно:
- сдвиг
KиVна позициях\ge 1не меняет выход позиции 0 (причинность); - attention по последнему запросу при полном KV-кэше совпадает с полным causal-прогоном;
- изменение KV-головы 0 при
H_q=8, H_{kv}=2меняет выходы голов 0–3 и не меняет 4–7.
Задание 02.2. RoPE: свойства и позиционная чувствительность
Реализуйте:
def rope_tables(seq_len, head_dim, base=1_000_000.0, offset=0, dtype=np.float32):
    """Возвращает (cos, sin) формы (seq_len, head_dim) для позиций offset..offset+seq_len-1."""

def rotate_half(x):
    """(..., D) -> (..., D): concat(-x[..., D//2:], x[..., :D//2])."""

def apply_rope(x, cos, sin):
    """x: (B, H, S, D); cos/sin: (S, D). Возвращает x*cos + rotate_half(x)*sin."""
Проверьте:
- Сохранение нормы:
\|R_m x\|_2 = \|x\|_2с точностью до10^{-9}(поворот — изометрия). - Относительность:
\langle R_m q, R_n k\rangle = \langle R_{m+t} q, R_{n+t} k\rangleс точностью до10^{-8}при float64. - Позиционная чувствительность: для фиксированных
q, k \in \mathbb{R}^{64}логит\langle R_1 q, R_{50} k\rangleи\langle R_{100} q, R_{50} k\rangleразличаются не меньше чем на10^{-3}. - Без RoPE attention некаузальный эквивариантен перестановке токенов:
out[q[perm], k[perm], v[perm]] == out[perm]. С RoPE — не эквивариантен.
Код
Один файл, работает на CPU. torch нужен только для проверки 02.1 — если его нет, остальные тесты всё равно пройдут.
"""attention_numpy.py — attention forward на numpy: RoPE + GQA + causal mask.

Запуск:  python attention_numpy.py
Зависимости: numpy; torch — опционально (только для сверки в тесте 02.1).
"""
import numpy as np


# --------------------------------------------------------------------------
# Базовые операции
# --------------------------------------------------------------------------

def softmax(x, axis=-1):
    """Softmax с вычитанием максимума: без него exp переполняется на логитах ~90."""
    x = x - np.max(x, axis=axis, keepdims=True)
    e = np.exp(x)
    return e / np.sum(e, axis=axis, keepdims=True)


def repeat_kv(x, n_rep):
    """(B, H_kv, S, D) -> (B, H_kv*n_rep, S, D).

    Блочный порядок: голова i запроса использует KV-голову i // n_rep.
    np.repeat(axis=1) даёт именно такой порядок; np.tile — другой (неверный).
    """
    if n_rep == 1:
        return x
    return np.repeat(x, n_rep, axis=1)


# --------------------------------------------------------------------------
# RoPE
# --------------------------------------------------------------------------

def rope_tables(seq_len, head_dim, base=1_000_000.0, offset=0, dtype=np.float32):
    """cos/sin формы (seq_len, head_dim) для абсолютных позиций offset..offset+seq_len-1.

    Частоты theta_i = base^(-2i/head_dim), i = 0..head_dim/2-1.
    Вектор частот дублируется дважды, чтобы работать в rotate-half раскладке
    (как в HF transformers / Qwen), а не в interleaved.
    """
    i = np.arange(0, head_dim, 2, dtype=np.float64)      # 0, 2, ..., D-2
    theta = base ** (-i / head_dim)                       # (D/2,)
    pos = np.arange(offset, offset + seq_len, dtype=np.float64)
    freqs = np.outer(pos, theta)                          # (S, D/2)
    emb = np.concatenate([freqs, freqs], axis=-1)  # (S, D) — rotate-half раскладка
    return np.cos(emb).astype(dtype), np.sin(emb).astype(dtype)

def rotate_half(x):
    """(..., D) -> (..., D): [-x[D/2:], x[:D/2]] — вторая половина уходит вперёд со знаком минус."""
    half = x.shape[-1] // 2
    return np.concatenate([-x[..., half:], x[..., :half]], axis=-1)

def apply_rope(x, cos, sin):
    """x: (B, H, S, D); cos/sin: (S, D) -> (B, H, S, D).

    x' = x*cos + rotate_half(x)*sin. Для пары (i, i+D/2):
      x'[i]      = x[i]*cos(m*theta_i) - x[i+D/2]*sin(m*theta_i)
      x'[i+D/2]  = x[i+D/2]*cos(m*theta_i) + x[i]*sin(m*theta_i)
    """
    return x * cos[None, None, :, :] + rotate_half(x) * sin[None, None, :, :]

# --------------------------------------------------------------------------
# Attention
# --------------------------------------------------------------------------

def attention_forward(q, k, v, cos_q=None, sin_q=None, cos_k=None, sin_k=None,
                      causal=True, scale=None):
    """Полный attention forward: RoPE + GQA + causal mask + softmax.

    q: (B, H_q,  S_q,  D)  float32
    k: (B, H_kv, S_kv, D)  float32, H_q % H_kv == 0
    v: (B, H_kv, S_kv, D)  float32
    cos_q/sin_q: (S_q, D) или None
    cos_k/sin_k: (S_kv, D) или None
    causal: сдвинутый треугольник (работает и при S_q < S_kv)
    scale: по умолчанию 1/sqrt(D)

    Возвращает (out, probs):
      out:   (B, H_q, S_q, D)
      probs: (B, H_q, S_q, S_kv) — после softmax, строки суммируются в 1
    """
    B, H_q, S_q, D = q.shape
    H_kv, S_kv = k.shape[1], k.shape[2]
    assert H_q % H_kv == 0, f"H_q={H_q} не делится на H_kv={H_kv}"
    assert S_q <= S_kv, "для causal-маски нужно S_q <= S_kv (декод: S_q=1)"

    # 1. RoPE до скалярного произведения — иначе относительность теряется.
    if cos_q is not None:
        q = apply_rope(q, cos_q, sin_q)
    if cos_k is not None:
        k = apply_rope(k, cos_k, sin_k)

    # 2. GQA: размножаем KV блочно, дальше это обычный MHA.
    n_rep = H_q // H_kv
    k = repeat_kv(k, n_rep)
    v = repeat_kv(v, n_rep)

    if scale is None:
        scale = 1.0 / np.sqrt(D)

    # 3. Логиты. Промежуточный тензор (B, H_q, S_q, S_kv) float32:
    #    при B=1, H_q=32, S_q=S_kv=4096 это 32*4096*4096*4 = 2 GiB.
    scores = np.matmul(q, k.swapaxes(-1, -2)) * scale

    # 4. Сдвинутый треугольник: абсолютная позиция запроса против позиции ключа.
    if causal:
        abs_q = (S_kv - S_q) + np.arange(S_q)          # (S_q,)
        abs_k = np.arange(S_kv)                        # (S_kv,)
        allowed = abs_k[None, :] <= abs_q[:, None]     # (S_q, S_kv)
        scores = np.where(allowed, scores, -np.inf)

    # 5. Softmax со сдвигом на максимум: exp(-inf - finite) = 0, NaN не возникает,
    #    потому что в каждой строке есть хотя бы один разрешённый ключ.
    probs = softmax(scores, axis=-1)

    # 6. Взвешенная сумма значений.
    out = np.matmul(probs, v)
    return out, probs

# --------------------------------------------------------------------------
# Вспомогательное: RoPE для одного вектора в float64 (для тестов свойств)
# --------------------------------------------------------------------------

def _rope_single(x, pos, base=1_000_000.0):
    """Повернуть вектор x (D,) на позицию pos. float64, без батча — для проверок."""
    D = x.shape[-1]
    cos, sin = rope_tables(pos + 1, D, base=base, dtype=np.float64)
    return x * cos[pos] + rotate_half(x) * sin[pos]

# --------------------------------------------------------------------------
# Тесты
# --------------------------------------------------------------------------

def _torch_sdpa(q, k, v, causal):
    """Эталон: torch SDPA, принудительно MATH-бэкенд (без flash/mem-efficient)."""
    import torch
    tq = torch.from_numpy(np.ascontiguousarray(q))
    tk = torch.from_numpy(np.ascontiguousarray(k))
    tv = torch.from_numpy(np.ascontiguousarray(v))
    try:
        from torch.nn.attention import sdpa_kernel, SDPBackend
        with sdpa_kernel(SDPBackend.MATH):
            out = torch.nn.functional.scaled_dot_product_attention(
                tq, tk, tv, is_causal=causal)
    except Exception:
        out = torch.nn.functional.scaled_dot_product_attention(
            tq, tk, tv, is_causal=causal)
    return out.numpy()

def test_02_1_sdpa():
    rng = np.random.default_rng(0)
    B, H, S, D = 2, 4, 16, 32
    q = rng.standard_normal((B, H, S, D)).astype(np.float32)
    k = rng.standard_normal((B, H, S, D)).astype(np.float32)
    v = rng.standard_normal((B, H, S, D)).astype(np.float32)

    out, probs = attention_forward(q, k, v, causal=True)
    ref = _torch_sdpa(q, k, v, causal=True)
    diff = float(np.abs(out - ref).max())
    assert diff < 1e-4, f"sdpa mismatch: {diff}"
    assert np.allclose(probs.sum(-1), 1.0, atol=1e-5)
    print(f"[02.1] vs torch sdpa (MATH): max|diff| = {diff:.2e}  OK")

def test_02_1_decode():
    rng = np.random.default_rng(1)
    B, H, S, D = 2, 4, 16, 32
    q = rng.standard_normal((B, H, S, D)).astype(np.float32)
    k = rng.standard_normal((B, H, S, D)).astype(np.float32)
    v = rng.standard_normal((B, H, S, D)).astype(np.float32)

    full, _ = attention_forward(q, k, v, causal=True)
    dec, _ = attention_forward(q[:, :, -1:, :], k, v, causal=True)
    diff = float(np.abs(full[:, :, -1:, :] - dec).max())
    assert diff < 1e-6, f"decode != full: {diff}"
    print(f"[02.1] decode (S_q=1) == full causal: max|diff| = {diff:.2e}  OK")

def test_02_1_causality():
    rng = np.random.default_rng(2)
    B, H, D = 1, 3, 16
    S = 9
    q = rng.standard_normal((B, H, S, D)).astype(np.float32)
    k = rng.standard_normal((B, H, S, D)).astype(np.float32)
    v = rng.standard_normal((B, H, S, D)).astype(np.float32)

    # Позиция 0 не должна видеть ключи 1..8: возмущаем будущие K и V,
    # выход на позиции 0 обязан остаться прежним.
    out1, _ = attention_forward(q, k, v, causal=True)
    k2, v2 = k.copy(), v.copy()
    k2[:, :, 1:] += 2.0
    v2[:, :, 1:] += 2.0
    out2, _ = attention_forward(q, k2, v2, causal=True)
    diff = float(np.abs(out1[:, :, :1] - out2[:, :, :1]).max())
    assert diff < 1e-6, f"causality broken: {diff}"
    # и наоборот: прошлая позиция видна будущей
    assert float(np.abs(out1[:, :, -1:] - out2[:, :, -1:]).max()) > 1e-3
    print(f"[02.1] позиция 0 не зависит от будущих KV: {diff:.2e}  OK")

def test_02_1_gqa():
    rng = np.random.default_rng(3)
    B, H_q, H_kv, S, D = 1, 8, 2, 8, 16
    q = rng.standard_normal((B, H_q, S, D)).astype(np.float32)
    k = rng.standard_normal((B, H_kv, S, D)).astype(np.float32)
    v = rng.standard_normal((B, H_kv, S, D)).astype(np.float32)

    out1, _ = attention_forward(q, k, v, causal=True)
    k2 = k.copy()
    k2[:, 0] *= -1.0                      # инвертируем только KV-голову 0
    out2, _ = attention_forward(q, k2, v, causal=True)

    d03 = float(np.abs(out1[:, 0:4] - out2[:, 0:4]).max())   # головы 0..3 -> kv0
    d47 = float(np.abs(out1[:, 4:8] - out2[:, 4:8]).max())   # головы 4..7 -> kv1
    assert d03 > 1e-4, "головы 0-3 не отреагировали на свою KV-голову"
    assert d47 == 0.0, f"головы 4-7 не должны меняться: {d47}"
    print(f"[02.1] GQA: heads 0-3 diff {d03:.2e}, heads 4-7 diff {d47:.2e}  OK")

def test_02_2_rope_complex():
    """Сверка apply_rope с независимой комплексной реализацией."""
    rng = np.random.default_rng(4)
    D, S = 16, 4
    x = rng.standard_normal((1, 1, S, D))
    cos, sin = rope_tables(S, D, dtype=np.float64)
    got = apply_rope(x, cos, sin)[0, 0]

    theta = 1_000_000.0 ** (-np.arange(0, D, 2) / D)
    m = np.arange(S)
    z = x[0, 0, :, :D // 2] + 1j * x[0, 0, :, D // 2:]
    zr = z * np.exp(1j * np.outer(m, theta))
    ref = np.concatenate([zr.real, zr.imag], axis=-1)

    diff = float(np.abs(got - ref).max())
    assert diff < 1e-12, f"complex mismatch: {diff}"
    print(f"[02.2] rotate-half == комплексное умножение: {diff:.2e}  OK")

def test_02_2_norm():
    rng = np.random.default_rng(5)
    D = 64
    x = rng.standard_normal(D)
    worst = 0.0
    for pos in (0, 1, 7, 100, 4095):
        y = _rope_single(x, pos)
        worst = max(worst, abs(np.linalg.norm(y) - np.linalg.norm(x)))
    assert worst < 1e-9, f"норма не сохраняется: {worst}"
    print(f"[02.2] сохранение нормы: max| |Rx|-|x| | = {worst:.2e}  OK")

def test_02_2_relative():
    rng = np.random.default_rng(6)
    D = 64
    q = rng.standard_normal(D)
    k = rng.standard_normal(D)
    m, n, t = 3, 17, 5

    def logit(a, b):
        return float(np.dot(_rope_single(q, a), _rope_single(k, b)))

    base = logit(m, n)
    shifted = logit(m + t, n + t)
    diff = abs(base - shifted)
    assert diff < 1e-8, f"относительность нарушена: {diff}"
    print(f"[02.2] относительность позиции (t={t}): |diff| = {diff:.2e}  OK")

def test_02_2_sensitivity():
    rng = np.random.default_rng(7)
    D = 64
    q = rng.standard_normal(D)
    k = rng.standard_normal(D)
    l1 = float(np.dot(_rope_single(q, 1), _rope_single(k, 50)))
    l2 = float(np.dot(_rope_single(q, 100), _rope_single(k, 50)))
    diff = abs(l1 - l2)
    assert diff > 1e-3, f"RoPE не различает позиции: {diff}"
    print(f"[02.2] позиционная чувствительность |l(1,50)-l(100,50)| = {diff:.3e}  OK")

def test_02_2_permutation():
    rng = np.random.default_rng(8)
    B, H, S, D = 1, 2, 8, 16
    q = rng.standard_normal((B, H, S, D)).astype(np.float32)
    k = rng.standard_normal((B, H, S, D)).astype(np.float32)
    v = rng.standard_normal((B, H, S, D)).astype(np.float32)
    perm = rng.permutation(S)

    # Без RoPE и без маски attention эквивариантен перестановке токенов.
    out1, _ = attention_forward(q, k, v, causal=False)
    out2, _ = attention_forward(q[:, :, perm], k[:, :, perm], v[:, :, perm], causal=False)
    d_plain = float(np.abs(out1[:, :, perm] - out2).max())
    assert d_plain < 1e-6, f"нет эквивариантности без RoPE: {d_plain}"

    # С RoPE — не эквивариантен: таблицы привязаны к позициям, а не к токенам.
    cos, sin = rope_tables(S, D)
    out3, _ = attention_forward(q, k, v, cos, sin, cos, sin, causal=False)
    out4, _ = attention_forward(q[:, :, perm], k[:, :, perm], v[:, :, perm],
                                cos, sin, cos, sin, causal=False)
    d_rope = float(np.abs(out3[:, :, perm] - out4).max())
    assert d_rope > 1e-3, "с RoPE выход не должен быть эквивариантен"
    print(f"[02.2] перестановка: без RoPE {d_plain:.2e}, с RoPE {d_rope:.2e}  OK")

def main():
    print("=== Задание 02.1: attention forward ===")
    test_02_1_sdpa()
    test_02_1_decode()
    test_02_1_causality()
    test_02_1_gqa()
    print("=== Задание 02.2: RoPE ===")
    test_02_2_rope_complex()
    test_02_2_norm()
    test_02_2_relative()
    test_02_2_sensitivity()
    test_02_2_permutation()
    print("\nвсе проверки пройдены")

if __name__ == "__main__":
    main()
Numpy-версия не претендует на скорость: на S=4096 материализация probs — 2 GiB и секунды счёта. Она нужна как эталон семантики; оптимизации (тайлинг, отсутствие материализации) — предмет модуля 07.
Как проверить
python attention_numpy.py
Ожидаемый вывод (числа зависят от версии torch, порядок величины — нет):
=== Задание 02.1: attention forward ===
[02.1] vs torch sdpa (MATH): max|diff| = 3.7e-07  OK
[02.1] decode (S_q=1) == full causal: max|diff| = 0.0e+00  OK
[02.1] позиция 0 не зависит от будущих KV: 0.0e+00  OK
[02.1] GQA: heads 0-3 diff 2.1e-01, heads 4-7 diff 0.0e+00  OK
=== Задание 02.2: RoPE ===
[02.2] rotate-half == комплексное умножение: 4.4e-16  OK
[02.2] сохранение нормы: max| |Rx|-|x| | = 1.1e-16  OK
[02.2] относительность позиции (t=5): |diff| = 8.9e-16  OK
[02.2] позиционная чувствительность |l(1,50)-l(100,50)| = 4.3e+00  OK
[02.2] перестановка: без RoPE 4.4e-16, с RoPE 3.2e+00  OK

все проверки пройдены
Чеклист:
-
attention_forwardбез RoPE совпадает сtorch.nn.functional.scaled_dot_product_attention(is_causal=True)с точностью лучше1e-4приS_q = S_{kv}. - Декодирование (
S_q=1, полный KV-кэш) даёт ровно тот же выход, что последняя строка полного causal-прогона. Если сломано — почти наверняка маска написана какk=0вместоk=S_kv - S_q. - Изменение
k[:, :, 1:]не меняет выход позиции 0 — проверка причинности на уровне данных, а не кода. - При
H_q=8, H_{kv}=2правка KV-головы 0 меняет головы 0–3 и не меняет 4–7. Если меняются все — использованnp.tileвместоnp.repeat. -
apply_ropeсовпадает с комплексным умножениемz e^{im\theta}с точностью1e-12: раскладка rotate-half реализована верно. - Норма вектора сохраняется при повороте на любую позицию (до
1e-9). - Скалярное произведение инвариантно к одновременному сдвигу позиций
qиk(до1e-8в float64) и различает разные абсолютные позиции при фиксированном ключе.
Сводка
- Attention — единственная операция, связывающая токены; всё остальное в блоке трансформера покоординатно. Формула
\text{softmax}(QK^\top/\sqrt{d_k} + M)Vсчитается за триmatmulи одинsoftmax. - Деление на
\sqrt{d_k}— не косметика: дисперсия скалярного произведения растёт какd_k(\sigma = 11.3приd_k=128), и без нормировки softmax в fp16 переполняется, а в fp32 вырождается в one-hot. - Causal-маска при декодировании — сдвинутый треугольник
tril(k=S_kv - S_q), а неtril(k=0). Ошибка здесь не ломает формы тензоров, поэтому её ловят только численной проверкой на полном прогоне. - GQA сжимает KV-кэш в
n_{heads}/n_{kv}раз: для Qwen3-8B это32/8=4, то есть 144 KiB на токен вместо 576 KiB, и 4.5 GiB вместо 18 GiB на 32k контекста. Реализуется блочнымnp.repeat(axis=1);np.tileдаёт тихо неверный порядок групп. - RoPE вносит позицию поворотом пар координат на
m\theta_i; в скалярном произведении остаётся толькоm-n. Раскладка rotate-half ([-x[D/2:], x[:D/2]]) — то, что ждёт HF-чекпоинт Qwen3; interleaved из статьи даёт другую перестановку каналов. - Кэш cos/sin — 16 MiB на 32k токенов при
d_k=128в fp16; считается один раз при загрузке, а не на каждом шаге декодирования. - Стоимость attention растёт как
S^2: для Qwen3-8B при 4k токенов это ~15% FLOPs префилла, а точка равенства с линейными слоями — около 27k токенов. МатрицаS\times Sна голову и есть причина существования FlashAttention.
Навигация по курсу: Хаб курса · Предыдущий: От matmul к тексту: тензоры и базовые операторы · Следующий: Автогрессивный цикл и сэмплирование