Хаб курсов / LLM Inference Systems / глава 0
Модуль 00: Нужен ли тебе свой движок инференса и ландшафт путей
Три пути к своему LLM-движку: MLX/Apple Silicon, CUDA/PyTorch, CPU/GGUF. Арифметика памяти, Qwen3 как подопытная, ландшафт сервинга vLLM, SGLang, llama.cpp.
LLM Inference Systems. Модуль 00: Ландшафт инференса LLM
Модель обучают один раз и за 10–100 млн USD, а инференс случается на каждый запрос, и за него платят. Из этого простого факта растёт целая дисциплина: обучение ограничено FLOPs и терпением исследователя, инференс ограничен памятью, задержкой и ценой за миллион токенов. Инженер, который умеет считать байты / пропускная способность быстрее, чем открывать конфиг модели, экономит работодателю порядки в счёте за GPU.
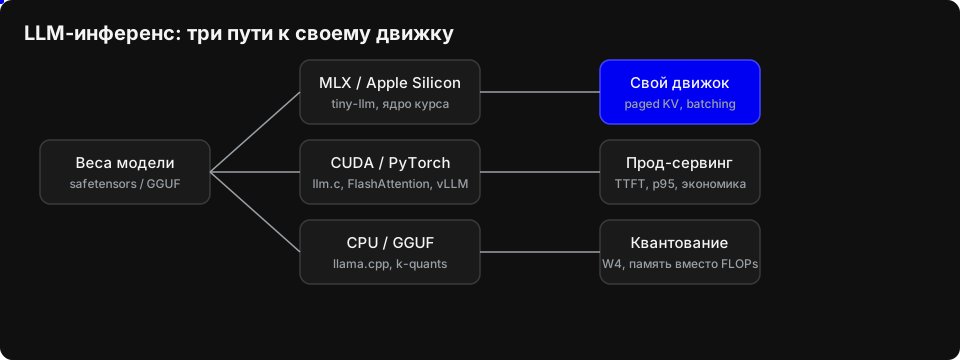
В этом модуле мы не пишем движок — мы строим бюджет. Считаем руками (и проверяем кодом), сколько занимают веса Qwen3-0.6B и Qwen3-8B, сколько занимает KV-кэш на 4k контекста, и какой потолок токенов в секунду физически возможен на Apple M-series, на десктопном DDR5, на RTX 4090 и на A100. Дальше смотрим на архитектуру Qwen3 как на подопытный экземпляр и на ландшафт сервингов: vLLM, SGLang, llama.cpp, TensorRT-LLM, MLX. К концу модуля у тебя на руках таблица, из которой видно, почему батчинг даёт ×100, а квантизация — ×4, и почему на CPU 8B-модель в fp16 обречена на 5 токенов в секунду.
Один токен изнутри
Forward pass по шагам
Генерация авторегрессионна: на каждом шаге модель получает последовательность длины S и выдаёт распределение над словарём для позиции S+1. Внутри — L одинаковых блоков (у Qwen3-0.6B L=28), в каждом:
- RMSNorm входа:
x = x / rms(x) * g, гдеg— обучаемый вектор длиныd_{model}. - Self-attention с GQA: проекции
q = x W_q,k = x W_k,v = x W_v, затемsoftmax(qk^T/√d) v, затемo = attn W_o. - Residual:
x = x + o. - RMSNorm, затем SwiGLU-MLP:
h = silu(x W_gate) * (x W_up),y = h W_down. - Residual:
x = x + y.
Сверху — финальный RMSNorm и lm_head (у 0.6B он связан с эмбеддингами, tie_word_embeddings=true).
Ключевое отличие инференса от обучения: на шаге декодинга мы обрабатываем один новый токен, а не всю последовательность. Значит, все матричные умножения вырождаются в матрица-вектор: вместо [B, S, d] × [d, d'] получаем [B, 1, d] × [d, d']. Это меняет всё: GEMM упирается в вычисления, GEMV упирается в память.
Что читается, что считается
Для одного токена:
- FLOPs ≈
2N, гдеN— число параметров (одно умножение + одно сложение на параметр). Для 8B это 16.4 Гфлоп на токен, для 0.6B — 1.19 Гфлоп. Форвард-пас по промпту длиныSстоит2NSфлоп. - Байты, которые надо прочитать из памяти = размер всех весов (при батче 1 и без учёта KV). Для 8B в fp16 — 16.4 ГБ, для 0.6B — 1.19 ГБ.
Отношение = арифметическая интенсивность: 2N / 2N = 1 флоп/байт для fp16. Точка перегиба (ridge point) у A100: 312 Тфлоп fp16 / 2.04 ТБ/с = 153 флоп/байт. Мы работаем в 150 раз левее пика — GPU при декодинге загружен на ~0.6% по вычислениям и на 100% по памяти. Отсюда главный вывод модуля: декодинг ограничен пропускной способностью памяти, а не FLOPs.
Оговорка про BPE: байтовые патчи
BPE — инженерный компромисс, а не физика. В проде 2026 он по-прежнему доминирует, но главный концептуальный вызов — Byte Latent Transformer (Meta): модель работает с сырым байтовым входом и группирует его в патчи с динамической границей, вместо фиксированного BPE-словаря (Meta BLT). Тезис работы — «Patches scale better than tokens»: патчи масштабируются лучше, чем токены, и у байтового входа нет vocabulary-артефактов (неравномерная «цена» слов в разных языках, как ~2–3 токена на русское слово в Qwen). Для арифметики инференса это меняет единицу счёта: сколько байт на «токен» и как патчи распределяют compute, становится вопросом архитектуры, а не константой словаря. Курс держится за BPE как за рабочий стандарт, но помните: это выбор, который оспаривается.
Арифметика: где живёт время
Потолок декодинга
Время на один токен при батче 1:
t_{token} \approx \frac{\text{байты весов}}{\text{BW}} + \text{накладные расходы ядер}
Потолок токенов в секунду: tok/s = BW / bytes_weights. Для W4-квантованных весов делитель в 4 раза меньше — потолок в 4 раза выше. Это единственная причина, по которой квантизация существует.
Пропускная способность памяти типичных устройств:
| Устройство | BW, ГБ/с | fp16 TFLOPS | B^* = TFLOPS/BW |
|---|---|---|---|
| Apple M1 (8 ядер) | 68 | ~2.6 | 38 |
| Apple M3 Max | 400 | ~28 | 70 |
| Десктоп DDR5, 2 канала | 90 | ~1.5 (AVX-512) | 17 |
| Сервер EPYC, 12 каналов DDR5 | ~460 | ~3 | 7 |
| RTX 4090 | 1008 | 165 | 164 |
| A100 80GB SXM | 2039 | 312 | 153 |
| H100 SXM | 3350 | 989 | 295 |
B^* — точка перелома батчинга, см. ниже.
Таблица потолков (fp16 и W4)
Считаем честно: 0.6B fp16 = 1.192 ГБ, 8B fp16 = 16.38 ГБ, W4 (4.5 бита на параметр с учётом scales) — 0.335 ГБ и 4.61 ГБ.
| Устройство | 0.6B fp16 | 0.6B W4 | 8B fp16 | 8B W4 |
|---|---|---|---|---|
| M1, 68 ГБ/с | 57 tok/s | 203 | 4.2 | 15 |
| M3 Max, 400 ГБ/с | 336 | 1194 | 24 | 87 |
| DDR5, 90 ГБ/с | 76 | 269 | 5.5 | 20 |
| RTX 4090, 1008 ГБ/с | 846 | 3007 | 62 | 219 |
| A100, 2039 ГБ/с | 1711 | 6082 | 125 | 442 |
| H100, 3350 ГБ/с | 2810 | 9991 | 205 | 727 |
Это теоретические потолки при идеальных ядрах и батче 1. Реальность: 60–80% от них. На A100 восьмимиллиардная модель в fp16 даёт ~80–100 tok/s на поток — ровно то, что видят люди, запускающие vllm serve Qwen/Qwen3-8B без батчинга.
Заметь: 0.6B на ноутбуке M1 в fp16 упирается в 57 tok/s, а на глаз человек читает ~10 tok/s. То есть маленькие модели на Apple Silicon комфортны, большие — нет: 8B на M1 даёт 4 tok/s, это медленнее чтения.
Четвёртая ось железа: unified memory
До этого момента железо делилось на три класса, и у каждого своя форма боли:
- CPU + DRAM — bandwidth в единицы–сотни ГБ/с, зато терабайты памяти и дешёвый гигабайт.
- Дискретная GPU — гигантский BW (1–3 ТБ/с), но ёмкость 8–80 ГБ на плате и PCIe между хостом и устройством.
- CPU-сервер с большим числом каналов — компромисс: ~460 ГБ/с при сотнях ГБ памяти, но дорогая плата.
Unified memory — четвёртая ось: Apple M-series (и их серверные аналоги) физически распаяли память вокруг одного кристалла, и CPU, и GPU обращаются к одним и тем же адресам. Из этого следует три инженерных следствия, а не маркетинговых:
- Нет PCIe. В дискретном стеке веса едут по шине при загрузке, KV-кэш и активации — при каждом обмене CPU↔GPU. ~16 ГБ весов 8B-модели по PCIe 4.0 x16 (~32 ГБ/с в каждую сторону) — это полсекунды на одну пересылку. В unified memory это указатель, а не копия: model weights грузятся один раз в
mmap-able файл и видны обеим сторонам. - Ёмкость = объём ОЗУ машины. Mac Studio с 192–512 ГБ unified memory грузит модели, которые не влезают ни в одну consumer-GPU: 70B в fp16 (140 ГБ) — это локально решаемая задача, тогда как 2×RTX 4090 дают только 48 ГБ и требуют квантования. Потолок декодинга при этом остаётся потолком по BW из таблицы выше: 400 ГБ/с у M3 Max против 1008 ГБ/с у 4090 — модель в 2.5 раза больше памяти доступна, но и читается она в 2.5 раза медленнее.
- Роскошь ленивой загрузки. Поскольку адресное пространство общее, можно
mmap-ить W4-веса с диска и не хранить весь тензор в памяти: страница подгружается при первом touch. В дискретном стеке это требовало бы явного CPU→GPU DMA-конвейера.
Отсюда правило для курса: на unified memory bottleneck — только bandwidth; на дискретной GPU к нему добавляется ёмкость платы и PCIe; на CPU — только bandwidth и её цена. Каждая из трёх «болей» диктует свои оптимизации: на Apple — выжимать BW (квантизация, fused-ядра), на дискретной GPU — упаковывать KV и батч, на CPU — квантовать агрессивно и держать веса mmap-нутыми.
Это не значит, что unified memory «лучше». Это значит, что там другая точка на кривой цена/BW/ёмкость: та же 8B-модель, которая на 4090 летает на 62 tok/s (fp16) с 12 контекстами, на M3 Max даст 24 tok/s, зато на Mac Studio с 512 ГБ можно поднять модель, которая на 4090 не запустится вовсе. Выбор железа — это выбор точки на этой кривой под конкретную задачу, а не «лучше/хуже».
Prefill против decode
У генерации две фазы с разной физикой.
Prefill: обрабатываем промпт длины S за один проход. FLOPs = 2NS, байты весов читаются один раз. Арифметическая интенсивность ≈ S флоп/байт. При S=4096 это 4096 против ridge point 153 — мы в 27 раз правее пика, то есть compute-bound. Время prefill для 8B на 4k токенов: 4096 \times 16.4 Гфлоп = 67 Тфлоп; при 50% MFU на A100 (156 Тфлоп реальных) — 0.43 с. Это и есть time-to-first-token.
Decode: по одному токену, memory-bound, ~125 tok/s на A100 для 8B. 100 токенов ответа — 0.8 с. Итого запрос: 0.43 с ожидания + 0.8 с генерации.
Практическое следствие: длинный промпт бьёт по TTFT, длинный ответ — по inter-token latency, и оптимизируют их разными средствами (chunked prefill, prefix caching против квантизации и спекулятивного декодинга).
Батчинг и точка перелома
При батче B веса читаются один раз на B токенов. Потолок становится B × BW / bytes, пока не упрёмся в вычисления: peak_flops / 2N. Точка перелома:
B^* = \frac{\text{peak\_flops} / 2N}{\text{BW} / 2N} = \frac{\text{peak\_flops}}{\text{BW}}
Для fp16 B^* — свойство устройства, а не модели: 153 для A100, 164 для 4090, 295 для H100, 17 для CPU. До B^* пропускная способность растёт линейно, после — выходит на плато.
Для 8B на A100: одиночный поток 125 tok/s, при B=32 — 4000 tok/s, при B=153 — 19 000 tok/s (потолок по вычислениям). Это ×150 к одиночному потоку. Ровно поэтому PagedAttention и continuous batching — не академические упражнения, а разница между USD 4.5 и USD 0.03 за миллион токенов.
Экономика токена
A100 за USD 2/час = USD 0.00056/с. Одиночный поток 8B fp16, 125 tok/s: USD 4.4 за 1M токенов. Батч 128: 16 000 tok/s → USD 0.035 за 1M. Разница в 128 раз — это и есть весь бизнес инференса. Каждый wasted байт в KV-кэше и каждая фрагментация памяти превращаются в деньги напрямую.
Три пути курса
Курс идёт по трём стекам параллельно, потому что одни и те же идеи выглядят по-разному в зависимости от того, где живёт память.
| Путь | Стек | Что строим | Где запускается |
|---|---|---|---|
| MLX / Apple Silicon (ядро курса) | tiny-llm, mlx, Metal | полный движок: forward pass, KV-кэш, paged attention, continuous batching, сэмплинг, спекулятивное декодирование | Mac с M-чипом, unified memory |
| CUDA / PyTorch | llm.c, FlashAttention, Triton | kernel-level: layernorm, fused matmul, attention без материализации S \times S | NVIDIA GPU |
| CPU / GGUF | llama.cpp | квантизация k-quants, mmap весов, SIMD-ядра, server | любая машина, включая этот ноутбук |
Четвёртая ось: класс железа
Три стека выше — это ось программного пути. Она не совпадает с осью железа. Помимо дискретной GPU и обычного CPU+DRAM есть класс устройств с когерентной unified memory: Apple M-series, AMD Ryzen AI Max+ 395 / Strix Halo и NVIDIA DGX Spark на GB10. У DGX Spark официально заявлены до 128 ГБ unified memory, до 1 PFLOP FP4 и ConnectX-сеть для объединения до 4 систем (официальная страница NVIDIA); у Ryzen AI Max+ 395 — до 128 ГБ LPDDR5X-8000 и Radeon 8060S (официальная страница AMD). Это не «ещё один Mac»: объём памяти, пропускная способность и зрелость ROCm/Metal/CUDA меняют оптимальную раскладку модели.
Отдельный класс — гибридная нода: unified-memory бокс держит большую модель или prefill, а дискретная NVIDIA GPU выполняет decode, draft-модель или быструю голову. Между ними передаются не веса на каждом шаге, а KV-кэш или компактный промежуточный результат; порог выгодности разбирается в модуле 13, рецепты placement и MoE-offload — в модуле 17. Поэтому «три пути» не исчерпывают ландшафт: это три стека, поверх которых можно собрать несколько разных аппаратных топологий.
MLX выбран ядром, потому что unified memory убирает шину PCIe из уравнения: и CPU, и GPU видят одни и те же байты, и можно честно измерять, где кончается bandwidth. CUDA-путь даёт доступ к настоящим ядрам и roofline. CPU-путь показывает, что происходит, когда bandwidth в 20 раз меньше, и почему квантизация там не роскошь, а необходимость.
Подопытная модель: Qwen3
Qwen3 — современное семейство с GQA, RMSNorm, SwiGLU, RoPE и QK-norm (RMSNorm на головах q и k, добавка 2 \cdot d_{head} параметров на слой). Dense-варианты: 0.6B, 1.7B, 4B, 8B, 14B, 32B.
Qwen3 остаётся сквозным примером курса, но не единственным стендом: в феврале–марте 2026 вышло семейство Qwen3.5 — MoE 397B-A17B плюс dense-варианты 0.8B–9B с контекстом ~256K, по-прежнему под лицензией Apache 2.0 (официальная линейка Qwen). Верхний dense-сегмент закрыл Qwen3.8-27B (официальный релиз Qwen). Методически ценно, что линейка покрывает оба класса — MoE и dense — на одной лицензии: второй стенд добавляется, не ломая нумерацию ноутбуков. Вся арифметика этого модуля (2N флоп на токен, декодинг по пропускной способности, бюджет KV) переносится на Qwen3.5 дословно — меняются только константы конфига.
| Параметр | Qwen3-0.6B | Qwen3-8B |
|---|---|---|
num_hidden_layers | 28 | 36 |
hidden_size (d_{model}) | 1024 | 4096 |
num_attention_heads | 16 | 32 |
num_key_value_heads | 8 | 8 |
head_dim | 128 | 128 |
intermediate_size | 3072 | 12288 |
vocab_size | 151 936 | 151 936 |
tie_word_embeddings | true | false |
| Параметров (расчёт) | 596 042 752 | 8 190 726 144 |
| Веса fp16 | 1.19 ГБ | 16.38 ГБ |
| Веса W4 (4.5 бита) | 0.335 ГБ | 4.61 ГБ |
| KV на токен (fp16) | 112 КиБ | 144 КиБ |
| KV на 4k токенов | 448 МиБ | 576 МиБ |
Обрати внимание на head_dim = 128 при d_{model}=1024: у 0.6B 16 голов по 128 = 2048 на q-проекцию, то есть q-проекция расширяет, а не сжимает. Это сделано, чтобы головы были «нормального» размера на всех масштабах.
GQA — главный источник экономии в KV-кэше. У 8B 32 головы запросов и 8 голов ключей/значений: каждая KV-голова обслуживает 4 q-головы. Без GQA (32 KV-головы) кэш на 4k был бы 2.25 ГиБ вместо 576 МиБ.
Формула KV-кэша, которую надо помнить наизусть:
\text{KV bytes} = 2 \cdot L \cdot n_{kv} \cdot d_{head} \cdot S \cdot B \cdot \text{bytes\_per\_element}
Множитель 2 — ключи и значения. Проверка для 8B: 2 \cdot 36 \cdot 8 \cdot 128 \cdot 4096 \cdot 1 \cdot 2 = 603\,979\,776 байт = 576 МиБ. Сходится.
Полный бюджет памяти при сервинге: веса + KV × batch × ctx + активации + фрагментация. Для 8B на 4090 (24 ГБ): 16.38 ГБ весов оставляют 7.6 ГБ, то есть 12 одновременных последовательностей по 4k. На A100 80 ГБ — 16.38 + KV, помещается ~100 последовательностей по 4k, и именно там начинает работать батчинг.
Ландшафт сервинга
| Движок | Ключевая идея | Когда брать | Ограничения |
|---|---|---|---|
| vLLM | PagedAttention: KV-кэш блоками по 16 токенов, как страницы ОС; continuous batching; prefix caching | GPU-сервинг общего назначения, OpenAI-совместимый API | CUDA-first; на CPU/Apple работает медленно |
| SGLang | RadixAttention: префиксы как дерево, переиспользование между запросами; frontend-язык для структурированной генерации | много общих системных промптов, агентные пайплайны | сложнее в дебаге |
| llama.cpp / llama-server | GGUF, k-quants (Q4_K_M и т.п.), mmap, SIMD на CPU, Metal/CUDA бэкенды | edge, ноутбуки, CPU-серверы, маленькие модели | пропускная способность ниже, чем у GPU-стеков |
| TensorRT-LLM | компиляция в engine под конкретную GPU, FP8/INT4, fused kernels, in-flight batching | максимум tok/s на NVIDIA, продакшн с фиксированной конфигурацией | долгая сборка, привязка к архитектуре GPU |
| MLX / mlx-lm | unified memory, ленивые графы, квантование в 4 бита | Apple Silicon, локальная разработка | нет продакшн-сервинга уровня vLLM |
Общая структура у всех одна: планировщик батчей → менеджер KV-кэша → ядра attention/matmul → сэмплер. Различаются тем, насколько эффективно они упаковывают KV-кэш и насколько часто пересобирают батч. В этом курсе мы соберём этот конвейер сами, начиная с наивного (пересчёт всего префикса каждый шаг) и заканчивая paged-KV с continuous batching.
Что ты построишь за курс
К концу курса у тебя будет собственный мини-движок инференса: загрузка safetensors, токенизатор, forward pass на numpy/torch (CPU) и на MLX (Apple Silicon), KV-кэш, paged attention с блоками по 16 токенов, continuous batching с планировщиком, сэмплинг (top-k/top-p/temperature), квантизация весов в int8/int4, спекулятивное декодирование и HTTP-сервер с OpenAI-совместимым /v1/completions. Он будет выдавать те же логиты, что и transformers, и мы это проверим численно.
Задание 00.1: бюджет памяти и потолок декодинга
Реализуй модуль budget.py со следующим интерфейсом:
def params_breakdown(m: ModelSpec) -> dict[str, int]:
    """Ключи: 'attention', 'mlp', 'norms', 'embedding', 'total'.
       Считается по формулам, без загрузки весов."""

def kv_bytes(m: ModelSpec, ctx: int, batch: int = 1, dtype_bytes: int = 2) -> int:
    """Полный размер KV-кэша в байтах."""

def weights_bytes(m: ModelSpec, bits_per_param: float) -> float:
    """bits_per_param: 16.0 для fp16, 8.0 для int8, 4.5 для W4."""

def decode_ceiling(m: ModelSpec, bits_per_param: float, bw_bytes_per_s: float,
                   efficiency: float = 1.0) -> float:
    """Теоретический потолок tok/s при батче 1."""

def batch_breakeven(m: ModelSpec, bits_per_param: float, bw: float, peak_flops: float) -> float:
    """Батч, после которого упираемся в вычисления, а не в память."""
На вход подаются два ModelSpec — Qwen3-0.6B и Qwen3-8B — и список устройств с BW и пиковыми FLOPs. На выходе — таблица из раздела «Арифметика», плюс отдельная строка «итого памяти» для 8B при batch=32, ctx=4096 на каждом устройстве.
Ожидаемый результат: params_breakdown(QWEN3_8B)['total'] = 8 190 726 144, kv_bytes(QWEN3_8B, 4096) = 603 979 776, decode_ceiling(QWEN3_8B, 16.0, 2039e9) ≈ 124.5. Все три числа должны совпасть с точностью до целого.
Задание 00.2: инспекция реального чекпоинта
Реализуй inspect_safetensors.py, который читает только заголовок safetensors-файла (8 байт длины + JSON), не поднимая в память ни одного тензора, и печатает:
- общее число тензоров и суммарный размер в байтах;
- гистограмму dtype (сколько тензоров и сколько байт на каждый dtype);
- агрегацию по префиксам:
model.layers.*.self_attn.q_projи т.п. — сколько байт суммарно; - top-10 самых больших тензоров;
- есть ли
lm_head.weight(проверкаtie_word_embeddings).
Интерфейс:
def read_header(path: Path) -> dict:
    """Возвращает распарсенный JSON-заголовок safetensors."""

def inspect(model_dir: Path) -> dict:
    """Ключи: 'n_tensors', 'total_bytes', 'dtypes', 'by_prefix', 'largest', 'has_lm_head'."""
На вход — директория с model.safetensors (или шардами model-00001-of-00002.safetensors + model.safetensors.index.json). Ожидаемо для Qwen3-0.6B: ≈310 тензоров, ≈1.19 ГБ, has_lm_head == False, dtype только BF16. Для Qwen3-8B: ≈399 тензоров, ≈16.4 ГБ, has_lm_head == True.
Код
budget.py
#!/usr/bin/env python3
"""budget.py — арифметика памяти и потолок декодинга для LLM.

Запуск: python budget.py
Зависимостей нет, только стандартная библиотека.
"""
from __future__ import annotations

from dataclasses import dataclass


@dataclass(frozen=True)
class ModelSpec:
    """Всё, что нужно знать о dense-модели, чтобы посчитать бюджет."""
    name: str
    n_layers: int
    d_model: int
    n_heads: int
    n_kv_heads: int
    head_dim: int
    d_ff: int
    vocab: int
    tied: bool  # tie_word_embeddings


# Значения взяты из config.json Qwen3-0.6B и Qwen3-8B
QWEN3_06B = ModelSpec("Qwen3-0.6B", 28, 1024, 16, 8, 128, 3072, 151936, True)
QWEN3_8B = ModelSpec("Qwen3-8B", 36, 4096, 32, 8, 128, 12288, 151936, False)

# (имя, BW байт/с, пиковые fp16 FLOP/s)
DEVICES = [
    ("Apple M1 (8 ядер)", 68e9, 2.6e12),
    ("Apple M3 Max", 400e9, 28e12),
    ("DDR5 desktop 2ch", 90e9, 1.5e12),
    ("RTX 4090", 1008e9, 165e12),
    ("A100 80GB SXM", 2039e9, 312e12),
    ("H100 SXM", 3350e9, 989e12),
]


def params_breakdown(m: ModelSpec) -> dict[str, int]:
    """Число параметров по группам. QK-norm (2*head_dim на слой) включён в norms."""
    q = m.d_model * m.n_heads * m.head_dim
    k = m.d_model * m.n_kv_heads * m.head_dim
    v = k
    o = m.n_heads * m.head_dim * m.d_model
    gate = m.d_model * m.d_ff
    up = gate
    down = m.d_ff * m.d_model
    norms = 2 * m.d_model + 2 * m.head_dim  # 2 RMSNorm + QK-norm

    per_layer = q + k + v + o + gate + up + down + norms
    emb = m.vocab * m.d_model
    head = 0 if m.tied else m.vocab * m.d_model

    return {
        "attention": (q + k + v + o) * m.n_layers,
        "mlp": (gate + up + down) * m.n_layers,
        "norms": norms * m.n_layers + m.d_model,
        "embedding": emb + head,
        "total": per_layer * m.n_layers + emb + head + m.d_model,
    }


def weights_bytes(m: ModelSpec, bits_per_param: float) -> float:
    """Размер весов в байтах. 16.0 -> fp16, 8.0 -> int8, 4.5 -> W4 со scales."""
    return params_breakdown(m)["total"] * bits_per_param / 8.0


def kv_bytes(m: ModelSpec, ctx: int, batch: int = 1, dtype_bytes: int = 2) -> int:
    """KV-кэш: 2 (K и V) * слои * kv-головы * head_dim * токены * батч * байты."""
    per_token = 2 * m.n_layers * m.n_kv_heads * m.head_dim * dtype_bytes
    return per_token * ctx * batch


def decode_ceiling(m: ModelSpec, bits_per_param: float, bw_bytes_per_s: float,
                   efficiency: float = 1.0) -> float:
    """tok/s при батче 1: сколько раз вес модели влезает в секунду пропускной способности."""
    return bw_bytes_per_s / weights_bytes(m, bits_per_param) * efficiency


def batch_breakeven(m: ModelSpec, bits_per_param: float, bw: float,
                    peak_flops: float) -> float:
    """Батч, на котором декодинг перестаёт быть memory-bound.

    B* = (peak_flops / 2N) / (BW / bytes_weights)
    Для fp16 упрощается до peak_flops / BW.
    """
    compute_bound = peak_flops / (2 * params_breakdown(m)["total"])
    memory_bound = bw / weights_bytes(m, bits_per_param)
    return compute_bound / memory_bound


def human(n: float) -> str:
    for unit in ("Б", "КиБ", "МиБ", "ГиБ", "ТиБ"):
        if abs(n) < 1024 or unit == "ТиБ":
            return f"{n:.2f} {unit}"
        n /= 1024


def report(m: ModelSpec, ctx: int = 4096, batch: int = 32) -> None:
    p = params_breakdown(m)
    print(f"\n=== {m.name} ===")
    print(f"параметров всего      : {p['total']:,}")
    print(f"  attention           : {p['attention']:,}")
    print(f"  mlp                 : {p['mlp']:,}")
    print(f"  norms               : {p['norms']:,}")
    print(f"  embedding (+lm_head): {p['embedding']:,}")
    for bits, tag in ((16.0, "fp16"), (8.0, "int8"), (4.5, "W4")):
        print(f"веса {tag:>5}          : {human(weights_bytes(m, bits))}")
    print(f"KV на токен (fp16)    : {human(kv_bytes(m, 1))}")
    print(f"KV на {ctx} токенов      : {human(kv_bytes(m, ctx))}")
    print(f"KV на {ctx}x{batch}        : {human(kv_bytes(m, ctx * batch))}")
Как проверить
- Запустите скрипт для одной модели при
ctx= 2k, 8k, 32k иbatch= 1, 2, 4. Убедитесь, чтоKV на ctxрастёт линейно, аKV на ctx x batch— ровно пропорциональноbatch. - Сверьте
параметров всегос суммой по конфигу и с известным размером модели. Если расходится, проверьтеtie_word_embeddings, отдельныйlm_headи учётnorms. - Проверьте формулу KV вручную:
2 * n_layers * n_kv_heads * head_dim * dtype_bytes. Для GQAn_kv_headsдолжен быть меньшеn_heads; если в расчёте стоитn_heads, KV завышен. - Сравните оценку с фактическим пиком памяти: прогрейте модель, сгенерируйте
ctxтокенов и снимитеtorch.cuda.max_memory_allocated(). Разница в 10–20% нормальна за счёт активаций, фрагментации и CUDA-контекста. - Для int8/W4 проверьте, что в
weights_bytesучитываются только веса, а KV и активации считаются отдельно. Квантованный KV включайте в расчёт только если он реально включён. - Добавьте unit-тест на синтетической модели:
kv_bytes(m, 2*ctx) == 2*kv_bytes(m, ctx)иkv_bytes(m, ctx*2) == 2*kv_bytes(m, ctx).
Сводка
- Память инференса складывается из весов, KV-кэша и служебных буферов; на длинном контексте KV-кэш часто становится главным ограничением.
- Размер весов считается как
params * bits / 8; для fp16 это 2 байта на параметр, для int8 — 1 байт, для W4 — около 0.5 байта плюс накладные расходы на масштабы. - KV на один токен:
2 * n_layers * n_kv_heads * head_dim * dtype_bytes; множитель 2 — это ключи и значения. - GQA и MQA уменьшают число KV-голов, поэтому кэш падает в
n_heads / n_kv_headsраз относительно обычного MHA. - Батч увеличивает KV линейно:
KV(ctx, batch) = batch * KV(ctx, 1), поэтому concurrent-запросы надо планировать вместе с длиной контекста. - Квантование весов не уменьшает KV автоматически; для экономии нужен отдельный quantized KV cache и проверка качества.
Навигация по курсу: Хаб курса · Следующий: От matmul к тексту: тензоры и базовые операторы