Хаб курсов / LLM Inference Systems / глава 3
Модуль 03: Автогрессивный цикл и сэмплирование
От логитов к токену: temperature, top-k, top-p. Полный forward Qwen3-0.6B на torch CPU и сверка с transformers.
LLM Inference Systems. Модуль 03: Автогрессивный цикл и сэмплирование
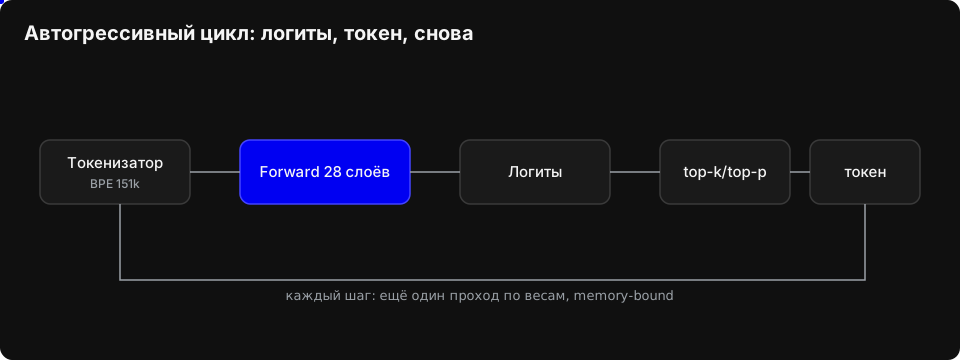
Языковая модель — это функция logits = f(tokens). Всё остальное (диалог, код, JSON) — надстройка над циклом: получить логиты, превратить их в распределение, выбрать токен, дописать его к входу, повторить. В этом модуле мы разберём каждое звено этого цикла с числами и соберём рабочий генератор Qwen3-0.6B на чистом torch, который на CPU выдаёт те же токены, что и transformers.generate. По дороге станет видно, почему наивный цикл стоит O(n²) и почему в модуле 04 появляется KV-кэш.
Никакого MLX и CUDA: всё, что ниже, запускается на ноутбуке под Windows/Linux/macOS на CPU. Модель 0.6B в fp32 занимает 2.4 ГБ RAM — влезает куда угодно.
3.1 От логитов к вероятностям: softmax и температура
Модель на выходе последнего слоя отдаёт вектор логитов z ∈ R^V, где V = 151936 для Qwen3. Логиты — ненормированные оценки; чтобы получить распределение, применяют softmax:
p_i = exp(z_i / T) / Σ_j exp(z_j / T)
T — температура. При T = 1 распределение «как обучено». При T < 1 распределение обостряется (растёт отношение max/min вероятностей), при T > 1 — размазывается. При T → 0 предел — дельта-функция на argmax (это и есть greedy). При T → ∞ — равномерное.
Важно, что температура не меняет порядок токенов, только их относительные веса: z_i/T монотонно по z_i. Поэтому argmax при любой T > 0 один и тот же.
Возьмём пять логитов и посчитаем честно. z = [2.0, 1.0, 0.5, 0.0, -1.0].
T = 1. exp(z) = [7.389, 2.718, 1.649, 1.000, 0.368], сумма 13.124.
| токен | z | exp(z) | p |
|---|---|---|---|
| A | 2.0 | 7.389 | 0.563 |
| B | 1.0 | 2.718 | 0.207 |
| C | 0.5 | 1.649 | 0.126 |
| D | 0.0 | 1.000 | 0.076 |
| E | -1.0 | 0.368 | 0.028 |
T = 0.5. z/T = [4, 2, 1, 0, -2], exp = [54.598, 7.389, 2.718, 1.000, 0.135], сумма 65.840, p = [0.829, 0.112, 0.041, 0.015, 0.002]. Токен A вырос с 56% до 83%.
T = 2.0. z/T = [1, 0.5, 0.25, 0, -0.5], exp = [2.719, 1.649, 1.284, 1.000, 0.607], сумма 7.257, p = [0.375, 0.227, 0.177, 0.138, 0.084]. Хвост поднялся с 2.8% до 8.4%.
Практическая деталь: softmax считают со сдвигом на максимум (exp(z - max(z))), иначе при логитах порядка 100 exp уходит в inf, а при разностях порядка -100 — в 0. Сдвиг не меняет результат математически, но спасает от NaN.
Вторая деталь: при T = 0 деление даёт inf/nan. Реализации обрабатывают это отдельной ветвью «greedy», а не «очень маленькой температурой».
3.2 top-k и top-p: обрезка хвоста
Softmax даёт распределение по 151936 токенам, но почти вся масса сосредоточена в голове. Проблема в том, что хвост из десятков тысяч токенов с вероятностями 1e-5 суммарно набирает несколько процентов и именно оттуда вылезает мусор: обрывки слов, смена языка, случайная пунктуация. Два способа обрезать хвост.
top-k оставляет k токенов с наибольшими логитами, остальным присваивает -inf (или вероятность 0), затем перенормирует:
p'_i = p_i / Σ_{j ∈ topk} p_j, если i ∈ topk, иначе 0
Из примера выше при T = 1, k = 3: остаются A, B, C с суммой 0.563 + 0.207 + 0.126 = 0.896, после перенормировки [0.628, 0.231, 0.140]. Токены D и E недостижимы.
top-p (nucleus sampling), Holtzman et al. 2019: отсортировать по убыванию, взять минимальный префикс, накопленная вероятность которого ≥ p, остальное отбросить. Размер «ядра» адаптивный: на уверенном распределении ядро — 1–2 токена, на плоском — десятки.
Из примера, p = 0.9: накопленные [0.563, 0.770, 0.896, 0.972, 1.000]. Первый индекс, где cumsum ≥ 0.9 — это D (0.972). Ядро — четыре токена, перенормировка на 0.972 даёт [0.579, 0.213, 0.129, 0.078].
Из того же примера, p = 0.5: cumsum первого же токена 0.563 ≥ 0.5, ядро — один токен. То есть top-p вырождается в greedy, когда модель уверена. Это его главное достоинство: он не режет выбор там, где модель сомневается, и не даёт шума там, где она уверена. top-k так не умеет — он всегда оставляет ровно k вариантов.
Соглашение о границе: «минимальный префикс с cumsum ≥ p» оставляет токен, который пересёк порог. Именно так работает TopPLogitsWarper в transformers (маска cumsum > p, сдвинутая вправо на один элемент, плюс принудительный min_tokens_to_keep = 1) и vLLM. Реализация ниже воспроизводит это поведение.
Порядок применения: температура → top-k → top-p → перенормировка → выбор. top-k и top-p можно комбинировать (top-k первым, top-p по уже обрезанному распределению) — так делают и HF, и vLLM.
Разумные значения. Карточка Qwen3 рекомендует: thinking-режим T = 0.6, top_p = 0.95, top_k = 20; non-thinking T = 0.7, top_p = 0.8, top_k = 20; и явно просит не использовать greedy — Qwen3 обучен с мыслью, что сэмплирование будет стохастическим, и на greedy деградирует (повторы, зацикливание). Для кода и извлечения данных, наоборот, T = 0 или T = 0.2, top_p = 0.95.
Ещё два популярных варианта, которые мы не реализуем, но стоит знать:
- min-p: отбросить всё, что меньше
min_p × p_max. Один гиперпараметр, адаптивнее top-p на острых распределениях. - repetition penalty: для токенов, уже встречавшихся в контексте,
z_i /= rприz_i > 0иz_i *= rприz_i ≤ 0. Дешёво, но легко ломает синтаксис: штрафует и{, иreturn, и отступы.
3.3 Greedy против сэмплирования
greedy (T=0) | sampling | |
|---|---|---|
| Детерминизм | побитовый при фиксированных весах и порядке операций | только при фиксированном seed и железе |
| Воспроизводимость багов | высокая | низкая |
| Разнообразие | нулевое, один и тот же ответ | есть |
| Типичные задачи | извлечение сущностей, классификация, код, unit-тесты, JSON | чат, брейншторм, генерация текста, перевод |
| Риск | зацикливание, «туннель» в частую фразу | дрейф темы, галлюцинации из хвоста |
Правило: если ответ проверяется программно (парсится JSON, компилируется, сравнивается с эталоном) — T = 0. Если ответ читает человек — сэмплирование с T ≈ 0.6–0.8.
Тонкость про детерминизм: даже greedy не гарантирует одинаковый текст на разных GPU или разных версиях библиотек. Причина — недетерминированный порядок суммирования во fused-ядрах (atomicAdd в reduce) и разные ядра для разных форм тензоров. Разница в 1 ulp логита может перевернуть argmax, если два токена почти равны, и дальше генерации расходятся полностью. На CPU с одним потоком расхождений обычно нет, с torch.set_num_threads(8) — уже возможны. Это надо помнить при сверке с эталоном.
Сэмплер в спекулятивном декодинге
Ещё один сдвиг, который не виден изолированно: спекулятивное декодирование (модуль 15) меняет роль сэмплера. При MTP-драфтах сэмплер становится частью контура верификации: от его отсечек зависит не только распределение выхода, но и доля принятых драфтов — агрессивные top-k/top-p режут и те кандидаты, которые модель-верификатор приняла бы, и качество MTP-ускорения падает (документация LM Studio). Практическое правило: при включённой спекуляции ослабляйте отсечки и замеряйте acceptance rate, а не только tok/s.
Второй тезис — про seed: детерминизм по фиксированному seed — это воспроизводимость распределения вызовов RNG, но не гарантия побитовой воспроизводимости результата. На батчах и разных кернелах порядок суммирования в reduce меняется (см. тонкость выше), логиты расходятся в последних битах, и сэмплированный токен может перевернуться. Для отладки держите greedy (seed там не нужен вовсе); для сравнения конфигураций фиксируйте seed и железо одновременно.
3.4 Автогрессивный цикл и токенизация
Модель работает с целыми числами — id токенов. Между текстом и id стоит BPE-токенизатор.
BPE в двух словах. Начинаем с байтов (256 базовых символов), на корпусе жадно сливаем самую частую пару соседних символов в новый токен, повторяем, пока словарь не достигнет нужного размера. Qwen3 использует словарь на 151936 токенов; служебные id: 151643 = <|endoftext|>, 151645 = <|im_end|> (последний — eos для instruct-моделей). Русский текст в Qwen-токенизаторе стоит в среднем ~2–3 токена на слово; английский — ~1.3.
tiktoken (OpenAI) — другая реализация той же идеи с другим словарём; для Qwen он не подходит, id не совпадут. Для Qwen берём transformers.AutoTokenizer.
Chat template. Instruct-модели обучались на конкретной разметке диалога. Для Qwen3:
text = tokenizer.apply_chat_template(
    [{"role": "user", "content": "..."}],
    tokenize=False, add_generation_prompt=True, enable_thinking=False)
enable_thinking — переключатель режима «сначала рассуждение в ...». Для базовой модели (Qwen/Qwen3-0.6B, не -Instruct) шаблон не нужен, но и не вредит: это просто текст. В наших экспериментах используем сырой промпт — так проще сверять с transformers.
Цикл. Prefill — один forward по всему промпту длины P, даёт логиты последней позиции. Decode — по одному токену за шаг:
ids = tokenize(prompt)
for step in range(max_new_tokens):
    logits = model(ids)[-1]          # [V]
    next_id = sample(logits, T, k, p)
    ids.append(next_id)
    if next_id == eos_id: break
return detokenize(ids[P:])
Ключевое свойство: каждый шаг модель видит весь префикс. Формально p(x_t | x_1..x_{t-1}) — это forward по t токенам. Именно здесь прячется квадратичная стоимость, и именно здесь её убивает KV-кэш.
3.5 Forward Qwen3-0.6B: что внутри
Конфигурация из config.json:
| параметр | значение | следствие |
|---|---|---|
hidden_size | 1024 | ширина residual-потока |
num_hidden_layers | 28 | 28 блоков |
num_attention_heads | 16 | 16 голов запроса |
num_key_value_heads | 8 | GQA, группа 2 |
head_dim | 128 | 16 × 128 = 2048 на выходе q_proj |
intermediate_size | 3072 | ширина MLP |
vocab_size | 151936 | embedding 151936×1024 |
rms_norm_eps | 1e-6 | |
rope_theta | 1e6 | база RoPE |
tie_word_embeddings | true | lm_head делит вес с embedding |
max_position_embeddings | 40960 |
Параметров: embedding 151936 × 1024 = 155.6M (26% всей модели!), на слой — q 1024×2048 = 2.10M, k и v по 1024×1024 = 1.05M, o 2048×1024 = 2.10M, gate/up/down по 1024×3072 = 3.15M; итого 15.7M на слой, 28 × 15.7M = 440M, плюс embedding 155.6M → 596M параметров. В bf16 это 1.19 ГБ, в fp32 — 2.38 ГБ.
RMSNorm. Нормировка без вычитания среднего и без сдвига:
y = x / sqrt(mean(x²) + ε) * γ
γ — обучаемый вектор длины 1024. Считается в fp32 независимо от dtype входа (иначе bf16-аккумуляция теряет точность), результат кастуется обратно. Один такой слой — на входе блока и после attention.
RoPE. Вращение пар координат (x_{2i}, x_{2i+1}) на угол θ_i · pos, где θ_i = rope_theta^(-2i/d), d = 128, pos — позиция токена. Для rope_theta = 1e6 частоты лежат в диапазоне от 1.0 (i=0) до 1e-6^(126/128) ≈ 1.15e-6. Реализуется как поворот в двумерной плоскости; в коде — через rotate_half:
rotate_half([x1, x2]) = [-x2, x1]     # x1, x2 — половины вектора головы
q_rot = q * cos(pos·θ) + rotate_half(q) * sin(pos·θ)
Важно: HF хранит inv_freq для i = 0, 2, 4, ..., 126, затем дублирует частоты (cat([freqs, freqs])), чтобы cos/sin имели длину 128. Это соответствует rotate_half над двумя половинами. Другая раскладка (чередование чётных/нечётных, как в оригинальной статье) даёт другие числа — при сверке с HF нужна именно «половинная».
GQA. 16 голов запроса на 8 голов ключа/значения. K и V повторяются вдвое (repeat_interleave по оси голов), после чего обычное scaled dot-product attention с scale = 1/sqrt(128) = 0.0884.
QK-Norm. Отличие Qwen3 от Llama: после проекций и reshape к головам применяется RMSNorm по head_dim = 128 отдельно к q и к k (веса q_norm, k_norm). Это стабилизирует обучение и меняет числа — забыть её значит получить расхождение в каждом слое.
SwiGLU. MLP — три матрицы, а не две:
h = down_proj( silu(gate_proj(x)) * up_proj(x) )
silu(z) = z * sigmoid(z)
gate и up обе расширяют 1024 → 3072, покомпонентно перемножаются, down сжимает обратно 3072 → 1024. Отсюда 3 × 1024 × 3072 = 9.4M параметров на MLP против 2 × 1024 × 4096 = 8.4M у Llama-стиля с тем же бюджетом — при лучшем качестве.
Сборка блока:
x = x + Attention(RMSNorm_1(x))
x = x + MLP(RMSNorm_2(x))
Pre-norm, residual в fp32, никаких bias ни в одном линейном слое (attention_bias: false).
Стоимость шага decode. Проекции: 2 × 596M ≈ 1.19 Гфлоп на токен (умножение на матрицу M×N — это 2MN флоп). При 1.19 ГБ весов в bf16 это ~1 флоп на байт — чудовищно низкая арифметическая интенсивность. Decode упирается в пропускную способность памяти, а не в вычисления: на CPU с реальными 20–40 ГБ/с теоретический потолок — 17–34 токена/с, и это без учёта attention. Практика на ноутбучном CPU: 0.1–0.5 с на токен.
3.6 Почему без кэша всё плохо: O(n²)
Наивный цикл пересчитывает весь префикс на каждом шаге. Стоимость генерации n токенов:
Σ_{i=1..n} i = n(n+1)/2 ≈ n²/2 шагов-эквивалентов
Для n = 1024: 524 800 против 1024 при кэше — в 512 раз больше работы. В абсолютных числах: 524 800 × 1.19 Гфлоп ≈ 625 Тфлоп вместо 1.2 Тфлоп. На CPU это разница между минутами и часами.
Для нашего упражнения (n = 20) переплата всего 210/20 = 10.5× — терпимо, поэтому в этом модуле мы кэш не делаем и честно меряем наивный вариант. Но уже сейчас видно, куда смотреть: при decode нужны только K и V прошлых позиций, а они не меняются. Хранить их — это 2 × 28 слоёв × 8 голов × 128 × 2 байта = 112 КиБ на токен в fp16. На 4096 токенов — 448 МиБ, на максимальные 40960 — 4.5 ГиБ, больше самих весов. Отсюда растёт вся индустрия управления KV-кэшем: PagedAttention, GQA, квантование кэша. Модуль 04.
Задание 03.1: сэмплер top-k/top-p
Реализовать в sampler.py функцию с интерфейсом:
def sample_from_logits(logits, temperature=1.0, top_k=0, top_p=1.0, rng=None) -> int
logits—np.ndarrayформы[V], любые вещественные числа (в том числе большие:±1e4).temperature—float ≥ 0;0означает greedy.top_k—int;0или≥ Vозначает «не обрезать».top_p—floatв(0, 1];1.0— не обрезать.rng—np.random.Generator; приNoneсоздаётся новый.- Возврат —
intв[0, V).
Порядок операций строго: температура → top-k → softmax → top-p → перенормировка → выбор.
Проверить на распределении из раздела 3.1 ([2.0, 1.0, 0.5, 0.0, -1.0]):
temperature=0→ всегда индекс 0.top_k=2→ поддержка строго{0, 1}на 10 000 прогонов.top_p=0.9→ поддержка{0, 1, 2, 3}, токен 4 не появляется ни разу.temperature=0.5даёт заметно бо́льшую вероятность индекса 0, чемtemperature=1.0, аtemperature=2.0— меньшую (монотонность по температуре при фиксированномrng-сиде проверяется усреднением по 10 000 прогонов).
Чеклист задания 03.1
-
sample_from_logitsустойчива кlogits = [1e4, -1e4, 0.0]: нетnan/infв вероятностях (softmax через вычитание максимума). -
temperature=0→argmax, и это ровно индекс 0 на распределении из 3.1 (10 000 прогонов, 10 000 попаданий). -
top_k=2→ поддержка строго{0, 1}; индексы 2, 3, 4 не встречаются ни разу. -
top_k=0иtop_k=V(иtop_k > V) ведут себя одинаково — как отсутствие обрезки. -
top_p=0.9→ поддержка{0, 1, 2, 3}, токен 4 не появляется ни разу. -
top_p=0.5приtemperature=2.0→ поддержка{0, 1}(приT=2распределение плосче:p₀=0.375,p₀+p₁=0.602 ≥ 0.5; приT=1p₀=0.563уже один пересекает порог, и ядро вырождается в{0}— это свойство top-p, а не баг). - Порядок операций именно температура → top-k → softmax → top-p → перенормировка → выбор (проверяется тем, что при
top_k=1результат не зависит отtop_p). - При фиксированном
rng = np.random.default_rng(seed)последовательность вызовов воспроизводима. - Возвращаемое значение — питоновский
int, а неnp.int64. - Время на 10 000 вызовов при
V = 151936— не больше пары секунд (нетO(V log V)сортировки там, где хватаетnp.partition).
Задание 03.2: forward Qwen3-0.6B на torch CPU
Цель — собрать forward вручную, без AutoModelForCausalLM.forward, и доказать численно, что архитектура понята правильно.
Что нужно реализовать (qwen3_cpu.py):
- Загрузка весов из
model.safetensors(или шардов поmodel.safetensors.index.json) черезsafetensors.torch.load_file, приведение кfloat32. - Эмбеддинг:
embed_tokens.weight[input_ids]. - 28 блоков ровно в таком порядке:
h += Attn(RMSNorm(h)), затемh += MLP(RMSNorm(h)), гдеAttn=q/k/v_proj→ QK-norm (q_norm,k_norm— RMSNorm поhead_dimна каждую голову) → RoPE → causal softmax →o_proj, аMLP= SwiGLU:down(silu(gate(x)) * up(x)). - Финальный
model.norm, затемlm_head(приtie_word_embeddings=true— это тот же тензор, чтоembed_tokens). - Greedy-генерация 20 токенов и сверка с
transformers.
Конфиг Qwen3-0.6B (читается из config.json, здесь для сверки): hidden=1024, layers=28, heads=16, kv_heads=8, head_dim=128 (то есть q_proj даёт 2048, k/v_proj — по 1024, GQA 2:1), intermediate=3072, vocab=151936, eps=1e-6, rope_theta=1e6, tie_word_embeddings=true.
Критерии приёмки:
- 20 greedy-токенов совпадают с
transformersпо id, один в один. max |logits_ref.float() - logits_ours| < 0.5на последней позиции при эталоне вbf16(и< 0.05, если эталон тоже загружен вfloat32). Допуск0.5— это как раз масштаб шагаbf16: у чисел порядка 10–20 мантисса bf16 грубее 0.1.- Сверять надо
logitsпоследней позиции после прогрева, а не первый токен: на первом шаге расхождение максимально. - Никакого
past_key_values: каждый шаг пересчитывает весь префикс — это и есть та самая переплатаn(n+1)/2, которую уберёт модуль 04.
Код
sampler.py:
"""Сэмплер top-k / top-p на numpy. Порядок: T -> top-k -> softmax -> top-p -> renorm -> draw."""
from __future__ import annotations

import numpy as np


def sample_from_logits(logits, temperature: float = 1.0, top_k: int = 0,
                       top_p: float = 1.0, rng: np.random.Generator | None = None) -> int:
    if rng is None:
        rng = np.random.default_rng()

    z = np.asarray(logits, dtype=np.float64).reshape(-1)
    V = z.shape[0]
    if V == 0:
        raise ValueError("empty logits")

    # 1) greedy
    if temperature <= 0.0:
        return int(np.argmax(z))

    # 2) температура
    z = z / float(temperature)

    # 3) top-k (через partition, без полной сортировки)
    if 0 < top_k < V:
        kth = np.partition(z, V - top_k)[V - top_k]     # k-й по величине
        z = np.where(z >= kth, z, -np.inf)

    # 4) softmax со сдвигом на максимум
    m = np.max(z)
    p = np.exp(z - m)
    p /= p.sum()

    # 5) top-p (nucleus): оставляем минимальный префикс с суммой >= top_p
    if top_p < 1.0:
        order = np.argsort(-p, kind="stable")
        csum = np.cumsum(p[order])
        cut = int(np.searchsorted(csum, top_p)) + 1
        keep = np.zeros(V, dtype=bool)
        keep[order[:cut]] = True
        p = np.where(keep, p, 0.0)
        s = p.sum()
        if s <= 0.0:                                    # вырожденный случай
            return int(np.argmax(z))
        p /= s

    # 6) выбор по CDF
    cdf = np.cumsum(p)
    u = rng.random() * cdf[-1]
    return int(np.searchsorted(cdf, u, side="right").clip(0, V - 1))
qwen3_cpu.py:
"""Наивный forward Qwen3-0.6B на torch CPU + сверка с transformers (greedy, 20 токенов)."""
from __future__ import annotations

import argparse
import json
import math
import os
import time

import torch
from safetensors.torch import load_file

from sampler import sample_from_logits

torch.set_grad_enabled(False)


# ------------------------------------------------------------------ конфиг
def read_cfg(model_dir: str) -> dict:
    with open(os.path.join(model_dir, "config.json"), encoding="utf-8") as f:
        c = json.load(f)
    return dict(
        hidden=c["hidden_size"],
        layers=c["num_hidden_layers"],
        heads=c["num_attention_heads"],
        kv_heads=c["num_key_value_heads"],
        head_dim=c.get("head_dim", c["hidden_size"] // c["num_attention_heads"]),
        inter=c["intermediate_size"],
        vocab=c["vocab_size"],
        eps=c["rms_norm_eps"],
        theta=c.get("rope_theta", 1_000_000.0),
        tie=c.get("tie_word_embeddings", False),
    )


def load_weights(model_dir: str) -> dict[str, torch.Tensor]:
    idx = os.path.join(model_dir, "model.safetensors.index.json")
    if os.path.exists(idx):
        with open(idx, encoding="utf-8") as f:
            files = sorted(set(json.load(f)["weight_map"].values()))
    else:
        files = ["model.safetensors"]
    w: dict[str, torch.Tensor] = {}
    for fn in files:
        w.update(load_file(os.path.join(model_dir, fn), device="cpu"))
    return {k: v.to(torch.float32) for k, v in w.items()}


# ------------------------------------------------------------------ примитивы
def rmsnorm(x: torch.Tensor, weight: torch.Tensor, eps: float) -> torch.Tensor:
    xf = x.float()
    var = xf.pow(2).mean(-1, keepdim=True)
    return (xf * torch.rsqrt(var + eps)) * weight


def rope_tables(cfg: dict, T: int):
    hd, theta = cfg["head_dim"], cfg["theta"]
    inv = 1.0 / (theta ** (torch.arange(0, hd, 2, dtype=torch.float32) / hd))
    freqs = torch.outer(torch.arange(T, dtype=torch.float32), inv)   # [T, hd/2]
    emb = torch.cat([freqs, freqs], dim=-1)                          # [T, hd]
    return emb.cos(), emb.sin()


def apply_rope(x: torch.Tensor, cos: torch.Tensor, sin: torch.Tensor) -> torch.Tensor:
    # HF rotate_half: половины вектора головы, а не соседние пары
    d = x.shape[-1] // 2
    x1, x2 = x[..., :d], x[..., d:]
    rot = torch.cat([-x2, x1], dim=-1)
    return x * cos[:, None, :] + rot * sin[:, None, :]


def attention(h, w, L, cos, sin, cfg):
    T = h.shape[0]
    nh, nkv, hd = cfg["heads"], cfg["kv_heads"], cfg["head_dim"]

    q = (h @ w[L + "self_attn.q_proj.weight"].T).view(T, nh, hd)
    k = (h @ w[L + "self_attn.k_proj.weight"].T).view(T, nkv, hd)
    v = (h @ w[L + "self_attn.v_proj.weight"].T).view(T, nkv, hd)

    # QK-norm — отличительная черта Qwen3 (RMSNorm по head_dim на голову)
    q = rmsnorm(q, w[L + "self_attn.q_norm.weight"], cfg["eps"])
    k = rmsnorm(k, w[L + "self_attn.k_norm.weight"], cfg["eps"])

    q = apply_rope(q, cos, sin)
    k = apply_rope(k, cos, sin)

    rep = nh // nkv
    k = k.repeat_interleave(rep, dim=1)
    v = v.repeat_interleave(rep, dim=1)

    scores = torch.einsum("thd,shd->hts", q, k) / math.sqrt(hd)
    mask = torch.triu(torch.ones(T, T, dtype=torch.bool), diagonal=1)
    scores = scores.masked_fill(mask, float("-inf"))
    probs = torch.softmax(scores, dim=-1)

    out = torch.einsum("hts,shd->thd", probs, v).reshape(T, nh * hd)
    return out @ w[L + "self_attn.o_proj.weight"].T


def mlp(h, w, L):
    gate = torch.nn.functional.silu(h @ w[L + "mlp.gate_proj.weight"].T)
    up = h @ w[L + "mlp.up_proj.weight"].T
    return (gate * up) @ w[L + "mlp.down_proj.weight"].T


# ------------------------------------------------------------------ forward
def forward(w, cfg, input_ids: torch.Tensor) -> torch.Tensor:
    T = input_ids.shape[0]
    cos, sin = rope_tables(cfg, T)

    h = w["model.embed_tokens.weight"][input_ids]
    for i in range(cfg["layers"]):
        L = f"model.layers.{i}."
        h = h + attention(rmsnorm(h, w[L + "input_layernorm.weight"], cfg["eps"]),
                          w, L, cos, sin, cfg)
        h = h + mlp(rmsnorm(h, w[L + "post_attention_layernorm.weight"], cfg["eps"]), w, L)

    h = rmsnorm(h, w["model.norm.weight"], cfg["eps"])
    if cfg["tie"]:
        lm = w["model.embed_tokens.weight"]
    else:
        lm = w.get("lm_head.weight", w["model.embed_tokens.weight"])
    return h @ lm.T


def greedy(w, cfg, ids: list[int], n: int) -> list[int]:
    out = list(ids)
    for _ in range(n):
        logits = forward(w, cfg, torch.tensor(out, dtype=torch.long))[-1]
        out.append(int(torch.argmax(logits)))
    return out[len(ids):]


# ------------------------------------------------------------------ main
def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--model", default="Qwen/Qwen3-0.6B")
    ap.add_argument("--prompt", default="Столица Франции —")
    ap.add_argument("--n", type=int, default=20)
    ap.add_argument("--seed", type=int, default=0)
    args = ap.parse_args()

    torch.set_num_threads(os.cpu_count() or 1)
    cfg = read_cfg(args.model)
    w = load_weights(args.model)
    print(f"loaded {len(w)} tensors, cfg={cfg}")

    from transformers import AutoModelForCausalLM, AutoTokenizer

    tok = AutoTokenizer.from_pretrained(args.model)
    ids = tok(args.prompt, return_tensors=None)["input_ids"]

    t0 = time.perf_counter()
    mine = greedy(w, cfg, ids, args.n)
    dt = time.perf_counter() - t0
    print(f"ours  ({dt:.1f}s): {tok.decode(mine)}")

    ref = AutoModelForCausalLM.from_pretrained(
        args.model, torch_dtype=torch.bfloat16).eval()
    with torch.no_grad():
        gen = ref.generate(torch.tensor([ids]), max_new_tokens=args.n,
                           do_sample=False, temperature=None, top_p=None,
                           top_k=None, pad_token_id=tok.eos_token_id)
    ref_ids = gen[0, len(ids):].tolist()
    print(f"ref         : {tok.decode(ref_ids)}")
    print(f"ids match   : {mine == ref_ids}")

    with torch.no_grad():
        ours_last = forward(w, cfg, torch.tensor(ids, dtype=torch.long))[-1]
        ref_last = ref(torch.tensor([ids])).logits[0, -1].float()
    dmax = (ours_last - ref_last).abs().max().item()
    print(f"max|dlogit| : {dmax:.4f}  (tolerance 0.5 for bf16 ref)")

    # бонус: тот же forward, но через сэмплер
    rng = torch.Generator().manual_seed(args.seed)
    p = torch.softmax(ours_last, dim=-1)
    nxt = sample_from_logits(ours_last.numpy(), temperature=0.8, top_k=50, top_p=0.95)
    print(f"sample(t=0.8,k=50,p=0.95) -> {tok.decode([nxt])} (p={p[nxt].item():.4f})")


if __name__ == "__main__":
    main()
Как проверить
# 1. сэмплер — без модели, мгновенно
python - <<'PY'
import numpy as np
from sampler import sample_from_logits
logits = np.array([2.0, 1.0, 0.5, 0.0, -1.0])
rng = np.random.default_rng(0)
assert sample_from_logits(logits, temperature=0.0) == 0
sup = {sample_from_logits(logits, top_k=2, rng=rng) for _ in range(10_000)}
assert sup == {0, 1}, sup
sup = {sample_from_logits(logits, top_p=0.9, rng=rng) for _ in range(10_000)}
assert sup == {0, 1, 2, 3}, sup
sup = {sample_from_logits(logits, temperature=2.0, top_p=0.5, rng=rng) for _ in range(10_000)}
assert sup == {0, 1}, sup
print("sampler ok")
PY

# 2. forward + сверка
python qwen3_cpu.py --model Qwen/Qwen3-0.6B --prompt "Столица Франции —" --n 20
# ожидаем: ids match   : True
#          max|dlogit| : ~0.05-0.30  (< 0.5)
Быстрые диагностики, если ids match: False:
| Симптом | Причина |
|---|---|
| Первый же токен другой, `max | Δ |
| Текст связный, но «съезжает» на 5–8 токене | RoPE: перепутаны rotate_half и «соседние пары», или theta вместо 1e6 стоит 1e4 |
Δ растёт с длиной промпта | нет causal-маски либо маска наложена не на те оси |
Δ ~ 1e-3, ids совпадают | всё верно, это bf16-эталон |
KeyError: lm_head.weight | tie_word_embeddings=true, надо брать embed_tokens |
Δ огромный только на длинных промптах | забыт 1/sqrt(head_dim) (у Qwen3 делитель по head_dim=128, не по hidden/heads) |
Сводка
- Наивный decode стоит
O(n²)по префиксу: 20 токенов — это210/20 = 10.5×переплаты, терпимо; 800 токенов — уже625 Тфлопи часы на CPU. - Масштаб проблемы задаёт арифметика:
2·L·n·d²на attention против12·L·n·d²на весах — при коротком префиксе доминируют веса, при длинном всё переворачивается. - KV-кэш для Qwen3-0.6B —
112 КиБ/токенв fp16; 4096 токенов = 448 МиБ, 40960 = 4.5 ГиБ, то есть больше самих весов. Дальше — PagedAttention/GQA/квантование кэша (модуль 04). - Архитектура Qwen3 в 6 примитивов: RMSNorm → GQA-внимание с QK-norm → RoPE (
theta=1e6,rotate_half) → residual → RMSNorm → SwiGLU → residual; ×28, затем final norm и tiedlm_head. - Три места, где легко ошибиться: QK-norm (нет в Llama/Qwen2),
head_dim=128 ≠ hidden/heads=64, и масштаб1/sqrt(128). - Сверка с
transformers— единственный надёжный тест:bf16-эталон даётmax|Δlogit| ≲ 0.5при точном совпадении greedy-id; вfloat32допуск падает до0.05. - Сэмплер держим на numpy и вне модели:
top-kчерезpartition,top-pчерез CDF-префикс, температура строго первой — так его можно тестировать на 10 000 прогонов без загрузки весов.
Навигация по курсу: Хаб курса · Предыдущий: Attention, RoPE и GQA · Следующий: KV-кэш и арифметика памяти