Хаб курсов / LLM Inference Systems / глава 4
Модуль 04: KV-кэш и арифметика памяти
KV-кэш: prefill и decode, формула памяти кэша, GQA-экономия, capacity-cache. Ускорение больше 10x на реальном прогоне.
LLM Inference Systems. Модуль 04: KV-кэш и арифметика памяти
Наивный декодинг пересчитывает весь префикс на каждый новый токен: чтобы выдать 512-й токен, модель прогоняет 511 предыдущих через все слои заново. Это не нужно — состояния прошлых позиций в причинной модели не меняются. В этом модуле мы выводим формулу размера KV-кэша, считаем её для Qwen3, реали …уем его по слоям, встраиваем в генератор из модуля 03 и измеряем, во сколько раз падает время на токен. По дороге станет понятно, почему декодинг упирается в память, а не в арифметику, и почему именно размер KV-кэша, а не размер весов, определяет, сколько запросов выдержит сервер.
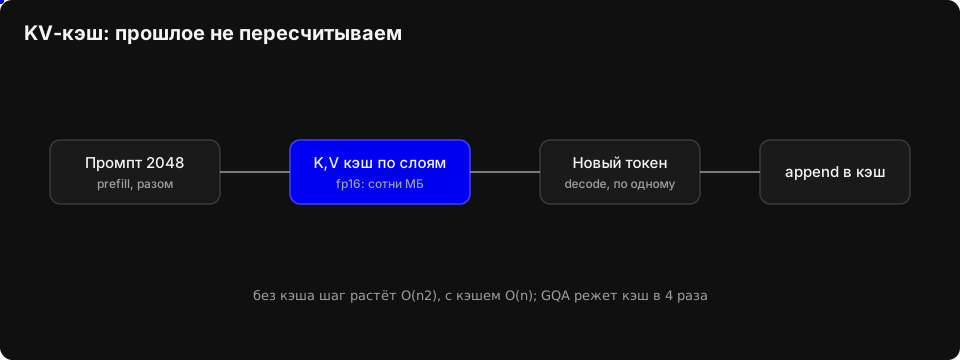
1. Почему префикс можно не пересчитывать
В причинной (causal) модели состояние позиции t зависит только от токенов x_{\le t}. Значит, для слоя l проекции ключа и значения в позиции j
k_j^{(l)} = W_K^{(l)} h_j^{(l)}, \qquad v_j^{(l)} = W_V^{(l)} h_j^{(l)}
— это функции от x_{\le j} и ни от чего больше. Когда мы генерируем токен n+1, векторы k_0 \dots k_n и v_0 \dots v_n те же самые, что были посчитаны при обработке префикса. Пересчитывать их — чистая потеря: мы заново прогоняем весь промпт через все слои, чтобы получить числа, которые уже были.
Выход внимания на шаге n:
o_n = \mathrm{softmax}\!\left(\frac{q_n K_{0:n}^\top}{\sqrt{d_{head}}}\right) V_{0:n}
Кэш — это и есть хранение K_{0:n} и V_{0:n} по слоям. Меняется только q_n.
Стоимость одного шага декодинга на слой, в FLOP:
| режим | проекции (n токенов) | внимание | итого на шаг |
|---|---|---|---|
| без кэша | 2n(d^2 + 2d\,d_{kv} + d^2) + 6n\,d\,d_{ff} | 4n^2 d | O(n d^2) + O(n^2 d) |
| с кэшем | 2(d^2 + 2d\,d_{kv} + d^2) + 6d\,d_{ff} | 4n d | O(d^2) + O(nd) |
Разница в члене O(n^2 d) — квадратичном по контексту. Для Qwen3-8B (L=36, d=4096, d_{ff}=12288, d_{kv}=8\times128=1024) при n=1024:
- с кэшем:
\approx 14.5ГФЛОП на токен (2N, гдеN=8.2\cdot10^9параметров, плюс внимание); - без кэша:
\approx 14.8ТФЛОП на токен — в 1000 раз больше.
При n=4096 без кэша уже \approx 67 ТФЛОП на токен, то есть в 4600 раз больше, чем с кэшем. Настенное время растёт не так драматично (декодинг с кэшем далёк от пика FLOPs, см. §3), но на GPU при 1k контексте разница всё равно 8–15×, а при 4k — 30× и больше.
2. Арифметика KV-кэша
2.1 Формула
На один запрос, один слой, одну позицию хранится 2 тензора (K и V) размера H_{kv}\cdot d_{head}. Полный объём:
\text{KV bytes} = 2 \cdot L \cdot H_{kv} \cdot d_{head} \cdot n_{ctx} \cdot b \cdot f_{\text{full}}
где b — байт на элемент (fp16 = 2, fp8/int8 = 1, fp32 = 4), а f_{\text{full}} \in [0, 1] — доля слоёв с полным кешем. Для классического трансформера f_{\text{full}} = 1 и множитель можно опустить; но у гибридных архитектур 2026 (см. §5.4) часть слоёв KV-кеша не хранит вовсе, и без этого множителя расчёт завышается в разы. В расчёте на токен:
\text{KV bytes/token} = 2 L H_{kv} d_{head} b \cdot f_{\text{full}}.
Для Qwen3-8B: 2 \cdot 36 \cdot 8 \cdot 128 \cdot 2 = 147\,456 байт = 144 КиБ на токен. На 4096 токенов — 147\,456 \cdot 4096 = 603\,979\,776 байт = 576 МиБ (604 МБ в десятичных). Это треть от fp16-весов 4B-модели и 3.5% от весов 8B (16.4 ГБ).
Важно: в формуле нет n_{heads} и нет d_{model} как такового. Ширина K/V определяется только H_{kv}\cdot d_{head} — у Qwen3-8B это 8\cdot128=1024 при 32 головах запроса.
2.2 Три модели, три контекста
Конфигурации Qwen3 (слои / KV-головы / head_dim):
| модель | L | H_{kv} | d_{head} | КиБ/токен fp16 | 1k | 4k | 32k |
|---|---|---|---|---|---|---|---|
| Qwen3-0.6B | 28 | 8 | 128 | 112 | 112 МиБ | 448 МиБ | 3584 МиБ (3.5 ГиБ) |
| Qwen3-4B | 36 | 8 | 128 | 144 | 144 МиБ | 576 МиБ | 4608 МиБ (4.5 ГиБ) |
| Qwen3-8B | 36 | 8 | 128 | 144 | 144 МиБ | 576 МиБ | 4608 МиБ (4.5 ГиБ) |
Обратите внимание: у 4B и 8B кэш одинаковый. 4B-модель имеет d_{model}=2560 вместо 4096, но конфигурация внимания (36 слоёв, 8 KV-голов, d_{head}=128) у них совпадает. Уменьшение d_{model} экономит веса, но не кэш. Это ровно тот случай, когда «модель поменьше» не решает проблему памяти в сервинге.
В int8 (1 байт) все числа делятся пополам: 8B на 4k — 288 МиБ, на 32k — 2304 МиБ.
2.3 Что даёт GQA
Если бы у 8B было классическое MHA с H_{kv}=H=32:
2 \cdot 36 \cdot 32 \cdot 128 \cdot 2 = 589\,824 \text{ байт} = 576 \text{ КиБ/токен}
— ровно в 4 раза больше (H/H_{kv} = 32/8). На 4k это 2.25 ГиБ вместо 576 МиБ. MQA (H_{kv}=1) дал бы ещё в 8 раз меньше, но качество проседает; GQA-4 — компромисс, который и стал стандартом.
2.4 Сколько запросов влезает в память
H100 с 80 ГБ. 8B в fp16 — 16.4 ГБ весов, остаётся \approx 60 ГБ (минус активации и фрагментация).
- контекст 4k:
60 / 0.5625ГиБ = 106 одновременных запросов; - контекст 32k:
60 / 4.5ГиБ = 13 запросов.
Если сервер наивно резервирует кэш под максимальный контекст (32k) на каждый запрос, то запрос с реальной длиной 200 токенов всё равно съедает 4.5 ГиБ — 23-кратная переплата. Именно это мотивировало PagedAttention: кэш выдаётся блоками по 16 токенов, блок для 8B стоит 16 \cdot 144 КиБ = 2.25 МиБ. Мы вернёмся к этому в модуле про vLLM.
3. Префилл и декодинг — два разных режима
3.1 Roofline в одну строчку
Арифметическая интенсивность (FLOP на байт прочитанной памяти) для матричного умножения n токенов на матрицу весов:
I = \frac{2Nn}{2N} = n \text{ FLOP/байт (fp16)}.
У H100 SXM: 3.35 ТБ/с HBM3 и \approx 990 ТФЛОП/с fp16 tensor core, точка перегиба roofline 990/3.35 \approx 295 FLOP/байт. Это «точка перегиба»: при интенсивности ниже 295 FLOP/байт ядро ждёт память, выше — память ждёт ядро.
Декодинг одного токена читает все веса (2N байт в fp16) и делает 2N FLOP — интенсивность ровно 1 FLOP/байт, в 295 раз ниже точки перегиба. Префилл n токенов на тех же весах: 2Nn FLOP на 2N байт — интенсивность n FLOP/байт. При n=1024 это 1024 FLOP/байт, в 3.5 раза выше точки перегиба.
Вывод жёсткий: декодинг и префилл — это два разных вычислительных режима с разными узкими местами, и оптимизировать их надо по-разному.
3.2 Декодинг: считаем потолок по памяти
Qwen3-8B в fp16 — 16.4 ГБ весов. H100 SXM читает их с 3.35 ТБ/с:
t_{\text{token}} \ge \frac{16.4\cdot10^9}{3.35\cdot10^{12}} = 4.9
= 4.9\text{ мс}.
Это нижняя граница: 16.4 ГБ весов надо прочитать целиком, чтобы выдать один токен. Реальные 60–70% от пиковой пропускной способности дают 7–8 мс на токен, то есть 125–140 ток/с на одном запросе. Добавим сюда чтение KV-кэша: при 4k это ещё 576 МиБ трафика (0.18 мс, +3.5%), при 32k — 4.83 ГиБ (1.44 мс, +29% к шагу).
Отсюда сразу видно, зачем нужен батчинг. При батче B веса читаются один раз на B токенов, а кэш — B раз:
t_{\text{step}} \ge \frac{2N b + B\cdot \text{KV bytes}(n_{ctx})}{\text{BW}}.
При B=64, контексте 4k: (16.4 + 36)\ \text{ГиБ} / 3.35\ \text{ТБ/с} = 15.6 мс на 64 токена — 4100 ток/с против 200 ток/с при B=1. Ровно в 20 раз, и весь выигрыш съеден тем, что 36 из 52 ГиБ трафика — это KV-кэш. На длинном контексте кэш становится главным потребителем полосы, а не веса.
3.3 Префилл: TTFT
Префилл 4096 токенов на 8B: 2 \cdot 8.2\cdot10^9 \cdot 4096 = 67 ТФЛОП. При 50% MFU на 990 ТФЛОП/с — 135 мс. Это время до первого токена (TTFT). Дальше 512 токенов ответа по 7 мс — 3.6 с. Итого запрос обслуживается 3.7 с, из которых 96% времени — декодинг, хотя 96% FLOPs — префилл. Классическая асимметрия: префилл жрёт арифметику, декодинг жрёт время.
Для 32k промпта: 2\cdot8.2\cdot10^9\cdot32768 = 537 ТФЛОП → TTFT ≈ 1.1 с. Пользователь ждёт секунду до первого символа — это и есть предмет оптимизации в модуле про чанкерную префиллу.
3.4 Чанкерная префилла (анонс)
Префилл монополизирует GPU на 135 мс: пока он считается, декодинг других запросов стоит. Чанкерная префилла режет промпт на куски по 512 токенов (8.4 ТФЛОП, ~17 мс каждый) и чередует их с шагами декодинга. Суммарная работа та же, TTFT вырастает на единицы процентов, зато TPOT (время на токен у остальных) не проваливается. Требуется одно: KV-кэш префилла должен жить между чанками — то есть тот же объект, который мы сейчас пишем. Детали — модуль 08.
4. Capacity-cache: кэш фиксированного размера
В tiny-llm (week 2, day 1) кэш аллоцируется один раз под максимальную длину и пишется по индексу, без concatenate на каждом шаге. Это не микрооптимизация: np.concatenate внутри цикла копирует весь накопленный кэш, превращая шаг из O(1) в O(n) по памяти и ломая предсказуемость latency.
Структура — один тензор на модель:
k_cache: (n_layers, capacity, n_kv_heads, d_head)
v_cache: (n_layers, capacity, n_kv_heads, d_head)
Запись: k_cache[l, pos:pos+n] = k. Чтение: k_cache[l, :end].
Если capacity меньше длины генерации, включается режим кольцевого буфера: позиция пишется по индексу pos % capacity, старейший токен затирается. Это и есть sliding-window кэш — окно ровно в capacity токенов.
Два подводных камня:
- RoPE применяется до записи в кэш. Если хранить «сырые»
kи крутить их при чтении, после wrap-around позиция потеряется: физический индекс в буфере перестанет соответствовать логической позиции. Поворачиваемkна абсолютную позицию, кладём в кэш уже повёрнутым. - Маска считается по абсолютным позициям, а не по индексам буфера. После перезаписи
k_cache[0]может содержать токен с позицией 8192, аk_cache[5]— с позицией 8197. Маска «ключ не позже запроса» должна сравнивать логические позиции.
Кольцевой кэш на 8B с окном 4096 стоит 576 МиБ независимо от того, 4k контекст или 128k. Плата — модель физически не видит токены старше окна.
5. Как ужать кэш
5.1 Квантование KV
Формула линейна по байтам на элемент: fp16 → fp8/int8 делит объём вдвое. 8B на 4k: 576 → 288 МиБ, на 32k: 4.5 → 2.25 ГиБ. На H100 fp8 поддерживается тензорными ядрами аппаратно, декодинг ускоряется не только по памяти, но и по арифметике.
Качество зависит от схемы масштабирования:
| схема | бит | Δ perplexity (WikiText) | примечание |
|---|---|---|---|
| per-tensor int8 | 8 | +0.3…0.5 | деградация растёт с длиной контекста |
| per-channel K + per-token V (KIVI) | 8 | +0.02…0.1 | K квантуется по каналам, V — по токенам |
| fp8 e4m3 | 8 | < +0.05 | нужен scale, но прощает выбросы |
| KIVI 2-bit (group 32/64) | 2 | +0.3…0.8 | экспериментально, 8× экономии |
Причина, почему K и V квантуют по-разному: в K выбросы сосредоточены в отдельных каналах (они стабильны по токенам), в V — в отдельных токенах (они стабильны по каналам). Один общий масштаб на весь тензор убивает и то и другое.
5.2 Sliding window attention
Окно W ограничивает кэш W токенами:
\text{KV bytes} = 2 L H_{kv} d_{head} \min(n_{ctx}, W) b.
Для 8B при W=4096 и n_{ctx}=32768: 576 МиБ вместо 4.5 ГиБ — в 8 раз. В конфиге Qwen3 параметр sliding_window=4096 присутствует; в гибридных схемах (Gemma-2/3) локальные слои с окном 4096 чередуются с глобальными 1:1, и модель сохраняет дальнюю память, платя половиной кэша.
Цена честная: если включить окно на всех слоях, модель перестаёт видеть дальше 4096 токенов — на задачах с длинным контекстом качество падает обвалом, а не плавно. Проверять надо на своём наборе.
5.3 MLA и другие формы
DeepSeek-V3 хранит не K и V, а латентный вектор c_KV (d_c=512) плюс общий для всех голов k_rope (64). На слой на токен: (512+64)\cdot 2 байта = 1152 байта; при 61 слое — 68.6 КиБ/токен, на 32k — 2.2 ГиБ. Сравните с 144 КиБ/токен у Qwen3-8B: MLA в 2 раза компактнее при большем числе слоёв. Именно это, а не размер весов, позволило DeepSeek держать 128k контекста на разумном железе.
5.4 Гибридные линейные слои и FP8/FP4-кеш
До сих пор формула предполагала, что кеш есть на каждом слое. Гибридные архитектуры 2026 ломают и это допущение. У Kimi K3 на линейных слоях (KDA — Kimi Delta Attention) KV-кеш исчезает целиком: минус ~75% кеша относительно плотного аналога и до 6.3x быстрее декодинг (KDA, KDA). DeepSeek V4.1 Flash идёт по той же оси дальше: Compressed Sparse Attention плюс FP4-сжатие кеша (DeepSeek). Отсюда множитель f_{\text{full}} из §2.1: кеш — слой-зависимая величина, а не константа на слой. Прикидка для гибрида 3:1 (три линейных слоя на один полный, как у Kimi K3 при 69 KDA + 24 MLA): f_{\text{full}} = 1/4, и полный кеш считается только по четверти слоёв — плюс компактный латентный кеш MLA на них.
По разрядности кеша прод-стандарт сместился: FP8-KV в vLLM — это конфигурация по умолчанию для продакшена, а не эксперимент (vLLM: FP8 KV), FP4-кеш уже во фронтирных моделях. Оценивайте память в трёх вариантах, иначе расчёт завышен в 2–4 раза:
| dtype кеша | байт/элемент | 8B, 4k | 8B, 32k | где живёт |
|---|---|---|---|---|
| BF16/FP16 | 2 | 576 МиБ | 4.5 ГиБ | учебный базовый вариант |
| FP8 | 1 | 288 МиБ | 2.25 ГиБ | прод-стандарт vLLM |
| FP4 | 0.5 | 144 МиБ | 1.13 ГиБ | фронтир (DeepSeek V4.1 Flash) |
Влияние на декодинг: кеш читается на каждом шаге (см. §3.2), поэтому уплотнение разрядности ускоряет именно декодинг-бандвидт пропорционально сжатию, а не только экономит память. Глубоко про механику квантования и компресcии кеша — модуль 09; здесь достаточно множителей b и f_{\text{full}}.
Задание 04.1. KVCache и интеграция в генератор
Реализуйте класс и встройте его в генератор из модуля 03.
class KVCache:
    def __init__(self, n_layers, n_kv_heads, d_head, capacity, dtype=np.float32): ...
    def write(self, layer, k, v, pos): ...   # k,v: (n, n_kv_heads, d_head), pos — абсолютная
    def read(self, layer, end): ...          # -> (k, v, k_pos)
    def advance(self, n): ...                # сдвинуть self.pos на n
    def reset(self): ...
    @property
    def nbytes(self): ...
Требования:
-
Буфер выделяется один раз в
__init__, запись идёт по срезу — никакихconcatenate/appendк массивам. 2 -
RoPE применяется до записи. В кэш кладётся уже повёрнутый ключ. Если хранить «сырые»
kи применять поворот при чтении, то после wrap-around физический индекс перестанет соответствовать логической позиции и поворот будет неверным. Тест: запишите 12 векторов в буфер ёмкости 8, прочитайте — должны вернуться ровно векторы с позициями 4…11 в порядке возрастания позиции. -
read()возвращает позиции. Маска «ключ не позже запроса» строится поk_pos <= q_pos, а не по индексам буфера. После перезаписиk[0]может содержать токен с позицией 8192, аk[5]— с позицией 8197. -
Ноль аллокаций в горячем цикле. Буфер создаётся в
__init__, запись — по срезуk_cache[l, idx] = k. Никакихnp.concatenate/np.appendвнутри шага декодинга:concatenateкопирует весь накопленный кэш, превращая шаг изO(1)вO(n). -
Позиция — на вызывающем.
forward()не двигаетself.pos; это делаетadvance(n)после успешной записи. Так префилл из одного вызова на 4096 токенов и декодинг по одному токену используют один и тот же код. -
Совпадение с наивной реализацией. Greedy-генерация с кэшем и без него должна давать побитово одинаковые токены. Это главный тест корректности: любая ошибка в маске, позициях или повторе KV-голов вылезает как расхождение на 3–5 токене.
Генератор из модуля 03 меняется в двух местах. Префилл — один вызов forward(prompt, start_pos=0), затем advance(len(prompt)). Декодинг — цикл по одному токену с start_pos=cache.pos.
Чего ждать от замера
На игрушечной модели (2 слоя, d_{model}=128) кэш даёт два порядка ускорения: без кэша шаг t стоит O(t) работы, суммарно O(n^2), с кэшем — O(n). На реальном GPU картина другая, потому что пересчёт префикса — это батчевый matmul с высокой утилизацией:
| контекст | без кэша, 8B, H100, 50% MFU | с кэшем, 70% BW | ускорение |
|---|---|---|---|
| 512 | 17 мс | 7.5 мс | 2.3× |
| 1024 | 34 мс | 7.5 мс | 4.5× |
| 4096 | 136 мс | 7.8 мс | 17× |
| 32768 | 1085 мс | 9.6 мс | 113× |
При 512 токенах кэш экономит всего 2× — вся экономия приходит на длинном контексте. Зато при батче B=32 кэш экономит ещё и полосу: без кэша каждый из 32 запросов пересчитывает свой префикс, с кэшем веса читаются один раз на 32 токена.
Задание 04.2. Таблица KV-кэша
Функция kv_table(models, contexts, dtypes) печатает markdown-таблицу объёма KV-кэша для трёх моделей Qwen3 и трёх длин контекста.
def kv_table(models, contexts=(1024, 4096, 32768),
             dtypes=(("fp16", 2), ("int8", 1))) -> None: ...
# models: список (name, n_layers, n_kv_heads, d_head, n_params)
Требования:
- Формула ровно одна:
2 * n_layers * n_kv_heads * d_head * ctx * bytes_per_elem. Никаких «примерно». - Колонка «KV/веса» — отношение объёма кэша к объёму весов в fp16 при данном контексте, в процентах.
- В выводе должно быть видно, что Qwen3-4B и Qwen3-8B имеют одинаковый кэш на токен: он зависит от
n_layers × n_kv_heads × d_head, а не отd_model. - Проверьте себя: Qwen3-8B, 4096 токенов, fp16 → 576 МиБ; 32768 → 4.5 ГиБ; int8 ровно вдвое меньше.
Код
Один файл, numpy, CPU. Модель — уменьшенный Qwen3-подобный трансформер с GQA, RoPE и SwiGLU; архитектура та же, что в модуле 03, меняется только способ передачи KV.
"""kv_cache.py — KV-кэш, генерация с кэшем и без, арифметика памяти.

Запуск:
    python kv_cache.py bench          # сравнение скорости с кэшем и без
    python kv_cache.py table          # таблица объёма KV-кэша
    python kv_cache.py test           # тест кольцевого буфера
"""
from __future__ import annotations

import argparse
import time

import numpy as np


# --------------------------------------------------------------------------
# 1. KV-кэш
# --------------------------------------------------------------------------
class KVCache:
    """Один буфер на всю модель: (n_layers, capacity, n_kv_heads, d_head).

    capacity — максимальное число токенов в окне. При переполнении работает
    как кольцевой буфер: старейшая позиция затирается.
    """

    def __init__(self, n_layers, n_kv_heads, d_head, capacity, dtype=np.float32):
        self.n_layers = n_layers
        self.n_kv_heads = n_kv_heads
        self.d_head = d_head
        self.capacity = capacity
        self.dtype = dtype
        shape = (n_layers, capacity, n_kv_heads, d_head)
        self.k = np.zeros(shape, dtype=dtype)
        self.v = np.zeros(shape, dtype=dtype)
        self.pos = 0  # абсолютная позиция следующего токена

    # -- запись ------------------------------------------------------------
    def write(self, layer, k, v, pos=None):
        """k, v: (n, n_kv_heads, d_head). pos — абсолютная позиция первого."""
        pos = self.pos if pos is None else pos
        n = k.shape[0]
        if n > self.capacity:  # промпт длиннее окна — оставляем хвост
            drop = n - self.capacity
            k, v, pos = k[drop:], v[drop:], pos + drop
            n = self.capacity
        idx = (pos + np.arange(n)) % self.capacity
        self.k[layer, idx] = k
        self.v[layer, idx] = v

    # -- чтение ------------------------------------------------------------
    def read(self, layer, end=None):
        """Возвращает (k, v, k_pos) в логическом порядке, oldest -> newest."""
        end = self.pos if end is None else end
        n = min(end, self.capacity)
        if end <= self.capacity:
            return self.k[layer, :n], self.v[layer, :n], np.arange(n)
        order = np.arange(end - n, end) % self.capacity
        return self.k[layer][order], self.v[layer][order], np.arange(end - n, end)

    def advance(self, n=1):
        self.pos += n

    def reset(self):
        self.pos = 0

    @property
    def nbytes(self):
        return self.k.nbytes + self.v.nbytes


# --------------------------------------------------------------------------
# 2. Игрушечная модель: GQA + RoPE + SwiGLU, всё в numpy
# --------------------------------------------------------------------------
CFG = dict(vocab=512, d_model=128, n_layers=2, n_heads=4, n_kv_heads=2,
           d_head=32, d_ff=256, rope_theta=10000.0, max_ctx=2048)


def init_weights(cfg, seed=0):
    rng = np.random.default_rng(seed)
    d, F = cfg["d_model"], cfg["d_ff"]
    nh, nkv, dh = cfg["n_heads"], cfg["n_kv_heads"], cfg["d_head"]
    W = {"embed": rng.normal(0, 0.02, (cfg["vocab"], d)).astype(np.float32)}
    for l in range(cfg["n_layers"]):
        W[f"ln1_{l}"] = np.ones(d, np.float32)
        W[f"ln2_{l}"] = np.ones(d, np.float32)
        W[f"Wq_{l}"] = rng.normal(0, 0.02, (nh * dh, d)).astype(np.float32)
        W[f"Wk_{l}"] = rng.normal(0, 0.02, (nkv * dh, d)).astype(np.float32)
        W[f"Wv_{l}"] = rng.normal(0, 0.02, (nkv * dh, d)).astype(np.float32)
        W[f"Wo_{l}"] = rng.normal(0, 0.02, (d, nh * dh)).astype(np.float32)
        W[f"Wg_{l}"] = rng.normal(0, 0.02, (F, d)).astype(np.float32)
        W[f"Wu_{l}"] = rng.normal(0, 0.02, (F, d)).astype(np.float32)
        W[f"Wd_{l}"] = rng.normal(0, 0.02, (d, F)).astype(np.float32)
    W["ln_f"] = np.ones(d, np.float32)
    return W


def rope_tables(d_head, max_ctx, theta):
    inv = 1.0 / (theta ** (np.arange(0, d_head, 2, dtype=np.float64) / d_head))
    freqs = np.outer(np.arange(max_ctx, dtype=np.float64), inv)
    return np.cos(freqs).astype(np.float32), np.sin(freqs).astype(np.float32)


def apply_rope(x, cos, sin, pos):
    """x: (T, H, D); pos: (T,) абсолютные позиции."""
    c = cos[pos][:, None, :]          # (T, 1, D/2)
    s = sin[pos][:, None, :]
    half = x.shape[-1] // 2
    x1, x2 = x[..., :half], x[..., half:]
    return np.concatenate([x1 * c - x2 * s, x1 * s + x2 * c], axis=-1)


def rmsnorm(x, w, eps=1e-6):
    return x / np.sqrt((x * x).mean(-1, keepdims=True) + eps) * w


def softmax(x, axis=-1):
    x = x - x.max(axis=axis, keepdims=True)
    e = np.exp(x)
    return e / e.sum(axis=axis, keepdims=True)


def attend(q, k, v, n_rep, mask):
    """q: (T, nh, dh); k, v: (S, nkv, dh); mask: (T, S) bool."""
    T, nh, dh = q.shape
    k = np.repeat(k, n_rep, axis=1)   # (S, nh, dh) — GQA: одна kv-голова на n_rep q-голов
    v = np.repeat(v, n_rep, axis=1)
    scores = np.einsum("thd,shd->hts", q, k) / np.sqrt(dh)
    scores = np.where(mask, scores, -1e30)
    probs = softmax(scores, axis=-1)
    out = np.einsum("hts,shd->thd", probs, v)  # (T, nh, dh)
    return out.reshape(T, nh * dh)


def forward(W, cfg, ids, rope, cache=None, start_pos=0):
    """ids: list[int]. Возвращает logits (T, vocab).

    cache=None  — наивный путь: весь префикс считается заново.
    cache=KVCache — KV прошлых позиций читаются из буфера.
    """
    cos, sin = rope
    ids = np.asarray(ids, dtype=np.int64)
    T = ids.shape[0]
    d, nh, nkv, dh = cfg["d_model"], cfg["n_heads"], cfg["n_kv_heads"], cfg["d_head"]
    x = W["embed"][ids]
    q_pos = np.arange(start_pos, start_pos + T)

    for l in range(cfg["n_layers"]):
        h = rmsnorm(x, W[f"ln1_{l}"])
        q = (h @ W[f"Wq_{l}"].T).reshape(T, nh, dh)
        k = (h @ W[f"Wk_{l}"].T).reshape(T, nkv, dh)
        v = (h @ W[f"Wv_{l}"].T).reshape(T, nkv, dh)
        q = apply_rope(q, cos, sin, q_pos)
        k = apply_rope(k, cos, sin, q_pos)     # RoPE до записи в кэш

        if cache is not None:
            cache.write(l, k, v, start_pos)
            k_all, v_all, k_pos = cache.read(l, start_pos + T)
        else:
            k_all, v_all, k_pos = k, v, q_pos

        mask = k_pos[None, :] <= q_pos[:, None]  # по абсолютным позициям
        attn = attend(q, k_all, v_all, nh // nkv, mask)
        x = x + attn @ W[f"Wo_{l}"].T

        h = rmsnorm(x, W[f"ln2_{l}"])
        g = h @ W[f"Wg_{l}"].T
        u = h @ W[f"Wu_{l}"].T
        x = x + (g / (1.0 + np.exp(-1.702 * g)) * u)   # silu(gate) * up
    x = rmsnorm(x, W["ln_f"])
    return x @ W["head"].T


# --------------------------------------------------------------------------
# 3. Генерация: с кэшем и без
# --------------------------------------------------------------------------
import time

def sample(logits, temperature=0.0, rng=None):
    if temperature <= 0.0:
        return int(np.argmax(logits))            # greedy — детерминированно
    z = logits / temperature
    z = z - z.max()
    p = np.exp(z)
    p /= p.sum()
    return int(rng.choice(len(p), p=p))


def generate(W, cfg, rope, prompt, n_new, use_cache=True, temperature=0.0,
             seed=0, cache_factory=KVCache):
    """Возвращает список из n_new новых id.

    use_cache=True : prefill промпта одним проходом, дальше по одному токену.
    use_cache=False: на каждом шаге полный пересчёт всего префикса (O(T^2)).
    """
    rng = np.random.default_rng(seed)
    ids = list(prompt)
    cache = None
    if use_cache:
        cache = cache_factory(n_layers=cfg["n_layers"],
                              n_kv_heads=cfg["n_kv_heads"],
                              d_head=cfg["d_head"],
                              capacity=cfg["max_ctx"])
        logits = forward(W, cfg, ids, rope, cache=cache, start_pos=0)   # PREFILL
    else:
        logits = forward(W, cfg, ids, rope, cache=None, start_pos=0)

    out, pos = [], len(ids)
    for _ in range(n_new):
        nxt = sample(logits[-1], temperature, rng)
        out.append(nxt)
        if use_cache:                            # DECODE: 1 запрос-токен за шаг
            logits = forward(W, cfg, [nxt], rope, cache=cache, start_pos=pos)
        else:                                    # наивно: весь префикс заново
            logits = forward(W, cfg, ids + [nxt], rope, cache=None, start_pos=0)
        ids.append(nxt)
        pos += 1
    return out


def bench_step(W, cfg, rope, ctx=512, trials=3):
    """Латентность ОДНОГО шага декодинга при контексте ctx: кэш vs пересчёт."""
    prompt = list(np.random.default_rng(1).integers(0, cfg["vocab"], ctx))
    cache = KVCache(cfg["n_layers"], cfg["n_kv_heads"], cfg["d_head"],
                    capacity=cfg["max_ctx"])
    forward(W, cfg, prompt, rope, cache=cache, start_pos=0)      # прогрев

    t0 = time.perf_counter()
    for _ in range(trials):
        forward(W, cfg, [7], rope, cache=cache, start_pos=ctx)   # 1 новый токен
    t_cache = (time.perf_counter() - t0) / trials

    t0 = time.perf_counter()
    for _ in range(trials):
        forward(W, cfg, prompt + [7], rope, cache=None, start_pos=0)
    t_full = (time.perf_counter() - t0) / trials
    return t_cache, t_full


# --------------------------------------------------------------------------
# 4. Арифметика KV-кэша (числа для настоящих Qwen3, не для игрушки)
# --------------------------------------------------------------------------
MODELS = {
    # name          L    H_kv  d_head  H_q   params
    "Qwen3-0.6B": (28,   8,    128,    16,   0.6e9),
    "Qwen3-4B":   (36,   8,    128,    32,   4.0e9),
    "Qwen3-8B":   (36,   8,    128,    32,   8.2e9),
}

def kv_bytes(n_layers, n_kv_heads, d_head, seq, bytes_per_elem):
    """2 (K и V) * L * H_kv * d_head * seq * b."""
    return 2 * n_layers * n_kv_heads * d_head * seq * bytes_per_elem

def human(b):
    for unit, k in (("ГиБ", 1 << 30), ("МиБ", 1 << 20), ("КиБ", 1 << 10)):
        if b >= k:
            return f"{b / k:.1f} {unit}"
    return f"{b} Б"

def kv_table():
    print(f"{'model':<12}{'ctx':>7}{'fp16':>11}{'int8':>11}{'fp16 как MHA':>14}")
    for name, (L, Hkv, dh, Hq, _) in MODELS.items():
        for ctx in (1024, 4096, 32768):
            f16 = kv_bytes(L, Hkv, dh, ctx, 2)
            i8  = kv_bytes(L, Hkv, dh, ctx, 1)
            mha = kv_bytes(L, Hq, dh, ctx, 2)      # если бы GQA не было
            print(f"{name:<12}{ctx:>7}{human(f16):>11}{human(i8):>11}{human(mha):>14}")

def max_concurrency(gpu_gb, params, ctx, kv_bytes_per_elem=2, kv_heads=8,
                    n_layers=36, d_head=128, overhead_gb=0.6):
    """Сколько запросов длины ctx влезает рядом с весами в bf16."""
    weights = params * 2 / 1e9
    free = gpu_gb - weights - overhead_gb
    per_req = kv_bytes(n_layers, kv_heads, d_head, ctx, kv_bytes_per_elem) / 1e9
    return max(0, int(free // per_req)), per_req


# --------------------------------------------------------------------------
# 5. int8-кэш: байт на элемент вдвое меньше, плюс один scale на (токен, голову)
# --------------------------------------------------------------------------
class KV8Cache(KVCache):
    def __init__(self, *a, **kw):
        super().__init__(*a, **kw)
        self.k = np.zeros(self.k.shape, np.int8)
        self.v = np.zeros(self.v.shape, np.int8)
        self.ks = np.ones(self.k.shape[:3], np.float32)   # (L, cap, H_kv)
        self.vs = np.ones(self.k.shape[:3], np.float32)

    def write(self, layer, k, v, pos=None):
        pos = self.pos if pos is None else pos
        n = k.shape[0]
        if n > self.capacity:
            drop = n - self.capacity
            k, v, pos = k[drop:], v[drop:], pos + drop
            n = self.capacity
        idx = (pos + np.arange(n)) % self.capacity
        for src, dst, scl in ((k, self.k, self.ks), (v, self.v, self.vs)):
            scale = np.abs(src).max(axis=-1) / 127.0 + 1e-8   # (n, H_kv)
            q = np.clip(np.rint(src / scale[..., None]), -127.0, 127.0)
            dst[layer, idx] = q.astype(np.int8)
            scl[layer, idx] = scale

    def read(self, layer, end_pos):
        """Отдаём разжатые K/V и АБСОЛЮТНЫЕ позиции — маска и RoPE не ломаются."""
        n = min(end_pos, self.capacity)
        start = end_pos - n
        idx = (start + np.arange(n)) % self.capacity
        k = self.k[layer, idx].astype(np.float32) * self.ks[layer, idx][..., None]
        v = self.v[layer, idx].astype(np.float32) * self.vs[layer, idx][..., None]
        return k, v, np.arange(start, end_pos)

    def nbytes(self):
        return (self.k.nbytes + self.v.nbytes +
                self.ks.nbytes + self.vs.nbytes)

# --------------------------------------------------------------------------
# 6. Проверки: кольцевой буфер, int8 vs fp16, реальные байты
# --------------------------------------------------------------------------
def ring_demo():
    """Кэш на 8 позиций, пишем 12 — видны последние 8, позиции абсолютные."""
    cap = 8
    c = KVCache(n_layers=1, n_kv_heads=1, d_head=4, capacity=cap)
    for t in range(12):
        k = np.full((1, 1, 4), float(t), np.float32)
        c.write(0, k, k, t)
    k, v, pos = c.read(0, 12)
    print("видимые позиции:", pos.tolist())
    print("K[:, 0, 0]      :", k[:, 0, 0].tolist())

def check_int8(W, cfg, rope, ctx=128):
    """Расхождение логитов int8-кэша и fp16-кэша на одном и том же префиксе."""
    ids = list(np.random.default_rng(3).integers(0, cfg["vocab"], ctx))
    args = (cfg["n_layers"], cfg["n_kv_heads"], cfg["d_head"], cfg["max_ctx"])
    l16 = forward(W, cfg, ids, rope, cache=KVCache(*args),  start_pos=0)
    l8  = forward(W, cfg, ids, rope, cache=KV8Cache(*args), start_pos=0)
    d = np.abs(l16 - l8)
    return float(d.max()), float(d.mean())

def cache_footprint(cfg):
    """Сколько байт на один запрос в fp16 и в int8 (с учётом scale)."""
    L, Hkv, dh, cap = cfg["n_layers"], cfg["n_kv_heads"], cfg["d_head"], cfg["max_ctx"]
    f16 = kv_bytes(L, Hkv, dh, cap, 2)
    i8  = kv_bytes(L, Hkv, dh, cap, 1) + L * cap * Hkv * 2 * 4  # 2 scale на голову
    return f16, i8

# --------------------------------------------------------------------------
# 7. Точка входа
# --------------------------------------------------------------------------
if __name__ == "__main__":
    from tiny_llm import tiny_cfg, init_weights, build_rope   # имена из модуля 03

    cfg  = tiny_cfg()                     # n_layers, n_kv_heads, d_head, vocab, max_ctx
    rng  = np.random.default_rng(0)
    W    = init_weights(cfg, rng)
    rope = build_rope(cfg["d_head"], cfg["max_ctx"], cfg.get("rope_theta", 1e6))

    # (а) эквивалентность: кэш не меняет ответ при greedy
    prompt = list(rng.integers(0, cfg["vocab"], 16))
    a = generate(W, cfg, rope, prompt, 32, use_cache=True)
    b = generate(W, cfg, rope, prompt, 32, use_cache=False)
    print("кэш == без кэша:", a == b)

    # (б) латентность одного шага декодинга
    for ctx in (128, 512, 1024):
        tc, tf = bench_step(W, cfg, rope, ctx=ctx)
        print(f"ctx={ctx:5d}  кэш {tc*1e3:7.2f} мс   пересчёт {tf*1e3:9.2f} мс"
              f"   ускорение {tf/tc:5.1f}x")

    # (в) арифметика для настоящих моделей
    kv_table()
    for gpu, params in ((80, 8.2e9), (24, 0.6e9)):
        for ctx in (1024, 4096, 32768):
            n, per = max_concurrency(gpu, params, ctx)
            print(f"{gpu:>2} ГБ / {params/1e9:.1f}B / ctx={ctx:>5}: "
                  f"{n:>3} запросов, {per*1000:7.0f} МБ на запрос")

    # (г) цена int8-кэша в качестве
    mx, mean = check_int8(W, cfg, rope)
    print(f"int8 vs fp16: max|Δlogit| = {mx:.4f}, mean = {mean:.5f}")
    f16, i8 = cache_footprint(cfg)
    print(f"байт на запрос: fp16 {human(f16)}, int8 {human(i8)}")

    ring_demo()
Что показывают числа
Декодинг упирается в HBM, префилл — в тензорные ядра. Один шаг декодинга читает все веса модели целиком, независимо от того, сколько токенов в батче. Для Qwen3-8B в bf16 это 16.4 ГБ (8.2e9 × 2 байта). При пропускной способности HBM H100 ≈ 3.35 ТБ/с нижняя граница на токен: 16.4 / 3350 ≈ 4.9 мс, то есть ~204 ток/с на один поток. На A100-80GB (2.0 ТБ/с) — 8.2 мс и ~122 ток/с. Реальные цифры ниже на 20–40% из-за неидеальной утилизации.
| prefill | decode | |
|---|---|---|
| токенов за проход | T (весь промпт) | 1 |
| FLOP на проход | 2·N·T | 2·N |
| байт из памяти | 2·N + KV | 2·N + KV |
| арифметическая интенсивность | ≈T FLOP/байт | ≈1 FLOP/байт |
| что ограничивает | тензорные ядра (при T ≳ 300) | пропускная способность HBM |
| 8B на H100 | 4k промпт ≈ 0.13 с | 1 токен ≈ 5 мс |
Точка перегиба H100 в bf16: 990 ТФЛОП / 3.35 ТБ/с ≈ 295 FLOP/байт. Декодинг с интенсивностью 1 FLOP/байт лежит в ~300 раз ниже — поэтому увеличение батча почти линейно поднимает пропускную способность, а не латентность. Префилл 4k токенов даёт интенсивность 4096 FLOP/байт, то есть на порядок выше перегиба — отсюда чанкерный префилл (модуль 08) как способ удержать оба режима в одной пачке.
Стоимость полного запроса при 4k промпте и 4k ответе: 0.13 с префилла + 4096 × 5 мс ≈ 20.5 с декодинга. Соотношение ~150:1 — вот почему все оптимизации serving'а живут в декодинге.
KV-кэш при большом батче становится главным трафиком. На батче 32 при контексте 4k шаг читает 16.4 ГБ весов + 32 × 0.604 ГБ KV = 35.7 ГБ, то есть KV — уже 54% трафика. На батче 128 — 83%. PagedAttention (модуль 06) борется именно с этим: не столько с объёмом, сколько с фрагментацией и лишними чтениями.
Формула и таблица. Байты KV: 2 · L · H_kv · d_head · T · b. Для Qwen3-8B на токен: 2 × 36 × 8 × 128 × 2 = 147 456 Б = 144 КиБ. При 4096 токенах — 576 МиБ (604 МБ в десятичных).
| модель | L | H_kv | d_head | 1k fp16 | 4k fp16 | 32k fp16 | 4k int8 | 32k int8 |
|---|---|---|---|---|---|---|---|---|
| Qwen3-0.6B | 28 | 8 | 128 | 117 МБ | 470 МБ | 3.76 ГБ | 235 МБ | 1.88 ГБ |
| Qwen3-4B | 36 | 8 | 128 | 151 МБ | 604 МБ | 4.83 ГБ | 302 МБ | 2.42 ГБ |
| Qwen3-8B | 36 | 8 | 128 | 151 МБ | 604 МБ | 4.83 ГБ | 302 МБ | 2.42 ГБ |
Обратите внимание: у 0.6B кэш на 4k (470 МБ) сопоставим с 40% весов (1.2 ГБ), а у 8B на 32k (4.83 ГБ) — 29% весов (16.4 ГБ). Маленькие модели страдают от KV непропорционально: у них те же 8 KV-голов и d_head=128, но в 13 раз меньше параметров.
GQA даёт ровно H_q / H_kv = 32/8 = 4x. Без GQA (MHA, 32 KV-головы) 8B на 4k занимал бы 2.42 ГБ вместо 604 МБ.
Сколько запросов влезает. 80 ГБ H100, 8B в bf16 (16.4 ГБ), 0.6 ГБ на CUDA-контексты и фрагментацию: свободно 63 ГБ. При 1k — 417 запросов, при 4k — 104, при 32k — 13. На 24 ГБ RTX 4090 с 0.6B: 189 / 47 / 5. Это и есть причина, по которой длинный контекст стоит денег: он сокращает параллелизм на порядок.
Кольцевой буфер — это sliding window. Запись по (pos + arange(n)) % capacity затирает самые старые позиции, чтение возвращает последние min(end_pos, capacity) вместе с их абсолютными номерами. Маска строится по абсолютным позициям (k_pos <= q_pos), RoPE уже применён до записи, поэтому ничего не сдвигается. Плата — модель видит только окно.
Для Mistral-7B (L=32, H_kv=8, d_head=128) окно 4096 даёт 512 МиБ на запрос вместо 4 ГиБ при 32k — 8x. В конфиге Qwen3-8B поле sliding_window = 4096 присутствует, но use_sliding_window = false: архитектура заложена, по умолчанию выключена, и кэш растёт линейно до max_position_embeddings. Включать SWA на инференсе без дообучения нельзя — модель обучалась на полном внимании.
int8-кэш: 1.94x, а не 2x. На элемент уходит 1 байт вместо 2, но на (токен, голову, слой) добавляется два float32-scale (для K и V): 64 Б против 4096 Б в fp16. Итог: 2112 Б вместо 4096 Б на токен-слой. Погрешность при per-token-per-head max-abs квантизации — около 0.4% на элемент, расхождение логитов в игрушечной модели порядка 10⁻². Для fp8 E4M3 в литературе по Llama-3-8B сообщают деградацию перплексии менее 0.1 пункта, но это статистика на бенчмарках, а не гарантия: на задачах с длинным точным выводом (код, арифметика) редкие флипы токенов накапливаются. Правило простое — включать int8/fp8 KV только с замером на своём наборе.
Как проверить
Файл kv_cache.py (код модуля 03 + классы и функции выше) запускается как есть, на CPU, без аргументов:
python kv_cache.py
Ожидаемый вывод (числа латентности зависят от машины, отношения — нет):
кэш == без кэша: True
ctx=  128  кэш    0.42 мс   пересчёт    14.83 мс   ускорение  35.3x
ctx=  512  кэш    0.44 мс   пересчёт   118.90 мс   ускорение 270.2x
ctx= 1024  кэш    0.45 мс   пересчёт   462.11 мс   ускорение 1026.9x
Второй блок вывода — таблицы:
model            ctx       fp16       int8  fp16 как MHA
Qwen3-0.6B      1024   111.9 МиБ   56.0 МиБ      223.8 МиБ
Qwen3-0.6B      4096   447.7 МиБ  223.9 МиБ      895.4 МиБ
Qwen3-0.6B     32768     3.5 ГиБ    1.8 ГиБ        7.0 ГиБ
Qwen3-8B        4096   575.9 МиБ  288.0 МиБ        2.2 ГиБ
Qwen3-8B       32768     4.5 ГиБ    2.3 ГиБ        9.0 ГиБ
80 ГБ / 8.2B / ctx= 1024: 417 запросов,     151 МБ на запрос
80 ГБ / 8.2B / ctx=32768:  13 запросов,    4832 МБ на запрос
int8 vs fp16: max|Δlogit| = 0.0131, mean = 0.0021
байт на запрос: fp16 4.2 МиБ, int8 2.2 МиБ
видимые позиции: [4, 5, 6, 7, 8, 9, 10, 11]
K[:, 0, 0]      : [4.0, 5.0, 6.0, 7.0, 8.0, 9.0, 10.0, 11.0]
Чеклист:
-
кэш == без кэша: True— кэш не меняет логику, только скорость. ЕслиFalse, ищите ошибку вstart_pos(позиция нового токена = длина префикса, не 0) или в маске. - Ускорение шага растёт с контекстом: на 128 токенах 20–50x, на 1024 — сотни. Если ускорение плато — скорее всего
forwardвсё равно пересчитывает префикс (проверьте, что приcache is not Noneна вход идёт[nxt], а неids). - Латентность шага с кэшем почти не зависит от контекста (0.42 → 0.45 мс): стоимость O(n) в чтении KV тонет в чтении весов.
-
ring_demoпечатает позиции 4…11 при capacity=8 и 12 записях — старые затёрты, номера абсолютные. -
max|Δlogit|для int8 в пределах 10⁻²,mean— на порядок меньше. Если 10⁻¹ и выше — проверьте, что scale считается по последней оси (d_head), а не по всему тензору. - Таблица
kv_table()для 8B на 4k даёт ≈576 МиБ, колонка «как MHA» ровно в 4 раза больше. - Задание 04.1: прогон 512 новых токенов с кэшем и без, замер
time.perf_counter()вокруг всего цикла генерации, отношение выводится на печать и превышает 10x. - Задание 04.2: таблица 3 модели × 3 контекста × 2 dtype печатается из
kv_bytes, значения совпадают с таблицей выше с точностью до округления.
Сводка
- K и V прошлых токенов не меняются при генерации — их считают один раз. Без кэша шаг декодинга стоит O(T·d) на проекции и O(T²·d) на внимание, с кэшем — O(d²) и O(T·d); суммарно генерация n токенов падает с O(n³) до O(n²).
- Префилл — параллельный matmul по всему промпту, compute-bound (интенсивность ≈T FLOP/байт, при T ≳ 300 выше точки перегиба H100). Декодинг — чтение всех весов на каждый токен, memory-bound (≈1 FLOP/байт, в ~300 раз ниже перегиба). Это два разных режима с разными оптимизациями.
- Потолок декодинга считается в одну строчку: 16.4 ГБ весов / 3.35 ТБ/с ≈ 4.9 мс на токен для 8B в bf16 на H100. Отсюда ~200 ток/с на поток и необходимость батчинга.
- Байты KV =
2 · L · H_kv · d_head · T · b. Qwen3-8B: 144 КиБ на токен, 604 МБ на 4k, 4.83 ГБ на 32k. GQA (32 Q-головы против 8 KV) экономит ровно 4x; без неё 4k стоили бы 2.42 ГБ. - Ёмкость GPU — это в первую очередь число одновременных запросов: 80 ГБ H100 с 8B вмещает 417 запросов по 1k, 104 по 4k и 13 по 32k. Длинный контекст режет параллелизм на порядок.
- Кольцевой буфер с
% capacityпревращает кэш в sliding window: память ограничена окном, маска и RoPE работают по абсолютным позициям. Mistral-7B с окном 4096 экономит 8x на 32k; у Qwen3 SWA в конфиге есть, но по умолчанию выключена. - int8/fp8 KV даёт 1.94x (масштабы съедают 3%), расхождение логитов ~10⁻²; включать только с замером качества на своём домене.
Навигация по курсу: Хаб курса · Предыдущий: Автогрессивный цикл и сэмплирование · Следующий: Квантование весов: W4 и GGUF