Хаб курсов / LLM Inference Systems / глава 5
Модуль 05: Квантование весов: W4 и GGUF
Групповое int4-квантование, quantized matvec, формат GGUF и k-quants llama.cpp, GPTQ и AWQ в двух словах.
LLM Inference Systems. Модуль 05: Квантование весов, W4 и GGUF
На декоде с батчем 1 узкое место — не арифметика, а трафик весов из памяти. Каждый токен требует прочитать все параметры модели ровно один раз, поэтому tok/s ≈ (пропускная способность памяти) / (байт на параметр × число параметров). Отсюда весь смысл квантования: сжать веса в 4 раза — получить почти в 4 раза больше токенов в секунду на том же железе и в 4 раза меньше VRAM.
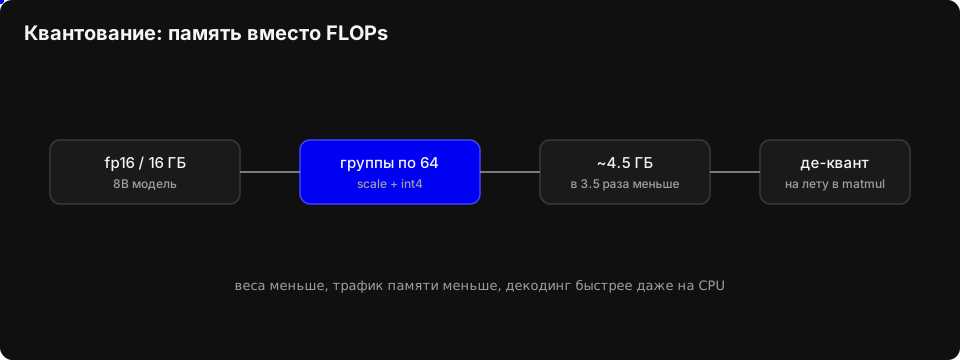
В этом модуле мы разберём групповое симметричное int4-квантование, напишем квантователь, упаковщик полубайтов и dequant-matvec на numpy, прогоним их на весах Qwen3-0.6B и сравним логиты и жадную генерацию с fp32-эталоном. Затем разберём, что именно делает llama.cpp в формате GGUF и почему Q4_K — это не «int4», а суперблок 256 с двумя fp16-константами и 6-битными масштабами на 32 веса.
1. Арифметика памяти: сколько байт и почему это важно
Считаем честно. Веса в fp16 — 2 байта на параметр, int8 — 1 байт, int4 — 0.5 байта плюс накладные расходы на масштабы. При группе 64 и fp16-масштабе накладные расходы = 16 бит / 64 веса = 0.25 бита на вес, итого 4.25 бита = 0.531 байта на параметр.
| Модель | fp16 | int8 (g=64) | int4 (g=64) | Q4_K_M (GGUF) |
|---|---|---|---|---|
| Qwen3-0.6B (0.596B) | 1.19 ГБ | 0.62 ГБ | 0.32 ГБ | ~0.40 ГБ |
| Llama-3-8B (8.03B) | 16.1 ГБ | 8.3 ГБ | 4.26 ГБ | 4.92 ГБ |
| Llama-3-70B (70.6B) | 141 ГБ | 73 ГБ | 37.5 ГБ | 42.5 ГБ |
Для сравнения: KV-кэш Qwen3-0.6B (28 слоёв, 8 KV-голов, head_dim=128) — это 2 × 8 × 128 × 2 байта = 4096 байт на токен на слой, ×28 = 112 КиБ на токен. На 4096 токенов — 448 МиБ, то есть больше, чем int4-веса всей модели. На коротком контексте доминируют веса, на длинном — кэш; это две разные задачи оптимизации, и в модуле 06 мы займёмся второй.
Теперь roofline для декода. На один токен при батче 1 приходится ~2·N_params флопов (по MAC на параметр) и N_params·b байт трафика, где b — байт на параметр. Арифметическая интенсивность:
AI = 2·N / (b·N) = 2/b [FLOP/байт]
Для fp16 это 1 FLOP/байт. У H100 пик bf16 — 989 TFLOPS, память — 3.35 ТБ/с, точка перегиба roofline — 295 FLOP/байт. Мы в 295 раз левее точки перегиба: GPU загружен на 0.3%. Отсюда tok/s ≈ BW / (b·N). На M2 Pro (200 ГБ/с) 8B-модель в fp16 даёт теоретические 200/16.1 = 12.4 tok/s, в int4 — 47 tok/s. Практика ниже (70–80% от теоретического) из-за оверхеда attention, сэмплинга и неидеального доступа к памяти.
Батчинг сдвигает AI вправо: при батче B интенсивность 2B/b, и на B ≈ 150 для fp16 GPU упирается в вычисления. Это причина, по которой серверный инференс (vLLM) квантует ради ёмкости VRAM, а не ради tok/s на запрос.
2. Групповое симметричное квантование
Идея: разбить строку матрицы на группы по 32/64/128 весов, в каждой группе найти absmax, положить scale = absmax / 7, и округлить все веса группы до целых в диапазоне [−7, 7].
q_i = clamp(round(w_i / scale), -7, 7),   scale = max_j |w_j| / 7
ŵ_i = q_i · scale
Почему 7, а не 8: int4 вмещает 16 значений, но симметричный диапазон [−7, 7] даёт 15 уровней и точный ноль (важно: нули в весах должны оставаться нулями, иначе разреженность и «мёртвые» каналы портятся). Один уровень теряем сознательно.
Ошибка. Максимальная абсолютная ошибка на вес — половина шага: absmax/14. Ошибка округления распределена примерно равномерно в [−scale/2, scale/2], её СКО = scale/√12.
Оценим относительную ошибку. Веса линейного слоя близки к гауссовым с σ. Матожидание максимума модуля из g гауссовых величин ≈ σ·√(2·ln 2g):
| group | E[absmax]/σ | scale/σ | RMSE/σ |
|---|---|---|---|
| 32 | 2.88 | 0.412 | 11.9% |
| 64 | 3.11 | 0.445 | 12.8% |
| 128 | 3.33 | 0.476 | 13.7% |
То есть относительная ошибка Фробениуса матрицы после int4-квантования с группой 64 — около 13%, и она растёт с размером группы логарифмически (absmax большой группы больше). Для int8 те же формулы дают 0.71% — вот там действительно «меньше процента».
Тринадцать процентов на слой звучит катастрофически, но модель это переживает: ошибки нулевого среднего и некоррелированы между слоями, а остаточный поток и overparameterization гасят шум. Эмпирически Llama-2-7B в Q4_K_M теряет ~0.06 в перплексии на wikitext2 — около 1%. Это и есть главный практический факт про квантование: шум большой, но безвредный, пока он не смещён.
Именно смещение — проблема. Если в группе есть один выброс (а в LLM есть каналы с амплитудой в 20–50 σ, «super weights»), он раздувает scale и превращает остальные 63 веса в мусор. Отсюда все продвинутые схемы: уменьшить группу, добавить min (асимметрия), или отмасштабировать каналы перед квантованием (AWQ).
3. Три способа считать matvec с квантованными весами
| Схема | Что хранится | Что происходит в цикле | Где встречается |
|---|---|---|---|
| QDQ (dequant-then-matmul) | int4 + scale | деквант всего тензора в fp, затем обычный GEMM | обучение/QAT, наш numpy-код |
| Dequant-matmul (W4A16) | int4 + scale | деквант 8–32 весов в регистрах, FMA с fp-активацией | llama.cpp, AWQ, Marlin |
| Int-матмул (W4A8/W8A8) | int4/int8 + scale | dp4a/vpdpbusd/sdot: int8×int8→int32 | Q8_0 на CPU, TensorRT-INT8 |
Разница в трафике памяти. QDQ читает 0.5 байта на вес, но материализует fp16-тензор — суммарно 2.5 байта на вес на один проход. Dequant-matmul не материализует ничего: прочитал 4 бита, деквантнул в регистре, умножил, выбросил. Для декода это ровно те 0.53 байта на параметр, которые мы обещали.
Второй вариант экономит ещё и на арифметике: int8-умножения на CPU идут через vpdpbusd (AVX-512 VNNI) — 64 MAC за инструкцию, — а на ARM через sdot (dot product extension). Именно поэтому Q8_0 иногда быстрее Q4_K на процессорах с VNNI, несмотря на вдвое больший трафик: арифметика дешевле.
Наш numpy-код будет QDQ по смыслу, но с групповой структурой dequant-matmul: масштаб применяется после частичной суммы по группе, а не к каждому весу.
4. Пакетинг: два int4 в один байт
Хранить int4 в int8-массиве — значит не сэкономить ничего. Упаковка: два соседних веса в один uint8, младший в младшем полубайте.
веса:     w0   w1   w2   w3   w4   w5
q:        -3   +5    0   +7   -7   +1
q+8:      05   0D   08   0F   01   09
байты:  [ 0x?D ]  [ 0xF8 ]  [ 0x91 ]     ← low = чётный вес, high = нечётный
Смещение на +8 переводит знаковые значения в беззнаковые 0..15, чтобы сдвиг >> 4 не тащил знаковый бит. Распаковка:
lo = (byte & 0x0F) - 8
hi = (byte >> 4)   - 8
Почему это реально работает в кернеле: 32 веса = 16 байт = одна 128-битная загрузка (_mm_loadu_si128 / ld1q_u8). Дальше маска, сдвиг, расширение до int16, умножение на broadcast-масштаб, FMA. На 32 веса уходит ~10 инструкций, то есть деквант стоит ~0.3 инструкции на вес — пренебрежимо рядом со стоимостью MAC.
Ограничение: in_features должно быть чётным (обычно делится на 64, так что проблемы нет), а группа должна быть кратна 2, чтобы масштабы не пересекали границы байтов. Группа 64 = 32 байта на группу — идеально ложится в половину кэш-линии.
5. GGUF и k-quants: что внутри Q4_K
GGUF — контейнер: заголовок с версией, словарь метаданных (key-value: архитектура, число слоёв, rope theta, chat template), таблица тензоров с типом, размерностями и смещением, затем выровненные (по умолчанию 32 байта) данные. Ключевое свойство — тензоры лежат подряд и читаются через mmap: llama.cpp не копирует веса в heap, ОС подгружает страницы по требованию, а при нескольких процессах страницы разделяются через page cache. Для 4-гигабайтной модели это экономит 4 ГБ RSS и время старта.
Типы блоков в GGUF (k-quants из PR #1684, ggml):
| Тип | Блок | Байт/блок | Бит/вес | Что хранится |
|---|---|---|---|---|
| Q4_0 | 32 | 18 | 4.5 | fp16 scale, 32×4 бита |
| Q4_1 | 32 | 20 | 5.0 | fp16 scale + fp16 min |
| Q5_0 | 32 | 22 | 5.5 | fp16 scale, 32×5 бит |
| Q8_0 | 32 | 34 | 8.5 | fp16 scale, 32×8 бит |
| Q2_K | 256 | 84 | 2.63 | 2 fp16 + 16 байт 4-бит scale/min + 64 байта квантов |
| Q3_K | 256 | 110 | 3.44 | 1 fp16 + 12 байт 6-бит scale + 32 байта hmask + 64 байта квантов |
| Q4_K | 256 | 144 | 4.5 | 2 fp16 + 12 байт (8×6-бит scale + 8×6-бит min) + 128 байт квантов |
| Q5_K | 256 | 176 | 5.5 | как Q4_K + 32 байта старших бит |
| Q6_K | 256 | 210 | 6.56 | fp16 + 16 байт 8-бит scale + 64 байта qh + 128 байт ql |
Q4_K — суперблок на 256 весов, внутри 8 подблоков по 32. Для каждого подблока хранится 6-битный масштаб sc_j и 6-битный минимум m_j; общие константы d и dmin — fp16 на весь суперблок. Восстановление:
w = d · sc_j · q − dmin · m_j (q ∈ [0, 15], 4 бита без знака)
Асимметрия (наличие min) — принципиальное отличие от Q4_0: подблок сдвигается по оси значений, поэтому распределение с ненулевым левым средним (а веса после RMSNorm и в down_proj часто именно такие) квантуется точнее, чем в симметричном Q4_0, где все 16 уровней тратятся на диапазон ±max(|w|), а половина уровней остаётся неиспользованной.
Два уровня квантования — главная идея k-quants. Сами масштабы sc_j и минимумы m_j тоже квантуются: они укладываются в 6 бит относительно общих d и dmin, вычисленных по всему суперблоку. Отсюда 12 байт на 16 значений вместо 32 при fp16. Получается иерархия: 256 весов → 8 подблоков → 2 fp16 константы → 16 шестибитных параметров. Накладные расходы на метаданные: 16 байт на 256 весов = 0.5 бита на вес, ровно та добавка, что превращает 4.0 в 4.5 бит/вес.
Практическое следствие: Q4_K почти не уступает Q5_0 по качеству при меньшем размере, потому что эффективная группа — 32 веса, а не 256. Масштаб на 256 весов «съел» бы выбросы и посадил бы точность; масштаб на 32 — локальный, выброс портит только свой подблок. Именно поэтому в llama.cpp «K»-варианты вытеснили старые Q4_0/Q4_1: тот же битрейт, заметно меньший PPL.
Смешанные типы. Q4_K_M — не один тип, а рецепт: большинство тензоров в Q4_K, а attention.wv и feed_forward.w2 (наиболее чувствительные к ошибке, потому что их выход суммируется с residual без нормализации) — в Q6_K. Отсюда «M» = medium. Q4_K_S — всё в Q4_K, чуть меньше и чуть хуже. Разница в размере для 7B: ~4.07 ГБ против ~4.37 ГБ, разница в PPL — десятые доли процента в пользу M.
Ещё один рычаг — importance matrix (--imatrix). Прогоняем калибровочный корпус, считаем активации и взвешиваем ошибку квантования по важности входов: веса, на которые приходят большие активации, получают более точный масштаб. Прирост на Q4_K_M скромный (0.1–0.3 PPL), на Q2_K/Q3_K — существенный.
6. CPU-инференс llama.cpp: почему это быстро
Наивный Python-цикл по весам даёт единицы токенов в минуту. llama.cpp на том же железе — десятки токенов в секунду. Разрыв в 4–5 порядков складывается из четырёх вещей.
Нет деквантования в память. Кернел ggml_vec_dot_q4_K_q8_K читает упакованные байты, распаковывает их в регистрах и тут же умножает-аккумулирует. Материализованного fp32-тензора не существует ни на одном шаге. Это ключевое отличие от «dequantize → matmul» в PyTorch: там вы платите и за запись 4 ГБ fp16 в RAM, и за повторное чтение, то есть втрое больше трафика.
Квантованные активации. Перед matvec активации квантуются в int8 (Q8_K, группа 32) с собственными масштабами. Дальше работает целочисленное скалярное произведение: int8 × int4→int8 с накоплением в int32, и только на выходе — одно умножение на произведение масштабов. Целочисленные MAC на CPU дешевле и, главное, не требуют конвертации.
Векторизация под конкретный ISA. ggml компилируется с набором кернелов и выбирает их в рантайме: AVX2, AVX-512, AVX-512 VNNI (vpdpbusd — один инструкцией 4 произведения с накоплением), ARM NEON, NEON dotprod (sdot), а на Apple Silicon — ещё и через AMX-подобные блоки. Плюс _mm_prefetch на следующую строку весов: генерация упирается в память, и предвыборка скрывает latency DRAM.
Планирование и потоки. Работа режется по строкам выходной матрицы (каждый поток берёт свой диапазон out_features) без синхронизации внутри matvec; синхронизация — раз на слой. Веса читаются через mmap, страницы шарятся между процессами. Граф вычислений статический, аллокаций в горячем цикле нет.
Отсюда две разные характеристики производительности:
- Prompt processing (pp) — батчевый GEMM по всем токенам промпта сразу, упирается в арифметику. Сотни–тысячи tok/s.
- Генерация (tg) — по одному токену, каждый требует прочитать все веса модели. Упирается в пропускную способность памяти. Оценка:
tok/s ≈ BW_effective / размер_модели. Для 7B Q4_K_M (4.1 ГБ) и DDR4-3200 в два канала (51 ГБ/с теоретически, 25–35 реально) получаем потолок 6–9 tok/s — и это то, что видно на практике.
Порядок величин для 7B Q4_K_M, -t = физические ядра (порядок величин, ±30%, зависит от версии llama.cpp, контекста и бэкенда):
| CPU | Потоков | Генерация, tok/s | Prompt, tok/s |
|---|---|---|---|
| Ryzen 5 5600X, DDR4-3200 | 6 | 9–12 | 70–100 |
| Core i7-1185G7 (ноутбук, LPDDR4x) | 4 | 7–9 | 50–70 |
| Apple M1 | 8 | 14–18 | 150–220 |
| Apple M2 Pro | 12 | 24–30 | 300–400 |
| Apple M3 Max | 16 | 45–55 | 500–700 |
| Xeon Silver 4314, 8 каналов | 16 | 22–28 | 120–180 |
| Snapdragon X Elite | 12 | 12–16 | 80–120 |
| Raspberry Pi 5 | 4 | 3–4 | 12–20 |
Два практических вывода. Первый: на ноутбуке -t 8 при 4 физических ядрах даст хуже, чем -t 4 — SMT делит кэш и bandwidth, а операция memory-bound. Второй: на сервере с 8 каналами памяти потолок определяется каналами, а не ядрами; 16 потоков на 32-ядерной машине обычно достаточно.
7. GPTQ и AWQ
GPTQ — это послойная пост-тренировочная квантизация с использованием вторых моментов. Идея: квантизовать веса не по одному, а последовательно, и на каждом шаге компенсировать внесённую ошибку, распределяя её по ещё не квантованным весам той же строки пропорционально тому, насколько они «важны» для выходов на калибровочных данных. Важность берётся из матрицы Гессе слоя, аппроксимированной через XᵀX по калибровочному корпусу (обычно 128–1024 последовательностей). Компенсация делается через обратную матрицу, поэтому веса обрабатываются в порядке убывания диагонали и процедура устойчива. Результат: 4-битные веса с ошибкой, заметно меньшей, чем у round-to-nearest, при том же битрейте. Цена — время: для 7B на одной GPU это десятки минут, для 70B — часы, и нужен калибровочный набор, репрезентативный для целевой задачи. Второе ограничение — GPTQ оптимизирует ошибку на конкретном распределении входов: если калибровка была на английском коде, а инференс на русском, качество просядет.
AWQ (Activation-aware Weight Quantization) смотрит на ту же проблему с другой стороны: не все веса равны, а те каналы, на которые приходят большие активации, терять точность не должны. Метод ищет по калибровочным активациям небольшой набор «salient»-каналов (порядка 1% весов) и защищает их, масштабируя соответствующие входы перед квантованием — эквивалентным преобразованием, которое не меняет выход слоя, но перекладывает динамический диапазон с весов на активации. Никакого обратного распространения и матрицы Гессе: только статистика активаций и поиск по сетке коэффициентов масштаба, поэтому AWQ быстрее GPTQ в разы и лучше переносится между доменами. Формально групповое масштабирование, которое мы разбирали выше, — это частный случай той же логики, только без выбора каналов.
Что выбирать. Для CPU-инференса через llama.cpp оба метода не нужны: там свои k-quants и свой формат, а GPTQ/AWQ-чекпоинты конвертируются в GGUF с потерей исходной калибровки (llama.cpp пересчитывает масштабы сам). GPTQ и AWQ — это про GPU-инференс: vLLM, TensorRT-LLM, ExLlama, Marlin-кернелы. Практическое правило: если у вас есть калибровочные данные из целевого домена и время — GPTQ даст минимум PPL; если данных мало или домен неизвестен — AWQ устойчивее; если нужен int4 на CPU — берите GGUF Q4_K_M и не изобретайте. И помните: обе техники квантуют веса, но не активации; для активаций есть отдельные схемы (SmoothQuant, FP8), и это уже другой модуль.
8. Граница сдвинулась: тернарные веса и BITCOS
Основной текст модуля отталкивается от тезиса «int4 — практический пол». К концу 2026 это уже не так: тернарные веса (BitNet b1.58, runtime bitnet.cpp) — рабочий инструментарий, а не curiosity, и упаковка тернарных весов пошла ниже «1.58 бита».
BITCOS («Breaking the 1.58-bit Barrier for Ternary LLMs», Intel, сент. 2026) атакует главную статью расходов классической тернарной упаковки — знаковый бит на каждый вес, включая нули. Схема хранит два потока: presence bitmap (есть ли вес вообще) и компактный вектор знаков только для ненулевых весов. На 29 тернарных моделях доля нулей доходит до 51.5%, что опускает фактический битрейт до 1.485 бита на вес на самых разреженных. Распаковка реализована под AVX-512, AVX2 и Xe2; на тернарных matvec-кернелах — до 1.28x, в decode-пропускной способности — до 1.18x на CPU и 1.27x на GPU.
Что здесь принципиально для нас: пять-trit packing (1.625 бита/вес), который раньше приводили как лучшую схему упаковки, проигрывает схеме «bitmap + компактные знаки» именно потому, что платит за нули. Разреженность тернарных весов — не побочный эффект, а ресурс, который стоит эксплуатировать на уровне формата хранения.
9. FP4-трек: NVFP4 и MXFP4
Параллельная ветка — не int4, а FP4: NVFP4 (формат NVIDIA для tensor cores Blackwell) и MXFP4 — продакшн-форматы 2026 года, а не экспериментальные.
Показательный кейс — vLLM Humming kernel: MXFP4-веса распаковываются при загрузке модели, счёт идёт в FP8 на tensor cores. На малых и средних батчах это даёт ~4.2x на H20 и ~4.5x на H200 против DeepGEMM W8A8. Стек FreeToken держит MXFP4/NVFP4/FP8/BF16 как равноправные форматы одной иерархии.
Смысл для архитектуры движка: FP4-веса + FP8-вычисления — это способ поднять ёмкость VRAM и пропускную способность одновременно, без собственной int-математики в кернелах.
10. KV-квантование нового поколения: KVarN
KV-квантование в этом модуле мы не разбирали как отдельную тему, а между тем baseline-набор уже включает KIVI и TurboQuant (кодбуки; turbo2/turbo3/turbo4 в полях llama.cpp/vLLM), а граница качества уехала на 2 бита.
KVarN (arXiv 2606.03458, Huawei, июнь 2026) — calibration-free схема: Hadamard-ротация + dual-scaling variance normalization по обеим осям, K и V. Ключевое наблюдение авторов: главный механизм деградации качества при агрессивном KV-кванте — накопление ошибки по шагам декодинга из-за неточных per-token scales, а не локальная ошибка квантования. KVarN даёт SOTA на 2-bit KV при длинном reasoning-декодинге (MATH500, AIME24, HumanEval); имплементация в vLLM — github.com/huawei-csl/KVarN.
Куда это продолжает блочное KV-квантование из модуля 09: per-token scales, Hadamard-ротации и кодбуки — следующий шаг за per-block/per-head int8/FP8, разобранным там. Мы вернёмся к этому в модуле 09.
Задание 05.1. Groupwise int4: ошибка логитов
Цель: увидеть своими руками, как группа и наличие zero-point влияют на точность, и получить число, а не «на глаз».
- Возьмите
quantize_int4_groupwiseиdequantized_matvec_fastиз раздела «Код». Убедитесь, что fused-вариант совпадает с плотным dequant+matmul до 1e-5. - Загрузите
Qwen/Qwen3-0.6Bв fp32 (0.6B помещается в CPU-память, GPU не нужен). Достаточноtransformers+torch. - Возьмите 5 промптов: короткий вопрос, длинный технический текст на русском, код на Python, список из 20 пунктов, диалог с системным сообщением. Прогоните каждый через модель в fp32, сохраните
logits[:, -1, :](распределение на последнем токене) — это эталон. - Сквантуйте веса всех
nn.Linear, кромеlm_head(её квантуйте отдельно, в варианте «только lm_head»). Для каждого слоя:W → (packed, scale, zero)сgroup ∈ {32, 64, 128}. Замените forward линейного слоя наdequantized_matvec_fast(батч из одного токена; для префилла можно просто деквантовать плотно и вызвать@). - Для каждого промпта и каждой группы посчитайте:
rms = ||logits_q − logits_fp32||₂ / ||logits_fp32||₂(относительная RMS);- косинус между векторами логитов;
- совпадает ли
argmax(то есть следующий токен при greedy); - позицию первого расхождения при генерации 32 токенов greedy.
- Сведите в таблицу
group × промпт. Ожидаемый порядок: относительная RMS логитов 1–3% при group=64, косинус > 0.999,argmaxсовпадает на 4–5 промптах из 5, расхождение в генерации наступает после 10–20 токенов.
Что сдать: таблицу, одну строку вывода о том, при какой группе ошибка перестаёт падать (обычно 32 → 64 даёт выигрыш, 64 → 128 уже почти нет, потому что упираемся в 4 бита, а не в масштаб), и замечание, на каком промпте ошибка максимальна и почему (подсказка: смотрите на outliers в активациях, а не в весах).
Задание 05.2. int4-слои и генерация против fp16
Цель: пройти путь до конца — от матрицы до текста — и убедиться, что модель не «ломается».
- Оберните
nn.Linearв классInt4Linear, который хранитpacked/scale/zeroкак буферы (неParameter), а вforwardвызываетdequantized_matvec_fastдляx.shape[0] == 1и плотное деквантование +F.linearдля префилла. - Замените все линейные слои в
Qwen3-0.6B, кромеlm_head. Замерьте: размер state_dict до и после (ожидание: ~2.4 ГБ fp32 → ~0.4 ГБ), RSS процесса. - Сгенерируйте greedy (
do_sample=False,max_new_tokens=64) для тех же 5 промптов в fp16 и в int4. - Сравните: позиция первого несовпавшего токена, доля совпавших токенов, субъективное качество (читается ли текст). Для 0.6B на Q4 ожидание — первые 20–40 токенов идентичны, дальше расхождение, но текст остаётся связным.
- Дополнительно: прогоните тот же чекпоинт через
llama.cppсQ4_K_Mи сравните с вашим наивным int4 при том же промпте. Ваш вариант обычно проигрывает 1–2 токена по позиции расхождения — потому что нет компенсации ошибки и нет Q6_K для чувствительных тензоров.
Что сдать: таблицу «промпт / первый разрыв / доля совпадений / размер модели», и вывод о том, где наивный groupwise-int4 проигрывает k-quants.
Опционально: llama.cpp CLI (если установлен llama.cpp)
# 1. Конвертация HF → GGUF (fp16)
python convert_hf_to_gguf.py Qwen/Qwen3-0.6B --outfile qwen3-0.6b-f16.gguf --outtype f16

# 2. Квантование в Q4_K_M
llama-quantize qwen3-0.6b-f16.gguf qwen3-0.6b-q4km.gguf Q4_K_M

# 3. Бенчмарк: генерация и префилл, по потокам
llama-bench -m qwen3-0.6b-q4km.gguf -t 4,8 -p 512 -n 128

# 4. Генерация с теми же промптами, что в задании
llama-cli -m qwen3-0.6b-q4km.gguf -p "Объясни, что такое groupwise-квантование" \
  -n 64 --temp 0 -t 8 --no-display-prompt
Обратите внимание на вывод llama-bench: там отдельно pp512 и tg128. Если tg128 ниже ожидаемого по формуле BW/размер, ищите узкое место в -t (попробуйте -t = число физических ядер) и в --mlock (без него страницы могут вытесняться).
Код
Самодостаточный скрипт: упаковка, распаковка, groupwise-квантование с zero-point, плотный и fused dequant-matvec, замер ошибки. Модель не требуется.
"""
int4 groupwise quantization: pack / unpack / dequantized matvec.
Запуск: python int4_groupwise.py
Зависимости: numpy >= 1.22.
"""
import numpy as np


def pack_int4(q):
    """q: (out, in) uint8 со значениями 0..15 -> (out, in//2) uint8.
    Чётный индекс веса идёт в младший полубайт, нечётный — в старший."""
    assert q.shape[1] % 2 == 0
    lo = q[:, 0::2].astype(np.uint8)
    hi = q[:, 1::2].astype(np.uint8)
    return (lo | (hi << 4)).astype(np.uint8)


def unpack_int4(p, in_features):
    """p: (out, in//2) uint8 -> (out, in) uint8 со значениями 0..15."""
    assert p.shape[1] * 2 == in_features
    out = np.empty((p.shape[0], in_features), dtype=np.uint8)
    out[:, 0::2] = p & 0x0F
    out[:, 1::2] = (p >> 4) & 0x0F
    return out


def quantize_int4_groupwise(W, group=64):
    """W: (out, in) float32.
    Возвращает packed (out, in//2) uint8, scale (out, ng) fp16, zero (out, ng) uint8.
    Восстановление: w ~ scale * (q - zero), q in [0, 15]."""
    W = np.ascontiguousarray(W, dtype=np.float32)
    out_f, in_f = W.shape
    assert in_f % group == 0, "in_features должно делиться на group"
    assert group % 2 == 0, "group должна быть чётной (полубайты не должны пересекать группу)"

    ng = in_f // group
    Wg = W.reshape(out_f, ng, group)

    mn = Wg.min(axis=2)
    mx = Wg.max(axis=2)
    scale = (mx - mn) / 15.0
    scale = np.where(scale < 1e-8, 1e-8, scale).astype(np.float32)

    # zero-point: значение 0.0 после деквантования. Для весов около нуля ~8.
    zero = np.clip(np.rint(-mn / scale), 0.0, 15.0).astype(np.float32)

    q = np.rint(Wg / scale[..., None] + zero[..., None])
    q = np.clip(q, 0.0, 15.0).astype(np.uint8)

    return (pack_int4(q.reshape(out_f, in_f)),
            scale.astype(np.float16),
            zero.astype(np.uint8))


def dequantize_int4(packed, scale, zero, group):
    """Плотное восстановление в fp32. Нужно для префилла и для отладки."""
    out_f, half = packed.shape
    in_f = half * 2
    ng = in_f // group
    q = unpack_int4(packed, in_f).astype(np.float32)
    s = scale.astype(np.float32).reshape(out_f, ng, 1)
    z = zero.astype(np.float32).reshape(out_f, ng, 1)
    return (s * (q.reshape(out_f, ng, group) - z)).reshape(out_f, in_f)


def dequantized_matvec(x, packed, scale, zero, group):
    """Плотный путь: dequant -> matvec. Медленно, но очевидно."""
    W = dequantize_int4(packed, scale, zero, group)
    return W @ x.astype(np.float32)


def dequantized_matvec_fast(x, packed, scale, zero, group):
    """Fused: масштаб применяется к частичной сумме по группе, а не к каждому весу.
    sum_g s_g * (sum_i q_i x_i - z_g * sum_i x_i)"""
    out_f, half = packed.shape
    in_f = half * 2
    ng = in_f // group

    q = unpack_int4(packed, in_f).astype(np.float32).reshape(out_f, ng, group)
    xg = x.astype(np.float32).reshape(ng, group)

    acc = np.einsum('ong,ng->on', q, xg)   # целочисленные частичные суммы
    xsum = xg.sum(axis=1)                  # (ng,)

    s = scale.astype(np.float32)           # (out, ng)
    z = zero.astype(np.float32)            # (out, ng)
    return ((acc - z * xsum[None, :]) * s).sum(axis=1)


def _demo():
    rng = np.random.default_rng(0)
    out_f, in_f = 1024, 1024

    W = (rng.standard_normal((out_f, in_f)) * 0.02).astype(np.float32)
    # немного выбросов, как в реальных слоях
    idx = rng.integers(0, in_f, size=(out_f, 8))
    W[np.arange(out_f)[:, None], idx] *= 12.0
    x = rng.standard_normal(in_f).astype(np.float32)

    # round-trip упаковки
    p0, s0, z0 = quantize_int4_groupwise(W, 64)
    q = unpack_int4(p0, in_f)
    assert q.min() >= 0 and q.max() <= 15
    W_rt = dequantize_int4(p0, s0, z0, 64)
    print("max |W - dequant(W)|:", float(np.abs(W - W_rt).max()))

    ref = W @ x
    print(f"{'group':>6} {'rel RMS':>9} {'cos':>8} {'argmax':>7}")
    for g in (32, 64, 128, 256):
        p, s, z = quantize_int4_groupwise(W, g)
        y = dequantized_matvec_fast(x, p, s, z, g)
        rms = np.sqrt(np.mean((y - ref) ** 2)) / np.sqrt(np.mean(ref ** 2))
        cos = float(y @ ref / (np.linalg.norm(y) * np.linalg.norm(ref)))
        same = int(np.argmax(y) == np.argmax(ref))
        print(f"{g:>6} {rms:>9.4f} {cos:>8.5f} {same:>7d}")

    # fused == dense
    p, s, z = quantize_int4_groupwise(W, 64)
    y1 = dequantized_matvec(x, p, s, z, 64)
    y2 = dequantized_matvec_fast(x, p, s, z, 64)
    print("max |fused - dense|:", float(np.abs(y1 - y2).max()))


if __name__ == "__main__":
    _demo()
Для задания 05.1 подключите модуль как библиотеку и вызовите quantize_int4_groupwise на layer.weight.detach().numpy().T (помните: nn.Linear хранит (out, in) — совпадает с нашим соглашением, транспонировать не нужно).
Как проверить
unpack_int4(pack_int4(q))возвращает ровноqдля всех значений 0..15 — проверьте на массивеnp.arange(16).dequantized_matvecиdequantized_matvec_fastдают одинаковый результат с точностью до 1e-5: масштаб, применённый после частичной суммы, математически эквивалентен.max |W − dequant(W)| ≤ scale/2для каждой группы: ошибка квантования не превышает половины шага.- Относительная RMS на демо-матрице: 0.01–0.03 для group=64. Если получилось 0.2 — вы забыли zero-point или перепутали
lo/hiпри упаковке. - Ошибка убывает с ростом группы до 64, дальше выходит на плато. Если она падает и при 256 — в весах нет выбросов, демо нереалистично.
- В задании 05.2 размер state_dict уменьшается примерно в 4.8 раза (4.5 бита/вес + fp16-масштабы), а не в 8: два int4 в байте дают 4 бита, остальное — метаданные.
llama-benchпоказываетtg128, близкий кBW/размер_модели; расхождение больше 2× — проблема в потоках или в отсутствии--mlock.
Сводка
- int4 в чистом виде — это 16 уровней на группу: масштаб и zero-point на 32–64 веса, группа важнее битрейта.
- Два int4 живут в одном байте; упаковка со смещением +8 позволяет распаковывать
>> 4без знакового расширения, а 32 веса = одна 128-битная загрузка. - QDQ (dequant → matmul) на CPU нежизнеспособен: он втрое увеличивает трафик. Рабочий вариант — fused dequant-matvec, где масштаб применяется к частичной сумме по группе.
- Q4_K — суперблок 256 весов с 8 подблоками по 32, два уровня квантования (6-битные scale/min относительно общих fp16
d/dmin) и асимметрия. 4.5 бита/вес при качестве, близком к Q5_0. - Q4_K_M — рецепт, а не тип:
wvиw2в Q6_K, остальное в Q4_K. Это дефолт для CPU-инференса. - Генерация на CPU memory-bound:
tok/s ≈ BW / размер модели; префилл compute-bound и на порядок быстрее. Потоки = физические ядра. - GPTQ компенсирует ошибку через матрицу Гессе на калибровке, AWQ защищает каналы с большими активациями масштабированием. Оба — про GPU; для CPU берите GGUF k-quants.
- int4 — не практический пол: тернарные веса с BITCOS-упаковкой (bitmap + компактные знаки) спускаются до 1.485 бита/вес; FP4 (NVFP4/MXFP4) — продакшн-формат 2026; KV-квантование уехало на 2 бита (KVarN, TurboQuant).
Навигация по курсу: Хаб курса · Предыдущий: KV-кэш и арифметика памяти · Следующий: Кернелы: SIMD-матмул и tiled prefill