Хаб курсов / LLM Inference Systems / глава 6
Модуль 06: Кернелы: SIMD-матмул и tiled prefill
Иерархия памяти, roofline, AVX2-кернел matvec на C, Metal и CUDA-листинги, tiled prefill.
LLM Inference Systems. Модуль 06: Кернелы, SIMD-матмул и tiled prefill
До сих пор мы смотрели на инференс сверху: раскладка весов, KV-кэш, батчинг. Теперь спускаемся на этаж ниже — к тому, что реально исполняет железо. У LLM-инференса два принципиально разных режима: decode — это matvec (умножение матрицы на вектор, batch=1), упирающийся в пропускную способность DRAM, и prefill — это matmul (batch=T), упирающийся во флопсы. Один и тот же вес 7B-модели в одном режиме даёт 14 tok/s, в другом — тысячи токенов в секунду.
В этом модуле мы руками напишем AVX2-кернел matvec и сравним его с наивным циклом, разберём, что делает BLAS внутри (блочность, упаковка, микроядро), прочитаем глазами Metal-кернел из tiny-llm и CUDA-ядро из llm.c, а затем измерим, что даёт нарезка префилла на чанки — и когда она вредит. Всё, кроме двух «читаем глазами» листингов, запускается на обычном CPU.
6.1 Два режима, две разные машинерии
Разница между decode и prefill — не косметическая, это разница между memory-bound и compute-bound задачей.
| Decode (генерация) | Prefill (обработка промпта) | |
|---|---|---|
| Форма операции | y = W @ x, x — один вектор | Y = X @ W, X — матрица T × d |
| Что читается из памяти | все веса, 2·N байт (fp16) | веса один раз + активации T × d |
| Арифметическая интенсивность | 2N / 2N = 1 флоп/байт | ≈ T флоп/байт |
| Ограничение | пропускная способность DRAM | флопсы ALU / tensor cores |
| Метрика | токенов/с ∝ bandwidth / размер весов | токенов/с ∝ TFLOPS / (2N) |
Числа для 7B-модели (N = 7·10⁹ параметров):
- fp16-веса: 14 ГБ. На Apple M2 Pro (200 ГБ/с) decode: 14 / 200 = 70 мс на токен → 14 tok/s потолок.
- W4-веса: 3.5 ГБ → 17.5 мс → 57 tok/s потолок.
- На M4 (120 ГБ/с): fp16 → 8.6 tok/s, W4 → 34 tok/s.
Никакой кернел не пробьёт этот потолок: если для одного токена нужно прочитать 14 ГБ, а канал даёт 200 ГБ/с, физика закрыта. Именно поэтому квантизация — не «оптимизация», а единственный способ ускорить decode на потребительском железе.
Prefill считается иначе. Для T токенов нужно 2·N·T флоп. При T = 1024 и N = 7·10⁹ это 14.3 ТФЛОП. На M2 Pro с пиком ~13.6 TFLOPS fp16 и реальной эффективностью 40 % (5.4 TFLOPS) — около 2.6 с на 1024 токена, то есть ~390 токенов/с. Против 14 tok/s в decode — в 28 раз быстрее на токен. Отсюда всё устройство современных движков: prefill считать большими матрицами, decode — терпеть memory-bound и прятать его за батчингом.
6.2 Иерархия памяти в числах
Кернел пишут не «под процессор», а под иерархию памяти. Порядок величин, который надо помнить наизусть:
| Уровень | Размер | Латентность | Пропускная способность |
|---|---|---|---|
| Регистры | 16–32 векторных регистра × 32 Б | 0 циклов | — |
| L1d | 32–48 КБ | ~4–5 циклов (≈1.4 нс @3.5 ГГц) | ~200 ГБ/с на ядро (2×32 Б/цикл) |
| L2 | 512 КБ – 2 МБ | ~14 циклов (≈4 нс) | ~64–100 ГБ/с на ядро |
| L3 | 8–32 МБ | ~40–50 циклов (≈14 нс) | ~200–400 ГБ/с |
| DDR5-5600, 2 канала | 32–128 ГБ | ~200–300 циклов (≈60–90 нс) | ~89 ГБ/с |
| Apple M2 Pro (unified) | 16–32 ГБ | ~150 циклов | ~200 ГБ/с |
| H100 SXM, HBM3 | 80 ГБ | ~500 циклов | 3.35 ТБ/с |
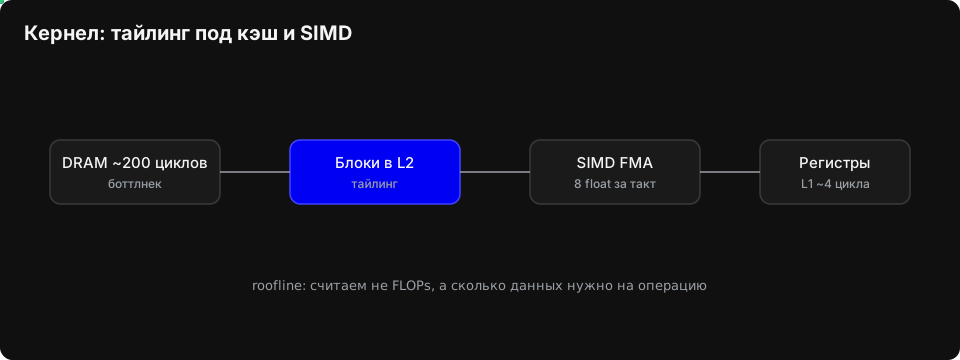
Ключевой разрыв: L1 быстрее DRAM примерно в 50 раз по латентности и в 2–3 раза по полосе. Всё искусство кернелов — не дать вычислению ждать DRAM.
Отсюда правило блокировки: рабочий набор одного шага должен помещаться в L1. Тайл 64 × 64 во float32 — это 64·64·4 = 16 КБ. Два таких тайла (A и B) — 32 КБ, ровно весь L1. Тайл 128 × 128 — уже 64 КБ на штуку, не влезает. Поэтому «магические» числа 32, 64, 128 в GEMM-кернелах — не произвол, а арифметика кэша.
6.3 Roofline в двух словах
Roofline-модель отвечает на вопрос «во что я упрусь»:
достижимые флопсы = min(пик_FLOPS, bandwidth × интенсивность)
интенсивность I = флопы / прочитанные байты
Точка перелома — I* = пик_FLOPS / bandwidth. Для M2 Pro: 13.6e12 / 200e9 ≈ 68 флоп/байт. Для H100: 989e12 / 3.35e12 ≈ 295 флоп/байт.
Decode с batch=1 имеет I = 1 — в 68 раз ниже перелома на M2 Pro и в 295 раз на H100. То есть на H100 decode утилизирует 0.34 % пиковых флопсов. Это не баг реализации, это геометрия задачи.
Prefill с T = 1024 имеет I ≈ 1024 — в 15 раз выше перелома, чисто compute-bound. Отсюда вывод, который стоит держать в голове: оптимизировать decode SIMD-инструкциями бессмысленно, он ждёт память; оптимизировать prefill — осмысленно, он ждёт ALU.
6.4 Что делает BLAS быстрым
np.dot на 4096 × 4096 выдаёт 30–80 GFLOPS на одном ядре CPU. Наивный тройной цикл — 0.5–1.5 GFLOPS. Разрыв в 50 раз. Он складывается из четырёх приёмов.
1. Векторизация. Компилятор или ручной intrinsic заменяет 8 скалярных FMA одной инструкцией vfmadd231ps над регистром YMM. Теоретический выигрыш ×8 (для AVX2, float32).
2. Блочность под кэш. Наивный ijk-цикл на матрице n × n при n = 4096 (64 МБ) читает B-матрицу n раз, итого n³·4 = 275 ГБ трафика при n³·2 = 137 Гфлоп работы — интенсивность 0.5 флоп/байт, то есть в 130 раз хуже перелома. Блокировка 64 × 64 снижает трафик до 2·n³/64 байт и поднимает интенсивность до 32 флоп/байт — почти до перелома.
3. Упаковка (packing). BLAS копирует тайлы в непрерывный буфер с нужным порядком — чтобы внутри микроядра обращения шли строго последовательно и без TLB-промахов.
4. Микроядро. OpenBLAS/BLIS используют ручное ядро 8 × 6 или 6 × 16 регистров, где все аккумуляторы живут в регистрах, а load/FMA идут в отношении 1:1. Плюс многопоточность поверх — вот почему np.dot бьёт наш ручной кернел даже при равной векторизации.
Для matvec (decode) всё это почти не работает: строки матрицы читаются ровно один раз, переиспользования нет. Блокировка тут бесполезна, упаковка бесполезна. Остаётся только векторизация и предвыборка — и жёсткий потолок DRAM.
6.5 Наивный matvec и его векторизация руками
Пишем y[i] = dot(W[i, :], x) для rows × cols.
Наивный вариант:
for (int i = 0; i < rows; i++) {
    float acc = 0.0f;
    const float *row = W + (size_t)i * cols;
    for (int j = 0; j < cols; j++) acc += row[j] * x[j];
    y[i] = acc;
}
Проблема — цепочка зависимостей по acc: каждая следующая FMA ждёт предыдущую. Латентность FMA на Skylake ~4 цикла, значит одно сложение в 4 цикла, а не в 0.5. Векторный вариант решает это четырьмя независимыми аккумуляторами: четыре _mm256_fmadd_ps в теле цикла, каждый со своей цепочкой. Четыре цепочки × 4 цикла латентности = пропускная способность одного FMA-порта, и счётчик больше не тормозит.
Горизонтальная сумма восьми lane'ов в конце строки: _mm256_castps256_ps128 + _mm256_extractf128_ps + _mm_add_ps (получаем 4 значения), затем два _mm_hadd_ps. Это 4–5 инструкций на строку — при cols = 4096 несущественно.
Хвост (cols % 32) добиваем скалярно. В реальных движках d_model всегда кратен 128, так что хвоста нет, но кернел должен быть корректен для любого cols.
6.6 Metal-кернел: simd_matmul из tiny-llm (только Apple Silicon)
tiny-llm (week 2, day 4) делает то же самое на GPU через Metal. Идея: один threadgroup обслуживает несколько выходных элементов, каждый simdgroup (32 lane'а) считает свой dot, simd_sum сворачивает 32 частичных суммы за одну инструкцию (simd_shuffle_down внутри).
// kernels/simd_matmul.metal — только Apple Silicon, на Windows не собирается, читать глазами
#include <metal_stdlib>
using namespace metal;

// y[o] = sum_i W[o, i] * x[i]
// Сетка: threadgroups = ceil(rows / SIMDGROUPS_PER_TG), threads = 128 (4 simdgroup по 32).
kernel void simd_matvec(
    device const float* W      [[buffer(0)]],   // (rows, cols), row-major
    device const float* x      [[buffer(1)]],   // (cols,)
    device float*       y      [[buffer(2)]],   // (rows,)
    constant int&       rows   [[buffer(3)]],
    constant int&       cols   [[buffer(4)]],
    uint tg_id                 [[threadgroup_position_in_grid]],
    uint simd_lane             [[thread_index_in_simdgroup]],
    uint simd_group            [[simdgroup_index_in_threadgroup]])
{
    const int out_idx = tg_id * 4 + simd_group;   // 4 simdgroup на threadgroup
    if (out_idx >= rows) return;

    const device float* row = W + (size_t)out_idx * cols;
    float acc = 0.0f;

    // Каждый lane берёт элементы с шагом 32: обращения соседних lane'ов
    // идут подряд -> memory coalescing, одна транзакция на 128 Б.
    for (int i = simd_lane; i < cols; i += 32) {
        acc = fma(row[i], x[i], acc);
    }

    acc = simd_sum(acc);            // свёртка 32 lane'ов через shuffle, без shared memory
    if (simd_lane == 0) y[out_idx] = acc;
}
Что здесь важно увидеть:
- Сетка потоков.
threads_per_threadgroup = 128,simdgroup = 32lane'а → 4 simdgroup на группу. Каждый simdgroup считает одну строку. Значит, threadgroup закрывает 4 строки за запуск, аthreadgroup_position_in_grid— это номер четвёрки строк. - Coalescing. Lane
kчитаетrow[k],row[k+32], … Соседние lane'ы читают соседние адреса — GPU объединяет их в одну транзакцию. Если бы шаг былi * strideс большим stride, полоса упала бы в 4–8 раз. simd_sumвместо shared memory. Свёртка внутри 32 lane'ов идёт черезsimd_shuffle_down— 5 инструкций, без барьера. Барьерthreadgroup_barrierнужен только когда обмен идёт между simdgroup'ами (в tile-версии сsimdgroup_float8x8).xв кэше. Векторx(4 КБ приd = 1024) читается всеми threadgroup'ами и живёт в L1/L2 — переиспользование есть, поэтому Metal-версия масштабируется лучше, чем наивная CUDA-версия с одним потоком на строку.
6.7 CUDA-аналог: matmul_forward_kernel из llm.c
llm.c (Karpathy) считает out = inp @ weightᵀ + bias для BT токенов, C входных и OC выходных каналов. Оригинальное ядро раскладывает выходные каналы по warp'ам: каждый warp берёт OC / warp_count каналов и итерируется по ним. Ниже — упрощённый тайловый вариант той же операции, он яснее показывает механику shared memory.
// Упрощённый аналог matmul_forward_kernel из llm.c.
// out[t, o] = sum_c inp[t, c] * weight[o, c] + bias[o]
// Сетка: (ceil(OC/TILE), ceil(BT/TILE)), блок: (TILE, TILE) = 32x32 = 1024 потока.
#define TILE 32

__global__ void matmul_forward_kernel(float* out, const float* inp,
                                      const float* weight, const float* bias,
                                      int BT, int C, int OC) {
    __shared__ float xs[TILE][TILE + 1];   // +1 — чтобы избежать bank conflicts
    __shared__ float ws[TILE][TILE + 1];

    const int row = blockIdx.y * TILE + threadIdx.y;   // индекс токена
    const int col = blockIdx.x * TILE + threadIdx.x;   // индекс выходного канала
    float acc = 0.0f;

    for (int c0 = 0; c0 < C; c0 += TILE) {
        // Кооперативная загрузка тайла A: 1024 потока читают 1024 float за раз,
        // адреса соседних потоков подряд -> coalesced.
        xs[threadIdx.y][threadIdx.x] =
            (row < BT && c0 + threadIdx.x < C) ? inp[row * C + c0 + threadIdx.x] : 0.0f;
        ws[threadIdx.y][threadIdx.x] =
            (col < OC && c0 + threadIdx.y < C) ? weight[col * C + c0 + threadIdx.y] : 0.0f;

        __syncthreads();   // тайлы заполнены, можно считать

        #pragma unroll
        for (int k = 0; k < TILE; k++)
            acc += xs[threadIdx.y][k] * ws[threadIdx.x][k];

        __syncthreads();   // все дочитали, можно перезаписывать тайлы
    }

    if (row < BT && col < OC) out[row * OC + col] = acc + bias[col];
}
Разбор:
- Блок 32×32 = 1024 потока = 32 warp'а. Каждый поток считает один элемент
out[row, col]. - Без shared memory каждый поток читал бы 32 элемента
inpи 32 элементаweightиз глобальной памяти на каждый шагk— всего2·BT·OC·Cчтений. С тайлом —2·BT·C + 2·OC·C, в 32 раза меньше. +1в объявленииxs[TILE][TILE+1]— классический трюк: 32 float = 32 банка, при чтении столбцаxs[k][threadIdx.x]все потоки попадают в один банк и сериализуются. Сдвиг на единицу разводит адреса по банкам.__syncthreads()дважды: до и после внутреннего цикла. Пропуск второго — гонка при перезаписи тайла.- Warp здесь работает над строкой
threadIdx.y, то есть 32 потока одного warp'а читаютxs[threadIdx.y][k]— одно и то же значение, broadcast, один банк, быстро.
Для запуска нужна CUDA-карта; на CPU этот листинг не исполняется. Ценность — увидеть, что «тайлинг» одинаков на всех уровнях: те же 32×32, что мы обсуждали для L1, только теперь это размер блока потоков.
6.8 Tiled prefill: зачем резать промпт на чанки
Prefill обрабатывает T токенов сразу: Y = X @ W, X — T × d. При T = 4096, d = 1536 в float32 матрица активаций занимает 4096 · 1536 · 4 = 25 МБ — больше L3 типичного десктопа (16–32 МБ). Веса одного слоя (4 матрицы d × d) — 4 · 1536² · 4 = 37.7 МБ, тоже не влезают.
Нарезка на чанки по 256 строк даёт активации 256 · 1536 · 4 = 1.6 МБ — комфортно в L2. Но есть цена: веса теперь читаются T / chunk = 16 раз вместо одного, то есть 16 · 37.7 = 604 МБ трафика на слой вместо 37.7 МБ.
Это ключевой компромисс, и он объясняет, почему в реальных движках chunked prefill делают не ради кэша, а ради планировщика: чанк — единица работы, которую можно перемежать с decode-шагами других запросов (continuous batching, Orca/OSDI'22) и укладывать в бюджет латентности. На GPU веса слоя (например, 4096² fp16 = 33 МБ) помещаются в L2 размером 50 МБ у H100 — там перечитывание весов бесплатно, и чанкинг действительно помогает.
На CPU ситуация честнее: если веса не влезают в L3, чанкинг вредит. Мы это измерим в задании 06.2 и не будем делать вид, что «чанкинг всегда быстрее».
Ещё один эффект: T = 1 (decode) даёт I = 1, T = 256 даёт I = 256 — уже выше перелома в 68 флоп/байт для M2 Pro. То есть чанк 256 — минимальный размер, при котором prefill перестаёт быть memory-bound и начинает утилизировать ALU. Меньше 64 — почти бессмысленно.
6.9 Куда двигаться дальше: FlashAttention-4, VC-Attention и Triton
Всё, что мы разобрали на CPU, — фундамент; на GPU фронтир кернелов в 2026 сместился дальше простых matmul-ядер.
FlashAttention-4 — текущая вершина линии attention-кернелов: до 1605 TFLOPS на B200, ~2.7x в vLLM 0.17.0. Внутри — TMEM (tensor memory), async-ядра и 2-CTA MMA; поддерживает Blackwell и Hopper. Разбирать её устройство на уровне этого курса рано, но знать иерархию (FA-2 → FA-3 → FA-4) полезно: когда вы читаете бенчмарк движка, версия attention-кернела объясняет разницу лучше, чем «новая архитектура».
VC-Attention (реализация через MachGen, окт. 2026) — открытая реализация под Blackwell, по заявлению разработчиков почти 2x быстрее FA-4 в BF16 на B200. Это заявление разработчиков, а не независимый замер — относитесь как к верхней границе.
Triton остаётся стандартом для кастомных fused-ядер: RMSNorm, SwiGLU, RoPE, FlashAttention, INT8 GEMM, fused MoE — всё это в 2026 пишут в первую очередь на Triton с roofline-анализом, а не на голом CUDA. Ровно тот анализ интенсивности из 6.3, который мы делали вручную, — обязательный шаг перед написанием любого Triton-кернела. Готовая библиотека поверх — Liger-Kernel v0.8.2 (CuTe-ядра для Hopper/Blackwell), про неё подробнее в модуле 07.
Кейс о приоритетах. ik_llama.cpp получил 26x ускорение prompt processing для Qwen 3.5 не микрооптимизациями, а фьюзингом CUDA-ядер: убрали промежуточные проходы в память — получили порядки. Это тот же вывод, что в модуле 07 (fusion — про байты), только на масштабе целого движка.
Apple-трек. На Mac M5 в 2026 живой практический вопрос — MLX против llama.cpp/GGUF: MLX компилируется в Metal, работает в unified memory, и на единой памяти это конкурентная связка для локального инференса (ср. Metal-кернел из 6.6). Весь материал модуля про иерархию памяти переносится на Metal практически дословно.
Задание 06.1 (обязательное, C): AVX2 matvec против наивного
Собери matvec_avx2.c из раздела «Код» и измерь четыре комбинации: наивный и AVX2-кернел, каждый в сборке -O0 и -O3 -mavx2 -mfma.
Интерфейс:
void matvec_naive(const float *W, const float *x, float *y, int rows, int cols);
void matvec_avx2 (const float *W, const float *x, float *y, int rows, int cols);
W — row-major rows × cols, x — длина cols, y — длина rows. Функции должны давать одинаковый результат с точностью max|y1 - y2| < 1e-3 (порядок суммирования разный, отсюда расхождение).
Сборка:
# Linux / macOS (Intel или Apple Silicon под Rosetta — AVX2 там нет, см. примечание)
gcc -O0 -o mv_O0 matvec_avx2.c -lm
gcc -O3 -mavx2 -mfma -o mv_O3 matvec_avx2.c -lm
./mv_O0 && ./mv_O3

# macOS на Apple Silicon: AVX2 отсутствует, используйте NEON-ветку или запускайте в Docker x86_64
# Windows, MSVC (x64 Native Tools Command Prompt):
cl /O2 /arch:AVX2 matvec_avx2.c
# Windows, mingw-w64:
gcc -O3 -mavx2 -mfma -o mv_O3.exe matvec_avx2.c
Что ожидать (порядок величин на DDR5, одно ядро):
| Сборка / кернел | rows=512 (8 МБ, в L3) | rows=4096 (64 МБ, DRAM) |
|---|---|---|
-O0 naive | 0.9–1.5 мс | 6–9 мс |
-O3 naive | 0.15–0.25 мс | 3.0–4.0 мс |
-O3 AVX2 | 0.08–0.12 мс | 2.0–2.8 мс |
Ускорение AVX2 -O3 против naive -O0 на маленькой матрице — 6–15×, на большой — 2.5–3.5×. Разница принципиальна: на 8 МБ данные живут в L3, и узкое место — ALU, векторизация даёт полный эффект. На 64 МБ упор в DRAM (64 МБ / 3 мс ≈ 21 ГБ/с), и никакая векторизация не поможет. Это ровно та roofline-модель из 6.3, только измеренная руками.
Дополнительно объясните в комментарии к отчёту: почему -O3 naive почти догнал AVX2? (GCC с -O3 -mavx2 сам авто-векторизует внутренний цикл и делает ту же развёртку на 4 аккумулятора; наш ручной кернел даёт выигрыш только за счёт явного контроля над хвостом и отсутствия проверок границ.)
Задание 06.2: tiled prefill на numpy
Запусти prefill_tiled.py из раздела «Код». Скрипт делает три вещи:
- Меряет пропускную способность DRAM на matvec
2048 × 2048fp32 (это потолок decode). - Считает
Y = X @ WприT = 4096,d = 1536с чанками128, 256, 512, 1024, 4096и печатает время, ГФЛОПС и объём перечитанных весов. - Симулирует префилл 2-слойного блока (QKV + attention + MLP) при
T = 1024,d = 1024с чанками128и1024.
Интерфейс:
def matmul_chunked(X: np.ndarray, W: np.ndarray, chunk: int) -> np.ndarray:
    """X: (T, d), W: (d, d). Возвращает (T, d), считая блоками по chunk строк."""
Требования к отчёту:
- Постройте таблицу «чанк → мс → ГФЛОПС». Объясните, при каком чанке результат лучший и почему.
- Проверьте корректность:
np.allclose(matmul_chunked(X, W, 128), X @ W, atol=1e-4). - Ответьте числом: во сколько раз вырастает трафик весов при
chunk = 128противchunk = 4096для слоя из 4 матриц1536 × 1536fp32?
Ожидаемый результат: разница между чанками в пределах ±15 %, и скорее всего полный прогон без нарезки окажется не хуже. Это правильный ответ, а не провал задания: np.dot внутри уже блокирует (OpenBLAS: тайл 128, микроядро 8×6, упаковка), а наша нарезка только добавляет накладные расходы и перечитывание весов. Ускорение появится, если раскошелиться на матрицу, где активации заведомо больше L3, — попробуйте T = 16384, d = 2048 (активации 134 МБ) и чанк 256.
Код
matvec_avx2.c
/* matvec_avx2.c — наивный и AVX2-кернел matvec, замер в мс и ГБ/с.
 *
 * Сборка:
 *   gcc -O0 -o mv_O0 matvec_avx2.c -lm
 *   gcc -O3 -mavx2 -mfma -o mv_O3 matvec_avx2.c -lm
 *   cl  /O2 /arch:AVX2 matvec_avx2.c        (MSVC, x64)
 *   gcc -O3 -mavx2 -mfma -o mv_O3.exe matvec_avx2.c   (mingw-w64)
 *
 * Без -mavx2 собирается, но AVX2-кернел откатывается на скалярный.
 */
#include <stdio.h>
#include <stdlib.h>
#include <math.h>

#if defined(_MSC_VER)
  #include <windows.h>
  static double now_ms(void) {
      static LARGE_INTEGER freq = {0};
      LARGE_INTEGER c;
      if (freq.QuadPart == 0) QueryPerformanceFrequency(&freq);
      QueryPerformanceCounter(&c);
      return (double)c.QuadPart * 1000.0 / (double)freq.QuadPart;
  }
#else
  #include <time.h>
  static double now_ms(void) {
      struct timespec ts;
      clock_gettime(CLOCK_MONOTONIC, &ts);
      return ts.tv_sec * 1e3 + ts.tv_nsec / 1e6;
  }
#endif

#if defined(__AVX2__)
  #include <immintrin.h>
#endif

/* Детерминированное заполнение: xorshift32, значения в [-0.5, 0.5). */
static void fill(float *a, size_t n, unsigned seed) {
    unsigned s = seed ? seed : 1u;
    for (size_t i = 0; i < n; i++) {
        s ^= s << 13; s ^= s >> 17; s ^= s << 5;
        a[i] = (float)(s >> 8) * (1.0f / 16777216.0f) - 0.5f;
    }
}

/* ---------- эталон: наивный цикл с одной цепочкой зависимостей ---------- */
void matvec_naive(const float *W, const float *x, float *y, int rows, int cols) {
    for (int i = 0; i < rows; i++) {
        const float *row = W + (size_t)i * (size_t)cols;
        float acc = 0.0f;
        for (int j = 0; j < cols; j++) acc += row[j] * x[j];   /* латентность FMA ~4 цикла */
        y[i] = acc;
    }
}

/* ---------- AVX2: 4 независимых аккумулятора, 32 float за итерацию ---------- */
void matvec_avx2(const float *W, const float *x, float *y, int rows, int cols) {
#if defined(__AVX2__)
    for (int i = 0; i < rows; i++) {
        const float *row = W + (size_t)i * (size_t)cols;
        __m256 a0 = _mm256_setzero_ps();
        __m256 a1 = _mm256_setzero_ps();
        __m256 a2 = _mm256_setzero_ps();
        __m256 a3 = _mm256_setzero_ps();

        int j = 0;
        for (; j + 32 <= cols; j += 32) {
            /* loadu: на практике адреса выровнены, цена нулевая; безопасно для любого W */
            a0 = _mm256_fmadd_ps(_mm256_loadu_ps(row + j),      _mm256_loadu_ps(x + j),      a0);
            a1 = _mm256_fmadd_ps(_mm256_loadu_ps(row + j + 8),  _mm256_loadu_ps(x + j + 8),  a1);
            a2 = _mm256_fmadd_ps(_mm256_loadu_ps(row + j + 16), _mm256_loadu_ps(x + j + 16), a2);
            a3 = _mm256_fmadd_ps(_mm256_loadu_ps(row + j + 24), _mm256_loadu_ps(x + j + 24), a3);
        }

        __m256 s = _mm256_add_ps(_mm256_add_ps(a0, a1), _mm256_add_ps(a2, a3));

        /* горизонтальная сумма 8 lane'ов */
        __m128 lo = _mm256_castps256_ps128(s);
        __m128 hi = _mm256_extractf128_ps(s, 1);
        lo = _mm_add_ps(lo, hi);        /* 4 значения */
        lo = _mm_hadd_ps(lo, lo);       /* 2 значения */
        lo = _mm_hadd_ps(lo, lo);       /* 1 значение */
        float acc = _mm_cvtss_f32(lo);

        for (; j < cols; j++) acc += row[j] * x[j];   /* хвост */
        y[i] = acc;
    }
#else
    matvec_naive(W, x, y, rows, cols);   /* нет AVX2 — честно откатываемся */
#endif
}

typedef void (*matvec_fn)(const float *, const float *, float *, int, int);

static double bench(matvec_fn fn, const float *W, const float *x, float *y,
                    int rows, int cols, int iters) {
    fn(W, x, y, rows, cols);                        /* прогрев */
    double t0 = now_ms();
    for (int it = 0; it < iters; it++) fn(W, x, y, rows, cols);
    return (now_ms() - t0) / iters;
}

int main(void) {
    /* rows=4096, cols=4096: 64 МБ — гарантированно из DRAM, не из L3 */
    const int rows = 4096, cols = 4096, iters = 20;
    const size_t nW = (size_t)rows * cols;
    float *W = malloc(nW * sizeof(float));
    float *x = malloc(cols * sizeof(float));
    float *y1 = malloc(rows * sizeof(float));
    float *y2 = malloc(rows * sizeof(float));
    if (!W || !x || !y1 || !y2) { fprintf(stderr, "OOM\n"); return 1; }
    fill(W, nW, 12345u);
    fill(x, cols, 67890u);

    /* 1. корректность */
    matvec_naive(W, x, y1, rows, cols);
    matvec_avx2 (W, x, y2, rows, cols);
    float diff = 0.0f;
    for (int i = 0; i < rows; i++) {
        float d = fabsf(y1[i] - y2[i]);
        if (d > diff) diff = d;
    }
    printf("max|y1-y2| = %.3e (порог 1e-3)\n", diff);
    if (diff >= 1e-3f) { fprintf(stderr, "FAIL: кернелы расходятся\n"); return 1; }

    /* 2. замер */
    double bytes = (double)nW * 4 + cols * 4;   /* W + x, y пренебрежимо */
    struct { const char *name; matvec_fn fn; } ks[] = {
        {"naive", matvec_naive},
        {"avx2 ", matvec_avx2 },
    };
    printf("%-8s %10s %10s\n", "kernel", "ms", "GB/s");
    for (int k = 0; k < 2; k++) {
        double ms = bench(ks[k].fn, W, x, y1, rows, cols, iters);
        printf("%-8s %10.3f %10.1f\n", ks[k].name, ms, bytes / ms / 1e6);
    }

    free(W); free(x); free(y1); free(y2);
    return 0;
}
prefill_tiled.py
# prefill_tiled.py — tiled prefill на numpy: чанки, время, ГФЛОПС, трафик весов.
# Запуск: python prefill_tiled.py   (numpy, CPU, без CUDA)
import time
import numpy as np


def matmul_chunked(X: np.ndarray, W: np.ndarray, chunk: int) -> np.ndarray:
    """X: (T, d), W: (d, d). Возвращает (T, d), считая блоками по chunk строк."""
    T = X.shape[0]
    out = np.empty((T, W.shape[1]), dtype=X.dtype)
    for i in range(0, T, chunk):
        out[i:i + chunk] = X[i:i + chunk] @ W
    return out


def bench_ms(fn, n=3):
    fn()  # прогрев
    t0 = time.perf_counter()
    for _ in range(n):
        fn()
    return (time.perf_counter() - t0) / n * 1e3


rng = np.random.default_rng(0)

# --- 1. потолок decode: matvec, упор в DRAM ---
Xv = rng.standard_normal((2048, 2048), dtype=np.float32)
x = Xv[0]
ms = bench_ms(lambda: Xv @ x, n=5)
bytes_ = Xv.nbytes + x.nbytes
print(f"matvec 2048x2048: {ms:.3f} мс, {bytes_/ms/1e6:.1f} ГБ/с  <- полоса DRAM (потолок decode)")

# --- 2. tiled prefill: T=4096, d=1536 ---
T, d = 4096, 1536
X = rng.standard_normal((T, d), dtype=np.float32)
W = rng.standard_normal((d, d), dtype=np.float32)
flops = 2.0 * T * d * d
print(f"\nprefill T={T}, d={d}: активации {X.nbytes/1e6:.0f} МБ, веса {W.nbytes/1e6:.1f} МБ")
print(f"{'chunk':>6} {'ms':>9} {'GFLOPS':>8} {'перечитано весов':>18}")
for chunk in (128, 256, 512, 1024, 4096):
    ms = bench_ms(lambda c=chunk: matmul_chunked(X, W, c))
    reread = (T / chunk - 1) * W.nbytes / 1e6
    print(f"{chunk:>6} {ms:>9.1f} {flops/ms/1e6:>8.1f} {reread:>15.0f} МБ")

assert np.allclose(matmul_chunked(X, W, 128), X @ W, atol=1e-4)

# --- 3. трафик весов на слое из 4 матриц d x d ---
for chunk in (128, 4096):
    rereads = T / chunk
    print(f"\nслой 4 матриц {d}x{d} fp32, chunk={chunk}: "
          f"{rereads:.1f}x чтение весов = {4 * rereads * W.nbytes / 1e6:.0f} МБ на слой")
Как проверить
# 1. AVX2-кернел (Windows mingw-w64):
gcc -O0 -o mv_O0 matvec_avx2.c -lm
gcc -O3 -mavx2 -mfma -o mv_O3 matvec_avx2.c -lm
./mv_O0 && ./mv_O3
# Windows MSVC (x64 Native Tools Command Prompt):
cl /O2 /arch:AVX2 matvec_avx2.c && matvec_avx2.exe

# 2. tiled prefill:
python prefill_tiled.py
Чеклист:
-
max|y1-y2| < 1e-3— AVX2-кернел совпадает с наивным. -
mv_O3быстрееmv_O0минимум в 3 раза (границы 2.5–15×, см. 06.1). - В таблице prefill разница между чанками ≤ ±15 %;
chunk=4096не хуже — и вы можете объяснить почему (OpenBLAS блокирует сам). -
np.allcloseна chunk=128 проходит. - Число перечитанных весов при chunk=128 ровно в 32 раза больше, чем при chunk=4096 (T/chunk = 4096/128).
Сводка
- Decode — matvec, memory-bound (I=1 флоп/байт), потолок = bandwidth / размер весов; prefill — matmul, compute-bound (I≈T), потолок = TFLOPS / 2N.
- Иерархия памяти: L1 ~4 цикла / 32–48 КБ, DRAM ~200–300 циклов — тайл 64×64 fp32 (16 КБ) подобран под L1 не случайно.
- Roofline: точка перелома I* = пик_FLOPS / bandwidth; на H100 decode утилизирует ~0.3 % флопсов — квантизация весов единственный рычаг, а не SIMD.
- BLAS = векторизация + блокировка + упаковка + микроядро + многопоточность; для matvec всё, кроме векторизации, бесполезно — переиспользования данных нет.
- AVX2-кернел: 4 независимых FMA-цепочки убивают зависимость по аккумулятору; хвост скалярно; выигрыш 6–15× против -O0, но на больших матрицах упор в DRAM съедает его до 2.5–3.5×.
- Metal/CUDA-ядра используют тот же тайлинг, что и CPU: coalescing, shared memory с padding против bank conflicts, simd_sum вместо барьера.
- Фронтир 2026: FlashAttention-4 (1605 TFLOPS на B200, ~2.7x в vLLM 0.17), VC-Attention (заявление разработчиков: ~2x FA-4 в BF16), Triton как стандарт кастомных fused-ядер (Liger-Kernel v0.8.2), фьюзинг даёт порядки (ik_llama.cpp: 26x prompt processing), на M5 — связка MLX/Metal.
- Chunked prefill на CPU с BLAS внутри чаще вредит (перечитывание весов), чем помогает; его настоящая роль — единица планирования в continuous batching, а не кэш-оптимизация.
Навигация по курсу: Хаб курса · Предыдущий: Квантование весов: W4 и GGUF · Следующий: Fused-операторы и FlashAttention