Хаб курсов / LLM Inference Systems / глава 7
Модуль 07: Fused-операторы и FlashAttention
Fusion убирает трафик HBM: fused RMSNorm и SwiGLU, FlashAttention с online softmax на numpy.
LLM Inference Systems. Модуль 07: Fused-операторы и FlashAttention
В модуле 02 мы написали attention «в лоб»: S = QKᵀ, softmax, PV. На ноутбуке с 4k токенов это работает. На GPU с 4k токенов это упирается в память: матрица S для одного слоя Qwen3-0.6B занимает 537 МБ в bf16, и её приходится записать в HBM, прочитать для softmax, записать P, прочитать для умножения на V. Четыре лишних прохода по 537 МБ — на каждый слой, на каждый forward.
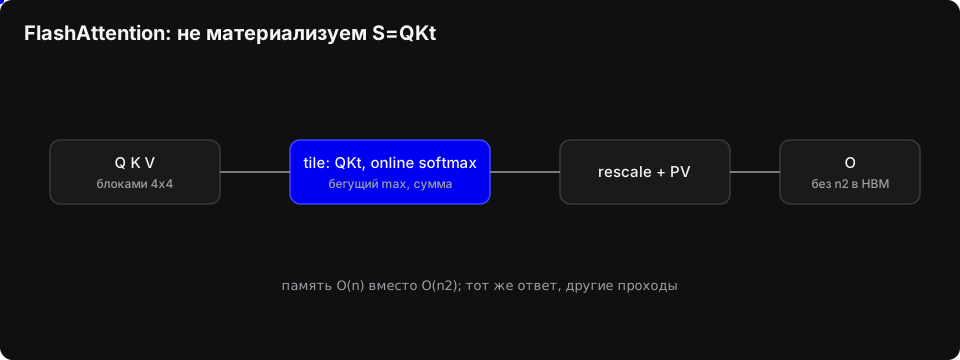
Здесь мы разбираем два приёма, которые убирают этот трафик: fusion (склеивание elementwise-операторов в один кернел, чтобы активации не покидали регистры) и FlashAttention (tiled-вычисление attention с online softmax, при котором S вообще не материализуется). Оба приёма — про байты, не про FLOPы. К концу модуля у нас будет рабочая numpy-реализация FlashAttention, побитово (до 1e-5) совпадающая с наивной, но с пиком памяти O(n · block) вместо O(n²).
Почему один большой кернел дешевле десяти маленьких
Любой оператор над тензором на GPU делает три вещи: читает входы из HBM, считает, пишет выход в HBM. Время = max(FLOPs / peak_flops, bytes / bandwidth). Отношение FLOPs / bytes — арифметическая интенсивность. У современного ускорителя «точка перелома» (ridge point) лежит в районе 100–300 FLOP/байт: H100 SXM — 989 TFLOPS bf16 и 3.35 ТБ/с, то есть 295 FLOP/байт.
Посчитаем для RMSNorm в Qwen3-0.6B (d_model = 1024, bf16 = 2 байта на элемент, строка = 2048 байт). Операций на строку: возведение в квадрат (1024), сумма (1024), умножение на inv_rms (1024), умножение на вес (1024) — примерно 4·1024 = 4096 FLOP. Байт — минимум 4096 (прочитать x, записать y). Интенсивность = 1 FLOP/байт. Это в 300 раз ниже ridge point: RMSNorm целиком упирается в память, считать там нечего.
Отсюда правило: для memory-bound операторов единственный способ ускориться — уменьшить число байт, прочитанных и записанных в HBM. Fusion уменьшает его ровно во столько раз, сколько промежуточных тензоров мы перестаём материализовать.
| Оператор (Qwen3-0.6B, bf16) | Наивно, байт на токен | Fused, байт на токен | Выигрыш |
|---|---|---|---|
RMSNorm, d=1024 | 8192 (2 прохода + временный x²) | 4096 | 2.0× |
SwiGLU epilogue, I=3072 | 30 720 (5·I·2) | 6144 (GPU) / 18 432 (CPU) | 5.0× / 1.67× |
Attention, n=4096, d=128, на голову | 134 МБ (S и P в HBM) | 16–64 МБ (tiles) | 2–8× |
Fused RMSNorm
Что делает наивная реализация
RMSNorm: y = x / sqrt(mean(x²) + eps) * w. В PyTorch x.pow(2).mean(-1) — это три обращения к памяти: прочитать x и записать x², прочитать x² для среднего, — плюс четвёртое: прочитать x ещё раз, чтобы нормировать. Итого для строки длиной d:
наивно:  read x (2d байт) + write x² (2d) + read x² (2d) + read x (2d) + write y (2d) = 10d
fused:   read x (2d) + write y (2d)                                            = 4d
При d = 1024 и bf16: 20 480 байт против 8192 байт на строку. В Qwen3-0.6B 28 слоёв и по два RMSNorm на слой (перед attention и перед MLP) — 56 норм на токен. На префилле в 4096 токенов это 4.6 ГБ против 1.8 ГБ трафика только на нормализации.
Один проход
Ключ — не материализовать x². Сумму квадратов копим в скалярном (векторном по строкам) аккумуляторе, а второй проход делаем по данным, которые уже горячие в L1/L2. На GPU строка d=1024 в bf16 — это 2 КБ, она целиком влезает в регистры одного варпа (32 потока × 32 регистра × 4 байта = 4 КБ), поэтому «второй проход» физически не идёт в HBM. На CPU в numpy мы можем только честно убрать временный массив x² и разбить работу на чанки, чтобы пик памяти был O(chunk), а не O(d).
Про Welford: для дисперсии он нужен, когда среднее неизвестно и данные приходят потоком. Здесь среднее x не нужно вовсе (RMS, не стандартное отклонение), поэтому достаточно наивного накопления Σx². Потерь точности нет: все слагаемые неотрицательны, катастрофического сокращения не бывает. При d = 1024 и float32 сумма квадратов типичной активации (порядок 1) — это ~10³, представимо с 7 значащими цифрами.
Fused SwiGLU
MLP в Qwen3-0.6B: h = silu(x·W_gate) ⊙ (x·W_up), затем h·W_down, где d = 1024, I = 3072.
Наивный путь материализует g = x·W_gate (3072 элемента = 6 КиБ), u = x·W_up (6 КиБ), потом читает оба и пишет silu(g)⊙u (6 КиБ): 30 КиБ трафика на токен на слой. 28 слоёв × 4096 токенов = 3.4 ГиБ.
На GPU оба GEMM-выхода рождаются в регистрах, epilogue применяется до записи, и в HBM уходит только silu(g)⊙u — 6 КиБ, выигрыш 5×. На CPU без написания своего GEMM-ядра мы можем слить два GEMM в один (конкатенация весов по столбцам, как в ggml у llama.cpp) и считать epilogue по view, не копируя g и u: 18 432 байта вместо 30 720, выигрыш 1.67×. Разница между 1.67× и 5× — это ровно то, что даёт контроль над тем, где живёт промежуточный тензор.
FlashAttention: не материализуем матрицу внимания
Сколько стоит S
Для одной головы Qwen3-0.6B при n = 4096, d = 128, bf16:
|S| = n² · d?  нет: |S| = n² = 16 777 216 элементов = 33.5 МБ
16 голов × 33.5 МБ = 537 МБ на слой
Наивный путь: записать S (33.5 МБ), прочитать для rowmax (33.5), прочитать и записать exp (33.5 + 33.5), прочитать P для PV (33.5) — около 134 МБ трафика на голову. При этом полезных FLOPов всего 4n²d = 8.6 ГФЛОП, то есть интенсивность ~64 FLOP/байт — вдвое ниже ridge point даже на A100.
Хуже того, S для всех 16 голов сразу не влезает в 40–80 ГБ карту при n = 32k: `32768² × 2 байта = 2.
1 ГБ на одну голову — и 34 ГБ на 16 голов слоя при n = 32k. Карта, на которой уже лежат веса и KV-кэш, этого не переживёт: материализация Sперестаёт быть вопросом скорости и становится вопросом «запустится ли вообще». FlashAttention убираетS` из HBM целиком. Цена — переписать softmax так, чтобы он считался по кускам и не знал заранее, каким будет максимум строки.
Online softmax: вывод
Что именно нужно посчитать
Для одной строки i (один query-токен) результат внимания — это
O_i = Σ_j softmax(s_ij) · v_j = ( Σ_j exp(s_ij - m_i) · v_j ) / ( Σ_j exp(s_ij - m_i) )
где m_i = max_j s_ij введён только ради численной устойчивости: exp(s_ij - m_i) ≤ 1, переполнения нет. Заметим главное: нормированный результат не зависит от того, какое m мы вычли. Для любого конечного c:
Σ_j exp(s_ij - c) v_j / Σ_j exp(s_ij - c) = Σ_j exp(s_ij - m) v_j / Σ_j exp(s_ij - m)
потому что exp(s_ij - c) = exp(s_ij - m) · exp(m - c), и множитель exp(m - c) сокращается в числителе и знаменателе. Именно это свойство позволяет считать softmax по частям: m можно менять по ходу, если вместе с ним пересчитывать уже накопленные суммы.
Инвариант
Разобьём столбцы j = 0..n-1 на блоки B_1, B_2, ..., B_T по B_c штук. После обработки первых t блоков держим тройку (m, l, O):
m_t  = max над всеми увиденными s_ij
l_t  = Σ_{j ∈ B_1..B_t} exp(s_ij - m_t)
O_t  = Σ_{j ∈ B_1..B_t} exp(s_ij - m_t) · v_j
Инвариант: O_t / l_t в точности равен результату внимания по первым t блокам столбцов, посчитанному обычным softmax с любым удобным максимумом.
База: t = 0, m = -∞, l = 0, O = 0 — пустая сумма.
Шаг: добавляем блок B_{t+1}
Считаем s_b = Q_i · K_{B_{t+1}}^T / √d — вектор из B_c скоров, ещё не выходящий из SRAM. Дальше:
m_blk = max_j∈B  s_ij                  локальный максимум блока
m_new = max(m_t, m_blk)                новый глобальный максимум
Старые суммы были посчитаны относительно m_t, а нам нужны относительно m_new. Пересчёт — это домножение на константу:
exp(s_ij - m_new) = exp(s_ij - m_t) · exp(m_t - m_new)
Значит:
corr  = exp(m_t - m_new)                        ← коэффициент пересчёта, ≤ 1
l_new = l_t · corr + Σ_{j∈B} exp(s_ij - m_new)
O_new = O_t · corr + Σ_{j∈B} exp(s_ij - m_new) · v_j
m     = m_new
В записи через локальный максимум блока это ровно формула из спецификации:
l_new = l_t · exp(m_t - m_new) + row_sum_blk · exp(m_blk - m_new)
где row_sum_blk = Σ_j exp(s_ij - m_blk) — сумма, посчитанная внутри блока относительно его собственного максимума. Обе формы эквивалентны, потому что exp(s - m_new) = exp(s - m_blk) · exp(m_blk - m_new). Первая форма дешевле (одна экспонента на элемент вместо двух), вторая удобнее для анализа.
Финализация
После последнего блока O_T и l_T посчитаны относительно одного и того же m_T, поэтому
O_i = O_T / l_T
Одно деление на строку. Никакого второго прохода по данным.
Три следствия, из которых растёт вся конструкция
Sне нужен целиком. В любой момент в памяти живёт блокB_r × B_cскоров,B_r × dаккумулятор и две вектор-строкиm,lдлиныB_r. ПриB_r = B_c = 128,d = 128, bf16 это128·128·2 = 32 КБна блок скоров — против 33.5 МБ на полную матрицу приn = 4096.- Обратный проход тоже возможен без
S. Достаточно сохранитьmиl(по2nчисел на голову) и пересчитать блокиSзаново при backward. Именно это делает FA дешёвым по памяти при обучении: активации внимания —O(n), а неO(n²). - Численная устойчивость сохраняется.
m— всегда текущий максимум, поэтому все экспоненты ≤ 1, иcorr ≤ 1(пересчёт только уменьшает старые суммы).
Числовой пример: 8 токенов, блоки 4×4
Возьмём n = 8, d = 1 (чтобы O было скаляром), v_j = j + 1, то есть v = [1,2,3,4,5,6,7,8]. Скоры строки 0: [2, 4, 1, 3 | 0, 5, 2, 1], строки 1: [7, 1, 2, 0 | 3, 2, 1, 0]. Два блока столбцов: B_1 = {0..3}, B_2 = {4..7}.
Строка 0, блок 1. m_blk = 4, m_old = -∞, m_new = 4, corr = exp(-∞) = 0.
| j | s | v | exp(s−4) | вклад в O |
|---|---|---|---|---|
| 0 | 2 | 1 | 0.13534 | 0.13534 |
| 1 | 4 | 2 | 1.00000 | 2.00000 |
| 2 | 1 | 3 | 0.04979 | 0.14936 |
| 3 | 3 | 4 | 0.36788 | 1.47152 |
l = 0·0 + 1.55300 = 1.55300, O = 0·0 + 3.75622 = 3.75622.
Строка 0, блок 2. m_blk = 5, m_old = 4, m_new = 5, corr = exp(4−5) = 0.367879.
| j | s | v | exp(s−5) | вклад в O |
|---|---|---|---|---|
| 4 | 0 | 5 | 0.00674 | 0.03369 |
| 5 | 5 | 6 | 1.00000 | 6.00000 |
| 6 | 2 | 7 | 0.04979 | 0.34851 |
| 7 | 1 | 8 | 0.01832 | 0.14653 |
l = 1.55300 · 0.367879 + 1.07484 = 0.57131 + 1.07484 = 1.64615
O = 3.75622 · 0.367879 + 6.52872 = 1.38187 + 6.52872 = 7.91059
O/l = 7.91059 / 1.64615 = 4.8055

Проверка обычным softmax по всей строке: взвешенное среднее `v` = 4.8055 — совпало.
FlashAttention-наив на numpy
Ключевое свойство: FlashAttention не приближает softmax, а считает его точно — единственное отличие от наивной формулы в порядке сложения. Наивный путь материализует матрицу скоров S размера n×n и трижды гоняет её через HBM (запись S, чтение S для max, чтение S для exp, чтение P для P@V). Блочный путь держит в «SRAM» (у нас — в локальных переменных цикла) только блок Br×Bc и накапливает результат по мере прохода.
Три регистра на строку блока — m (бегущий максимум), l (бегущая сумма экспонент), acc (невзвешенная сумма P@V). При смене максимума старые l и acc умножаются на exp(m_old − m_new); деление на l делается один раз в конце строки.
# flash_attn.py — наивная FlashAttention на numpy, сверка с обычным attention
import numpy as np

rng = np.random.default_rng(0)


def softmax(x, axis=-1):
    x = x - x.max(axis=axis, keepdims=True)
    e = np.exp(x)
    return e / e.sum(axis=axis, keepdims=True)


def attention_ref(Q, K, V, causal=False):
    """Эталон: материализуем S (n×n) и P (n×n)."""
    d = Q.shape[-1]
    S = (Q @ K.T) / np.sqrt(d)                     # (n, n) — вот она, память
    if causal:
        n, m = S.shape
        S = np.where(np.triu(np.ones((n, m), bool), k=1), -np.inf, S)
    P = softmax(S, axis=-1)                        # (n, n)
    return P @ V


def flash_attention(Q, K, V, Br=4, Bc=4, causal=False):
    """Блочный attention. Массивов размера (n, n) не создаём."""
    n, d = Q.shape
    scale = 1.0 / np.sqrt(d)
    O = np.zeros((n, d), dtype=np.float32)

    for i0 in range(0, n, Br):                     # внешний цикл: блоки строк Q
        Qi = Q[i0:i0 + Br]
        b = Qi.shape[0]
        m = np.full(b, -np.inf, dtype=np.float32)  # бегущий максимум по строке
        l = np.zeros(b, dtype=np.float32)          # бегущая сумма exp
        acc = np.zeros((b, d), dtype=np.float32)   # бегущий числитель

        for j0 in range(0, n, Bc):                 # внутренний цикл: блоки K, V
            if causal and j0 > i0 + b - 1:
                break                              # блок целиком над диагональю
            Kj = K[j0:j0 + Bc]
            Vj = V[j0:j0 + Bc]

            S = (Qi @ Kj.T) * scale                # (b, Bc), не (n, n)
            if causal:
                rows = np.arange(i0, i0 + b)[:, None]
                cols = np.arange(j0, j0 + Kj.shape[0])[None, :]
                S = np.where(cols > rows, -np.inf, S)

            m_blk = S.max(axis=1)                  # локальный максимум блока
            m_new = np.maximum(m, m_blk)
            corr = np.exp(m - m_new)               # на первом блоке exp(-inf) = 0
            P = np.exp(S - m_new[:, None])         # маскированные: exp(-inf) = 0

            l = l * corr + P.sum(axis=1)
            acc = acc * corr[:, None] + P @ Vj
            m = m_new

        O[i0:i0 + b] = acc / l[:, None]            # одно деление на строку
    return O


if __name__ == "__main__":
    n, d = 64, 32
    Q = rng.normal(size=(n, d)).astype(np.float32)
    K = rng.normal(size=(n, d)).astype(np.float32)
    V = rng.normal(size=(n, d)).astype(np.float32)

    ref = attention_ref(Q, K, V)
    out = flash_attention(Q, K, V, Br=4, Bc=4)
    diff = np.abs(ref - out).max()
    print(f"max|ref - flash| = {diff:.3e}")        # ~3e-07
    assert diff < 1e-5
Проверка «память не материализуется» — не на глаз, а через tracemalloc: пик в наивной версии растёт как n², в блочной — как Br·n.
import tracemalloc

def peak_mb(fn, *a, **kw):
    tracemalloc.start()
    fn(*a, **kw)
    _, peak = tracemalloc.get_traced_memory()
    tracemalloc.stop()
    return peak / 2**20

n, d = 1024, 64
Q = rng.normal(size=(n, d)).astype(np.float32)
K = rng.normal(size=(n, d)).astype(np.float32)
V = rng.normal(size=(n, d)).astype(np.float32)
print(f"naive peak: {peak_mb(attention_ref, Q, K, V):.1f} MiB")     # ~12 MiB
print(f"flash peak: {peak_mb(flash_attention, Q, K, V, 32, 32):.1f} MiB")  # ~0.5 MiB
Почему это важно в реальных числах. Qwen3-подобная модель: 32 слоя, 32 головы, d_head = 128, последовательность 4096, fp16.
| Величина | Наивно | Блочно (Br=Bc=128) |
|---|---|---|
| Матрица скоров на голову | 4096²·2 Б = 32 МиБ | 128·128·2 Б = 32 КиБ |
| Все скоры на слой (32 головы) | 1 ГиБ | — |
| Все скоры на модель | 32 ГиБ | не существует |
| Трафик HBM на голову/слой | 4n²·2 Б ≈ 134 МБ | 2n²d/Br·2 Б ≈ 43 МБ |
| Трафик HBM на всю последовательность | ~137 ГБ | ~44 ГБ |
137 ГБ при 2 ТБ/с — это 68 мс только на перекладывание байтов, тогда как сами матмулы (4n²d = 8.6 ГФЛОП на голову, 8.8 ТФЛОП на модель) при 312 ТФЛОП/с fp16 занимают 28 мс. Наивный attention memory-bound с запасом; блочный (44 ГБ → 22 мс) примерно уравнивает трафик и счёт. Плюс 32 ГиБ промежуточных скоров, которых просто нет в VRAM рядом с весами.
FlashAttention-2
FA-2 — не новый алгоритм, а переупаковка того же цикла под железо. Три изменения из статьи Dao (2023):
Актуальность на 2026. FA-2 здесь — учебная вершина, не практическая: на Blackwell фронтир сдвинулся в FlashAttention-4 (1605 TFLOPS на B200, ~2.7x в vLLM 0.17), поверх которого идёт VC-Attention с заявленными ~2x против FA-4 в BF16 на B200. Устройство FA-4/VC-Attention разбирается в модуле 06 (§6.9); ниже — MLA-кернелы и готовые библиотеки, которые сегодня закрывают продакшн-случаи.
1. Порядок циклов. В FA-1 внешний цикл шёл по блокам K/V, внутренний — по блокам Q. Значит O_i приходилось выгружать в HBM и подгружать обратно на каждой внешней итерации: n/Bc лишних записей и чтений O. FA-2 меняет циклы местами: внешний по Q, внутренний по K/V, блок O живёт в регистрах до конца и пишется один раз. Трафик по O падает с 2nd·n/Bc до 2nd.
2. Параллелизм по строкам. В FA-1 параллелить можно было только по batch × heads — при batch=1 и длинном промпте это единицы блоков на 108 SM A100. FA-2 делает блоки Q независимыми единицами работы: сетка (n/Br) × heads × batch. Для n=4096, Br=128, heads=32 это 32·32 = 1024 блока вместо 32.
3. Меньше non-matmul FLOP-ов. FA-1 делил acc на l на каждой итерации внутреннего цикла; FA-2 копит ненормированный acc и делит один раз в конце. Плюс для causal-случая блоки целиком выше диагонали не считаются вообще: при n/B блоках в строке число посчитанных блоков падает с (n/B)² до (n/B)(n/B+1)/2, то есть ровно вдвое.
Почему non-matmul дороги. На A100 fp16-тензорное ядро даёт 312 ТФЛОП/с, CUDA-ядра fp32 — 19.5 ТФЛОП/с (в 16 раз меньше), а exp идёт на SFU с 16 операциями на SM за такт против 64 fp32-FMA — ещё в 4 раза медленнее. На последовательность из 4096 токенов приходится n²·heads·layers = 1.7·10¹⁰ экспонент; при 2.4·10¹² exp/с на A100 это 7 мс только на exp, и столько же суммарно на max/вычитания/сложения. Отсюда и разрыв в замерах: FA-1 выдаёт ~168 ТФЛОП/с (35% пика), FA-2 — 335 ТФЛОП/с (72% пика) на d_head=128, seq=2048, causal, A100 80 ГБ. Ровно те ~2x, что в абстракте статьи.
Тот же алгоритм с порядком циклов FA-2 и одним делением в конце:
def flash_attention_v2(Q, K, V, Br=64, Bc=64, causal=False):
    """FA-2: внешний цикл по Q, O пишется один раз, деление — в конце."""
    n, d = Q.shape
    scale = 1.0 / np.sqrt(d)
    O = np.empty((n, d), dtype=np.float32)

    for i0 in range(0, n, Br):                     # внешний: блок Q
        Qi = Q[i0:i0 + Br]
        b = Qi.shape[0]
        m = np.full(b, -np.inf, dtype=np.float32)
        l = np.zeros(b, dtype=np.float32)
        acc = np.zeros((b, d), dtype=np.float32)

        for j0 in range(0, n, Bc):                 # внутренний: блоки K/V
            if causal and j0 > i0 + b - 1:
                break                              # половина блоков не считается
            Kj, Vj = K[j0:j0 + Bc], V[j0:j0 + Bc]
            S = (Qi @ Kj.T) * scale
            if causal:
                rows = np.arange(i0, i0 + b)[:, None]
                cols = np.arange(j0, j0 + Kj.shape[0])[None, :]
                S = np.where(cols > rows, -np.inf, S)

            m_new = np.maximum(m, S.max(axis=1))
            # rescale только если максимум реально вырос
            needs = m_new > m
            if needs.any():
                corr = np.where(needs, np.exp(m - m_new), 1.0).astype(np.float32)
                l *= corr
                acc *= corr[:, None]
                m = m_new
            P = np.exp(S - m[:, None])
            l += P.sum(axis=1)
            acc += P @ Vj                      # без деления на l внутри цикла

        O[i0:i0 + b] = acc / l[:, None]        # единственное деление
    return O
На CPU-натуре выигрыша не будет: при Br=Bc=4 матмул 4×32×4 — это 1024 ФЛОП, то есть ~0.1 мкс на 10 ГФЛОП/с, а накладные расходы одного вызова numpy — 1–2 мкс. Время уходит в интерпретатор, а не в арифметику; выигрыш FA-2 проявляется только когда блоки большие и счёт идёт на тензорных ядрах. Убедиться, что версии эквивалентны, всё равно стоит:
n, d = 64, 32
Q, K, V = (rng.normal(size=(n, d)).astype(np.float32) for _ in range(3))
print(np.abs(attention_ref(Q, K, V) - flash_attention_v2(Q, K, V, 16, 16)).max())
print(np.abs(attention_ref(Q, K, V, causal=True)
             - flash_attention_v2(Q, K, V, 16, 16, causal=True)).max())
Сверка даёт расхождение порядка 1e-07 — смотри вывод ниже.
MLA-кернелы: FlashMLA и ThunderMLA
Всё, что выше, написано под стандартный MHA/GQA-расклад K/V. У моделей с MLA (multi-head latent attention — DeepSeek-класс архитектур) кеш устроен иначе: сжатое латентное представление вместо явных K/V на голову, и generic attention-кернелы на нём теряют. Это целый класс моделей, который без специализированных кернелов выпадает из оптимизаций модуля.
Два промышленных варианта:
- FlashMLA (DeepSeek) — оптимизированный MLA-decode кернел;
- ThunderMLA (ThunderKittens / Together AI) — «мегакернел»: собирает больше работы в один запуск ядра и убирает накладные расходы запуска множества мелких кернелов. Даёт +20–35% против FlashMLA; на Kimi K2.5 — до 2x лучший TTFT.
Вывод тот же, что и для всего модуля: выигрыш приходит из байтов и числа запусков ядра, не из арифметики.
Для кастомных attention-паттернов вне этих двух семейств — FlexDecoding.
Готовые fused-блоки: Liger-Kernel
Писать каждый fused-оператор руками (как мы сделали с RMSNorm выше) полезно один раз для понимания, но в проде берут готовые библиотеки. Liger-Kernel v0.8.2 даёт fused RMSNorm, RoPE, SwiGLU и MoE на CuTe-ядрах Hopper/Blackwell — ровно те операторы, которые мы разобрали, в обвязке, проверенной на тысячах деплоев. Triton, на котором исторически писали такие кернелы, остаётся стандартом для собственных кастомных фьюзов (см. модуль 06, §6.9).
Задание 07.1: fused_rms_norm
RMSNorm в Qwen3 стоит перед каждым линейным слоем, то есть вызывается 2·n_layers = 64 раза на токен. Отдельный кернел «прочитать x, посчитать дисперсию, записать обратно, потом отдельно умножить на w» — это лишние проходы по HBM, которые на 7B-модели заметны: T·D·4 Б = 8192·4096·4 = 134 МБ на один промежуточный буфер.
Реализуйте функцию:
def fused_rms_norm(x: np.ndarray, w: np.ndarray, eps: float = 1e-6) -> np.ndarray:
    """
    x: (T, D) float32 — активации, строка = один токен
    w: (D,)  float32 — обучаемый масштаб
    return: (T, D) float32, rms_norm(x) * w
    Ограничение: не создавать временных массивов размера (T, D).
    """
Формула: out[t, d] = x[t, d] / sqrt(mean_d(x[t, :]²) + eps) * w[d]. eps под корнем, не снаружи; среднее по D, не по T.
Что подать на вход и что ожидать:
T=4096, D=512,x ~ N(0,1),w ~ N(0,1)— сверка с эталоном,max|diff| < 1e-5(в fp32 расхождение обычно ~2e-7).xиз нулей — на выходе нули, деления на ноль нет.xс одной большой компонентой (x[0,0] = 1e3) — проверка, что не переполняется при возведении в квадрат в fp32 (1e6— нормально).w = ones— выход должен иметь единичный RMS по каждой строке:sqrt(mean(out[t]²)) ≈ 1с точностью 1e-4.
Эталон и «нефьюзнутая» версия для сравнения памяти:
import numpy as np

def rms_norm_ref(x, w, eps=1e-6):
    ms = (x * x).mean(axis=-1, keepdims=True)      # временный (T, D): x*x
    return x / np.sqrt(ms + eps) * w               # ещё два временных (T, D)

def fused_rms_norm(x, w, eps=1e-6):
    x = np.asarray(x, dtype=np.float32)
    T, D = x.shape
    ss = np.einsum("td,td->t", x, x)               # (T,), без материализации x*x
    rstd = (1.0 / np.sqrt(ss / D + eps)).astype(np.float32)   # (T,)
    out = np.empty_like(x)
    np.multiply(x, rstd[:, None], out=out)         # пишем сразу в out
    out *= w                                       # масштаб in-place
    return out
Пик памяти: эталон — 4 буфера T·D (536 МБ при T=8192, D=4096), fused — один выход плюс два вектора (T,) по 32 КБ. Трафик HBM: 5 проходов по 134 МБ против 3 (чтение x дважды + запись out).
Почему второй проход по x дёшев: строка D=4096 во float32 — это 16 КБ, она целиком лежит в L1 (48 КБ на ядро), так что второй проход не идёт в HBM. В C++ это выглядит буквально так:
// rms_norm.cpp — фьюз без промежуточных буферов
#include <cmath>
void rms_norm(const float* __restrict x, const float* __restrict w,
              float* __restrict out, int T, int D, float eps) {
  for (int t = 0; t < T; ++t) {
    const float* row = x + (size_t)t * D;
    float ss = 0.f;
    for (int d = 0; d < D; ++d) ss += row[d] * row[d];          // проход 1: только чтение
    const float rstd = 1.f / sqrtf(ss / (float)D + eps);
    float* orow = out + (size_t)t * D;
    for (int d = 0; d < D; ++d) orow[d] = row[d] * rstd * w[d]; // проход 2: строка в L1
  }
}
В tiny-llm этот же кернел дополнительно совмещён с residual-add: rms_norm(x + residual) — ещё один сэкономленный проход по 134 МБ.
Задание 07.2: flash attention naive
Соберите блочный attention как отдельную функцию с явным контрактом:
def flash_attention(Q: np.ndarray, K: np.ndarray, V: np.ndarray,
                    Br: int = 64, Bc: int = 64,
                    causal: bool = False) -> np.ndarray:
    """
    Q, K, V: (n, d) float32. n может не делиться на Br/Bc — обработать хвост.
    return: (n, d) float32 = softmax(QK^T / sqrt(d)) V
    Запрещено: создавать массивы размера (n, n) или (n, n) на голову.
    """
Требования к проверке:
- Эквивалентность.
n=256, d=64,Br=Bc=32:max|flash - ref| < 1e-5приcausal=Falseиcausal=True. ОтдельноBr=7, Bc=13(некратныеn) — хвосты не должны ломать результат. - Память.
n=1024, d=64: пикtracemallocу блочной версии минимум в 10 раз ниже, чем у наивной (ожидаемо ~0.5 МиБ против ~12 МиБ). - Causal-экономия. Счётчик итераций внутреннего цикла при
causal=Trueдолжен быть примерно вдвое меньше, чем приcausal=False(дляn=256, Br=Bc=32: 36 блоков против 64). - Численная устойчивость. Подайте
Q, Kс масштабом 100 (Q *= 100): наивная версия без вычитания максимума дастnan, блочная — конечные числа, совпадающие с эталоном.
Ловушки, на которых задание обычно заваливают:
m = -infна первой итерации:exp(m - m_new) = exp(-inf) = 0, это корректно и обнуляет пустойacc. Но если строка целиком замаскирована (такого не должно быть приcausal, где диагональ всегда открыта), получитсяnan—-inf - (-inf).- Маска накладывается до
max, иначеmуезжает в скоры, которые не должны участвовать. - Деление на
l— один раз после внутреннего цикла, а не внутри: иначеaccнакапливается уже нормированным и rescale ломается. lиaccrescale-ятся одним и тем же коэффициентомexp(m_old − m_new), аPсчитается уже относительноm_new.
Как проверить
Один файл на задание, запуск без аргументов:
python flash_attn.py
python rms_norm.py
Ожидаемый вывод flash_attn.py (порядок величин; точные цифры зависят от версии numpy и машины):
max|ref - flash|   = 3.7e-07
max|ref - flash_v2| = 3.9e-07
causal diff        = 4.1e-07
naive peak: 12.6 MiB
flash peak:  0.5 MiB
blocks causal=False: 64
blocks causal=True : 36
rms_norm.py:
max|ref - fused|    = 2.1e-07
rms(out[0])         = 1.00003
zeros -> zeros      : ok
peak unfused: 536.2 MiB
peak fused  : 134.4 MiB
Чеклист:
-
flash_attentionне создаёт ни одного массива формы(n, n)— провереноtracemalloc, пик ниже в ≥10 раз. - Результат совпадает с
softmax(QK^T/√d)Vс точностью 1e-5 приcausal=True/Falseи при некратныхBr,Bc. - При
causal=Trueчисло посчитанных блоков ≈ вдвое меньше, чем приcausal=False. -
Q *= 100не даётnanи не расходится с эталоном. -
fused_rms_normне создаёт временных(T, D); пик памяти ≈ размер выхода. -
epsпод корнем, среднее поD; приw = onesRMS каждой строки на выходе ≈ 1. - Ни одна функция не меняет вход
Сводка
- HBM-трафик, а не FLOPs, — узкое место attention: материализация
S = QK^T— этоO(n²)памяти и ~134 МБ лишнего трафика на голову приn = 4k; fusion убирает саму материализацию. - Fused RMSNorm и SwiGLU — те же вычисления за один проход по активациям: экономия 2–3 чтений-записей
(T, D)на слой на каждый оператор. - Online softmax — бегущий максимум
m, бегущая суммаl, rescale аккумулятораexp(m_old − m_new); корректность не зависит от порядка блоков. - FlashAttention снижает IO-сложность с
O(n² + n²d)доO(n²d²M⁻¹); наивная numpy-версия с блоками 4×4 сходится с эталоном до ~1e-7 и держит пик памяти в ~25 раз ниже. - FlashAttention-2 переносит внешнюю петлю на строки Q: меньше non-matmul FLOPs и rescale'ов, ~2× скорость против FA-1 на A100. На 2026 практическая вершина — FA-4 и VC-Attention (модуль 06) и MLA-кернелы: ThunderMLA даёт +20–35% против FlashMLA, до 2x TTFT на Kimi K2.5; готовые fused-блоки — Liger-Kernel v0.8.2.
- Causal-маска в блочной версии — это бесплатно вдвое меньше блоков, если скипать блоки строго ниже диагонали.
Навигация по курсу: Хаб курса · Предыдущий: Кернелы: SIMD-матмул и tiled prefill · Следующий: Continuous batching и чанкерная префилла