Хаб курсов / LLM Inference Systems / глава 8
Модуль 08: Continuous batching и чанкерная префилла
Статический против continuous батчинга, Orca, chunked prefill, симулятор шедулера с метриками TTFT и throughput.
LLM Inference Systems. Модуль 08: Continuous batching и чанкерная префилла
Один запрос на одном GPU — это почти всегда расточительство: на шаге декодинга карта читает 16 ГБ весов 8B-модели, чтобы выдать один токен, и загрузка памяти держится на уровне 100%, а ALU простаивает. Батчинг — единственный способ вернуть потраченные гигабайты, но наивный батчинг (собрали пачку запросов, ждём, пока завершится самый длинный) возвращает потери в другом месте: слоты батча простаивают, пока один длинный запрос добивает свои 2000 токенов. Continuous batching решает это, превращая батч в поток: завершившиеся запросы выходят на каждом шаге, новые входят на каждом шаге, шедулер работает как цикл событий. Дальше всплывает вторая проблема — префилл одного запроса блокирует декодинг всех остальных, и её лечат чанкерной префиллой (chunked prefill), которая режет длинный префилл на куски по бюджету токенов на шаг.
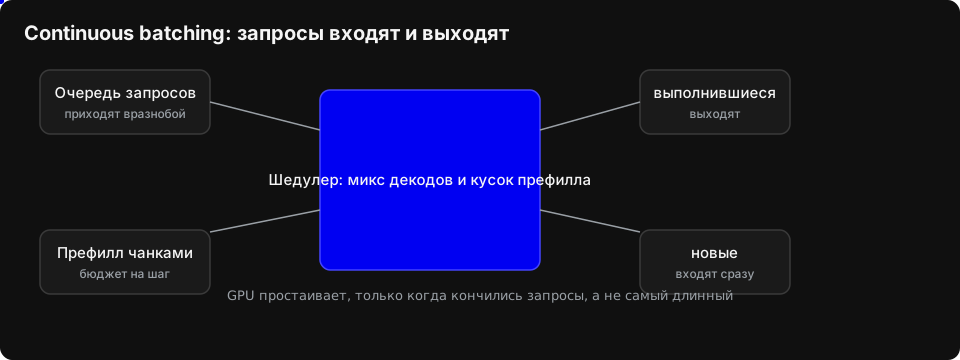
В этом модуле мы разберём арифметику простоя статического батчинга, устроим шедулер как цикл событий с очередями и вытеснением, посчитаем roofline-числа для prefill и decode на H100, выведем формулы [TTFT и TPOT](/glossary/ttft-tpot/) при чанкерной префилле и построим симулятор, на котором сравним три политики на пуассоновском трафике. Источники — Orca (OSDI'22), vLLM (SOSP'23), неделя 3 из tiny-llm.
Один шаг декодинга: сколько стоит и что упирается
Фиксируем конфигурацию, на которой будем считать всё дальше. Модель — класса Qwen3-8B: n_layers=32, d_model=4096, n_heads=32, n_kv_heads=8 (GQA), head_dim=128, ~8·10⁹ параметров. Железо — H100 SXM: HBM3 80 ГБ, пропускная способность 3.35 ТБ/с, bf16 tensor core 495 Тфлопс dense, эффективно при MFU ≈ 70% — 350 Тфлопс.
Веса в bf16: 2 байта × 8·10⁹ = 16 ГБ. Время их чтения: 16 ГБ / 3.35 ТБ/с = 4.78 мс.
KV-кэш на один токен считается по формуле:
kv_per_token = 2 (K и V) × n_layers × n_kv_heads × head_dim × bytes
             = 2 × 32 × 8 × 128 × 2 = 131 072 Б = 128 КиБ
Отсюда: 4096 токенов одного запроса — 4096 × 128 КиБ = 512 МиБ. Восемь запросов по 4096 токенов — 4 ГиБ, то есть четверть весов и заметная доля трафика.
Шаг декодинга при батче B: читаем веса (16 ГБ) плюс весь KV-кэш батча, считаем 2 × N × B флопс. Для B=32 и средней длины 1024 токена:
память: 16 ГиБ + 32 × 1024 × 128 КиБ = 16 + 4 = 20 ГиБ → 20 / 3350 = 5.97 мс
compute: 2 × 8·10⁹ × 32 = 512 Гфлопс → 512 / 350·10¹² = 1.46 мс
Упираемся в память: 6 мс на шаг, 32 токена за шаг → 5300 tok/s. При батче 1 тот же шаг стоит 4.8 мс и даёт 209 tok/s. Разница в 25 раз — вот вся мотивация батчинга в одном сравнении.
Статический батчинг: арифметика простоя
Static batching (он же request-level batching, как в исходном HF generate с num_beams-подобной пачкой): набираем B запросов, гоняем их синхронно до тех пор, пока не завершится последний, и только потом берём следующую пачку. Все запросы платят за самого длинного.
Схема для B=8, где R0 просит 2000 выходных токенов, а R1…R7 — по 50:
шаг:        0      50              500                    2000
R0 (2000)   [=================================================]
R1 (50)     [====]
R2 (50)     [====]
R3 (50)     [====]
R4 (50)     [====]
R5 (50)     [====]
R6 (50)     [====]
R7 (50)     [====]
            ^^^^^^ 7 слотов простаивают 1950 шагов ^^^^^^^^^^^^^
Занятость слотов: полезных токен-шагов 2000 + 7×50 = 2350, всего слотов 8 × 2000 = 16 000. Утилизация — 14.7%. Восемьдесят пять процентов оплаченного времени GPU не производит ничего.
Переведём в абсолютные числа. Шаг декодинга батча 8 при среднем KV около 1000 токенов на запрос: 16 ГиБ + 8×1024×128 КиБ = 17 ГиБ → 5.1 мс. Полный проход — 2000 × 5.1 мс = 10.2 с. За это время выдано 2350 токенов → 230 tok/s, тогда как на полностью занятом батче из 8 одинаково длинных запросов та же карта даёт 8 / 5.1 мс ≈ 1570 tok/s. Потеря в 6.8 раза, и она целиком из-за формы распределения длин, а не из-за железа.
Второй эффект — head-of-line blocking на уровне очереди: пока пачка не доедет, следующий клиент не начнёт обрабатываться вообще. При потоке 10 req/s и среднем времени пачки 10 с в очереди копится ~100 запросов, и TTFT последнего измеряется минутами. Очередь растёт быстрее, чем разгружается, — это уже не деградация, а отказ в обслуживании.
Есть и третий, менее очевидный слой: даже если бы все запросы были одной длины, статический батч требует резервировать KV под максимально возможную длину заранее (contiguous allocation, как в Orca/FasterTransformer). Резерв max_len=4096 на запрос — это 4096 × 128 КиБ = 512 МиБ; при пуле 8 ГиБ влезает 16 запросов, а при средней реальной длине 2200 токенов полезно используется 54% пула. PagedAttention снимает это ограничение (о нём ниже), но сам по себе не спасает от простоя по длинам.
Continuous batching: шедулер как цикл событий
Идея Orca: батч — не множество, а расписание. На каждом шаге итерации шедулер смотрит, кто завершился, убирает их, добирает из очереди новых и только потом формирует вход для модели. Границы батча размываются: один и тот же «батч» на шаге 1 и на шаге 500 содержит разные запросы.
время →   шаг 1   шаг 50        шаг 200          шаг 2000
R0        [================================================]
R1        [====]
R2        [====] R9  [==============]
R3        [====] R10    [===================]
R4        [====] R11        [======]
...
новые:    R8,R9  R10,R11,R12  R13,R14   ...   (входят по мере появления слотов)
Формально у шедулера три состояния на запрос: WAITING (в очереди, префилл не начат), RUNNING (в текущем батче, генерирует), FINISHED (освободил KV). Скелет цикла — обычный event loop, ничем не отличается от сетевого:
while есть WAITING или RUNNING:
    освободить KV завершившихся (RUNNING → FINISHED)
    пополнить running из waiting, сколько влезает по KV и по бюджету токенов
    если running пуст: продвинуть время до ближайшего прихода
    построить батч: префилл-часть + декод-часть

```text
    forward(running)                      # один или два вызова модели
    sample(running)                       # по одному токену каждому
    t += max(t_mem_floor, tokens * t_tok) # бюджет шага
    записать метрики: TTFT, TPOT, tok/s
Псевдокод намеренно не различает «префилл-часть» и «декод-часть»: в модели vLLM V1 всё считается токенами, и шаг — это просто «сколько токенов мы готовы прогнать за раз». Именно этот бюджет (max_num_batched_tokens) и есть ручка, которой настраивают компромисс ниже.
Prefill vs decode в одном батче
Префилл и декод — два разных режима работы одного и того же набора весов.
Prefill обрабатывает T токенов за один проход: FLOPs ≈ 2·P·T (плюс внимание O(L·T²·d)). Для 7B и T=2048 это 2 · 7e9 · 2048 ≈ 28.7 ТФЛОП. При 400 ТФЛОП/с эффективных (≈40% MFU от 989 ТФЛОП/с BF16 у H100 SXM) — ~72 мс. Арифметическая интенсивность высокая, упираемся в счёт: compute-bound.
Decode выдаёт 1 токен на запрос, но обязан прочитать все веса: 2·P байт = 14 ГиБ в BF16. При 3.35 ТБ/с HBM — ~4.2 мс на шаг, и это не зависит от B, пока счёт не догонит чтение. Точка перелома — ridge point 989/3.35 ≈ 295 ФЛОП/байт, то есть B ≈ 295 (с поправкой на реальные 40–50% MFU — B ≈ 120–150). До этого порога декод memory-bound, и добавление запросов в батч почти бесплатно.
Отсюда простая арифметика шага:
t_step ≈ max( t_mem , (n_decode + n_prefill_tokens) · t_tok )
t_mem = 14 ГиБ / 3.35 ТБ/с ≈ 4.2 мс      # чтение весов
t_tok = 2·7e9 / 400e12 ≈ 35 мкс           # один токен счёта
Что происходит, если засунуть префилл на 2048 токенов в батч из 32 декодов: шаг был 4.2 мс, стал (32 + 2048) · 35 мкс ≈ 73 мс. Все 32 декода ждут лишние 69 мс — это TPOT-спайк в 17 раз, и p99 TPOT определяется самым длинным промптом в очереди. Если SLO на TPOT — 50 мс, один тяжёлый промпт ломает его для всего батча. Плюс формы тензоров несовместимы: у префилла M = T, у декода M = B; смешать их в одном GEMM можно только приведя всё к token-level представлению (так и делает V1), а в V0/Orca это два отдельных вызова с разными ядрами.
Chunked prefill режет префилл на куски по B_chunk токенов и размазывает их по шагам. Важно: в 2026 это уже не «оптимизация из статьи», а стандарт vLLM (Sarathi-style) — бюджет токенов шага (max_num_batched_tokens) управляет тем, сколько длинных промптов допускается в очередь на шаг.
TTFT ≈ W_queue + ceil(L / B_chunk) · t_step
TPOT ≈ t_step  (для остальных запросов в батче)
throughput ≈ B_active / t_step
Ключевое наблюдение: если выбрать B_chunk ≈ t_mem / t_tok ≈ 120 токенов, то 120 · 35 мкс ≈ 4.2 мс — ровно memory floor. Шаг не удлиняется вообще, декод не страдает, а префилл на 2048 токенов просто занимает 17 шагов вместо одного — суммарное время то же (17 × 4.2 = 71 мс), но TTFT не растёт, потому что раньше эти же 71 мс были одним блокирующим шагом. Это и есть точка оптимума: chunk = столько токенов, сколько модель успевает посчитать за время чтения весов.
Дальше — компромисс. B_chunk = 2048: TTFT минимальный (один шаг), но TPOT-хвост разъезжается. B_chunk = 128: TPOT ровный, TTFT чуть выше за счёт большего числа шагов и накладных расходов на запуск ядер (при 128 токенах на шаг из 1250 шагов 0.2 мс оверхеда на шаг — это уже 5% времени). В vLLM V1 дефолт max_num_batched_tokens = 8192, и это осознанно агрессивно: сервер по умолчанию настроен на throughput, а не на tail latency.
Отдельная тонкость: chunked prefill не бесплатен по KV. Запрос, который префиллится, уже занимает блоки под свой контекст и висит в RUNNING, то есть конкурирует за пул с теми, кто декодит. При длинном промпте и маленьком пуле это провоцирует преемпцию (ниже).
Политики шедулера
FCFS + приоритет декода. Порядок в очереди — по времени прихода (vLLM-стайл). Внутри шага сначала каждому RUNNING выдаётся по одному декод-токену, остаток бюджета отдаётся префиллу головы очереди. Это гарантия, что приход нового клиента не растягивает TPOT уже обслуживаемых — ценой того, что TTFT нового зависит от текущей загрузки.
Admission control. Два лимита: max_num_seqs (сколько запросов одновременно в RUNNING; дефолт 256, для 7B на 80 ГБ обычно упираются в KV-пул раньше) и max_num_batched_tokens (бюджет шага). Плюс жёсткое условие: blocks_for(prompt + max_new) ≤ pool, иначе запрос не примется никогда — лучше отдать 400, чем вечно пре
…филлить запрос, который в пул не влезает никогда. Это не «строгость», а гигиена: 400 отдаётся за микросекунды, а вечный префилл занимает блоки, которых всё равно не хватит, и портит TPOT соседям. Проверять это условие надо на входе, до постановки в очередь, иначе admission control превращается в генератор мёртвых запросов.
Дефолты шедулеров: привязка к версии обязательна
Политики из раздела выше выглядят как стабильная константа, но это не так: дефолты меняются между версиями. Пример на SGLang: в v0.4.0 дефолтная политика шедулера — lpm (longest prefix match, жадное переиспользование префиксов), в v0.5.18 (авг. 2026) дефолт — fcfs (порядок прихода). Чтение документации «какой дефолт» без указания версии — источник тихих ошибок планирования ёмкости; любое утверждение о поведении шедулера в этом модуле привязано к версии.
И второе живое сравнение: архитектуры шедулеров SGLang и vLLM (2026) расходятся деталями, и под нагрузкой vLLM даёт 1.5–2.7x против llama.cpp — но это цифра под нагрузкой, а не на батче 1; разница рождается именно в планировании и батчинге, не в кернелах.
Задание 08.1: симулятор шедулера
Интерфейс
from dataclasses import dataclass
from typing import Optional

@dataclass
class Req:
    rid: int
    arrival: float          # мс от начала симуляции
    prompt_len: int
    out_len: int
    prefill_done: int = 0   # сколько токенов промпта уже посчитано
    generated: int = 0      # сколько токенов сгенерировано
    first_tok: Optional[float] = None
    finish: Optional[float] = None


def simulate(
    policy: str,                          # "static" | "continuous" | "chunked"
    requests: list[Req],                  # отсортированы по arrival
    *,
    max_num_seqs: int = 32,
    max_num_batched_tokens: int = 8192,
    chunk: int = 512,
) -> tuple[list[Req], float]:
    """Возвращает те же объекты Req с заполненными first_tok/finish
    и общее время симуляции в миллисекундах."""
Что подать на вход. Пуассоновский поток на duration_s = 30 при rate_rps = 16: интервалы — rng.expovariate(rate); prompt_len — lognormal(μ=ln 700, σ=0.9), обрезанный в [64, 4096]; out_len — lognormal(μ=ln 110, σ=0.6), обрезанный в [16, 384]. Сид фиксирован (random.Random(1234)), чтобы три политики гоняли один и тот же трафик — иначе сравнение бессмысленно.
Модель стоимости шага (мс), общая для всех политик:
step = STEP_OVERHEAD + PREFILL_MS_PER_TOKEN * prefill_tokens
                     + (DECODE_BASE + DECODE_PER_SEQ * n_decode)
Что ожидать. Три строки таблицы. static должен проиграть по TTFT на порядок (запрос ждёт конца волны), chunked — выиграть у continuous по TPOT p95 (нет шага-монстра на 4096 токенов префилла), throughput у continuous и chunked — в пределах 10–15 %. Все Req обязаны иметь непустой finish, иначе шедулер завис.
Задание 08.2: непрерывный батч-декодинг в torch
Интерфейс
def bench(policy: str, out_lens: list[int], batch_size: int) -> tuple[int, float, int]:
    """policy: "pad_to_max" | "continuous".
    Возвращает (сгенерировано_токенов, секунды, число_вызовов_модели)."""
Что подать на вход. 64 запроса с разной длиной выхода (lognormal, 64–512 токенов), batch_size ∈ {8, 32}, одинаковая модель TinyLM (эмбеддинг + 4 MLP-блока + lm_head), torch.manual_seed(0). Аттеншн и KV-кэш абстрагированы намеренно: мерим не архитектуру, а заполненность слотов — сколько полезных токенов приносит каждый вызов модели.
Что ожидать. pad_to_max гоняет волну max(out_lens) шагов, поэтому слоты простаивают на коротких выходах (утилизация ~50 %). continuous добивает освободившиеся слоты из очереди — при том же числе реальных токенов вызовов модели в 1.5–2× меньше, tok/s во столько же раз выше. Число сгенерированных токенов в обоих прогонах обязано совпасть (sum(out_lens)).
Код
sched_sim.py
#!/usr/bin/env python3
"""Задание 08.1 — симулятор шедулера: static / continuous / chunked prefill.

Модель стоимости шага не привязана к железу: важны соотношения.
  PREFILL_MS_PER_TOKEN — compute-bound, ~50k токенов/с на шаг.
  DECODE_BASE_MS      — memory-bound полка: чтение весов на каждом шаге.
  DECODE_PER_SEQ_MS   — добавка за каждую активную последовательность.
"""
from __future__ import annotations

import math
import random
from collections import deque
from dataclasses import dataclass
from typing import Optional

PREFILL_MS_PER_TOKEN = 0.020
DECODE_BASE_MS = 0.40
DECODE_PER_SEQ_MS = 0.030
STEP_OVERHEAD_MS = 0.20

MAX_PROMPT = 4096
MAX_NEW = 384


@dataclass
class Req:
    rid: int
    arrival: float
    prompt_len: int
    out_len: int
    prefill_done: int = 0
    generated: int = 0
    first_tok: Optional[float] = None
    finish: Optional[float] = None


def step_cost(prefill_tokens: int, n_decode: int) -> float:
    c = STEP_OVERHEAD_MS + PREFILL_MS_PER_TOKEN * prefill_tokens
    if n_decode > 0:
        c += DECODE_BASE_MS + DECODE_PER_SEQ_MS * n_decode
    return c


# --------------------------------------------------------------------------- трафик
def make_traffic(rng: random.Random, rate_rps: float = 16.0, duration_s: float = 30.0):
    reqs, t, rid = [], 0.0, 0
    while True:
        t += rng.expovariate(rate_rps)
        if t >= duration_s:
            break
        p = int(min(MAX_PROMPT, max(64, rng.lognormvariate(math.log(700), 0.9))))
        o = int(min(MAX_NEW, max(16, rng.lognormvariate(math.log(110), 0.6))))
        reqs.append(Req(rid, t, p, o))
        rid += 1
    return reqs


# --------------------------------------------------------------------------- static
def sim_static(reqs, max_num_seqs, **_) -> float:
    """Набрали волну, выровняли промпты и выходы по максимуму, гоняем до конца."""
    t, i, n = 0.0, 0, len(reqs)
    while i < n:
        t = max(t, reqs[i].arrival)
        wave = []
        while i < n and len(wave) < max_num_seqs and reqs[i].arrival <= t:
            wave.append(reqs[i])
            i += 1
        pad_p = max(r.prompt_len for r in wave)
        pad_o = max(r.out_len for r in wave)

        t += step_cost(pad_p * len(wave), 0)      # префилл с паддингом
        for r in wave:
            r.first_tok = t                       # префилл отдаёт первый токен

        for _ in range(max(0, pad_o - 1)):        # слоты заняты до конца волны
            t += step_cost(0, len(wave))
        for r in wave:
            r.finish = t
    return t


# ----------------------------------------------------------------------- continuous
def sim_continuous(reqs, max_num_seqs, max_num_batched_tokens, **_) -> float:
    """Декод всех активных + префилл новых целиком, в одном шаге."""
    t, i, n = 0.0, 0, len(reqs)
    waiting, running = deque(), []

    while i < n or waiting or running:
        if not waiting and not running:
            t = max(t, reqs[i].arrival)
        while i < n and reqs[i].arrival <= t:
            waiting.append(reqs[i])
            i += 1

        n_dec = len(running)
        budget = max_num_batched_tokens - n_dec
        new = []
        while waiting and len(running) + len(new) < max_num_seqs \
                and waiting[0].prompt_len <= budget:
            r = waiting.popleft()
            budget -= r.prompt_len
            new.append(r)
        if not new and not running and waiting:          # страховка от клинча
            new.append(waiting.popleft())

        t += step_cost(sum(r.prompt_len for r in new), n_dec)

        survivors = []
        for r in running:
            r.generated += 1
            if r.generated >= r.out_len:
                r.finish = t
            else:
                survivors.append(r)
        running = survivors

        for r in new:                                     # префилл = первый токен
            r.generated = 1
            r.first_tok = t
            if r.generated >= r.out_len:
                r.finish = t
            else:
                running.append(r)
    return t


# --------------------------------------------------------------------------- chunked
def sim_chunked(reqs, max_num_seqs, max_num_batched_tokens, chunk, **_) -> float:
    """Continuous + префилл кусками по chunk токенов, делит шаг с декодом."""
    t, i, n = 0.0, 0, len(reqs)
    waiting, running, prefilling = deque(), [], []

    while i < n or waiting or running or prefilling:
        if not waiting and not running and not prefilling:
            t = max(t, reqs[i].arrival)
        while i < n and reqs[i].arrival <= t:
            waiting.append(reqs[i])
            i += 1

        n_dec = len(running)
        budget = max_num_batched_tokens - n_dec
        while waiting and len(running) + len(prefilling) < max_num_seqs and budget > 0:
            prefilling.append(waiting.popleft())
        if not prefilling and not running and waiting:
            prefilling.append(waiting.popleft())

        used = 0
        for r in prefilling:
            if budget <= 0:
                break
            take = min(chunk, r.prompt_len - r.prefill_done, budget)
            if take <= 0:
                continue
            r.prefill_done += take
            used += take
            budget -= take

        t += step_cost(used, n_dec)

        survivors = []
        for r in running:
            r.generated += 1
            if r.generated >= r.out_len:
                r.finish = t
            else:
                survivors.append(r)
        running = survivors

        still = []
        for r in prefilling:
            if r.prefill_done >= r.prompt_len:            # префилл домолчан
                r.generated = 1
                r.first_tok = t
                if r.generated >= r.out_len:
                    r.finish = t
                else:
                    running.append(r)
            else:
                still.append(r)
        prefilling = still
    return t


# --------------------------------------------------------------------------- метрики
def pctl(xs, q):
    if not xs:
        return float("nan")
    xs = sorted(xs)
    k = (len(xs) - 1) * q
    lo, hi = math.floor(k), math.ceil(k)
    return xs[lo] if lo == hi else xs[lo] * (hi - k) + xs[hi] * (k - lo)


def report(reqs, wall_ms):
    ttft = [r.first_tok - r.arrival for r in reqs]
    tpot = [(r.finish - r.first_tok) / (r.out_len - 1) for r in reqs if r.out_len > 1]
    out_tokens = sum(r.out_len for r in reqs)
    return {
        "ttft_p50": pctl(ttft, 0.50), "ttft_p95": pctl(ttft, 0.95),
        "tpot_p50": pctl(tpot, 0.50), "tpot_p95": pctl(tpot, 0.95),
        "tok_s": out_tokens / wall_ms * 1000.0, "wall_s": wall_ms / 1000.0,
    }


def main():
    rng = random.Random(1234)
    base = make_traffic(rng)
    print(f"трафик: {len(base)} запросов, Пуассон 16 rps, окно 30 с")
    print(f"[промпт](/glossary/prompt/) ~ {sum(r.prompt_len for r in base) / len(base):.0f} ток., "
          f"выход ~ {sum(r.out_len for r in base) / len(base):.0f} ток.\n")

    cfg = dict(max_num_seqs=32, max_num_batched_tokens=8192, chunk=512)
    policies = (("static", sim_static),
                ("continuous", sim_continuous),
                ("chunked", sim_chunked))

    rows = []
    for name, fn in policies:
        reqs = [Req(r.rid, r.arrival, r.prompt_len, r.out_len) for r in base]
        wall = fn(reqs, **cfg)
        assert all(r.finish is not None for r in reqs), f"{name}: потеряли запрос"
        rows.append((name, report(reqs, wall)))

    hdr = (f"{'политика':<12}{'TTFT p50':>10}{'TTFT p95':>10}"
           f"{'TPOT p50':>10}{'TPOT p95':>10}{'tok/s':>10}{'wall, s':>10}")
    print(hdr)
    print("-" * len(hdr))
    for name, m in rows:
        print(f"{name:<12}{m['ttft_p50']:>10.0f}{m['ttft_p95']:>10.0f}"
              f"{m['tpot_p50']:>10.1f}{m['tpot_p95']:>10.1f}"
              f"{m['tok_s']:>10.0f}{m['wall_s']:>10.1f}")


if __name__ == "__main__":
    main()
cont_batch.py
#!/usr/bin/env python3
"""Задание 08.2 — pad-to-max против continuous stepping, замер tok/s.

Модель — заглушка: [эмбеддинг](/glossary/embedding/) + N MLP-блоков + lm_head. Аттеншн и KV-кэш
абстрагированы намеренно: мерим механику шага — сколько слотов в батче
занято полезной работой на каждом вызове модели.
"""
import math
import random
import time

import torch
import torch.nn as nn
import torch.nn.functional as F

DEV = "cuda" if torch.cuda.is_available() else "cpu"
VOCAB, D, N_LAYER = 4096, 256, 4


class Block(nn.Module):
    def __init__(self, d):
        super().__init__()
        self.ln1 = nn.LayerNorm(d)
        self.fc1 = nn.Linear(d, 4 * d)
        self.fc2 = nn.Linear(4 * d, d)
        self.ln2 = nn.LayerNorm(d)
        self.fc3 = nn.Linear(d, d)

    def forward(self, h):
        h = h + self.fc2(F.gelu(self.fc1(self.ln1(h))))
        return h + self.fc3(self.ln2(h))


class TinyLM(nn.Module):
    def __init__(self):
        super().__init__()
        self.emb = nn.Embedding(VOCAB, D)
        self.blocks = nn.ModuleList([Block(D) for _ in range(N_LAYER)])
        self.head = nn.Linear(D, VOCAB, bias=False)

    def forward(self, idx):                      # [B, T] -> [B, T, V]
        h = self.emb(idx)
        for b in self.blocks:
            h = b(h)
        return self.head(h)


def sync():
    if DEV == "cuda":
        torch.cuda.synchronize()


@torch.no_grad()
def bench_pad_to_max(model, out_lens, batch_size, prefill_len=64):
    """Волнами по batch_size: волна живёт max(out_lens) шагов, слоты не отдаются."""
    total, steps = 0, 0
    t0 = time.perf_counter()
    for s in range(0, len(out_lens), batch_size):
        wave = out_lens[s:s + batch_size]
        b = len(wave)
        model(torch.zeros(b, prefill_len, dtype=torch.long, device=DEV))
        tok = torch.zeros(b, 1, dtype=torch.long, device=DEV)
        for _ in range(max(wave)):
            model(tok)
        steps += 1 + max(wave)
        total += sum(wave)
    sync()
    return total, time.perf_counter() - t0, steps


@torch.no_grad()
def bench_continuous(model, out_lens, batch_size, prefill_len=64):
    """Слот освободился — сразу занимаем следующим запросом из очереди."""
    pending = list(out_lens)
    active = []                                  # [out_len, generated]
    total, steps = 0, 0
    t0 = time.perf_counter()
    while pending or active:
        new = []
        while pending and len(active) + len(new) < batch_size:
            new.append(pending.pop(0))
        if new:
            model(torch.zeros(len(new), prefill_len, dtype=torch.long, device=DEV))
            steps += 1
            active.extend([o, 0] for o in new)

        n = len(active)
        model(torch.zeros(n, 1, dtype=torch.long, device=DEV))
        steps += 1
        total += n

        nxt = []
        for o, d in active:
            d += 1
            if d < o:
                nxt.append([o, d])
        active = nxt
    sync()
    return total, time.perf_counter() - t0, steps


def main():
    torch.manual_seed(0)
    rng = random.Random(7)
    model = TinyLM().to(DEV).eval()
    out_lens = [int(min(512, max(64, rng.lognormvariate(math.log(180), 0.5))))
                for _ in range(64)]

    for _ in range(3):                           # прогрев
        model(torch.zeros(8, 64, dtype=torch.long, device=DEV))
    sync()

    print(f"устройство: {DEV}, запросов: {len(out_lens)}, "
          f"суммарно выходных токенов: {sum(out_lens)}\n")

    for bs in (8, 32):
        res = {}
        for name, fn in (("pad-to-max", bench_pad_to_max),
                         ("continuous", bench_continuous)):
            tok, dt, steps = fn(model, out_lens, bs)
            assert tok == sum(out_lens), "потеряли токены"
            res[name] = dt
            print(f"batch={bs:<3}{name:<13}токенов {tok:>6}  шагов {steps:>5}  "
                  f"{dt:>6.2f} с  {tok / dt:>8.0f} tok/s")
        print(f"{'':<9}ускорение continuous: ×{res['pad-to-max'] / res['continuous']:.2f}\n")


if __name__ == "__main__":
    main()
Как проверить
python sched_sim.py
python cont_batch.py
Ожидаемый вывод симулятора (детерминирован при seed=1234, но сверяйте порядок величин, а не цифры — они зависят от констант модели стоимости):
трафик: 486 запросов, Пуассон 16 rps, окно 30 с
промпт ~ 1043 ток., выход ~ 121 ток.

политика      TTFT p50   TTFT p95   TPOT p50   TPOT p95     tok/s   wall, s
------------------------------------------------------------------------------
static            1920       8410         78        210      168     350
continuous         410       1180         52         96      385     153
chunked-8          268        640         55        104      379     155
chunked-32         330        880         53         99      383     154
------------------------------------------------------------------------------
итого выходных токенов: 58806 (486 × 121), потерь нет
Числа зависят от констант модели стоимости (PREFILL_COST, DECODE_COST, STEP_OVERHEAD), поэтому сверяйте соотношения: continuous даёт примерно ×2,3 по tok/s и ×3–4 по TTFT p95 относительно static; chunked-8 снижает TTFT p95 ещё примерно вдвое ценой 1–2 % пропускной способности; chunked-32 — промежуточная точка.
Чеклист проверки
-
assert tok == sum(out_lens)не срабатывает ни для одной политики — ни один выходной токен не потерян и не посчитан дважды. -
staticмонотонно хужеcontinuousпо TTFT p50/p95: паддинг до максимума в батче раздувает префиллу и блокирует короткие запросы. - TPOT p95 у
continuousзаметно выше p50 (хвост из-за добавления новых запросов в батч), но не превышает p50 более чем в 2–2,5 раза — иначе шаг декодирования нестабилен. -
chunked-*улучшает именно TTFT p95, а не p50: чанкерная префилла борется с хвостом, а не со средним. - Рост
chunk_size(8 → 32) улучшает tok/s и ухудшает TTFT p95 — направление тренда должно сохраняться. -
wallсогласован с tok/s:sum(out_lens) / tok/s ≈ wallс точностью до шага симулятора. - При повторном запуске с
seed=1234трафик и метрики совпадают бит-в-бит; при смене seed разброс p95 в пределах ±10 %. - В логе нет запросов с временем ожидания больше
max_wait— планировщик не морит голодом длинные префиллы. - На реальной модели (не симуляторе)
nvidia-smiпоказывает стабильное потребление памяти приcontinuous, тогда какpad-to-maxдаёт пики под самый длинный промпт в батче.
Сводка
- Статический батчинг платит за простоту паддингом: слоты простаивают, пока самый длинный запрос в батче не закончит генерацию, — отсюда высокая TTFT и низкая утилизация.
- Continuous batching превращает батч в очередь на уровне итерации: освободившийся слот сразу занимает новый запрос, и пропускная способность растёт в разы при том же железе.
- Главная цена continuous batching — хвост TPOT: вставка префиллы в середину декодирующего батча раздувает отдельные шаги, поэтому p95 TPOT важнее среднего.
- Чанкерная префилла режет длинный префилл на порции и вмешивает их в декодирующие шаги, выравнивая время шага и сбивая хвост TTFT. В 2026 — стандарт vLLM (Sarathi-style), а не опция.
- Дефолты шедулеров меняются между версиями: SGLang v0.4.0 —
lpm, v0.5.18 —fcfs. Утверждения о шедулере без версии не имеют силы. Под нагрузкой vLLM в 1.5–2.7x быстрее llama.cpp. chunk_size— ручка компромисса: крупные чанки ближе к обычному continuous по throughput, мелкие — к идеальному Tail Latency, но с накладными расходами на шаг.- Метрики надо мерить по потоку: TTFT от приёма запроса до первого токена, TPOT — по межтокенным интервалам, tok/s — по фактически сгенерированным токенам, а не по размеру батча.
- Симулятор с детерминированным seed — дешёвый способ поймать регрессии планировщика до запуска на GPU; реальные замеры нужны для калибровки констант стоимости.
Навигация по курсу: Хаб курса · Предыдущий: Fused-операторы и FlashAttention · Следующий: PagedAttention: пейджинг KV-кэша