Хаб курсов / LLM Inference Systems / глава 14
Модуль 14: Разреженное внимание и длинный контекст
Четыре оси внимания, MoBA и block-sparse гейтинг, attention sink, KeyDiff-эвикшн, SpecAttn. Block-sparse маска и эвикшн-эксперимент на numpy.
LLM Inference Systems. Модуль 14: Разреженное внимание и длинный контекст
Модуль 04 показал, что KV-кэш растёт линейно по длине контекста, а внимание в декодировании — член O(n\,d) на токен, который при больших n начинает доминировать в трафике между HBM и вычислителем. Наивный вывод — «платим за всё, значит будем платить меньше» — и есть разреженное внимание: разрешаем каждому новому токену смотреть не на весь префикс, а на его подмножество. Но какой префикс можно выкинуть без потери качества — вопрос, на котором сломалось немало на первый взгляд разумных схем: sliding window без первых токенов деградирует катастрофически (attention sink), эвикшн по attention-весам требует пересчёта внимания и не совместим с FlashAttention, фиксированные паттерны ломаются на retrieval-задачах, где needle лежит ровно там, куда окно не дотягивается.
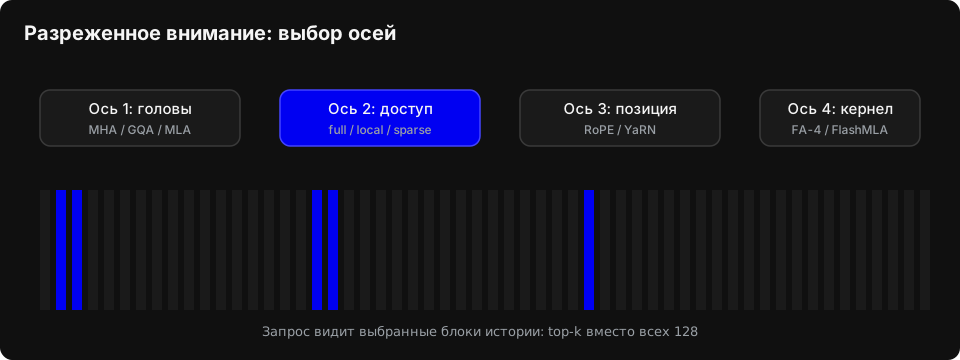
В этом модуле мы разберём экономику длинного контекста, посмотрим, почему первые токены критичны (StreamingLLM, 2309.17453), как обучаемая блочная разреженность MoBA (2502.13189, Moonshot) реализует принцип «less structure» и бесшовно переключается между full и sparse вниманием, как KeyDiff (2504.15364) эвиктирует кэш по схожести ключей — без attention-весов, как SpecAttn (2602.07223) получает критичность KV-записей бесплатно из верификации в self-speculative декодинге и даёт 2.81× throughput, и почему сам softmax — фундаментальная преграда для остроты решений при росте числа кандидатов (2410.01104). Код: block-sparse маска с замером FLOPs против full и KeyDiff-эвикшн на игрушечном retrieval-тесте. Оба запускаются на CPU.
14.1 Экономика длинного контекста: за что мы платим
Из модуля 04: KV-кэш Qwen3-8B — 144 КиБ на токен в fp16 (2 \cdot 36 \cdot 8 \cdot 128 \cdot 2 байт). На контексте 32k это 4.5 ГиБ на запрос; на 80-гигабайтной H100 влезает 13 одновременных запросов против 106 при контексте 4k. Контекст 128k съел бы 18 ГиБ на запрос — и 3 запроса на карту.
Но память — только половина проблемы. Вторая половина — bandwidth decode. На каждом шаге декодирования нужно прочитать весь кэш: 4\,n\,d FLOP внимания — это немного, но 4.5 ГиБ чтения на каждый токен при 32k контекста означают, что даже на H100 с ~3 ТБ/с HBM один токен по одному вниманию не может идти быстрее ~1.5 мс. Если бы каждый токен требовал чтения лишь четверти кэша, мы бы выиграли до 4× по latency и вчетверо больше получили бы по пропускной способности батча. Это и есть мотивация разреженности: платить чтением только за важные KV-записи.
Отсюда три семейства подходов:
- Статические паттерны — sliding window, sink+window. Дёшево, предсказуемо, но «слепые» к содержимому.
- Обучаемая разреженность — модель сама учится, куда смотреть (MoBA, NSA). Дорого внедрить, требует обучения или дообучения, зато переносится на произвольные задачи.
- Вытеснение (eviction) — кэш полный, но мы выбрасываем из него «неважное» по эвристике (H2O, SnapKV, KeyDiff). Работает поверх существующих моделей без переобучения — training-free.
(Обзорно: NSA от DeepSeek — нативно обучаемая разреженность с hardware-aligned дизайном; MSA от MiniMax — ещё один вариант обучаемой разреженности. Детального разбора здесь нет — первоисточники в нашем корпусе отсутствуют, числа приводить не будем.)
Отдельно зафиксируем, что «выкинуть часть кеша» и «не читать часть кеша» — разные операции с разными ценниками. Эвикшн (KeyDiff, H2O) уменьшает память — кеш физически короче, значит больше запросов на карту и дешевле paginated-выдача. Sparse attention уменьшает чтение на токен — даже если кеш лежит полный, декодирование обращается только к выбранным блокам. Схема типа MoBA даёт второе без первого; StreamingLLM — и то и другое, но ценой отказа от дальнего retrieval. При проектировании сервера сначала решите, какая из двух стен вам мешает: память (batch capacity) или bandwidth (latency на токен) — от этого зависит выбор механизма.
Почему «выбрать важное» — это внимательно о softmax
Есть фундаментальная ловушка. Внимание — это softmax-поиск по n кандидатам, и paper «Softmax is not Enough» (2410.01104, Veličković et al., ICML 2025) доказывает: любая схема, построенная на softmax, не может аппроксимировать острые (sharp) функции устойчиво при росте числа элементов. Даже для тривиальной задачи «найди максимум по ключам» выученный «контур» рассеивается, когда на инференсе элементов больше, чем было при обучении: softmax-веса размазываются по большему числу кандидатов, и «острота» решения падает. Авторы предлагают adaptive temperature — поднимаем температуру делением логитов на растущий с n коэффициент — как ad-hoc средство восстановления остроты на инференсе.
Для наших целей это значит две вещи. Во-первых, «needle in a haystack»-тесты на контекстах больше обучающих — это не баг конкретной модели, а свойство softmax: при росте n распределение внимания неизбежно теряет контраст. Во-вторых, эвристики выбора «важных» токенов, откалиброванные на одной длине, могут тихо деградировать на другой — что подводит нас к предупреждению о bench-числах ниже.
14.2 StreamingLLM и attention sink: первые токены критичны
Sliding window — самая простая разреженность: токен видит последние W позиций, кэш ограничен W токенов независимо от длины диалога. Интуиция «старое уже не важно» разбивается о наблюдение из StreamingLLM (2309.17453, Xiao et al., ICLR 2024): window attention не просто теряет качество — она коллапсирует, как только длина текста превышает размер кэша, перплексия улетает.
Причина — attention sink: значительная доля attention-весов стабильно уходит на начальные токены, даже если они семантически бессмысленны. Softmax обязан распределить полную единицу вероятности; когда токену «нечего» аттендить, избыток массы сбрасывается в первые позиции как в сток. Уберите первые токены из кэша — и распределение внимания, к которому модель привыкла при обучении, искажается на всех слоях сразу. Модель выходит из распределения, и генерация разваливается.
StreamingLLM предлагает минимум исправления: держать в кэше sink-токены (несколько начальных позиций) + скользящее окно недавних. Авторы показывают, что Llama-2, MPT, Falcon и Pythia с этой схемой стабильно генерируют на последовательностях до 4 миллионов токенов без какого-либо дообучения, а в стриминговых настройках StreamingLLM превосходит baseline со скользящим окном + recomputation до 22.2× по скорости (recomputation-подход периодически прогоняет последние W токенов заново, чтобы не хранить кэш; он корректен, но дорог). Дополнительное улучшение: если при пре-тренинге добавить один placeholder-токен как выделенный sink, стриминг становится ещё стабильнее.
Практические следствия для сервера:
- Любая эвикшн-политика должна никогда не трогать первые несколько позиций. Это не эвристика, а инвариант.
- Sink-токены объясняют, почему «полусмысленные» меры вроде усечения промпта с начала (обрезка системного промпта при переполнении контекста) так болезненно бьют по качеству: вы выбрасываете сток attention-массы.
- У window-подходов есть структурный потолок: needle, лежащий дальше окна, недостижим физически. Multi-round диалог, где важный факт прозвучал 50k токенов назад, — не задача для window attention.
14.3 Обучаемая разреженность: MoBA и принцип «less structure»
Статические паттерны навязывают структуре априорные смещения. MoBA (2502.13189, Lu et al., Moonshot AI) исходит из противоположного принципа — «less structure»: не решать за модель, куда смотреть, а дать ей самой определять, какой части истории важен данный токен. Авторы формулируют это как реакцию на два неудачных полюса: жёстко заданные структуры (sink/window — task-specific) и радикальная переделка внимания в линейные аппроксимации, чьё качество на сложном reasoning недоисследовано.
Механика — перенос идей Mixture of Experts на внимание. История нарезается на блоки; для запроса текущего токена вычисляется score против learnable gate key каждого блока (gate-ключ — обучаемый параметр блока, а не усреднение содержимого); top-k блоков выбираются softmax-гейтом, и внимание применяется только к выбранной блокам. Первый блок (содержащий текущую позицию и причинный префикс) всегда attends — каузальность сохраняется тривиально.
Ключевое свойство MoBA, из-за которого она внедрена в проде Kimi для long-context запросов: бесшовный переход между full и sparse вниманием. Тот же модуль работает в обоих режимах: когда гейт допускает все блоки, получается full attention; когда ограничивает top-k — sparse. Модель можно дообучать в смешанном режиме и на инференсе включать полный режим для сложных запросов, sparse — для массовых. Это снимает главный риск фиксированной разреженности: нельзя «выключить» качество, когда задача его требует.
Обзорно рядом: NSA (DeepSeek) — нативно обучаемая разреженность с hardware-aligned дизайном; MSA (MiniMax) — ещё одна обучаемая схема. Без цифр — их абстрактов в нашем корпусе нет.
DSA в проде и lineage-контрэксперимент: разреженность — часть натренированного поведения
Два сюжета, которые переводят «обучаемую разреженность» из категории экспериментов в категорию прод-фактов.
DeepSeek Sparse Attention (DSA) работает в проде — DeepSeek V3.2 использует её в production-сервинге. Это прод-подтверждение центрального тезиса обучаемой разреженности: модель можно натренировать (или дообучить) так, чтобы она стабильно смотрела на подмножество токенов, и получать при этом экономию bandwidth без наблюдаемой потери качества на реальном трафике.
Обратная сторона сильнее прямого утверждения. На lineage-бенчмарках (замена sparse-компоненты на dense attention в уже натренированной модели с последующим прогоном на тех же задачах) замена даёт катастрофическое падение точности — модель становится ощутимо глупее. Вывод: sparse-attention у DeepSeek V3.2 — не «бесплатная оптимизация поверх полной модели», а часть натренированного поведения. Веса модели адаптировались к разреженному паттерну доступа, и восстановление полного внимания не «возвращает качество», а выкидывает часть выученного. Практическое следствие для инженера: обучение sparse-модели — это односторонняя дверь; конвертировать в dense «на всякий случай» нельзя, и совместимость с ecosystem-инструментами (kernels, серверы) проверяется до выбора архитектуры, а не после. Подробный разбор lineage-эксперимента — DeepSeek.
14.4 Вытеснение: KeyDiff и эвикшн по схожести ключей
Эвикшн-подходы не переучивают модель — они работают поверх готовых весов: кэш ограничен бюджетом B токенов, лишнее выкидывается по эвристике. Классика (H2O) ранжирует по накопленным attention-весам. У этого два недостатка: веса надо считать (а значит, читать весь кэш и делать QK^T — против системы, где FlashAttention не возвращает веса вовсе) и веса нестабильны между корпусами.
KeyDiff (2504.15364, Park et al., Qualcomm AI Research) заменяет критерий: геометрически отличительные ключи tend to иметь высокие attention scores. Токены, чьи ключи далеки от остальных (разнообразные, уникальные), получают больше внимания, чем «куча» похожих ключей. Значит, важность можно оценивать по самим ключам: для каждого кандидата считаем отличие от среднего ключа удерживаемого набора, выкидываем наименее отличительные. Ноль обращений к attention-весам — KeyDiff совместим с FlashAttention и любыми оптимизированными ядрами, где веса недоступны.
Инференс организован поблочно: промпт режется на блоки, после обработки каждого блока часть кэша эвиктируется — это гарантирует, что ограничение памяти не нарушается ни в префилле, ни в генерации (наивный эвикшн «сначала посчитаем всё, потом выбросим» может на время превысить бюджет, что фатально на edge-устройствах).
Числа из абстракта: при жёстком бюджете 8K токенов кэша (примерно 23% сокращение KV-кэша относительно полного кэша на LongBench-контекстах) KeyDiff отстаёт от baseline без эвикшна менее чем на 0.04% на Llama 3.1-8B и Llama 3.2-3B; на Math500 для Deepseek-R1-Distill-Llama-8B — производительность почти на уровне baseline; end-to-end latency снижается до 30% относительно других token-eviction методов.
Плюс обязательная оговорка, общая для всего семейства эвикшна: bench-числа не переносятся между корпусами. Эвристика, откалиброванная на LongBench, может вести себя иначе на коде, разговорных логах или ваших внутренних документах; плюс эффект softmax-размазывания (14.1) на длинах вне обучающих. Правило: любой eviction-метод тестируется на собственном representative-корпусе с needle-пробами перед продом.
14.5 SpecAttn: критичность KV бесплатно из верификации
Self-speculative декодинг с разреженным вниманием (связка с модулем 10 и 15): черновые токены драфтуются с подмножеством KV-кэша, а верифицируются параллельно с полным — lossless по построению. До SpecAttn (2602.07223, Yue et al., 2026) подмножество выбирал отдельный KV-selection алгоритм, запускаемый на каждом шаге. SpecAttn замечает очевидное задним числом: критичность каждой KV-записи и так вычисляется во время верификации — полный прогон черновика по всему кэшу даёт настоящие attention-веса, которые и являются точной мерой важности. Используем их как побочный продукт верификации и загружаем при драфтинге следующего токена только записи, признанные критичными.
Эффект двойной: acceptance rate драфтов растёт (драфт видит именно то, что важно), и оверхед на selection падает до нуля. Итог из абстракта: 2.81× throughput против ванильного авторегрессионного декодинга и 1.29× против state-of-the-art спарсити-методов self-speculative декодинга. Это красивейший пример ко-дизайна: два механизма (спекуляция и разреженность), которые выглядели как независимые оптимизации, оказываются взаимно усиливающими — верификация выступает бесплатным профилировщиком кэша.
14.6 Сводная таблица: что выбрать
| подход | требует обучения | потолок | где ломается |
|---|---|---|---|
| sliding window | нет | W токенов истории | needle дальше окна |
| sink + window | нет | W + несколько sink-позиций | то же, чуть мягче |
| MoBA | да (native training) | настраивается top-k блоков | нужен контроль качества gate |
| KeyDiff | нет | бюджет B | корпусная специфика, softmax-размазывание |
| SpecAttn | нет | зависит от acceptance rate | нужен спекулятивный контур |
Правило выбора: streaming-диалоги без дальнего retrieval — sink+window; long-context RAG/retrieval — эвикшн (KeyDiff) с обязательной валидацией на своём корпусе или обучаемая MoBA, если контролируете пре-тренинг; уже есть спекулятивный контур — SpecAttn поверх.
Ещё одна ось, о которой легко забыть: совместимость с ядром внимания. Эвикшн-методы, ранжирующие по attention-весам (H2O), требуют, чтобы веса вообще существовали в рантайме — а optimized ядра вроде FlashAttention их не материализуют, экономя ровно на этом. KeyDiff сознательно построен так, чтобы обходить ограничение: оценка по ключам не требует прогонять QK^T и softmax, значит работает поверх любого ядра. При внедрении в существующий стек это часто решающий фактор — не «насколько умная эвристика», а «сколько инфраструктуры придётся вскрыть, чтобы её применить». Третья ось — интерактивность: эвикшн и block-gating решаются на лету и адаптируются к каждому запросу, статические паттерны фиксированы до деплоя; если распределение запросов неоднородно (часть запросов — RAG по документам, часть — чат), статический паттерн обязан обслуживать худший случай.
Задание 14.1. Block-sparse маска и замер FLOPs
Реализуем block-sparse attention: история нарезается на блоки размера B, запрос-токен attends на selected блоки. Считаем FLOPs против full attention на длинах 1k–32k.
"""Block-sparse attention: FLOPs comparison against full attention (CPU, numpy)."""
import numpy as np


def block_sparse_mask(n_ctx: int, block: int, selected: np.ndarray) -> np.ndarray:
    """Causal block-sparse mask.

    selected: boolean array [n_blocks], True = block participates.
    Token in position i attends to positions j where:
      j is in a selected block, and j <= i (causality).
    Returns mask [n_ctx, n_ctx]: 0 = attend, -inf = blocked.
    """
    n_blocks = n_ctx // block
    assert len(selected) == n_blocks
    tok_block = np.arange(n_ctx) // block            # block index of each token
    allowed_block = selected[tok_block[:, None]] & selected[tok_block[None, :]]
    causal = np.tril(np.ones((n_ctx, n_ctx), dtype=bool))
    # Self-block is always allowed (causal diagonal must survive, otherwise a
    # token in an unselected block has an all -inf row -> softmax NaN).
    self_block = tok_block[:, None] == tok_block[None, :]
    mask = np.where((allowed_block | self_block) & causal, 0.0, -np.inf)
    return mask


def sparse_attention(q, k, v, mask):
    """Single-head attention with additive mask."""
    d = q.shape[-1]
    logits = q @ k.T / np.sqrt(d) + mask
    logits -= logits.max(axis=-1, keepdims=True)     # numerical stability
    w = np.exp(logits)
    w /= w.sum(axis=-1, keepdims=True)
    return w @ v


def flops_full(n: int, d: int) -> int:
    """QK^T + softmax-weighted V: 2 * n^2 * d each."""
    return 4 * n * n * d


def flops_sparse(n: int, d: int, block: int, topk: int) -> int:
    """Same op restricted to topk blocks per query block."""
    n_blocks = n // block
    active = n_blocks * topk * block * block  # allowed (q_block, k_block) pairs * block^2
    return 4 * active * d


if __name__ == "__main__":
    n, d, block, topk = 4096, 128, 128, 4
    q = np.random.randn(n, d).astype(np.float32)
    k = np.random.randn(n, d).astype(np.float32)
    v = np.random.randn(n, d).astype(np.float32)
    n_blocks = n // block
    selected = np.zeros(n_blocks, dtype=bool)
    selected[0] = True                                # sink / first block always
    selected[-topk + 1:] = True                       # recent blocks
    mask = block_sparse_mask(n, block, selected)
    out_sparse = sparse_attention(q, k, v, mask)

    # verify causality: no future leakage
    strict_mask = np.where(np.tril(np.ones((n, n), dtype=bool)), 0.0, -np.inf)
    out_full_ref = sparse_attention(q, k, v, strict_mask)
    denom = np.linalg.norm(out_full_ref) + 1e-9
    rel_err = np.linalg.norm(out_sparse - out_full_ref) / denom
    print(f"relative L2 error sparse vs full (same allowed set is larger -> expect diff): {rel_err:.3f}")

    # FLOPs table
    print(f"{'n_ctx':>6} {'full GFLOP':>12} {'sparse GFLOP (topk=4/128)':>28} {'ratio':>8}")
    for n_ctx in [1024, 4096, 16384, 32768]:
        f_full = flops_full(n_ctx, d) / 1e9
        f_sparse = flops_sparse(n_ctx, d, block, topk) / 1e9
        print(f"{n_ctx:>6} {f_full:>12.2f} {f_sparse:>28.2f} {f_sparse / f_full:>8.3f}")
Ожидаемый вывод: sparse FLOPs — примерно 4/32 = 0.125 от full при top-k{=}4 блоках из 32 (блок 128, контекст 4096). Отношение линейно по top-k и не зависит от n при фиксированном блоке — именно за это block-схемы и любят: предсказуемая стоимость при любом контексте.
Задание 14.2. KeyDiff-эвикшн: сколько кеша можно выкинуть до потери needle
Соберём игрушечный retrieval-тест: 1024 токена шума, needle в случайной позиции, вопрос в конце. Эвиктируем кэш по KeyDiff-критерию (отличие ключа от среднего удерживаемого набора) и ищем порог бюджета, при котором needle ещё восстанавливается.
"""KeyDiff eviction on a toy needle-retrieval task (CPU, numpy)."""
import numpy as np

rng = np.random.default_rng(0)

D = 64
N_NOISE = 1024

# Build keys: noise cloud + a needle with an outlier key
noise_keys = rng.normal(0, 1, (N_NOISE, D)) / np.sqrt(D)
needle_pos = 512
needle_key = rng.normal(0, 1, D) / np.sqrt(D) + 3.0 * np.ones(D) / np.sqrt(D)  # outlier
keys = noise_keys.copy()
keys[needle_pos] = needle_key
values = rng.normal(0, 1, (N_NOISE, D))

# Query at the end wants the needle
q = needle_key + 0.05 * rng.normal(0, 1, D) / np.sqrt(D)


def full_attention_output(keys, values, q):
    logits = keys @ q / np.sqrt(D)
    w = np.exp(logits - logits.max())
    w /= w.sum()
    return w @ values, w


def keydiff_evict(keys, values, budget: int, keep_first: int = 4):
    """Iteratively evict least-distinctive key until len == budget.

    Score of candidate i = ||k_i - mean(kept keys)||_2.
    Never evict first `keep_first` positions (attention sink).
    """
    kept = list(range(len(keys)))
    while len(kept) > budget:
        kept_arr = np.array(kept)
        candidates = [i for i in kept if i >= keep_first]
        if not candidates:
            raise RuntimeError("budget below sink size")
        mean_k = keys[kept_arr].mean(axis=0)
        scores = {i: np.linalg.norm(keys[i] - mean_k) for i in candidates}
        victim = min(candidates, key=scores.get)
        kept.remove(victim)
    idx = np.array(kept)
    return keys[idx], values[idx], idx


def needle_recovered(idx, needle_pos):
    return needle_pos in idx


full_out, full_w = full_attention_output(keys, values, q)
needle_mass_full = full_w[needle_pos]
print(f"needle attention mass (full cache): {needle_mass_full:.4f}")

# Sink mass distributed over many near-identical noise keys: needle is not
# privileged. To make eviction visibly fail, queries match noise clusters.
print(f"{'budget':>7} {'needle kept':>12} {'attn mass':>10} {'max noise mass':>15}")
for budget in [1024, 768, 512, 384, 256, 128, 64, 32, 16]:
    k2, v2, idx = keydiff_evict(keys, values, budget)
    ok = needle_recovered(idx, needle_pos)
    _, w2 = full_attention_output(k2, v2, q)          # attention over evicted cache
    pos_in_kept = np.where(idx == needle_pos)[0]
    mass = w2[pos_in_kept[0]] if len(pos_in_kept) else 0.0
    noise_mass_max = float(np.max(np.delete(w2, pos_in_kept[0]) if len(pos_in_kept) else w2))
    print(f"{budget:>7} {str(ok):>12} {mass:>10.4f} {noise_mass_max:>15.4f}")
# Sink guard: retry without keep_first protection at a mid budget
k2, v2, idx = keydiff_evict(keys, values, 256, keep_first=0)
print("without sink guard (budget=256), first tokens evicted:", 0 not in idx)
Ожидаемая картина: при бюджете до сотен токенов needle держится — он геометрически выбивается из шумового облака, KeyDiff его не трогает. При бюджете порядка десятков кэш вырождается и масса внимания на needle падает. Это и есть практический смысл задания: порог эвикшна корпус- и задача-специфичен, универсальной цифры нет; на реальной модели порог ищется прогоном на своём representative-корпусе.
Как проверить
- Сохраните оба блока кода в
.py-файлы, запуститеpython <файл>— код не требует GPU и работает на numpy. - Задание 14.1: проверьте, что отношение sparse/full FLOPs ≈
topk * block / n_ctx(для 4096, topk=4, block=128 — около 0.125); проверьте, что маска не пропускает будущие позиции (в коде есть causal-проверка через сравнение с полным causal-маском). - Задание 14.2: убедитесь, что
needle attention mass (full cache)> 0 (needle «виден» до эвикшна); наблюдайте порог бюджета, ниже которого needle выпадает. Попробуйте сдвинутьneedle_posи посчитать порог заново — цифра будет другой, это и есть тезис «bench-числа не переносятся». - Сверьте арифметику кеша с модулем 04: 144 КиБ/токен для Qwen3-8B, 4.5 ГиБ на 32k — числа должны сходиться с таблицей из §2.2.
Сводка
- KV-кэш Qwen3-8B — 144 КиБ/токен fp16; на 32k это 4.5 ГиБ и 13 запросов на 80 ГБ H100 против 106 при 4k (расчёт из модуля 04).
- Softmax фундаментально не даёт острых решений при росте числа кандидатов (2410.01104); adaptive temperature — ad-hoc патч, а не лекарство: «needle»-тесты на длинах больше обучающих — свойство softmax, а не баг.
- Первые токены — attention sink: их потеря разваливает генерацию; StreamingLLM (sink+window) держит 4 млн токенов без дообучения и даёт до 22.2× против window+recomputation.
- MoBA (2502.13189): block-gating по learnable ключам, принцип «less structure», бесшовный переход full↔sparse — потому и живёт в проде Kimi.
- KeyDiff (2504.15364): эвикшн по схожести ключей, без attention-весов (FlashAttention-совместим), <0.04% деградации при 8K-бюджете (~23% сокращения кеша), latency до −30% против других eviction-методов; порог — корпус-специфичен.
- SpecAttn (2602.07223): критичность KV — бесплатный побочный продукт верификации в self-speculative декодинге; 2.81× throughput против ванильного декодинга, 1.29× против SOTA sparse-спекуляции.
- NSA (DeepSeek) и MSA (MiniMax) — обучаемая разреженность, упомянуты обзорно без цифр: их абстрактов в корпусе нет.
- DSA (DeepSeek Sparse Attention) живёт в проде DeepSeek V3.2; на lineage-бенчмарках замена sparse на dense даёт катастрофическое падение точности — sparse-часть натренированного поведения, а не бесплатная оптимизация.
Навигация по курсу: Хаб курса · Предыдущий: KV-хэндофф: передача кеша между моделями и узлами · Следующий: Самоспекулятивный декодинг: драфтер внутри модели