Хаб курсов / LLM Inference Systems / глава 15
Модуль 15: Самоспекулятивный декодинг: драфтер внутри модели
Слой-скип драфт и полная верификация, S2-MoE, SpecAttn, экономика acceptance против стоимости драфта. Эксперимент на toy-модели с адаптивной длиной драфта.
LLM Inference Systems. Модуль 15: Самоспекулятивный декодинг: драфтер внутри модели
В модуле 10 спекулятивный декодинг выигрывал на паре «маленький драфтер + большой верификатор»: внешняя модель (или n-gram-lookup) предлагала k токенов, target-модель проверяла их одним batched forward, и на нашем toy-примере при acceptance 79.7% один вызов target выдавал в среднем 4.85 токена. Но у внешнего драфтера есть цена, которую на toy-примере легко не заметить: отдельные веса в памяти, отдельная KV-эвакуация на каждый шаг драфта и рассогласование распределений драфтера и верификатора, которое и определяет acceptance. На edge-устройствах, где каждый гигабайт на счету, эта цена часто съедает весь выигрыш.
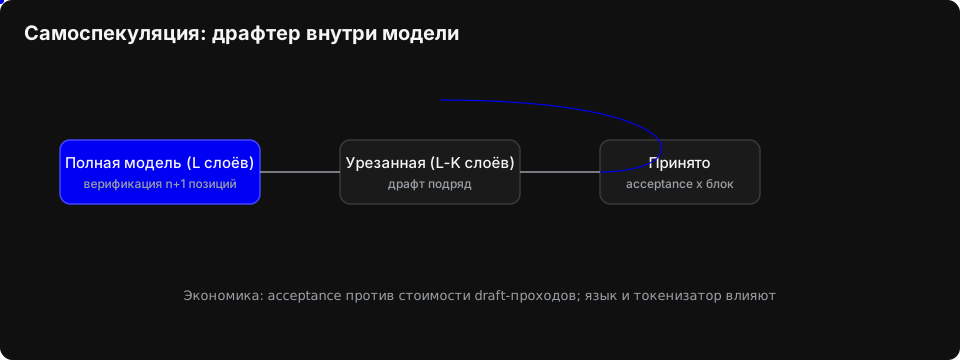
Самоспекулятивный декодинг убирает внешнюю модель: драфтер извлекается из самой target-модели. Идея везде одна — в модели уже есть «дешёвая версия самой себя»: несколько последних слоёв можно пропустить (LayerSkip-подход), в MoE можно драфтить на подмножестве активированных экспертов, в длинном контексте — драфтить на подмножестве KV-кэша. Верификатор при этом всегда полный, поэтому результат побитово совпадает с обычным декодингом — lossless. Модуль разбирает три свежие работы, которые доводят эту идею до продакшена (S2-MoE в llama.cpp, SpecAttn для длинного контекста, component-aware для гибридных архитектур), считает экономику — когда драфт дешевле верификации, а когда спекуляция вредит — и строит два рабочих эксперимента на toy-модели со слой-скипом.
15.1 Откуда взять драфтер внутри модели
У ordinary-модели есть три «внутренности», которые можно ослабить для драфта, не меняя веса:
- Слои. LLM-стек часто избыточен: последние слои уточняют представление, а раннее предсказание токена уже даёт высокое совпадение с полной моделью (идея LayerSkip). Драфт — forward без последних K слоёв; верификация — полный проход. Это тот же контракт, что в модуле 10: самый длинный совпавший префикс + один бонусный токен от target.
- Эксперты (MoE). На каждый токен активны не все эксперты. Драфт можно считать на подмножестве, а полную маршрутизацию включать только на верификации. Но наивное комбинирование спекуляции с MoE упирается в две вещи, которые мы разберём в 15.2: верификация дублирует драфт-работу, а переиспользование активированных экспертов между драфтом и верификацией плохое.
- Внимание. В длинном контексте критично малое подмножество KV-записей. Драфт можно считать на срезе кеша, верификацию — на полном. Это SpecAttn, раздел 15.3.
Общий контракт не меняется с модулем 10: lossless-инвариант — побитовое совпадение с жадным baseline — должен держаться всегда. Экономика другая: в модуле 10 драфт и target — разные модели с разными весами, здесь драфт — урезанный проход той же модели, поэтому стоимость draft-прохода выражается в тех же слой-проходах, что и верификация.
Отсюда же другое, менее очевидное следствие: самоспекуляция не требует ни обучения драфтера, ни согласования токенизаторов, ни отдельной дистилляции. Драфтер унаследовал все веса у верификатора и по построению смотрит на тот же словарь, тот же контекст и ту же историю сэмплинга. Внешние схемы платят за расхождение распределений низкой acceptance — у самоспекуляции расхождение ограничено сверху тем, сколько «мудрости» теряет срез слоёв или подмножество экспертов, и ровно поэтому acceptance здесь обычно выше, чем у случайно подобранной пары draft/target. Плата переносится в другую плоскость: качество драфта нельзя настраивать независимо — улучшая его, вы меняете саму target-модель, и наоборот.
15.2 S2-MoE: self-speculation для MoE на edge (2608.15018)
S2-MoE — первый систематический self-speculative фреймворк для MoE-инференса на edge-устройствах, где жёсткие ограничения по памяти и пропускной способности делают внешний драфтер особенно дорогим. Авторы показывают, что наивное комбинирование спекуляции с MoE даёт чрезмерный overhead верификации и плохое переиспользование экспертов — то есть ровно те две проблемы, которые делают схему бессмысленной, если их не решать.
Три механизма:
- Routing-aware adaptive speculative expansion. Драфт-длина подстраивается по маршрутизации: если роутер уверенно ведёт токены в эксперты, которые и так будут активированы при верификации, драфт-окно расширяется; если маршрут шумный — сжимается. Цель — сократить избыточную верификацию.
- Reuse-aware expert gating. При верификации эксперты переиспользуются между драфтом и verify-проходом, а не пересчитываются с нуля: это режет verification overhead в memory-bound-режиме edge-устройства.
- Shared context. Draft и target выполняются на общем контексте, чтобы их распределения не разъезжались.
Реализовано в llama.cpp. Числа: до 5.3× ускорения в peak и около 2.0× в среднем против стандартного авторегрессионного декодинга на разных MoE-моделях и датасетах на edge-устройствах. Для сравнения по масштабу эффекта: в модуле 10 внешний n-gram-драфтер давал 4.85 токена на вызов target при acceptance 79.7% — S2-MoE получает comparable-прирост без второй модели в памяти.
Стоит отметить, что разрыв между peak и average (5.3× против 2.0×) — сам по себе диагностический сигнал. Peak достигается на участках, где маршрутизация стабильна и драфт-окно успевает расшириться: текст копируется, продолжение предсказуемо, эксперты переиспользуются почти полностью. Average опускается к 2× на смешанных данных, где часть раундов уходит в узкие окна и откаты. Это тот же урок, что и с n-gram-драфтером модуля 10: acceptance сильно зависит от профиля задачи, и бенчмарк, состоящий из одного типа текста, будет лгать о средней скорости — см. модуль 16 о том, как не обмануться числом.
15.3 SpecAttn: draft на срезе кеша (2602.07223)
SpecAttn решает самоспекуляцию для длинного контекста. Схема: токены драфтятся с использованием подмножества KV-кэша и верифицируются параллельно с полным кешем — lossless. Предыдущие работы делали так же, но полагались на отдельные алгоритмы выбора KV-записей для драфта; SpecAttn замечает, что критичность каждой KV-записи и так вычисляется во время верификации, и использует её как побочный продукт: при драфте следующего токена загружаются только записи, признанные критичными на последнем verify-проходе.
Эффект двойной: выше acceptance (выборка лучше согласована с тем, что реально важно для верификатора) и ниже overhead выбора KV. Числа: 2.81× throughput против vanilla авторегрессионного декодинга и 1.29× против предыдущих sparsity-based self-speculative методов. Это ровно та стыковка с модулем 14 (разреженное внимание), о которой стоит помнить: спекуляция и разреженность выигрывают не независимо, а совместно, если выборка KV для драфта выводится из верификации, а не считается отдельно.
15.4 Component-aware self-speculation для гибридных моделей (2605.01106)
Гибридные модели (Transformer + SSM/linear-attention) предоставляют ещё один источник внутреннего драфтера: изолировать SSM/linear-attention подграф и считать его «бесплатным» драфтом, верифицируя полной моделью. Авторы проверили это на двух архитектурно различных семействах: Falcon-H1 (параллельная интеграция Mamba-2 + attention в слое) и Qwen3.5 (последовательная: чередование linear- и attention-слоёв), с чистым Transformer (Qwen2.5) как контролем.
Результат важный и отрезвляющий: параллельные гибриды дают acceptance α = 0.68 при длине драфта k = 2 (greedy), а последовательные — только α = 0.038, разрыв в 18 раз. Свойство масштабируется: Falcon-H1 на 3B воспроизводит значения 0.5B. Значит, вопрос «можно ли спекулировать внутри гибрида» определяется не наличием альтернативного компонента, а паттерном композиции. Авторы добавили и предиктор без запуска спекуляции: деградация перплексии в companion-абляции предсказывает жизнеспособность — соотношение 3.15× у Falcon соответствует α = 0.37 при k = 4, а 81.96× у Qwen — α = 0.019. Для последовательных гибридов generic LayerSkip даёт acceptance в 12 раз выше, чем component-aware стратегия.
15.5 Экономика: acceptance против стоимости draft-прохода
MTP стал дефолтом рантаймов. К осени 2026 MTP — нативная поддержка в vLLM и SGLang, llama.cpp умеет его для Qwen3.6/3.8 и EXAONE MoE. Два уточнения к слову «дефолт». Первое: в LMStudio реализация MTP режет качество вывода (кривой speculative decoder; кастомная настройка gamma — в roadmap) — включать не глядя нельзя. Второе: acceptance зависит от сценария — на Qwen3.6-27B в агентных задачах с tool calling acceptance поднимают до 62% только ограничением длины генерации. Числа замеров авторов, не независимые.
Формула из модуля 10 остаётся, но теперь обе части выражены в слой-проходах одной модели. Пусть модель имеет L слоёв, драфт срезает K из них и предлагает n токенов с acceptance α. На раунд:
- baseline: L слой-проходов на 1 токен;
- спекуляция: draft ≈ n·(L−K) слой-проходов на n токенов-кандидатов + verify L·(n+1) слой-проходов на блок из примерно 1+α·n токенов.
Выигрыш по слой-проходам на токен существует, только если верификация действительно batched — то есть один forward проверяет n+1 позицию почти по цене одного. На GPU это так (arithmetic intensity), на CPU-игрушке из нашего кода — нет, и wall-clock там честно показывает 0.3–0.4×. Важно не путать две метрики: токенов на вызов target (предел схемы, как 4.85 в модуле 10) и wall-clock (что реально получает пользователь).
Когда спекуляция вредна:
- acceptance низкий — драфт и верификатор слишком рассогласованы (пример: последовательные гибриды с α = 0.038 из 15.4);
- draft-проход не бесплатен — на edge в memory-bound-режиме каждый слой-проход драфта конкурирует с верификацией за пропускную способность; наивная схема без reuse-aware gating тонет в duplication;
- система под нагрузкой. Наш замер (наш замер, не из papers): DFlash на RTX 4060 под нагрузкой давал 0.25× — то есть в 4 раза медленнее обычного декодинга; EAGLE-3 acceptance на русском тексте — 0.17, чего недостаточно для окупаемости draft-прохода. Вывод тот же, что в модуле 10: спекуляция — не фича, а сделка, и её надо измерять на вашем железе и вашем языке.
15.6 Как это выглядит в рантайме
Ландшафт драфтов 2026: DFlash2, EAGLE-3 и обязательная оговорка про язык
Свежие цифры ландшафта (замеры авторов, английский текст):
- DFlash2 (параллельный драфт блоков): 142 tok/s против 113 tok/s у MTP на Qwen3.8-27B; на H200 с 27B — рост с 67 до 255 tok/s.
- EAGLE-3: голова 150–300 МБ в GGUF, acceptance 0.80–0.88 на Qwen/Llama, нативно в llama.cpp.
Acceptance-бенчмарков для русского не существует, и перенос с английского невалиден. Русский токенизируется хуже: больше токенов на слово, более равномерное распределение предсказуемости — обе эти вещи давят acceptance вниз. Наш собственный замер в этом модуле это подтверждает: EAGLE-3 acceptance на русском тексте — 0.17, при котором схема не окупается. Рабочее требование: acceptance меряется на реальных запросах вашего языка и при совпадении токенизатора у target и draft; любая acceptance-цифра без указания языка и токенизатора не имеет переносной силы.
Новые исследовательские работы (кратко)
- KnapSpec (arXiv 2602.20217): выбор срезаемых слоёв формулируется как задача о рюкзаке — какие слои отдать драфту при заданном бюджете качества.
- CLaSp (in-context layer skip): пропуск слоёв без дополнительных модулей и тренировки.
- LK Losses (arXiv 2602.23881): прямая оптимизация acceptance rate в лоссе при обучении.
Внешние драфтеры рядом с этой картой: UBTree и DARTree
Ландшафт 2026 дополняют два внешних драфтера, которые не относятся к self-speculation и подробно разобраны в модуле 10:
- UBTree (arXiv:2609.39972) — external parallel/tree drafter: unigram proposer + обученный bigram selector, tree-native тренировка на high-temperature трассах (renormalized KL). Draft checkpoint отдельный и парный к target: Ling3-Flash-UBTree-B16 работает только вместе с matching target inclusionAI/Ling-3.0-flash и не является самостоятельной моделью — это внешняя модель, а не срез самой target (ср. с LayerSkip, S2-MoE и SpecAttn выше).
- DARTree (arXiv:2608.13524) — training-free расширение предобученной AR correction head от цепочек к деревьям; в отличие от UBTree, не обучает proposer/selector.
Оба метода — внешние драфтеры, их нельзя смешивать с самоспекуляцией: у них есть отдельные веса драфта, отдельная дистилляция/обучение и согласование токенизаторов, тогда как self-speculative схемы этого раздела этих платежей не несут (см. 15.1).
Теория хороша, но применение схемы в реальном рантайме упирается в три инженерных вопроса, которые в статьях спрятаны в одной строчку «implemented in llama.cpp».
Первый — совместное использование KV-кеша. Драфт и верификация работают с одним и тем же контекстом, и наивная реализация хранит два кеша: полный для верификатора и срезанный для драфтера. S2-MoE решает это через shared context: драфт и target выполняются на общем контексте, а SpecAttn идёт дальше — критичные KV-записи выбираются из уже посчитанного верификационного прохода, так что отдельная фаза выбора исчезает. На edge, где KV-кеш доминирует по памяти (вспомним асимметрию из модуля 10: у маленьких моделей KV-кеш растёт быстрее весов), это не оптимизация, а условие применимости.
Второй — батчинг verify-прохода. Вся экономика схемы держится на том, что проверка n+1 позиций стоит почти как одна. В рантайме это значит: общий префикс не пересчитывается, кеш драфт-позиций аккуратно отбрасывается после отката, а logits по всем позициям блока собираются одним проходом. Наш toy-код в задании 15.1 не делает этого намеренно — «verify» там честный цикл, — и именно поэтому wall-clock там ниже 1×: это контролируемая демонстрация того, что происходит без батчинга.
Третий — совместимость с квантованием и параллелизмом. Если верификатор квантован (модуль 5) или шардирован (модуль 10), драфт обязан согласовываться с этим: срезание слоёв в квантованной модели и в fp-модели даёт разный acceptance, а на шардированной модели драфт без K слоёв меняет и шаблон коммуникации. Это одна из причин, почему reuse-aware gating в S2-MoE сформулирован на уровне системы, а не отдельного слоя: переиспользование экспертов должно переживать и батчинг, и раскладку по устройствам.
Задание 15.1: слой-скип спекуляция на toy-модели
Модель — L = 6 слоёв: «ядро» из 4 слоёв плюс 2 уточняющих, которые редко меняют предсказание. Драфт — forward без последних K слоёв; верификация — полный проход; контракт — как в модуле 10. Замеряем acceptance, слой-проходы и wall-clock против baseline и против n-gram-драфтера модуля 10.
Запустите python module15.py. Ожидаемый вывод:
--- фиксированный draft=4, k_skip=1 ---
сгенерировано        : 252
принято драфт-токенов: 195
раундов верификации  : 57
средний блок         : 4.42 токенов/раунд
acceptance rate      : 77.4%
слой-проходов        : 2850 (draft 1140 + target 1710) vs baseline 1512 -> экономия -88.5%
wall-clock           : 0.5 мс vs 0.2 мс -> 0.34x
lossless             : OK (побитово совпадает с baseline)
--- фиксированный draft=4, k_skip=2 ---
сгенерировано        : 252
принято драфт-токенов: 189
раундов верификации  : 63
средний блок         : 4.00 токенов/раунд
acceptance rate      : 75.0%
слой-проходов        : 2898 (draft 1008 + target 1890) vs baseline 1512 -> экономия -91.7%
wall-clock           : 0.5 мс vs 0.2 мс -> 0.36x
lossless             : OK (побитово совпадает с baseline)
Что здесь важно понять:
- Lossless-инвариант выполняется во всех трёх прогонах: спекуляция побитово совпадает с жадным baseline. Это контракт, который нельзя нарушать даже в toy.
- Wall-clock 0.34× — не ошибка, а урок. В toy-модели «forward» — это цикл по позициям, batched-верификация не даёт free lunch, и стоимость draft-проходов (1140 слой-проходов) превышает экономию target'а. Ускорение по токенам на раунд (4.42) показывает предел схемы — как 4.85 в модуле 10; wall-clock в этой игрушке всегда будет < 1×. Реальные системы выигрывают, потому что batched verify почти бесплатен по сравнению с n+1 отдельными проходами.
- k_skip = 2 хуже k_skip = 1 по всем метрикам (acceptance 75.0% против 77.4%, слой-проходов больше): срезание «лишнего» слоя снижает согласованность драфта с верификатором сильнее, чем даёт экономия на драфте. Это и есть trade-off из 15.5 в миниатюре.
Задание 15.2: адаптивная длина драфта по скользящему acceptance
Фиксированная длина драфта расточительна: на «лёгких» участках можно предлагать больше, на «тяжёлых» — меньше. Простейший контроллер: скользящее окно из последних 8 раундов, если acceptance < 0.5 — уменьшаем draft на 1, если > 0.8 — увеличиваем (максимум 6). Это грубый аналог routing-aware adaptive expansion из S2-MoE.
Ожидаемый вывод третьего прогона:
--- адаптивный контроллер, k_skip=1 ---
сгенерировано        : 252
принято драфт-токенов: 209
раундов верификации  : 47
средний блок         : 5.36 токенов/раунд
acceptance rate      : 82.9%
слой-проходов        : 3197 (draft 1325 + target 1872) vs baseline 1512 -> экономия -111.4%
wall-clock           : 0.5 мс vs 0.2 мс -> 0.33x
lossless             : OK (побитово совпадает с baseline)
Контроллер поднял acceptance с 77.4% до 82.9% и средний блок с 4.42 до 5.36 — но на этой toy-модели слой-проходов стало даже больше (3197 против 2850): удлинение драфта на лёгких участках увеличивает суммарный draft-FLOPs быстрее, чем выигрывает верификация, поскольку batched-эффект в игрушке нулевой. На настоящем GPU соотношение другое, и S2-MoE получает свои 5.3× peak именно потому, что адаптивная длина драфта сокращает избыточную верификацию без роста стоимости драфта. Мораль: метрика «средний блок» — не тождественна метрике «слой-проходы», и контроллер надо тюнить по той, которая соответствует вашему железу.
Код
# -*- coding: utf-8 -*-
"""Модуль 15: самоспекулятивный декодинг — драфтер внутри модели.

Toy-модель: L слоёв, ядро (4 слоя) + уточняющие (2 слоя).
Draft = forward без последних K слоёв, verify = полный проход.
Greedy-верификация: самый длинный совпавший префикс + 1 бонусный токен.

Задание 15.1: фиксированная длина драфта, замер acceptance и wall-clock.
Задание 15.2: адаптивная длина драфта по скользящему acceptance.
"""
from time import perf_counter

import numpy as np

VOCAB = 100
L_CORE = 4      # ядро: его считают оба (draft и target)
L_REFINE = 2    # уточняющие слои: их пропускает draft
LAYERS = L_CORE + L_REFINE

A = [7, 11, 13, 17, 3, 5]
B = [13, 29, 41, 7, 3, 11]


def _refine_delta(x, layer, pos):
    """Уточнение от refine-слоя: редко != 0 (примерно в 1/17 случаев на слой)."""
    return 1 if (x * (layer + 3) + pos) % 17 == 0 else 0


def next_token_full(ids, n_layers=LAYERS):
    """Жадный следующий токен полной модели. n_layers последних слоёв можно срезать."""
    x = ids[-1]
    pos = len(ids)
    for i in range(n_layers):
        if i < L_CORE:
            x = (x * A[i] + B[i]) % VOCAB
        else:
            x = (x + _refine_delta(x, i, pos)) % VOCAB
    return x


# target: полная модель; draft: модель без последних K refine-слоёв
def draft_next(ids, k_skip):
    return next_token_full(ids, n_layers=LAYERS - k_skip)


def speculative_decode(seed, n_target=256, n_draft=4, k_skip=1, adaptive=False,
                       win=8, lo=0.5, hi=0.8):
    ids = list(seed)
    n_seed = len(ids)
    accepted = 0
    calls = 0                       # раундов верификации (batched forward target)
    draft_flops = 0                 # слой-проходов, потраченных draft'ом
    target_flops = 0                # слой-проходов, потраченных target'ом
    blocks = []
    acc_hist = []                   # acceptance последнего раунда (для контроллера)
    nd = n_draft

    t0 = perf_counter()
    while len(ids) < n_target:
        # ---- draft: авторегрессионно, каждый шаг дешевле full на k_skip/LAYERS
        d = []
        buf = list(ids)
        for _ in range(nd):
            d.append(draft_next(buf, k_skip))
            buf.append(d[-1])
            draft_flops += LAYERS - k_skip

        # ---- verify: ОДИН batched forward полной модели по префиксу + драфту
        preds = [next_token_full(ids + d[:i]) for i in range(len(d) + 1)]
        calls += 1
        target_flops += LAYERS * (len(d) + 1)

        n_acc = 0
        while n_acc < len(d) and d[n_acc] == preds[n_acc]:
            n_acc += 1
        emitted = d[:n_acc] + [preds[n_acc]]
        ids.extend(emitted)
        accepted += n_acc
        blocks.append(len(emitted))
        acc_hist.append(n_acc / max(nd, 1))

        # ---- Задание 15.2: контроллер длины драфта по скользящему acceptance
        if adaptive and len(acc_hist) >= win:
            r = sum(acc_hist[-win:]) / win
            if r < lo:
                nd = max(1, nd - 1)
            elif r > hi:
                nd = min(6, nd + 1)
    elapsed = perf_counter() - t0

    return {
        "ids": ids[:n_target],
        "accepted": accepted,
        "calls": calls,
        "draft_flops": draft_flops,
        "target_flops": target_flops,
        "total_flops": draft_flops + target_flops,
        "blocks": blocks,
        "elapsed": elapsed,
        "generated": len(ids[:n_target]) - n_seed,
    }


def baseline_decode(seed, n_target=256):
    ids = list(seed)
    n_seed = len(ids)
    flops = 0
    t0 = perf_counter()
    while len(ids) < n_target:
        ids.append(next_token_full(ids))
        flops += LAYERS
    return {"ids": ids[:n_target], "elapsed": perf_counter() - t0,
            "flops": flops, "generated": n_target - n_seed}


def report(name, spec, base, target_ids):
    gen = spec["generated"]
    print(f"--- {name} ---")
    print(f"сгенерировано        : {gen}")
    print(f"принято драфт-токенов: {spec['accepted']}")
    print(f"раундов верификации  : {spec['calls']}")
    print(f"средний блок         : {gen / spec['calls']:.2f} токенов/раунд")
    print(f"acceptance rate      : {spec['accepted'] / gen:.1%}")
    print(f"слой-проходов        : {spec['total_flops']} (draft {spec['draft_flops']} + target {spec['target_flops']})"
          f" vs baseline {base['flops']} -> экономия {1 - spec['total_flops'] / base['flops']:.1%}")
    print(f"wall-clock           : {spec['elapsed'] * 1e3:.1f} мс vs {base['elapsed'] * 1e3:.1f} мс"
          f" -> {base['elapsed'] / spec['elapsed']:.2f}x")
    assert spec["ids"] == target_ids, "lossless-инвариант нарушен!"
    print("lossless             : OK (побитово совпадает с baseline)")


def main():
    seed = [0, 1, 2, 3]
    n_target = 256
    base = baseline_decode(seed, n_target=n_target)

    for k_skip in (1, 2):
        spec = speculative_decode(seed, n_target=n_target, n_draft=4, k_skip=k_skip)
        report(f"фиксированный draft=4, k_skip={k_skip}", spec, base, base["ids"])

    spec = speculative_decode(seed, n_target=n_target, n_draft=4, k_skip=1, adaptive=True)
    report("адаптивный контроллер, k_skip=1", spec, base, base["ids"])


if __name__ == "__main__":
    main()
Как проверить
- Процесс завершается с кодом 0, все три прогона печатают
lossless : OK— спекуляция побитово совпадает с baseline во всех конфигурациях. - Задание 15.1, k_skip=1: acceptance около 77–78%, средний блок 4.3–4.5, wall-clock-ускорение < 1× (это норма для CPU-игрушки без батчинга, см. 15.5). Если acceptance сильно ниже 70% — проверьте, что draft действительно считает
LAYERS - k_skipслоёв, а верификация — всеLAYERS. - Задание 15.1, k_skip=2: acceptance чуть ниже k_skip=1, слой-проходов — больше. Если наоборот — уточняющие слои в вашей версии стали слишком «шумными» или драфт срезает не те слои.
- Задание 15.2: acceptance и средний блок выше фиксированного прогона; lossless-инвариант не нарушен. Контроллер должен менять
nd(проверьте печатьspec["blocks"]— длины блоков не одинаковы).
Сводка
- Самоспекулятивный декодинг убирает внешнего драфтера модуля 10: драфт извлекается из самой модели — пропуск слоёв, подмножество экспертов (MoE) или подмножество KV-кеша.
- S2-MoE (2608.15018): routing-aware adaptive draft + reuse-aware expert gating + shared context в llama.cpp; до 5.3× peak и ~2.0× среднего ускорения для MoE на edge.
- SpecAttn (2602.07223): драфт на KV-подмножестве, верификация на полном кеше, выборка критичных записей — побочный продукт верификации; 2.81× throughput против baseline, 1.29× против предыдущих sparse-методов. Lossless.
- Component-aware self-speculation (2605.01106) для гибридов: работает только при параллельной композиции (Falcon-H1, α=0.68 при k=2), на последовательной — α=0.038; перплексия абляции предсказывает жизнеспособность без запуска спекуляции.
- MTP — дефолт рантаймов (vLLM/SGLang native, llama.cpp для Qwen3.6/3.8 и EXAONE MoE) с оговорками: LMStudio режет качество (кривой speculative decoder), Qwen3.6-27B tool calling — acceptance 62% при ограничении генерации. DFlash2: 142 vs 113 tok/s (MTP) на Qwen3.8-27B; EAGLE-3 — голова 150–300 МБ GGUF, acceptance 0.80–0.88 (замеры авторов, английский).
- Acceptance-бенчмарков для русского нет, перенос с английского невалиден — русский токенизируется хуже; наш замер: EAGLE-3 acceptance 0.17 на русском. Любая acceptance-цифра требует указания языка и токенизатора.
- Новые работы: KnapSpec (2602.20217, выбор слоёв как рюкзак), CLaSp (in-context layer skip), LK Losses (2602.23881, прямая оптимизация acceptance).
- Экономика: спекуляция окупается только при высоком acceptance и дешёвом draft-проходе. Наш замер (не из papers): DFlash 0.25× на RTX 4060 под нагрузкой, EAGLE-3 acceptance 0.17 на русском — обе схемы не окупаются в этих условиях.
- Игрушечный слой-скип эксперимент: acceptance 77.4% при k_skip=1, wall-clock < 1× из-за отсутствия батчинга — разделение метрик «токенов на вызов» и «wall-clock» обязательно.
- Внешние драфтеры UBTree (2609.39972) и DARTree (2608.13524) — не самоспекуляция: отдельный draft checkpoint, обучение/дистилляция, согласование токенизаторов. Доска ландшафта и цифры — в модуле 10.
Навигация по курсу: Хаб курса · Предыдущий: Разреженное внимание и длинный контекст · Следующий: Как не обмануться числом: методология замера