Хаб курсов / Курс по RAG / глава 2
Модуль 02: векторные БД, Qdrant и pgvector
Векторные БД без магии: как устроен HNSW, зачем payload-фильтры, чем отличаются Qdrant и pgvector и как организовать мультитенантность.
RAG Engineering. Модуль 02: Векторные БД, Qdrant и pgvector
Почему векторная БД быстрая: HNSW на пальцах
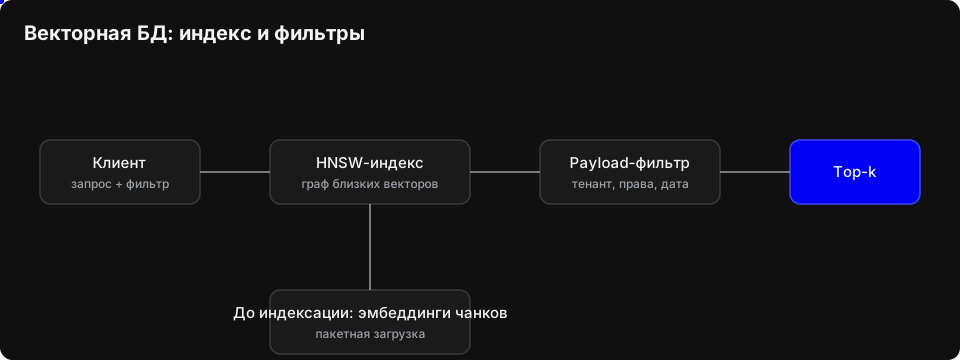
Начнём с проблемы. Если нужно найти ближайший вектор к запросу, самый простой способ такой: сравнить запрос со всеми векторами в коллекции и выбрать лучшие. Это полный перебор, или exact search. Если в коллекции N векторов, работа растёт как O(N). На небольших наборах это нормально. На миллионах векторов проверять всё подряд уже слишком дорого: латентность становится неприемлемой, особенно если поиск вызывается на каждый запрос пользователя.
Векторная БД ускоряет поиск не потому, что сравнивает векторы каким-то магическим образом, а потому что использует индекс. Один из популярных индексов для приближённого поиска называется HNSW, Hierarchical Navigable Small World. Идея у него такая: векторы становятся узлами графа, а рёбра соединяют похожие, то есть близкие, векторы. Вместо проверки всех точек мы идём по графу от узла к узлу и стараемся быстро добраться до области, где лежат хорошие кандидаты.
Граф в HNSW многослойный. Верхние слои разреженные: в них мало узлов и длинные связи. Нижние слои плотнее: узлов больше, связи короче и точнее. Самый нижний слой содержит основную массу векторов. Это похоже на карты разного масштаба. Сначала ты смотришь на карту страны: видишь крупные города и можешь быстро перейти из одного региона в другой. Потом открываешь карту региона: маршрут становится точнее. В конце смотришь карту города и находишь конкретную улицу. HNSW работает так же: сверху делает грубую навигацию, снизу уточняет результат.
Поиск начинается с верхнего слоя. У нас есть текущий узел и вектор запроса. Мы смотрим на соседей текущего узла и жадно идём к тому, который ближе к запросу. Если среди соседей нет узла ближе текущего, значит на этом слое мы дошли до локально хорошей точки. Тогда спускаемся на следующий слой и продолжаем оттуда. На каждом слое повторяем одно и то же: идём к ближайшим соседям, пока есть улучшение, затем переходим ниже. На самом нижнем слое уже собираем список кандидатов и выбираем лучшие. Это и есть approximate nearest neighbor search, или ANN: поиск приближённый, но обычно заметно быстрее полного перебора.
Жадный спуск не гарантирует нахождение абсолютно ближайшего вектора. Граф не хранит все возможные связи, а поиск не просматривает все узлы. Он идёт по маршруту, который выглядит лучшим локально. Поэтому HNSW даёт хороший результат с высокой вероятностью, но не обещает математически точный ответ, как полный перебор.
Теперь параметры. m задаёт число связей у узла, то есть насколько густо узел связан с соседями. Чем больше m, тем богаче граф и тем выше шанс, что поиск сможет пройти к хорошим кандидатам. Но у узла становится больше рёбер, поэтому растёт память на индекс. Кроме того, вставка нового вектора становится дороже: нужно выбрать больше соседей и обновить больше связей. Чем меньше m, тем компактнее индекс и дешевле вставка, но граф беднее, и качество поиска может просесть.
Параметр ef задаёт размер списка кандидатов при поиске. Можно думать о нём так: сколько хороших узлов поиск держит в работе и насколько широко исследует граф. При маленьком ef поиск смотрит меньше кандидатов и заканчивается быстрее. При большом ef он проверяет больше вариантов, чаще находит действительно хороших соседей, но работает дольше. Здесь есть прямая цена: ef выше, поиск медленнее; ef ниже, поиск быстрее, но полнота может упасть.
Полнота, или recall, здесь означает долю действительно близких векторов, которые поиск сумел найти. Для RAG это важная метрика: если индекс теряет релевантный чанк, модель может не получить нужный контекст. Поэтому настраивать HNSW нужно не по одному параметру, а с оглядкой на три вещи: латентность, полноту и память.
Это и есть основная триада компромиссов. Нельзя просто улучшить всё сразу. Хочешь меньше памяти: снижаешь m. Но граф становится беднее, и чтобы удержать полноту, часто приходится увеличивать ef, а значит, платить латентностью. Хочешь меньше латентности: снижаешь ef. Но тогда падает полнота, либо нужно повышать m, а это снова память и более дорогая вставка. Хочешь выше полноту: увеличиваешь ef или m. В первом случае страдает скорость, во втором память и стоимость построения индекса. Универсально лучших значений нет: они зависят от данных, железа и требований к качеству.
Теперь отличие ANN от точного поиска. Точный поиск гарантирует, что возвращённые векторы действительно ближайшие по выбранной метрике. ANN этого не гарантирует. Он возвращает приближённо ближайшие векторы, зато обычно делает это быстрее и не требует полного перебора. Для RAG это часто приемлемо: тебе нужен хороший контекст для генерации, а не юридически заверенный список всех ближайших соседей. Если поиск стабильно возвращает релевантные чанки в верхних результатах, редкие пропуски могут почти не влиять на ответ.
Но approximate search не всегда уместен. Если ошибка поиска критична, если нужно сравнивать векторы для дедупликации, проверять точное совпадение или строить систему с жёсткими требованиями к полноте, лучше использовать точный поиск либо очень внимательно контролировать recall. На маленькой коллекции полный перебор может оказаться проще и предсказуемее. На большой коллекции HNSW даёт практичный компромисс: быстрый поиск в обмен на возможность иногда пропустить идеального соседа.
Для RAG полезно проверять этот компромисс на своих данных. Возьми набор запросов, получи результаты точного поиска как эталон и сравни с ANN при разных ef и m. Смотри на скорость и заодно проверь, попадают ли нужные чанки в верхние результаты. Так ты увидишь реальную цену параметров именно для своего корпуса, а не абстрактное «быстрее» или «качественнее».
Что ты построишь
В практической части ты перенесёшь мини-RAG из m01 на векторную БД без Docker. Сначала загрузишь те же документы и чанки, затем вынесешь поиск в класс VectorDB с payload-фильтром по тенанту и выполнишь те же запросы. После этого замеришь латентность поиска и сравнишь выдачу с точным перебором на маленьком контрольном наборе. В конце замеришь латентность при k=3 и k=20, с фильтром и без, и соберёшь pgvector-схему для продакшена.
Payload-фильтры и мультитенантность
Векторный поиск почти никогда не живет отдельно от метаданных. У точки есть вектор и payload: tenant_id, раздел, дата, права доступа, тип документа, статус. Payload нужен не только для показа результата. Он задает пространство поиска: искать среди документов конкретного тенанта, за нужный период, в доступных пользователю разделах.
Почему нельзя фильтровать после поиска
Представь, что индекс возвращает top-k по всему корпусу, а приложение потом выбрасывает точки с чужим tenant_id. Это ошибка. Top-k считается до фильтра, поэтому после него может остаться меньше k результатов или ноль. Пользователь получит неполный контекст, а код может передать пустой список в генерацию. Если приложение где-то ослабит фильтр или забудет его, в контекст попадут чужие данные. Увеличивать k заранее тоже не решение: нужного количества никто не гарантирует, а нагрузка растет. Фильтр должен участвовать в выборе кандидатов: до поиска или во время обхода индекса, но не после получения финального top-k.
Pre-filter, filtered search и полный перебор
Pre-filter сначала получает множество точек, удовлетворяющих payload, и ищет только среди них. Если подходящих точек мало, разумно посчитать расстояния полным перебором этого подмножества: результат точный, а лишняя работа ограничена размером подмножества. Если подмножество большое, движок использует приближенный индекс, но обязан проверять payload для кандидатов. В интегрированном filtered search условие проверяется при обходе индекса. Важно, чтобы движок не останавливался, набрав k соседей без учета фильтра, и чтобы API не применял limit раньше фильтра.
Фильтр по индексу и полный перебор решают разные задачи. Индекс по payload сужает набор кандидатов по равенству, диапазону или членству. Например, индекс по tenant_id обязателен для общей коллекции, индекс по дате помогает диапазонным запросам, индекс по полю прав доступа помогает проверкам доступа. Но индекс не бесплатен: он занимает место, требует обновления при записи и может не помочь при неселективном условии. Если фильтр пропускает почти весь корпус, планировщик может выбрать поиск по векторному индексу с проверкой условия, а не bitmap scan. В PostgreSQL это решение планировщика, в отдельной векторной БД это решение движка. Тебе нужно проверять план и поведение на своих данных, а не считать, что любой индекс всегда ускоряет запрос.
Полный перебор без индекса допустим, когда кандидатов после фильтра немного или когда нужна точная выдача. Для больших коллекций и широких фильтров он становится слишком дорогим. Практическое правило: сначала обеспечь корректную семантику фильтра, затем измерь, где тратится время, и добавляй индекс под конкретные предикаты. Не храни важные для фильтрации поля в произвольном JSON без необходимости: типизированные колонки и продуманные составные индексы обычно понятнее и предсказуемее.
Мультитенантность: две схемы
Первая схема: отдельная коллекция на тенанта. Она дает четкую границу: запрос по умолчанию не видит чужие данные, удаление тенанта сводится к удалению его коллекции, бэкап и восстановление можно делать по тенанту, проще выдать разные настройки индекса или квоты. Но коллекции нужно создавать, мигрировать, обслуживать и отслеживать. При большом числе маленьких тенантов растут накладные расходы и риск упереться в лимиты платформы. Общие операции и поиск сразу по нескольким тенантам усложняются.
Вторая схема: одна коллекция и обязательный фильтр по tenant_id. Она проще в эксплуатации: одна схема, один набор индексов, меньше сущностей для миграций и мониторинга. Но изоляция здесь держится на дисциплине кода. Забыл фильтр в одном эндпоинте, debug-скрипте или фоновой задаче, и получил утечку. Поэтому tenant_id нельзя брать из тела запроса без проверки: он должен приходить из аутентифицированного контекста и подставляться централизованно. Сырые запросы к векторному хранилищу лучше запретить или обернуть в обязательный конструктор. Нужны индекс по tenant_id, негативные тесты на доступ между тенантами и проверка, что фильтр есть в каждом пути выполнения, включая админские и служебные.
Правило выбора:
- Если нужна строгая изоляция, отдельные бэкапы, удаление и квоты по тенанту, а число тенантов обозримо, выбирай коллекцию на тенанта.
- Если тенантов много и они небольшие, а ops-ресурс общий, выбирай
tenant_idв payload, но только с централизованным обязательным фильтром, индексом и тестами на утечку. - Если сомневаешься и тенантов немного, начинай с коллекции на тенанта: она дороже в ops, но уменьшает цену ошибки.
pgvector или отдельная векторная БД
pgvector выбирают, когда данные уже в PostgreSQL. Тогда вектор лежит рядом с бизнес-сущностями, а поиск можно совместить с JOIN, транзакцией и привычными правами доступа. Запись вектора и изменение бизнес-строки происходят в одной транзакции, не нужен отдельный контур синхронизации, бэкап и мониторинг остаются общими. Это хороший вариант, когда векторов немного, нагрузка на поиск не конкурирует с критичным OLTP и отдельного ops-бюджета на новую систему нет. Ограничение в том, что векторный индекс живет в той же базе: тяжелая перестройка или поиск могут влиять на остальные запросы, а набор возможностей ограничен тем, что дает PostgreSQL и pgvector.
Отдельная векторная БД нужна, когда масштаб и профиль нагрузки уже неудобно держать в основной базе. Она дает специализированные индексы, квантование, независимое масштабирование и репликацию поиска, а также позволяет изолировать поисковую нагрузку от транзакционной. Но появляется второй источник данных: нужно синхронизировать изменения, обрабатывать отставание, проектировать компенсацию ошибок, отдельно бэкапить, защищать и наблюдать новую систему. Если эти затраты не оправданы, отдельная БД добавляет сложность без пользы.
Выбор делай не по модности, а по ограничениям: нужна ли транзакционная целостность с бизнес-данными, есть ли JOIN, кто обслуживает систему, как быстро растет корпус и насколько поиск должен быть независим от OLTP. Начни с pgvector, если он естественно ложится на текущую архитектуру. Переходи на отдельную БД, когда появляется измеримая причина: не хватает возможностей индексов, мешает общая нагрузка или нужен отдельный контур масштабирования. Числовых порогов здесь быть не может: они зависят от данных, железа, запросов и SLA.
Отдельная тема, которая всплывает позже всех и бьёт больнее выбора движка: владелец индекса. У встроенных баз (sqlite-vec, zvec и их родни) коллекция открывается процессом, который её держит. Если коллекцию открывает каждый клиент напрямую, любой упавший клиент оставляет индекс заблокированным, и следующий запрос молча деградирует: поиск выглядит пустым, хотя данные на месте. Рабочая схема одна: индекс держит ровно один процесс-сервис, а клиенты ходят к нему по HTTP; existence проверяется по диску, живость сервиса по health-эндпоинту. И с этим же связана тихая подмена бэкенда: детектор, который «проверяет доступность» побочным эффектом открытия коллекции, при падении сервиса уезжает на другой движок или на пустой список вместо внятной ошибки. Проверяй существование чтением каталога, а не открыванием; о недоступности говори явно, а не пустой выдачей.
Практика: векторная БД без Docker и pgvector-схема
Начнем с векторной БД своими руками, без docker и без внешних пакетов. Скрипт ниже хранит векторы в обычном dict, считает косинус через скалярное произведение и фильтрует по payload прямо во время перебора: строки, которые не подошли под фильтр, отбрасываются до подсчета score. Латентность каждого поиска измеряется через time.perf_counter() и печатается в миллисекундах. Эмбеддер здесь hash-эмбеддер embed(text, dim=64): он детерминированный, работает оффлайн и дает одинаковые векторы между запусками, но в продакшене замени его на живой эмбеддер, контракт тот же.
В main() четыре замера на 2000 векторов: k=3 и k=20 без фильтра и с фильтром по tenant_id. Смотреть надо на две вещи. Первая: как меняется латентность при росте k. Полный перебор от k не зависит, дороже становится только сортировка, поэтому разница между k=3 и k=20 небольшая. Вторая: как фильтр уменьшает число кандидатов. Фильтр по одному тенанту оставляет примерно четверть корпуса, и латентность падает. Абсолютные числа на ноутбуке будут в десятые доли миллисекунды, важны не они, а соотношение сценариев.
"""Мини векторная БД на чистом stdlib: оффлайн, без зависимостей.
Запуск: python mini_vector_db.py
"""

import hashlib
import math
import time

# Размерность вектора, в продакшене совпадает с размерностью модели.
DIM = 64
# Размер корпуса и число повторов на один замер.
CORPUS_SIZE = 2000
REPEATS = 7


def embed(text, dim=DIM):
    """Детерминированный hash-эмбеддер для тестов и замеров.
    Для продакшена замените на живой эмбеддер: контракт тот же,
    текст на входе, список float на выходе.
    """
    vector = [0.0] * dim
    for token in text.lower().split():
        # blake2b стабилен между запусками и платформами
        digest = hashlib.blake2b(token.encode("utf-8"), digest_size=8).digest()
        number = int.from_bytes(digest, "big")
        index = number % dim
        sign = 1.0 if (number >> 16) % 2 == 0 else -1.0
        vector[index] += sign
    # После нормировки косинус равен скалярному произведению
    norm = math.sqrt(math.fsum(x * x for x in vector))
    if norm == 0.0:
        return vector
    return [x / norm for x in vector]


def match_filter(payload, payload_filter):
    """Все пары ключ-значение фильтра должны совпасть с payload."""
    for key, expected in payload_filter.items():
        if payload.get(key) != expected:
            return False
    return True


class VectorDB:
    """In-memory векторная БД с полным перебором.
    Хранилище это dict: id -> (вектор, payload).
    """

    def __init__(self, dim=DIM):
        self.dim = dim
        self._rows = {}
        self.last_scanned = 0

    def count(self):
        """Сколько записей сейчас в базе."""
        return len(self._rows)

    def upsert(self, id, vector, payload=None):
        """Вставляет или обновляет запись по id."""
        if len(vector) != self.dim:
            raise ValueError("размерность вектора не совпадает с базой")
        self._rows[id] = (list(vector), dict(payload or {}))

    def search(self, query_vector, k=3, filter=None):
        """Ищет top-k по косинусу, возвращает (результаты, латентность в мс).
        Фильтр по payload применяется внутри цикла, до подсчета score.
        """
        if len(query_vector) != self.dim:
            raise ValueError("размерность запроса не совпадает с базой")
        start = time.perf_counter()
        scored = []
        scanned = 0
        for doc_id, (vector, payload) in self._rows.items():
            scanned += 1
            if filter is not None and not match_filter(payload, filter):
                continue
            # Косинус для нормированных векторов это скалярное произведение
            score = math.fsum(a * b for a, b in zip(query_vector, vector))
            scored.append((score, doc_id, payload))
        scored.sort(key=lambda item: item[0], reverse=True)
        top = [
            {"id": doc_id, "score": score, "payload": payload}
            for score, doc_id, payload in scored[:k]
        ]
        elapsed_ms = (time.perf_counter() - start) * 1000.0
        self.last_scanned = scanned
        return top, elapsed_ms


TENANTS = ("acme", "globex", "initech", "umbrella")
TOPICS = ("billing", "auth", "search", "deploy")


def build_corpus(size=CORPUS_SIZE):
    """Детерминированный корпус: id, текст и payload."""
    rows = []
    for i in range(size):
        tenant = TENANTS[i % len(TENANTS)]
        topic = TOPICS[(i // len(TENANTS)) % len(TOPICS)]
        text = "{} документ {} про {} для {}".format(topic, i, topic, tenant)
        payload = {"tenant_id": tenant, "topic": topic, "doc_id": "doc-{}".format(i)}
        rows.append(("chunk-{}".format(i), text, payload))
    return rows


def load_db(rows, dim=DIM):
    """Считает эмбеддинги и складывает все в VectorDB."""
    db = VectorDB(dim=dim)
    for doc_id, text, payload in rows:
        db.upsert(doc_id, embed(text, dim=dim), payload)
    return db


def measure(db, query_vector, k, payload_filter=None):
    """Повторяет поиск и возвращает лучшую латентность в мс и top."""
    best_ms = None
    top = []
    for _ in range(REPEATS):
        top, latency_ms = db.search(query_vector, k=k, filter=payload_filter)
        if best_ms is None or latency_ms < best_ms:
            best_ms = latency_ms
    return best_ms, top


def main():
    db = load_db(build_corpus())
    print("векторов в базе:", db.count(), "размерность:", db.dim)

    query_vector = embed("billing документ 42 про billing для acme")
    tenant_filter = {"tenant_id": "acme"}
    print("фильтр:", tenant_filter)
    print()

    header = "{:<22}{:>4}{:>12}{:>18}".format(
        "сценарий", "k", "кандидатов", "латентность, мс"
    )
    print(header)
    print("-" * len(header))

    scenarios = (
        ("без фильтра", 3, None),
        ("без фильтра", 20, None),
        ("фильтр tenant_id", 3, tenant_filter),
        ("фильтр tenant_id", 20, tenant_filter),
    )
    for name, k, payload_filter in scenarios:
        latency_ms, top = measure(db, query_vector, k, payload_filter)
        print(
            "{:<22}{:>4}{:>12}{:>18.4f}".format(
                name, k, db.last_scanned, latency_ms
            )
        )
        best = top[0]
        print(
            "    top-1: {} score={:.4f} tenant={}".format(
                best["id"], best["score"], best["payload"]["tenant_id"]
            )
        )

    print()
    print("k меняет только стоимость сортировки, перебор от k не зависит")
    print("фильтр снижает число кандидатов и обычно снижает латентность")
    print("для продакшена замените embed на живой эмбеддер, dict на внешнюю БД")


if __name__ == "__main__":
    main()
Если у тебя уже есть Postgres, это весь код, который нужен: расширение, таблица, два индекса и один запрос. Расширение vector ставится один раз, размерность в vector(96) должна совпадать с моделью эмбеддингов, btree по tenant_id закрывает фильтр, hnsw по embedding закрывает поиск. Ivfflat оставлен закомментированной альтернативой: он дешевле по памяти и быстрее строится, но требует настройки lists. Индексы строй после массовой загрузки, иначе вставки будут медленными.
-- Опциональный блок: нужен Postgres с расширением pgvector.
-- Если Postgres уже есть, дальше вся схема целиком.

CREATE EXTENSION IF NOT EXISTS vector;

-- Чанки. tenant_id обязателен: почти все запросы идут с фильтром по нему.
-- vector(96): размерность должна совпадать с моделью эмбеддингов.
CREATE TABLE IF NOT EXISTS chunks (
    id        bigserial PRIMARY KEY,
    tenant_id text       NOT NULL,
    doc_id    text       NOT NULL,
    title     text,
    content   text       NOT NULL,
    embedding vector(96) NOT NULL
);

-- Btree по тенанту: ускоряет фильтр в WHERE и будущее партиционирование.
CREATE INDEX IF NOT EXISTS chunks_tenant_idx ON chunks (tenant_id);

-- HNSW по косинусу. Строится после загрузки данных, а не до.
CREATE INDEX IF NOT EXISTS chunks_embedding_idx
    ON chunks USING hnsw (embedding vector_cosine_ops);

-- Альтернатива вместо HNSW: ivfflat дешевле по памяти и быстрее строится,
-- но требует настройки lists и дает качество ниже на маленьких таблицах.
-- CREATE INDEX chunks_embedding_ivfflat_idx
--     ON chunks USING ivfflat (embedding vector_cosine_ops) WITH (lists = 100);

-- Поиск top-3 внутри тенанта. <=> это косинусное расстояние, меньше значит ближе.
-- $1 это вектор запроса той же размерности 96, его подставляет драйвер.
SELECT id, doc_id, title, content
FROM chunks
WHERE tenant_id = 'acme'
ORDER BY embedding <=> $1::vector
LIMIT 3;

-- При жестком фильтре по тенанту HNSW может вернуть меньше k строк.
-- Тогда помогает partial index на тенанта или отдельная таблица на тенанта.
В продакшен из скрипта переноси контракт, а не код: upsert по стабильному id, поиск с фильтром внутри запроса, замер латентности на каждом релизе. Само хранилище меняй на БД: dict теряется при рестарте и не переживет второй процесс. В Qdrant это collection и payload filter, в Postgres это таблица и WHERE по tenant_id. Добавь пакетную загрузку через executemany или COPY, вынеси эмбеддинги в отдельный шаг индексации и держи размерность в одном месте конфига. Отдельно проверь, что фильтр по тенанту не ломает recall: при жестких фильтрах HNSW может вернуть меньше k строк, тогда нужен partial index на тенанта или отдельная таблица. И не забудь про гибридный поиск: векторный top-k без лексического поиска плохо ловит точные артикулы и имена.
Лаба: переносим мини-RAG и замеряем латентность
Возьми мини-RAG из m01 и вынеси индекс в класс VectorDB из этого модуля или в таблицу sqlite. У каждого из твоих 20 документов должен быть tenant_id. Загрузи документы один раз, чтобы загрузка не попадала в замер. Для учебного прогона используй hash-эмбеддер, в продакшне замени его на реальную модель.
Прогони те же 5 запросов, что в m01. Сначала замерь наивный поиск: полный проход по списку документов с расчетом сходства. Затем тот же поиск через VectorDB с обязательным фильтром по tenant_id. Время снимай через time.perf_counter() только вокруг этапа поиска. Он включает расчет сходства и фильтрацию, но не включает загрузку документов, чтение ответа и генерацию. Запускай оба варианта в одном процессе, на одном наборе векторов и при одинаковом k. Сделай прогрев, затем одинаковое число повторов и посчитай среднее по своим замерам. Сохрани сырые замеры, чтобы среднее можно было пересчитать.
Отдельно сравни выдачу при k=3 и k=20: какие документы попали в top-k, изменился ли их состав и сохранился ли порядок релевантности. Зафиксируй, влияет ли рост k на latency и не вытесняют ли целевые документы менее релевантные. Если embedding запроса считается отдельно, не включай его в latency поиска, иначе сравнивай одинаковые границы этапа.
Проверь изоляцию: для каждого запроса подставь чужой tenant_id. Каждый такой вызов должен вернуть пустой список, а не документы другого тенанта. Это обязательная проверка фильтра.
В отчете запиши две основные средние цифры: latency наивного поиска и latency VectorDB с фильтром. Укажи число повторов, эмбеддер и способ подсчета среднего. Добавь вывод: изменился ли выбор top-k при переходе от k=3 к k=20, появились ли нерелевантные документы и где фильтрация дала заметную разницу. Критерий выполнения: у тебя есть две цифры латентности из собственных замеров, вывод по top-k и подтверждение, что каждый запрос к чужому тенанту вернул пустой список.
Критерий готовности
- Объясняешь, как параметры
mиefв HNSW влияют на качество, память и скорость поиска. - Проверяешь, что payload-фильтр применяется во время поиска, а не после top-k.
- Запускаешь скрипт с
VectorDBбез docker и внешних пакетов. - Выбираешь между pgvector и отдельной БД по нагрузке, изоляции, фильтрам и стоимости поддержки.
- Снимаешь замеры латентности сам через
time.perf_counter()и сохраняешь условия эксперимента.
Чеклист самопроверки
- Что сломается, если сначала взять top-k, а payload-фильтр применить после?
- Чем ты платишь за рост
efпри неизменномk? - Когда коллекция на тенанта окажется лучше payload-фильтра?
- Почему индекс
ivfflatилиhnswв pgvector не заменяет бизнес-индекс поtenant_id? - Как ты проверишь, что фильтр
tenant_idработает во время поиска, а не отсекает уже найденные документы? - Почему при
k=20средняя latency может вырасти даже без смены индекса?
Материалы главы: текст главы в репо · код · иллюстрации · подписка на обновления курса