Хаб курсов / Курс по RAG / глава 3
Модуль 03: чанкинг и золотой набор для eval
Нарезаем документы на чанки: fixed, recursive, semantic и parent-child. Замеряем влияние стратегии на recall и собираем золотой набор вопросов.
RAG Engineering. Модуль 03: Чанкинг и золотой набор для eval
Почему нарезка решает больше, чем эмбеддер
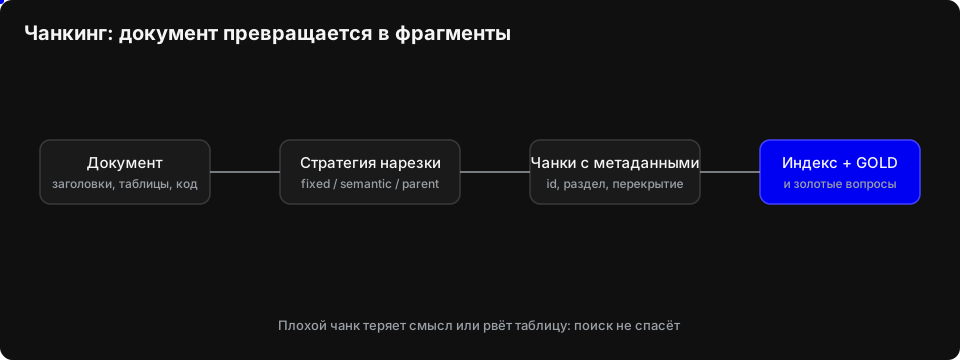
Чанк это одновременно единица поиска и единица цитаты. При поиске система сравнивает эмбеддинг вопроса с эмбеддингами чанков и выбирает лучшие фрагменты. При генерации эти же фрагменты попадают в промпт и становятся основанием для ответа со ссылкой на источник. Если граница чанка проведена неудачно, исправить это хорошим эмбеддером обычно не получится.
Представь, что ответ на вопрос разрезан пополам. В одном чанке осталось условие задачи, во втором результат. Вопрос может быть семантически ближе ко второй половине, поэтому поиск поднимет наверх только её. Генератор получит результат без условия и либо ответит неточно, либо откажется отвечать. Обе половины могли бы оказаться в top-k, но нет гарантии, что они расположатся рядом и попадут в контекст. Особенно плохо, когда модель уверенно цитирует фрагмент, который сам по себе выглядит законченным, но теряет смысл без соседнего текста.
Второй сценарий: чанк теряет контекст. Внутри остаётся фраза «этот параметр увеличивают только при повторной обработке», но пропадает название параметра из предыдущего абзаца. Эмбеддинг такого фрагмента становится размытым, а цитата непонятной. Читатель видит корректную строку, но не понимает, к чему она относится. Для RAG это такой же дефект, как неверный ответ, потому что проверить утверждение по цитате невозможно.
Третий сценарий: в чанк попали два чужих фрагмента. Например, конец раздела про индексацию и начало раздела про безопасность. Эмбеддинг усредняет две темы, поэтому чанк может слабо совпадать с обеими. При этом поиск иногда поднимает его из-за одного удачного слова, а генератор получает смесь контекстов. Ответ становится поверхностным, цитата указывает на слишком широкий кусок, а нужная информация теряется среди посторонней.
Плохая нарезка снижает recall ещё до того, как выбран эмбеддер. Модель не может найти то, чего нет в индексе как осмысленной единицы. Поэтому сначала нужно определить гранулярность смысла, затем выбрать способ деления, и только после этого сравнивать модели эмбеддингов на одном и том же наборе чанков.
Пять стратегий нарезки
-
Fixed-size. Текст режется на блоки фиксированного размера в символах или токенах, часто с перекрытием. Стратегия проста, предсказуема по стоимости и подходит для однородного текста без явной структуры, например для логов или черновых прототипов. Цена: качество границ. Предложения, таблицы и блоки кода рвутся в произвольных местах. Одинаковый размер не означает одинаковую смысловую полноту. Для базовой линии это нормально, для сложной документации обычно недостаточно.
-
Recursive. Сначала текст делится по крупным разделителям, затем по абзацам, предложениям и более мелким единицам, пока фрагмент не поместится в лимит. Это хороший рабочий вариант по умолчанию для статей, инструкций и внутренней документации, где структура есть, но она неидеальна. Цена: зависимость от качества разделителей и эвристик. Длинное рассуждение всё равно может разрезаться, а размеры чанков получаются неравномерными. Стратегия не понимает смысл, она только следует за разметкой и пунктуацией.
-
Semantic. Предложения или небольшие окна превращаются в эмбеддинги, после чего граница ставится там, где близость соседних фрагментов заметно падает. Идея в том, чтобы резать при смене темы. Подходит для связной прозы без надёжной разметки, где важно сохранить смысловые блоки. Цена: дополнительные вычисления, чувствительность к порогу и нестабильность результата. Слишком высокий порог создаёт мелкие чанки, слишком низкий оставляет темы смешанными. Кроме того, смена темы не всегда совпадает с полезной границей для поиска.
-
Document-aware. Нарезка учитывает структуру формата: заголовки Markdown, таблицы, блоки кода, списки, разделы HTML или PDF. Такой подход нужен для технической документации, баз знаний, регламентов и материалов, где структура несёт смысл. Цена: сложность парсинга и поддержка разных форматов. Таблица или код могут не помещаться в лимит, поэтому нужен аккуратный fallback. Нельзя бездумно резать код по символам, а таблицу по строкам без заголовка. Зато цитаты получаются точнее, а метаданные раздела помогают фильтрации.
-
Parent-child. В индекс попадают маленькие дочерние чанки, удобные для точного поиска, а в промпт передаётся большой родительский фрагмент, из которого они получены. Это полезно, когда вопрос требует локальной детали, но ответ нужно давать с широким контекстом. Цена: два уровня хранения, связь между дочерними и родительскими блоками и дополнительный расход контекстного окна. Родитель может содержать шум, а хороший дочерний чанк не гарантирует, что весь родитель релевантен. Нужно ограничивать размер родителя и уметь собирать его без дублей.
Перекрытие
Перекрытие помогает не потерять смысл на стыке. Если важная фраза начинается в конце одного чанка и продолжается в следующем, общий фрагмент даёт хотя бы одному блоку шанс сохранить её целиком. На практике часто берут перекрытие примерно от 10 до 20 процентов размера чанка, но это отправная точка, а не закон. Для коротких предложенческих чанков доля может быть меньше, для длинных абзацев иногда нужен запас побольше.
Слишком большое перекрытие создаёт почти одинаковые чанки. Индекс раздувается, эмбеддинги дублируются, а top-k заполняется вариациями одного и того же места. Падает разнообразие найденных доказательств, растёт стоимость хранения и генерации. Цитаты начинают указывать на несколько пересекающихся фрагментов, и пользователю сложнее понять, какой из них основной. Перекрытие должно закрывать риск разрыва, а не маскировать плохие границы.
Размер чанка и recall
Слишком маленький чанк повышает точность совпадения, но теряет контекст. Вопрос может найти нужную фразу, однако генератор не получит условий, определений или связей. Слишком большой чанк сохраняет контекст, но размывает эмбеддинг: в нём смешиваются несколько тем, и нужный абзац не обязательно поднимется в top-k. Точность цитаты тоже падает, потому что ссылка указывает на большой раздел, а не на конкретное утверждение.
Универсального размера нет. Он зависит от типа документов, длины ответов, формулировки вопросов, свойств эмбеддера, доступного контекстного окна и бюджета индекса. Один и тот же размер по-разному работает для чата поддержки, юридического регламента и справочника API. Настраивать нарезку нужно на золотом наборе вопросов, измеряя recall@10 и проверяя, позволяет ли найденный чанк дать точную цитату.
Два приёма стоят отдельно от выбора размера и перекрытия, потому что меняют сам контекст чанка. Первый: contextual retrieval (Anthropic, сентябрь 2024). Перед индексацией LLM дописывает каждому чанку одно-два предложения о том, где он находится в документе и о чём документ; по публикации Anthropic это снижает долю промахов поиска на десятки процентов, а вместе с реранком сильнее. Цена соответствующая: по вызову генерации на каждый чанк корпуса при индексации, поэтому приём оправдан для дорогих ошибок, а не для всех корпусов подряд. Сложившейся дешёвой практики «сгенерируем контекст локальной моделью за копейки» на 2026 год нет, только туториалы. Второй приём: late chunking (Jina, 2024). Эмбеддер прогоняется по всему документу целиком, а чанковые векторы собираются из токенов уже готового прогона: контекст документа попадает в каждый вектор без дополнительных вызовов LLM. Дешевле и проще contextual retrieval, но требует эмбеддера, который умеет работать с длинным входом. Оба приёма принимай так же, как паттерны из модуля 07: только через замер на золотом наборе.
Что ты построишь
В этом модуле ты соберёшь оффлайн-скрипт на чистом Python, который берёт один корпус и режет его тремя стратегиями. Скрипт построит локальный индекс и посчитает recall@10 по заранее подготовленному золотому набору вопросов. Этот набор ты сформируешь здесь, а затем переиспользуешь в модуле 06 для сквозной оценки всего пайплайна. Главная цель: увидеть, как разные границы чанков меняют находимость доказательств при одном и том же способе сравнения.
Ловушки: таблицы, код, заголовки
Фиксированная нарезка делит текст по символам или токенам и не учитывает структуру документа. Перекрытие чанков немного смягчает проблему, но не восстанавливает потерянный смысл.
Таблицы
Что ломается: строка таблицы без заголовков колонок превращается в набор непонятных значений. Модель видит Иван, 12, да и не знает, что 12 означает срок, количество или номер. Если разрезать таблицу поперек строк, одна часть может содержать шапку и несколько строк, а другая только строки. Вторая часть теряет связь с колонками. Разрыв внутри ячейки или между строкой и ее подписью делает фрагмент еще менее пригодным.
Почему фиксированная нарезка это ломает: размер окна не связан с границами таблицы. Шапка может остаться в предыдущем чанке, а данные в следующем. Перекрытие иногда повторяет шапку, но не гарантирует этого. При изменении длины текста или ширины окна результат снова станет произвольным.
Что делать: определяй таблицы до нарезки и обрабатывай их как отдельные структуры. Сохраняй заголовок таблицы, названия колонок и единицы измерения. Если таблица большая, дели ее по строкам, но повторяй шапку в каждом чанке. Можно преобразовать строки в записи вида колонка: значение и добавить название таблицы. Никогда не режь ячейку или строку пополам.
Код
Что ломается: функция, разрезанная посередине, теряет сигнатуру, отступы и часть тела. Такой фрагмент не компилируется и плохо читается человеком. Модель может принять обрывок за самостоятельный пример и воспроизвести ошибку. Если сигнатура осталась в другом чанке, поиск по имени функции может не найти реализацию.
Почему фиксированная нарезка это ломает: код чувствителен к синтаксическим границам, а окно по символам их не видит. Оно может разрезать условие, аргументы, строковый литерал или блок отступов. Перекрытие не гарантирует сохранение сигнатуры и логической целостности.
Что делать: используй разбиение с учетом языка программирования. Дели код по функциям, классам, методам и другим самостоятельным единицам. В чанк включай сигнатуру, необходимые импорты и пояснение, к какому файлу или модулю относится фрагмент. Для большой функции сохраняй сигнатуру и дели тело по логическим блокам. В тексте чанка полезно указать имя функции и путь к файлу, чтобы поиск работал не только по телу.
Заголовки
Что ломается: чанк без пути заголовков теряет тему. Фраза «требования к срокам» может относиться к договору, отчетности, отпускам или приемке работ. Без родительского раздела модель не понимает контекст и может смешать правила из разных частей документа.
Почему фиксированная нарезка это ломает: заголовок остается в начале документа или раздела, а окно забирает только следующий за ним текст. Чем дальше чанк от заголовка, тем меньше шансов, что тема сохранится. Метаданные документа помогают не всегда: поиск по смыслу опирается прежде всего на текст чанка.
Что делать: приклеивай breadcrumb заголовков к каждому чанку. Например: Договор > Приемка работ > Требования к срокам. Добавляй этот путь в начало текста чанка и дублируй в метаданные. Сохраняй иерархию заголовков, а не только последний заголовок. Для длинных разделов повторяй путь при каждом разбиении.
Списки и сноски
Что ломается: список, разорванный посередине, теряет вводную фразу, нумерацию или последний пункт. Сноска может остаться без текста, а ссылка на нее без пояснения. Модель видит отдельный пункт и не понимает, к чему он относится.
Почему фиксированная нарезка это ломает: окно режет по длине, а не по границам пунктов. Вводная фраза может оказаться в другом чанке, маркер списка потеряться, а ссылка на сноску оторваться от определения.
Что делать: считай список и сноску структурными единицами. По возможности сохраняй вводную фразу и пункты вместе. Если список большой, дели его по пунктам, но повторяй вводную фразу и путь заголовков. Пару «ссылка на сноску» и «текст сноски» держи рядом или разрешай сноски до нарезки. Не разрывай пункт между маркером и содержимым.
Золотой набор вопросов: фундамент для eval
Золотой набор это набор вопросов, для каждого из которых заранее известен список релевантных документов. Он нужен, чтобы измерять качество поиска и чанкинга на одной и той же базе, а не на случайных примерах.
Собирай набор до того, как настраивать размер чанка, перекрытие и другие параметры. Иначе легко подогнать вопросы под уже выбранную нарезку и получить ложное улучшение. Сначала фиксируй вопросы и правильные документы, затем сравнивай варианты чанкинга на одинаковых условиях.
Для старта достаточно десятков вопросов, не тысяч. Небольшой набор проще проверить вручную и быстрее прогонять после каждого изменения. Когда появятся новые реальные обращения, набор можно расширять.
Источники вопросов: реальные тикеты, чаты поддержки и другие запросы пользователей. Они показывают настоящие формулировки и пробелы в документации. Дополнительно можно генерировать вопросы с помощью LLM небольшими порциями, но каждый вопрос и список релевантных документов должен проверить человек. В набор стоит включать разные типы запросов: точные термины, перефразировки, вопросы по таблицам, коду и нескольким документам.
Основная метрика для старта: recall@k. Это доля вопросов, для которых хотя бы один релевантный документ попал в top-k. Считай метрику по вопросам, а не по количеству найденных фрагментов. Если релевантный документ разрезан на части, полезно отдельно смотреть, находится ли нужный фрагмент.
Золотой набор сохраняй в файл, например в JSONL или CSV. Для каждого вопроса храни идентификатор, текст вопроса, список идентификаторов релевантных документов, источник и комментарий проверяющего. Файл держи в репозитории и версионируй вместе с кодом. В модуле 04 на этом наборе сравнивается гибридный поиск, а в модуле 06 через него прогоняется сквозная оценка всего RAG. Один и тот же набор позволяет честно сравнивать изменения между модулями и не начинать оценку заново.
Практика: три стратегии на одном корпусе
Скрипт берёт один и тот же корпус и режет его тремя стратегиями: фиксированными окнами (fixed), рекурсивно по границам структуры (recursive) и рекурсивно, но с перекрытием соседних чанков. Для каждой стратегии он строит индекс на hash-эмбеддере, прогоняет золотой набор запросов GOLD и считает recall@10: попал ли хотя бы один релевантный чанк в топ-10 выдачи.
В выводе смотри на два столбца вместе: число чанков и recall. Рост числа чанков сам по себе ничего не значит, важно, растёт ли при этом recall. Перекрытие почти всегда добавляет чанков, потому что одни и те же куски текста попадают в два соседних чанка, и это допустимо, пока прибавка к recall оправдывает раздутый индекс.
import hashlib
import math
import re


DOCS = [
    {
        "id": "vacation_policy",
        "title": "Регламент отпусков",
        "text": (
            "Каждый сотрудник имеет право на ежегодный оплачиваемый отпуск "
            "продолжительностью двадцать восемь календарных дней. График отпусков "
            "утверждается руководителем подразделения до начала календарного года. "
            "Заявление на отпуск подается не позднее чем за четырнадцать календарных "
            "дней. При необходимости даты можно перенести по согласованию с "
            "руководителем. Неиспользованные дни сохраняются в соответствии с "
            "трудовым законодательством."
        ),
    },
    {
        "id": "vacation_pay",
        "title": "Расчет отпускных",
        "text": (
            "Отпускные рассчитываются исходя из среднего заработка за двенадцать "
            "календарных месяцев, предшествующих месяцу начала отпуска. В расчет "
            "включаются оклад, регулярные премии и иные выплаты, предусмотренные "
            "системой оплаты труда. Выплата производится не позднее чем за три "
            "календарных дня до начала отпуска. При изменении дат отпуска бухгалтерия "
            "пересчитывает сумму. Вопросы по расчету направляйте в бухгалтерию."
        ),
    },
    {
        "id": "vpn_rules",
        "title": "Использование VPN",
        "text": (
            "Корпоративный VPN используется только для служебных задач и доступа к "
            "внутренним ресурсам компании. Подключаться разрешено с рабочих устройств, "
            "прошедших проверку безопасности. Передавать учетные данные и "
            "конфигурационные файлы третьим лицам запрещено. При потере устройства или "
            "подозрении на компрометацию немедленно сообщите в службу безопасности. "
            "Отключайте VPN после завершения работы, если постоянное соединение не "
            "требуется."
        ),
    },
    {
        "id": "vpn_incidents",
        "title": "Инциденты VPN",
        "text": (
            "При невозможности подключения к VPN сначала проверьте интернет-соединение "
            "и актуальность клиента. Если ошибка сохраняется, создайте заявку в "
            "сервис-деске, указав время, устройство и текст сообщения. Не пытайтесь "
            "самостоятельно изменять сертификаты или обходить ограничения. Служба "
            "безопасности анализирует инциденты и уведомляет пользователя о дальнейших "
            "действиях. Критические случаи обрабатываются в приоритетном порядке."
        ),
    },
    {
        "id": "backup_policy",
        "title": "Резервное копирование",
        "text": (
            "Рабочие документы должны храниться в корпоративных сетевых хранилищах, где "
            "резервное копирование выполняется автоматически. Полные копии создаются "
            "ежедневно, а проверка восстановления проводится не реже одного раза в "
            "квартал. Локальные копии на ноутбуках не считаются надежным способом "
            "сохранения данных. При обнаружении потери файлов необходимо обратиться в "
            "сервис-деск и указать путь, дату и время последнего изменения."
        ),
    },
    {
        "id": "access_policy",
        "title": "Управление доступами",
        "text": (
            "Доступ к информационным системам предоставляется по принципу минимально "
            "необходимых прав. Заявка на новый доступ согласуется с руководителем и "
            "владельцем системы. Права пересматриваются при смене должности, переводе в "
            "другое подразделение и увольнении. Использовать чужие учетные записи "
            "запрещено. Пароли должны быть уникальными и надежными, а многофакторная "
            "аутентификация обязательна для критичных сервисов."
        ),
    },
    {
        "id": "travel_policy",
        "title": "Командировки",
        "text": (
            "Командировка оформляется на основании служебного задания и приказа "
            "руководителя. До поездки сотрудник согласует даты, маршрут и бюджет с "
            "непосредственным руководителем. Авансовый отчет и подтверждающие документы "
            "необходимо предоставить в бухгалтерию в течение пяти рабочих дней после "
            "возвращения. Суточные выплачиваются за каждый день командировки. Изменение "
            "маршрута допускается только по согласованию."
        ),
    },
    {
        "id": "travel_expenses",
        "title": "Расходы в командировке",
        "text": (
            "В командировке оплачиваются проезд, проживание и суточные в пределах "
            "утвержденных норм. Дополнительные расходы требуют предварительного "
            "согласования с руководителем. Сохраняйте чеки, билеты и счета: без "
            "подтверждающих документов компенсация не производится. Корпоративная "
            "банковская карта используется только для служебных целей. При утере карты "
            "или документов сразу уведомите бухгалтерию и руководителя."
        ),
    },
]


GOLD = [
    (
        "За сколько дней нужно подать заявление на ежегодный отпуск?",
        ["vacation_policy"],
    ),
    (
        "Как рассчитываются отпускные и когда их выплачивают?",
        ["vacation_pay"],
    ),
    (
        "Можно ли передавать коллегам конфигурацию корпоративного VPN?",
        ["vpn_rules"],
    ),
    (
        "Что делать при потере рабочих файлов и как часто создаются резервные копии?",
        ["backup_policy"],
    ),
    (
        "Как получить доступ к информационной системе и кто его согласует?",
        ["access_policy"],
    ),
    (
        "Какие документы нужны для отчета по командировочным расходам?",
        ["travel_expenses", "travel_policy"],
    ),
]


def chunk_fixed(text, size=160):
    if size <= 0:
        raise ValueError("size должен быть больше нуля")
    return [text[start:start + size] for start in range(0, len(text), size)]


def chunk_recursive(text, size=200):
    if size <= 0:
        raise ValueError("size должен быть больше нуля")

    chunks = []
    current = ""
    paragraphs = re.split(r"\n\s*\n", text)

    for paragraph in paragraphs:
        paragraph = paragraph.strip()
        if not paragraph:
            continue

        sentences = re.split(r"(?<=[.!?])\s+", paragraph)

        for sentence in sentences:
            sentence = sentence.strip()
            if not sentence:
                continue

            if len(sentence) > size:
                if current:
                    chunks.append(current)
                    current = ""
                for start in range(0, len(sentence), size):
                    chunks.append(sentence[start:start + size])
                continue

            candidate = sentence if not current else current + " " + sentence
            if len(candidate) <= size:
                current = candidate
            else:
                chunks.append(current)
                current = sentence

    if current:
        chunks.append(current)

    return chunks


def chunk_overlap(text, size=160, overlap=40):
    if size <= 0:
        raise ValueError("size должен быть больше нуля")
    if overlap < 0 or overlap >= size:
        raise ValueError("overlap должен быть от 0 до size - 1")

    if not text:
        return []

    step = size - overlap
    chunks = []

    for start in range(0, len(text), step):
        chunk = text[start:start + size]
        if chunk:
            chunks.append(chunk)
        if start + size >= len(text):
            break

    return chunks


def embed(text, dim=64):
    # для продакшена замените на живой эмбеддер, hash-версия чтобы код бежал оффлайн
    vector = [0.0] * dim
    tokens = re.findall(r"[a-zа-яё0-9]+", text.lower())

    for token in tokens:
        digest = hashlib.sha256(token.encode("utf-8")).digest()
        bucket = int.from_bytes(digest[:8], "big") % dim
        vector[bucket] += 1.0

    norm = math.sqrt(sum(value * value for value in vector))
    if norm > 0:
        vector = [value / norm for value in vector]

    return vector


def search(chunks, query, k=10):
    query_vector = embed(query)
    scored = []

    for index, chunk in enumerate(chunks):
        text = chunk["text"] if isinstance(chunk, dict) else chunk
        chunk_vector = embed(text)
        score = sum(
            query_value * chunk_value
            for query_value, chunk_value in zip(query_vector, chunk_vector)
        )
        scored.append((score, index, chunk))

    scored.sort(key=lambda item: (-item[0], item[1]))
    return [item[2] for item in scored[:k]]


def recall_at_k(found_doc_ids, relevant_ids):
    return 1.0 if set(found_doc_ids).intersection(relevant_ids) else 0.0


def main():
    strategies = [
        ("fixed", lambda text: chunk_fixed(text, size=160)),
        ("recursive", lambda text: chunk_recursive(text, size=200)),
        ("overlap", lambda text: chunk_overlap(text, size=160, overlap=40)),
    ]

    rows = []

    for strategy_name, chunker in strategies:
        chunks = []

        for doc in DOCS:
            for piece in chunker(doc["text"]):
                chunks.append({
                    "doc_id": doc["id"],
                    "text": piece,
                })

        recall_values = []

        for question, relevant_ids in GOLD:
            found = search(chunks, question, k=10)
            found_doc_ids = [
                item["doc_id"] if isinstance(item, dict) else item
                for item in found
            ]
            recall_values.append(recall_at_k(found_doc_ids, relevant_ids))

        average_recall = sum(recall_values) / len(recall_values)
        rows.append((strategy_name, len(chunks), average_recall))

    print(f"{'стратегия':<12} | {'чанков':>7} | {'recall@10':>9}")
    print("-" * 36)

    for strategy_name, chunk_count, average_recall in rows:
        print(
            f"{strategy_name:<12} | {chunk_count:>7} | "
            f"{average_recall:>9.2f}"
        )


if __name__ == "__main__":
    main()
Граница у recursive-резки грубая: если фрагмент без точек и абзацев длиннее лимита, он режется по счёту символов и слово может оказаться разрезанным пополам. На регламентах это редкость, а на логах и коде с длинными строками вылезает регулярно: ломаный токен перестаёт совпадать с запросом и чанк теряется на ровном месте. Жёсткий рез это деградация, а не ошибка, но знать о ней стоит до того, как корпус окажется машинным.
Не жди от hash-эмбеддера семантики: он разводит тексты только по совпадению токенов, поэтому абсолютные цифры здесь не главное. На маленьком корпусе recall@10 легко оказывается единицей: топ-10 покрывает добрую половину всех чанков. Поэтому рядом стоит посмотреть и recall@5: именно верх выдачи попадает в промпт. В этом прогоне перекрытие добавило восемь чанков и уронило recall@5: дубли заняли место полезных фрагментов. Сравнивай стратегии относительно друг друга на своём корпусе, а не с ожиданиями от живого эмбеддера.
Золотой набор держи в отдельном файле, например в JSONL, а не только в списке GOLD внутри скрипта: этот же файл переиспользуется дальше в курсе, в модуле 04 он нужен для сравнения плотного поиска с гибридным, а в модуле 06 на нём строится сквозная оценка всего пайплайна. Держи разметку золотого набора в одном месте и не размножай её по модулям, иначе метрики перестанут быть сопоставимыми.
Лаба: две стратегии на своих данных
Возьми 5-10 своих реальных документов: регламенты, заметки, тикеты. Положи их в DOCS. Не подбирай только удобные файлы. В корпусе должны быть хотя бы один список, одна таблица и один длинный раздел с заголовками.
Собери golden.json из 5 вопросов. Для каждого укажи question и relevant_doc_ids, то есть документы, где действительно есть ответ. Формулируй вопросы как пользователь, а не как поисковик. Добавь вопрос, где ответ размазан по абзацу, вопрос, где важен заголовок, и вопрос, где ответ находится в таблице.
Скрипт модуля сравнивает три стратегии и считает recall@10; чтобы получить recall@5, достаточно уменьшить k до 5. В этой лабе сосредоточься на двух: например fixed против recursive или recursive с перекрытием против recursive без перекрытия. Скопируй скрипт из модуля в файл chunking_compare.py, подставь в DOCS свои документы и в GOLD свои вопросы, затем запусти:
# Сравнение стратегий чанкинга на своих документах.
python chunking_compare.py
Скрипт работает на чистом Python stdlib оффлайн, внешние пакеты не нужны. В нём используется hash-эмбеддер; для продакшена замени его на живой эмбеддер.
recall@10 считай так: доля вопросов, где хотя бы один релевантный чанк попал в топ-10. Смотри и на итоговое число, и на провалы по отдельным вопросам.
Заполни таблицу:
| Вопрос | Победившая стратегия | Причина |
|---|---|---|
| 1 | ||
| 2 | ||
| 3 | ||
| 4 | ||
| 5 |
Для каждого вопроса письменно объясни разницу. Ответ разрезан границей чанка? Потерялся заголовок, который задавал смысл? Перекрытие спасло нужный фрагмент? Стратегия проиграла из-за слишком мелких чанков или из-за того, что таблица попала в середину окна? Если стратегии сравнялись, так и напиши и объясни почему.
Критерий выполнения: заполненная таблица «вопрос / победившая стратегия / причина» и один абзац вывода. В выводе скажи, какую стратегию берёшь для своего корпуса и почему. Опирайся на свои документы и свои ошибки, а не на общие обещания.
Критерий готовности
- Назови пять стратегий чанкинга и случаи, когда какую выбирать.
- Объясни, почему таблицу и код нельзя резать поперёк, и покажи это на своём документе.
- Собери золотой набор из 5 вопросов с релевантными документами и сохрани его для модулей 04 и 06.
- Запусти скрипт сравнения минимум на двух стратегиях без внешних пакетов.
- Замерь
recall@10на двух стратегиях и объясни разницу на конкретных вопросах.
Чеклист самопроверки
- Почему размер чанка это компромисс между recall и точностью цитаты?
- Что ломается, если резать таблицу фиксированным окном?
- Зачем parent-child держит большой родительский чанк?
- Сколько вопросов хватит для стартового золотого набора и откуда их брать?
- Что даёт перекрытие чанков и чем плох избыток перекрытия?
Материалы главы: текст главы в репо · код · иллюстрации · подписка на обновления курса