Хаб курсов / Курс по RAG / глава 4
Модуль 04: гибридный поиск, BM25, dense и RRF
Строим гибридный поиск: BM25 для точных терминов, dense для смысла, слияние через RRF. Сценарий, где плотный поиск даёт ноль, а гибрид находит документ.
RAG Engineering. Модуль 04: Гибридный поиск: BM25, dense и RRF
BM25: почему лексический поиск до сих пор жив
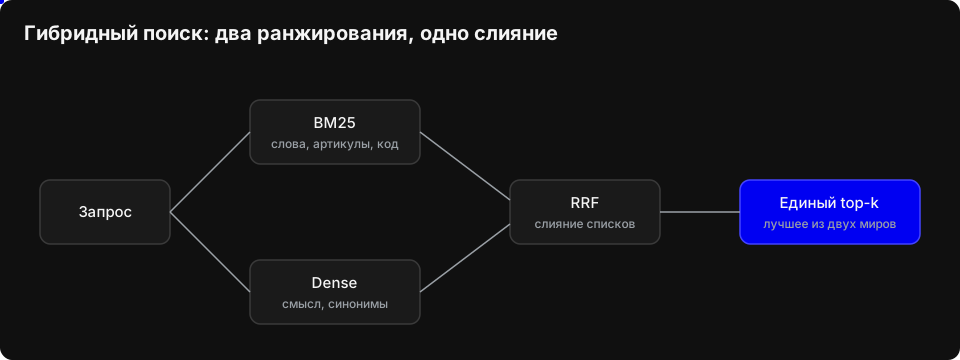
BM25 это способ ранжировать документы по точному совпадению терминов. Его часто называют улучшенным tf-idf, и это полезное сравнение. Как и tf-idf, BM25 повышает вес термина, который часто встречается в документе, но редко встречается во всём корпусе. Но в отличие от простого tf-idf, BM25 аккуратнее обращается с повторами и длиной документа.
Разберём три части формулы.
Первая часть отвечает за частоту термина в документе, tf. Если слово встретилось один раз, это важно. Если десять раз, это уже не в десять раз важнее. BM25 насыщает частоту: сначала рост веса заметный, потом всё меньше. Документ не получает бесконечное преимущество только потому, что автор много раз повторил один и тот же термин.
За насыщение отвечает параметр k1. Чем меньше k1, тем быстрее наступает насыщение: после нескольких повторов термин почти перестаёт увеличивать вес. Чем больше k1, тем дольше частота термина продолжает влиять на оценку. Грубо говоря, k1 определяет, насколько сильно BM25 реагирует на повторные упоминания.
Вторая часть это нормализация длины документа. Длинный документ чаще содержит нужный термин просто потому, что в нём больше слов. Без поправки он получал бы несправедливое преимущество. Параметр b управляет силой этой нормализации. При b = 0 длина документа не учитывается. При b = 1 нормализация применяется полностью. Обычно b выбирают между этими крайними значениями.
Третья часть это IDF, обратная частота документа. Термин, который встречается почти везде, плохо отличает документы друг от друга. Термин, который встречается редко, наоборот, становится сильным сигналом. Если запрос содержит редкий артикул, IDF этого артикула будет высоким, и документ с точным совпадением получит заметный бонус.
Упрощённо оценку можно записать так:
score(q, d) = sum по t из q:
    IDF(t) * tf(t, d) /
    (tf(t, d) + k1 * (1 - b + b * len(d) / avg_len))
Здесь q это запрос, d это документ, tf(t, d) это частота термина t в документе, len(d) это длина документа, а avg_len это средняя длина документа в корпусе. Формула выглядит компактно, но за ней стоят три понятные идеи: насыщение частоты, поправка на длину и цена редкости термина.
BM25 обычно считают по инвертированному индексу. Для каждого термина хранится список документов, где он встречается, и статистика по корпусу. Поэтому лексический поиск не требует эмбеддера. Ему нужны токенизация, нормализация терминов и корпусная статистика.
С точки зрения векторов BM25 можно представить как разреженный, или sparse, вектор. Его размер соответствует словарю корпуса. Почти все позиции в нём нулевые. Ненулевые позиции соответствуют терминам, которые есть в документе или запросе. Значение в позиции отражает вклад термина в оценку. Запрос тоже можно представить таким разреженным вектором, и тогда сравнение сводится к пересечению ненулевых позиций.
Dense-вектор устроен иначе. У него фиксированная размерность, и почти каждая координата получает некоторое число. Такие векторы пытаются расположить близкие по смыслу тексты рядом. У sparse-вектора смысловых соседей нет. Есть точные термины и их веса. Поэтому sparse-поиск хорошо находит документ, где написано именно CONF-2024-118, но не обязан находить документ, где тот же смысл выражен другими словами.
Для sparse-поиска не нужен эмбеддер, потому что веса можно вычислить напрямую из терминов, частот и статистики корпуса. Это делает BM25 дешёвым, предсказуемым и удобным для точных совпадений. Он не заменяет смысловой поиск, но закрывает те случаи, где смысловой поиск теряет важные детали.
Когда dense проигрывает
Dense-поиск силён там, где нужно понять смысл. Но у него есть слабое место: он сжимает текст в вектор фиксированной размерности. Чем более уникален токен, тем меньше у модели возможности выучить для него отдельное устойчивое представление. В результате редкий идентификатор может раствориться среди подслов, соседних токенов и общего смысла фразы.
Первый типичный случай это артикулы и номера. Запрос CONF-2024-118 требует найти именно этот номер, а не конференцию похожего масштаба и не документ за другой год. Эмбеддер может разбить строку на части, потерять разделители или приблизить её к другому номеру. BM25 при разумной токенизации видит точный термин, а высокий IDF делает его особенно ценным.
Второй случай это идентификаторы ошибок. Например, в документации есть код ошибки, и пользователь ищет именно его. Для dense такой код часто является шумом: он редкий, плохо представлен в обучающих данных и не имеет богатого смыслового окружения. Для BM25 это наоборот золото: точное совпадение редкого токена резко поднимает нужный документ.
Третий случай это код и имена функций. parse_config, retry_request, UserRepository или имя параметра должны находиться как строки, а не как общая тема про конфигурацию и запросы. Dense может вернуть документ про работу с конфигами, но пропустить страницу с нужной функцией. Лексический поиск сохраняет точность имени.
Четвёртый случай это редкие фамилии. Если в корпусе есть сотрудник или автор с необычной фамилией, эмбеддер может не иметь для неё хорошего представления. BM25 не должен «понимать» фамилию. Ему достаточно увидеть точное совпадение и учесть её редкость через IDF.
Пятый случай это точные формулировки из регламента. Пользователь может искать фразу, которая должна встретиться дословно: название процедуры, пункт правила, юридическую формулировку. Dense-поиск вернёт много семантически близких документов, но не обязательно тот, где есть нужная формулировка. BM25 находит совпадение по терминам и лучше держит точность.
Общее правило простое: редкий токен это шум для эмбеддера и золото для BM25. Эмбеддеру важнее общий смысл, а BM25 важнее точная строка. Поэтому идентификаторы, коды, имена и цитаты стоит искать лексически.
Но есть и обратная ситуация. Пользователь спрашивает «как вернуть деньги», а в документе написано «возврат средств». Общих терминов почти нет, и BM25 может не найти документ или поставить его низко. Dense-поиск справляется лучше, потому что сравнивает не строки, а смысловые представления. То же происходит с синонимами, перефразировками и вопросами, где слова запроса не повторяют слова документа.
Морфологическая нормализация помогает BM25 с формами слов, но не решает проблему синонимов полностью. Если в запросе и документе нет общих нормализованных терминов, лексический сигнал слабеет. Здесь нужен dense или другой механизм расширения запроса.
Вывод: dense и BM25 это не конкуренты, а пара. Dense отвечает за смысл и перефразировки. BM25 отвечает за точные термины, идентификаторы и редкие строки. Если объединить их результаты, можно закрыть слабые места каждого способа.
Между BM25 и dense есть третий класс: learned sparse. Идея: sparse-вектор, как у BM25, но веса и словарь обучены на корпусе, поэтому синонимы и формы слов расширяют представление без потери точных терминов. Практика 2026: SPLADE-семейство (актуальная модель naver/splade-v3) даёт сильный сигнал, но лицензия у неё некоммерческая, поэтому в проде чаще берут открытые аналоги из fastembed или sparse-выход мультиязычных моделей вроде BGE-M3, у которой dense и sparse считаются одним прогоном. Векторные БД поддерживают такой формат нативно: у Qdrant есть sparse-векторы и готовый BM25 через fastembed, у zvec sparse-поиск встроен в библиотеку. В гибриде learned sparse встаёт на место BM25 в том же RRF: лексический сигнал становится умнее, механика слияния не меняется. Для учебного пайплайна обычного BM25 достаточно; learned sparse это апгрейд, который принимается через замер, как всё остальное в этом курсе.
Что ты построишь
Ты напишешь оффлайн-скрипт на чистом Python stdlib, который загрузит корпус и золотой набор вопросов из модуля 03. Скрипт посчитает три ранжирования: BM25, dense-поиск на hash-эмбеддере и слияние через RRF. Для каждого вопроса он сравнит recall@5 трёх способов и покажет, где лексический сигнал спасает провал dense. В конце ты получишь таблицу, по которой увидишь, где добавил ценность лексический сигнал, где dense остался сильнее и что дало слияние.
RRF: слияние списков без подгонки скоров
BM25 выдает безразмерные скоры, часто в десятках. Косинусная близость лежит от минус единицы до единицы. Складывать такие значения напрямую нельзя: один ретривер начнет доминировать не потому, что лучше ранжирует, а потому, что у него другая шкала.
Есть два подхода. Первый: нормализовать скоры, например через min-max или z-score, и затем сложить. Способ простой, но хрупкий. Границы и распределение зависят от корпуса, запроса и конкретной выдачи. Один выброс может сжать остальные значения. После смены индекса или модели нормализацию приходится пересматривать. Второй: сливать документы по рангам. Он игнорирует абсолютные значения скоров и использует только порядок документов в каждом списке. Для этого и нужен Reciprocal Rank Fusion, или RRF.
Формула:
score(d) = Σ по спискам 1 / (k + rank(d))
Здесь rank(d) это позиция документа в конкретном списке, причем нумерация начинается с 1. Если документа нет в списке, этот список не дает вклада. k обычно берут равным 60. Это общепринятая практика, а не результат универсального бенчмарка.
Интуиция простая. Документ, который находится высоко в обоих списках, получает сумму двух больших вкладов. Документ наверху только одного списка получает один большой вклад и, возможно, небольшой вклад от низкой позиции во втором списке. Документ, который есть лишь в одном списке и находится там низко, получает мало. Поэтому RRF поощряет согласие между ретриверами.
Параметр k сглаживает разницу между верхними позициями. При k=60 вклады за первое и второе место отличаются слабо: 1/61 и 1/62. Чем больше k, тем меньше преимущество конкретной верхней позиции и тем важнее сам факт присутствия документа в нескольких списках. Чем меньше k, тем сильнее доминируют первые места. Это не абсолютная настройка: k подбирают под данные и проверяют на валидации.
Мини-пример. Пусть BM25 вернул порядок A, B, C, а векторный поиск вернул B, D, A. Берем k=60 и считаем вклады.
| Документ | Ранг BM25 | Ранг вектора | RRF |
|---|---|---|---|
| A | 1 | 3 | 1/61 + 1/63, около 0,0323 |
| B | 2 | 1 | 1/62 + 1/61, около 0,0325 |
| C | 3 | нет | 1/63, около 0,0159 |
| D | нет | 2 | 1/62, около 0,0161 |
Итоговый порядок: B, A, D, C. Документы A и B присутствуют в обоих списках и получают по два вклада. B чуть выше, потому что занимает первое и второе места, а A первое и третье. D обходит C, хотя есть только в одном списке: второе место в векторном поиске дает вклад больше, чем третье место BM25.
Что настраивать на практике. Во-первых, веса списков, если один источник важнее. Взвешенный вариант выглядит так:
score(d) = Σ по спискам w(список) / (k + rank(d))
Вес умножает вклад каждого списка. Если BM25 важнее, его вес делают больше единицы, а вес векторного поиска меньше. Но веса нужно проверять на валидации, а не выбирать только по интуиции. Во-вторых, k. Меньшее значение делает fusion более агрессивным к верхним позициям, большее значение сглаживает ранжирование. Менять k и веса одновременно без фиксации остальных параметров плохо: будет непонятно, что дало эффект.
Самая частая ошибка - сливать списки после слишком ранней отсечки. Нельзя брать по три документа из каждого ретривера, а потом удивляться, что хороший кандидат потерян. Документ может быть четвертым в BM25 и первым в векторном поиске. Если BM25 обрезан до третьего места, RRF уже не увидит сильную позицию из второго списка. Слияние нужно делать на достаточно глубоком пуле кандидатов: сначала получить объединение документов из обоих ретриверов, затем посчитать RRF и только после этого применять финальную отсечку. Глубина должна покрывать ожидаемое пересечение списков, а не только несколько верхних строк.
Вторая ошибка - пытаться сравнивать или усреднять сырые скоры перед RRF. RRF работает с рангами, поэтому нормализация ему не нужна. Если ты сначала нормализуешь скоры, а потом ещё и применяешь RRF, ты смешиваешь два разных подхода и теряешь главное преимущество rank fusion.
Третья ошибка - забыть про идентичность документов. Один и тот же чанк может прийти из разных источников с разными идентификаторами. Перед слиянием нужен стабильный ключ, иначе документ получит два независимых места в одном списке и необоснованно усилит себя. Ещё определи правило разрешения ничьих, например по лучшей позиции в любом списке, чтобы итоговый порядок был воспроизводимым.
RRF не восстанавливает полезную информацию о силе скора. Если ретривер уверенно отделяет первый документ от второго, RRF эту разницу сгладит. Зато он устойчив к разным шкалам, не требует калибровки и хорошо работает как простой базовый способ объединить BM25 и векторный поиск.
Практика: BM25 плюс dense плюс RRF
Скрипт практики устроен просто и умышленно наивно, чтобы ты видел каждый слой отдельно. Сначала ты собираешь наивный BM25: считаешь частоты токенов по документам, IDF и скор запроса без внешних библиотек поиска. Затем делаешь dense-поиск на hash-эмбеддере: хешируешь токены в фиксированное число измерений, складываешь векторы документов и вектор запроса, сравниваешь их по косинусу или скалярному произведению. После этого сливаешь два ранжирования через RRF: каждому документу даёшь вклад по обратному рангу в обоих списках и складываешь вклады. В конце скрипт сравнивает recall@5 для BM25, для dense и для RRF на золотом наборе, где для каждого вопроса размечен правильный документ, и печатает таблицу.
Смотреть в этой таблице нужно на расхождения, а не на средние. Особенно интересны вопросы, где способы расходятся. На живом эмбеддере dense часто промахивается на артикулах: редкий идентификатор плохо представлен в векторном пространстве, и близкими по косинусу оказываются документы похожей тематики без нужного номера. BM25 в этом случае выигрывает точным совпадением токена: артикул редкий, IDF у него высокий, и документ с ним поднимается наверх. В нашем прогоне на hash-эмбеддере артикул нашёлся всеми тремя способами: токенизация сохраняет REG-2024-118 целиком, и hash-эмбеддер ловит точное совпадение так же, как BM25. Зато на вопросе про отпуск dense дал 0.00, а RRF вытащил правильный документ из BM25-списка. Смотри на оба типа строк: где слияние спасает провал одного из способов и где все три согласны. Так ты на живом примере видишь, зачем вообще нужен гибрид.
import hashlib
import math
import re


def tokenize(text):
    return re.findall(r"[а-яё0-9a-z-]+", (text or "").lower())


def bm25_search(docs, query, k):
    k1 = 1.5
    b = 0.75
    n = len(docs)
    if n == 0:
        return []

    tokenized = []
    for d in docs:
        tokens = tokenize(str(d.get("title", "")) + " " + str(d.get("text", "")))
        tokenized.append(tokens)

    dlen = [len(t) for t in tokenized]
    avglen = sum(dlen) / n if n else 0.0

    df = {}
    for tokens in tokenized:
        for term in set(tokens):
            df[term] = df.get(term, 0) + 1

    q_terms = tokenize(query)
    scores = {}
    for i, d in enumerate(docs):
        tf_counts = {}
        for term in tokenized[i]:
            tf_counts[term] = tf_counts.get(term, 0) + 1
        score = 0.0
        for term in q_terms:
            if term not in df:
                continue
            tf = tf_counts.get(term, 0)
            if tf == 0:
                continue
            idf = math.log((n - df[term] + 0.5) / (df[term] + 0.5) + 1.0)
            denom = tf + k1 * (1.0 - b + b * (dlen[i] / avglen if avglen else 0.0))
            score += idf * (tf * (k1 + 1.0) / denom)
        scores[d["id"]] = score

    # нулевой скор это отсутствие пересечений: такие документы не выдаём,
    # иначе мусорный запрос получает произвольную выдачу с рейтингом
    ranked = sorted(
        ((doc_id, s) for doc_id, s in scores.items() if s > 0.0),
        key=lambda x: (-x[1], str(x[0])),
    )
    return [doc_id for doc_id, _ in ranked[:k]]


def embed(text, dim=64):
    # для продакшена замените на живой эмбеддер
    vec = [0.0] * dim
    for token in tokenize(text):
        digest = hashlib.sha256(token.encode("utf-8")).digest()
        bucket = int.from_bytes(digest[:8], "big") % dim
        sign = 1.0 if digest[8] % 2 == 0 else -1.0
        vec[bucket] += sign
    norm = math.sqrt(sum(x * x for x in vec))
    if norm > 0.0:
        vec = [x / norm for x in vec]
    return vec


def dense_search(docs, query, k):
    q_vec = embed(query)
    scored = []
    for d in docs:
        text = str(d.get("title", "")) + " " + str(d.get("text", ""))
        d_vec = embed(text)
        dot = sum(a * b for a, b in zip(q_vec, d_vec))
        scored.append((d["id"], dot))
    scored.sort(key=lambda x: (-x[1], str(x[0])))
    return [doc_id for doc_id, _ in scored[:k]]


def rrf_fuse(list_a, list_b, k_rrf=60):
    scores = {}
    for rank, doc_id in enumerate(list_a, start=1):
        scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k_rrf + rank)
    for rank, doc_id in enumerate(list_b, start=1):
        scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k_rrf + rank)
    ranked = sorted(scores.items(), key=lambda x: (-x[1], str(x[0])))
    return [doc_id for doc_id, _ in ranked]


DOCS = [
    {
        "id": "vacation",
        "title": "Регламент об отпусках",
        "text": "Каждый сотрудник имеет право на ежегодный оплачиваемый отпуск продолжительностью 28 календарных дней. График отпусков утверждается до 15 декабря на следующий год. Заявление подается не позднее чем за 14 дней до начала отдыха через HR-портал. Перенос допускается по согласованию с руководителем."
    },
    {
        "id": "vacation_pay",
        "title": "Расчет отпускных",
        "text": "Отпускные рассчитываются исходя из среднего дневного заработка за последние 12 месяцев. Выплата производится не позднее чем за три календарных дня до начала отпуска. Если срок нарушен, работодатель обязан выплатить компенсацию за задержку. Больничный в период отпуска продлевает отдых."
    },
    {
        "id": "vpn",
        "title": "Регламент доступа к VPN",
        "text": "Доступ к корпоративной сети извне предоставляется только через VPN. Заявку оформляют в сервис-деске, указывая обоснование и срок. Пароль меняется каждые 90 дней, многофакторная аутентификация обязательна. Запрещено передавать ключи и подключаться с личных устройств без согласования с ИБ."
    },
    {
        "id": "vpn_incidents",
        "title": "Порядок обработки инцидентов VPN",
        "text": "При недоступности VPN или массовых ошибках подключения необходимо немедленно создать инцидент в сервис-деске с пометкой «VPN-инцидент». Указывают время, площадку и коды ошибок. Дежурный инженер эскалирует проблему в ИБ и сетевую команду в течение 15 минут."
    },
    {
        "id": "backups",
        "title": "Регламент резервного копирования",
        "text": "Резервное копирование критичных систем выполняется ежедневно в 02:00, полные копии каждое воскресенье. Срок хранения инкрементальных копий 30 дней, полных 12 месяцев. Восстановление проверяется ежеквартально. Запрос на восстановление подается через сервис-деск с указанием даты."
    },
    {
        "id": "access",
        "title": "Регламент управления доступами",
        "text": "Доступ к информационным системам предоставляется по принципу минимально необходимых прав. Заявка согласуется с руководителем и владельцем системы. При переводе или увольнении права пересматриваются в течение одного рабочего дня. Пароли запрещено передавать коллегам."
    },
    {
        "id": "trips",
        "title": "Регламент командировок",
        "text": "Служебная командировка оформляется не позднее чем за пять рабочих дней до выезда. Суточные выплачиваются за каждый день поездки, включая выходные. Билеты и проживание бронируются через корпоративный портал. Отчет о командировке сдается в течение трех дней после возвращения."
    },
    {
        "id": "expenses",
        "title": "Регламент компенсации расходов",
        "text": "Компенсация расходов производится при наличии подтверждающих документов. Авансовый отчет подается в течение пяти рабочих дней. Лимит на такси в городе 1500 рублей за поездку. Представительские расходы согласуются заранее с финансовым директором."
    },
    {
        "id": "reg2024",
        "title": "Регламент REG-2024-118",
        "text": "Регламент REG-2024-118 устанавливает единый порядок согласования внутренних документов. Он вступает в силу с 1 января 2025 года. Ответственный за исполнение : отдел внутреннего контроля. Изменения вносятся приказом руководителя, а нарушения фиксируются в журнале."
    }
]


GOLD = [
    ("Сколько дней ежегодного отпуска и за сколько подать заявление?", ["vacation"]),
    ("Как подключиться к корпоративной сети извне и что для этого нужно?", ["vpn"]),
    ("Как часто выполняется резервное копирование и сколько хранятся копии?", ["backups"]),
    ("Как получить доступ к информационной системе и кто согласует?", ["access"]),
    ("Как оформляется командировка и в какой срок сдать отчёт?", ["trips"]),
]

ART_Q = "Что устанавливает регламент REG-2024-118?"
ART_REL = ["reg2024"]

def main():
    sums = [0.0, 0.0, 0.0]

    for q, rel in GOLD:
        b = bm25_search(DOCS, q, 10)
        d = dense_search(DOCS, q, 10)
        r = rrf_fuse(b, d)

        rb = len(set(rel) & set(b[:5])) / len(rel)
        rd = len(set(rel) & set(d[:5])) / len(rel)
        rr = len(set(rel) & set(r[:5])) / len(rel)

        sums[0] += rb
        sums[1] += rd
        sums[2] += rr

        print(f"{q}")
        print(f"  recall@5 bm25={rb:.2f} dense={rd:.2f} rrf={rr:.2f}")

    n = len(GOLD)
    print(f"\nСредние recall@5: bm25={sums[0]/n:.2f} dense={sums[1]/n:.2f} rrf={sums[2]/n:.2f}")

    # top-1 для артикульного вопроса: где точный редкий токен решает
    tb = bm25_search(DOCS, ART_Q, 1)[0]
    td = dense_search(DOCS, ART_Q, 1)[0]
    tr = rrf_fuse(bm25_search(DOCS, ART_Q, 10), dense_search(DOCS, ART_Q, 10))[0]
    print(f"Артикульный вопрос: top-1 bm25={tb} dense={td} rrf={tr}")

if __name__ == '__main__':
    main()
Читать таблицу стоит по строкам, а не по итоговым средним. Правило, которое тут видно на практике: RRF редко оказывается хуже худшего из двух методов и часто спасает там, где один способ провалился. Если BM25 промахнулся на перефразированном вопросе, dense всё равно отдаёт правильный документ, и RRF удерживает его в топе. Если dense промахнулся на артикуле, BM25 ставит нужный документ первым, и слияние по рангам вытягивает его наверх. Поэтому смотри на строки, где один из базовых методов дал провал: именно там RRF показывает свою пользу.
Держи в голове, что этот скелет дальше не выбрасывается. В модуле 06 он становится стадией retrieval для сквозной оценки: ты подключаешь к нему разметку, метрики и прогоняешь всю цепочку целиком, от запроса до ответа. А реранкер из модуля 05 встанет поверх этого слияния: он получит объединённый список кандидатов от BM25 и dense, пересортирует его более тяжёлой моделью и отдаст уточнённый топ. То есть RRF здесь не финальная точка, а рабочая база, на которую аккуратно накладываются следующие слои.
Лаба: nDCG на золотом наборе и где гибрид выигрывает
Берёшь свой корпус и свой золотой набор из модуля 03. Дальше делаешь прицельный тест.
Добавь в корпус один документ с уникальным идентификатором, которого больше нигде нет: артикул вида SKU-4471, номер тикета вида INC-90231, серийник, что угодно, лишь бы строка была редкой и точной. Придумай вопрос, ответ на который есть только в этом документе и строится вокруг этого идентификатора. Например, вопрос «что известно по тикету INC-90231» против документа, где INC-90231 встречается ровно один раз.
Теперь прогони три способа поиска и посчитай nDCG@5 для каждого:
- bm25, чистый лексический поиск;
- dense, чистый векторный поиск по эмбеддингам;
- rrf, гибрид со слиянием по рангам.
Формула: DCG = сумма rel_i / log2(i + 1) по позициям, где i это номер позиции от 1. iDCG это DCG идеального ранжирования, то есть когда все релевантные документы стоят в самом верху. nDCG = DCG / iDCG. Считай релевантность бинарно или градациями, но одинаково для всех трёх способов, иначе сравнение поедет.
Заполни таблицу:
| вопрос | bm25 | dense | rrf |
|---|---|---|---|
| вопрос про артикул SKU-4471 | ... | ... | ... |
| вопрос без редких токенов | ... | ... | ... |
| вопрос с точной формулировкой | ... | ... | ... |
Добавь столько строк, сколько запросов в твоём золотом наборе. Дальше посчитай три средних по столбцам: средний nDCG@5 у bm25, у dense, у rrf. Отметь в таблице или рядом, где rrf выше обоих одиночных способов, и не скрывай обратные случаи, где solo-способ обошёл гибрид.
Критерий выполнения: таблица заполнена на своих данных, три средних по столбцам посчитаны, и написан абзац объяснения. В абзаце разбери, почему на запросе с артикулом bm25 обычно тянет документ наверх, а dense может промахнуться, почему rrf сглаживает провалы обоих, и почему на некоторых запросах гибрид не даёт выигрыша.
Критерий готовности
- Объяснил, почему скор BM25 и косинусную близость нельзя суммировать напрямую и как RRF обходит это через ранги.
- Описал роль константы k в RRF и что меняется при её увеличении и уменьшении.
- Привёл три случая, где dense проигрывает BM25, с примерами из своего корпуса.
- Запустил скрипт на своих данных, а не на демо-корпусе из урока.
- Посчитал nDCG@5 для bm25, dense и rrf и объяснил расхождение словами, а не только числами.
Чеклист самопроверки
- Что делает параметр b в BM25 и как он влияет на нормализацию по длине документа?
- Почему артикул или номер тикета это золото для BM25 и шум для dense?
- В чём разница между слиянием по рангам и слиянием по нормализованным скорам?
- Почему слияние стоит делать на глубоком списке кандидатов, а не на top-3?
- Когда гибрид не нужен и одного способа достаточно?
- Как проверить, что выигрыш гибрида это не случайность на одном запросе?
Материалы главы: текст главы в репо · код · иллюстрации · подписка на обновления курса