Хаб курсов / Курс по RAG / глава 5
Модуль 05: реранкинг cross-encoder поверх гибрида
Добавляем cross-encoder реранкинг поверх гибрида: как он поднимает точность верхних позиций и сколько стоит в миллисекундах.
RAG Engineering. Модуль 05: Реранкинг: cross-encoder поверх гибрида
Bi-encoder против cross-encoder
Bi-encoder кодирует запрос и документ раздельно, двумя независимыми проходами энкодера. На выходе два вектора, релевантность это косинус (или скалярное произведение) между ними. Главное свойство: вектор документа не зависит от запроса, поэтому он считается один раз при индексации и лежит в ANN-индексе (HNSW, IVF). Поиск по миллионам векторов занимает десятки миллисекунд, добавление документа не требует пересчёта остальных. Цена этой дешевизны в том, что модель никогда не видит пару целиком. Оба вектора это усреднённые представления смысла, взаимодействие слов запроса и слов документа теряется. Если в запросе есть отрицание, число, условие или редкий термин, bi-encoder может не заметить разницу между документом, где это есть, и документом, где этого нет.
Cross-encoder подаёт запрос и документ вместе одной последовательностью: [CLS] query [SEP] doc [SEP]. Это один forward pass трансформера, где полноценный self-attention позволяет каждому слову запроса смотреть на каждое слово документа. На выходе один скор релевантности, обученный именно на паре. Точность выше, особенно на тонких различиях: порядок слов, числа, отрицания, оговорки, точные фразы. Цена: предпосчитать нельзя, потому что вход зависит от пары. Каждый кандидат это отдельный forward pass, и никакой индекс тут не помогает.
Аналогия: рекрутер сначала отбирает резюме по ключевым словам, потом лично собеседует пятерых финалистов. Прособеседовать все десять тысяч откликов физически невозможно, а отобрать по ключевым словам и затем внимательно поговорить с коротким списком вполне реально.
Почему нельзя реранчить весь корпус. Арифметика простая. Ретривер отдаёт топ-50 из миллиона документов, это 0.005% корпуса. Пятьдесят пар одним батчем cross-encoder считает за десятки миллисекунд, это приемлемо. Реранкинг всего миллиона это миллион forward pass, на четыре-пять порядков больше вычислений, часы на один запрос. Реранкинг имеет смысл только на коротком списке, где recall уже высокий и остаётся поднять precision.
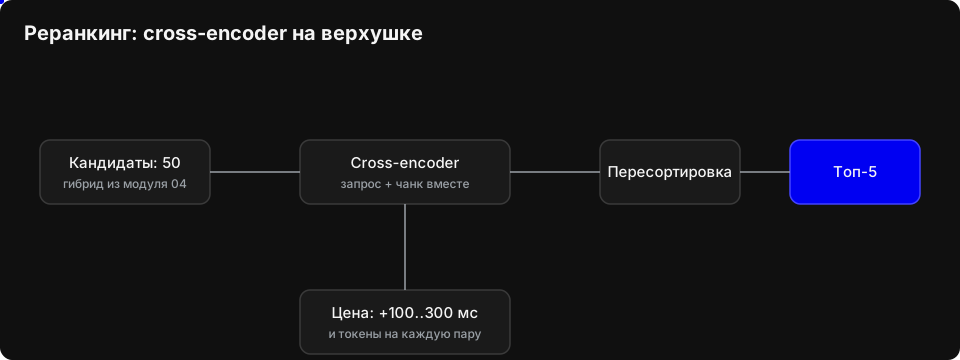
Архитектура двух стадий. Первая стадия дешёвая и оптимизирована на «не потерять»: гибрид BM25, dense и RRF из модуля 04 отдаёт топ-50 по recall. Вторая стадия дорогая и оптимизирована на «правильно упорядочить»: cross-encoder переранжирует эти 50 в топ-5 по precision. Это классический retrieve-and-rerank, тот же паттерн, что в поисковых системах и рекомендациях: дешёвый фильтр, дорогая проверка. Разделение обязанностей важно ещё и потому, что ошибки стадий разные. Ретривер, не пустивший документ в топ-50, реранкер уже не спасёт, а реранкер, получивший хороший пул, обычно вытаскивает правильный ответ наверх.
Что ты построишь
Двухстадийный пайплайн поверх гибрида из модуля 04: первую стадию оставляешь как есть, вторую добавляешь отдельным модулем реранкинга с явным интерфейсом. В оффлайн-версии роль cross-encoder играет детерминированный скор на пересечении токенов и фраз: доля общих токенов, бонус за точное вхождение фразы запроса, нормировка по длине, чтобы пайплайн был воспроизводим без GPU и внешних вызовов. Точка подмены ровно одна: функция или класс реранкера с сигнатурой «запрос плюс список кандидатов на входе, переупорядоченный список со скорами на выходе», поэтому bge-reranker или API-реранкер подставляется без правок остального кода. Плюс замер латентности каждой стадии отдельно и сквозной, чтобы видеть, во что реально обходится прирост точности.
Инструменты: локально и через API
Реранкер нужен там, где ретривер дал широкий список кандидатов, а финальную пятёрку надо выбрать точнее. Почему bi-encoder теряет тонкие различия, а cross-encoder читает пару целиком, разобрано в начале модуля. Здесь важно другое: пару нельзя посчитать заранее, только в момент запроса, и за это платят скоростью.
Локально. Семейство bge-reranker от BAAI это открытый cross-encoder, который крутится на своей машине через transformers. По умолчанию бери BAAI/bge-reranker-v2-m3: он мультиязычный, держит русский и заметно сильнее старого bge-reranker-base 2023 года, который ещё живёт в старых туториалах. Данные не покидают твой контур, что важно, если корпус приватный или под регуляторикой. GPU желателен: на нём батч пар считается заметно быстрее, чем на CPU, но конкретные цифры латентности зависят от модели, железа и размера батча, поэтому проверяй на своём стенде, а не бери из чужих бенчмарков.
Суть в том, что на вход идёт пара (query, doc), на выходе один логит релевантности, который через softmax превращается в скор. Скор нужен только для сортировки кандидатов между собой, поэтому важна не калибровка, а монотонность.
API-реранкеры как опция. Cohere Rerank 4, Jina Reranker (актуальная линейка v3.5 на конец 2026), Voyage rerank-2.5 дают то же поведение одной строкой вызова: передаёшь запрос и список документов, получаешь переупорядоченный список со скорами. Линейки обновляются часто, версию под свой корпус проверяй перед выбором. Тренд направления: listwise-реранкеры вроде Jina v3.5 и Qwen3-Reranker подают список целиком и переупорядочивают его одним прогоном, а не парами; на бенчмарках они обгоняют классические cross-encoder своего размера, но локально требуют своего стека. Своя инфраструктура не нужна, веса не хранишь, модель не обслуживаешь. Минусы прямые: платишь за пары запрос-документ, данные уходят наружу, латентность включает сеть. Оправдано, когда GPU в контуре не водится, поднимать локальный стек некогда и нужен быстрый старт. Если корпус чувствительный или объём запросов большой, локальный вариант почти всегда выигрывает экономически.
Третий класс ранжирования стоит знать, даже если в учебном пайплайне он не нужен: late interaction. ColBERT и его наследники хранят вектор на каждый токен, а релевантность считают через MaxSim: каждый токен запроса ищет ближайший токен документа, скоры максимизируются и суммируются. Это дороже bi-encoder, но точнее его на вопросах, где важны совпадения деталей, и дешевле cross-encoder, потому что векторы документа считаются при индексации, а не на каждый запрос. Экосистема к 2026 году стала обычной: в sentence-transformers есть мультивекторный энкодер, отдельные фреймворки вроде PyLate закрывают обучение и вывод, есть мультиязычные модели вроде jina-colbert-v2; хранилища поддерживают мультивекторы: в Qdrant они есть с версии 1.10.0, и документация прямо называет late interaction с ColBERT и MaxSim основным сценарием. На этом же механизме стоит визуальный retrieval: ColPali и его наследник ColQwen2.5 ищут не по распознанному тексту PDF, а по картинкам страниц, и для сканов с таблицами и схемами это сейчас рабочая альтернатива OCR-пайплайну. Как и всё в этом курсе, late interaction принимается замером на золотом наборе, а не потому, что подход красивый.
Экономика: латентность и деньги реранкинга из топ-50 в топ-5
Латентность реранкинга растёт линейно по числу кандидатов. Каждый кандидат это отдельный прогон cross-encoder по паре, поэтому глубина списка напрямую определяет время ответа. Топ-50 значит пятьдесят прогонов модели, топ-5 значит пять. Разница в порядке усилий, и именно поэтому глубина это главный рычаг.
Каналы экономии. Сначала уменьши глубину. Если ретривер уже выдаёт разумный порядок, реранчить топ-50 целиком смысла мало: часто достаточно топ-30, потому что нижняя часть списка всё равно не претендует на финальную пятёрку. Это экономит и время, и деньги. Дальше батчинг: гонять пары по одной расточительно, батч загружает GPU равномернее и снижает накладные расходы на вызов. Локальная модель снимает плату за пару как таковую, остаётся только железо и время. И кеширование скоров повторных запросов: если запросы повторяются или документы стабильны, готовые скоры переиспользуются без прогона.
Деньги для API. Здесь ты платишь за число пар, поэтому глубина кандидатов конвертируется в счёт напрямую. При том же числе запросов топ-50 дороже топ-30, а топ-30 дороже топ-10. Практическое правило: реранчить только то, что реально спорит за топ-5. Если документы с 30-го по 50-е место не имеют шансов попасть в ответ, их прогон это выброшенные деньги и добавленная латентность. Глубину стоит подбирать под задачу, а не ставить по привычке.
Когда реранкер не нужен. Если корпус маленький, точность первого этапа уже высокая, а латентность критичнее качества, то cross-encoder добавляет стоимость без ощутимой пользы. Маленький корпус часто помещается в контекст целиком или ретривер на нём и так попадает в топ. Точный ретривер с хорошим индексом может не оставлять реранкеру работы. Жёсткий SLA по времени ответа делает лишний прогон модели вредным. Проверяй на своих данных, а не по умолчанию: реранкинг это инструмент под конкретную проблему, а не обязательный слой в любой схеме.
Практика: реранкер поверх гибрида
Скрипт собран из двух стадий. Стадия 1 это гибридный поиск из модуля 04: BM25 и dense-поиск идут параллельно по одному и тому же запросу, а RRF сливает два ранжированных списка в общий пул кандидатов. Ты получаешь не финальную выдачу, а расширенный список с запасом, чтобы реранкеру было из чего выбирать. На вход стадии 2 уходит именно этот пул, а не весь индекс, поэтому стоимость реранкинга зависит от размера пула, а не от размера корпуса.
Стадия 2 это реранкер: он переупорядочивает кандидатов и оставляет топ-5. Точка подмены находится в функции rerank и в cross_score. Контракт простой: rerank принимает запрос и список кандидатов, cross_score принимает пару запрос плюс документ и возвращает скор, а rerank собирает скоры, сортирует по убыванию и обрезает до топ-5. В учебной версии cross_score это лёгкая эвристика, чтобы пример запускался без моделей. Для продакшена замени cross_score на bge-reranker или на вызов API-реранкера, не меняя контракт: кандидаты на вход, скоры на выход, остальной пайплайн остаётся прежним.
import math
import re
import time
import hashlib

def tokenize(text):
    return re.findall(r"[а-яё0-9a-z-]+", text.lower())

def bm25_search(docs, query, k):
    q_tokens = tokenize(query)
    if not docs or not q_tokens:
        return []
    doc_ids = [d["id"] for d in docs]
    n = len(doc_ids)
    # Индексируем заголовок вместе с текстом: заголовок несёт тему документа.
    doc_tokens = {d["id"]: tokenize(d["title"] + " " + d["text"]) for d in docs}
    avgdl = sum(len(t) for t in doc_tokens.values()) / n
    df = {}
    for qt in set(q_tokens):
        df[qt] = sum(1 for d in doc_ids if qt in set(doc_tokens[d]))
    k1, b = 1.5, 0.75
    scores = {}
    for d in doc_ids:
        toks = doc_tokens[d]
        dl = len(toks)
        tf = {}
        for t in toks:
            tf[t] = tf.get(t, 0) + 1
        s = 0.0
        for qt in q_tokens:
            f = tf.get(qt, 0)
            if f == 0:
                continue
            idf = math.log(1 + (n - df[qt] + 0.5) / (df[qt] + 0.5))
            s += idf * (f * (k1 + 1)) / (f + k1 * (1 - b + b * dl / avgdl))
        scores[d] = s
    return sorted(doc_ids, key=lambda d: -scores[d])[:k]

def embed(text, dim=64):
    # для продакшена замените на живой эмбеддер
    vec = [0.0] * dim
    for tok in tokenize(text):
        h = hashlib.sha256(tok.encode("utf-8")).digest()
        idx = int.from_bytes(h[:4], "big") % dim
        sign = 1.0 if h[4] % 2 == 0 else -1.0
        vec[idx] += sign
    norm = math.sqrt(sum(v * v for v in vec))
    if norm > 0:
        vec = [v / norm for v in vec]
    return vec

def dense_search(docs, query, k):
    qv = embed(query)
    scored = []
    for d in docs:
        did = d["id"]
        dv = embed(d["title"] + " " + d["text"])
        dot = sum(a * b for a, b in zip(qv, dv))
        scored.append((dot, did))
    scored.sort(key=lambda x: -x[0])
    return [d for _, d in scored[:k]]

def rrf_fuse(list_a, list_b, k_rrf=60):
    scores = {}
    for lst in (list_a, list_b):
        for rank, did in enumerate(lst, start=1):
            scores[did] = scores.get(did, 0.0) + 1.0 / (k_rrf + rank)
    return sorted(scores, key=lambda d: -scores[d])

def cross_score(query, doc_text):
    # для продакшена замените на bge-reranker или API-реранкер, контракт тот же: список кандидатов, список скоров
    q_tokens = tokenize(query)
    if not q_tokens:
        return 0.0
    doc_tokens = set(tokenize(doc_text))
    # уникальные токены запроса: повтор "vpn vpn vpn" не должен менять скор
    hit = sum(1 for t in set(q_tokens) if t in doc_tokens) / len(set(q_tokens))
    phrase = 0.5 if query.lower() in doc_text.lower() else 0.0
    length_penalty = -0.1 * len(doc_text) / 500
    # нулевое пересечение означает "не релевантен": такой кандидат получает
    # ноль, а не полсотни разных отрицательных скоров, упорядоченных по длине
    if hit == 0.0:
        return 0.0
    return 1.0 + hit + phrase + length_penalty

def rerank(query, doc_ids, docs, top_n=5):
    texts = {d["id"]: d["title"] + " " + d["text"] for d in docs}
    scored = [(cross_score(query, texts.get(d, "")), d) for d in doc_ids]
    scored.sort(key=lambda x: -x[0])
    return [d for _, d in scored[:top_n]]

def recall_at5(found_doc_ids, relevant_ids):
    rel = set(relevant_ids)
    if not rel:
        return 0.0
    return len(set(found_doc_ids[:5]) & rel) / len(rel)


DOCS = [
    {
        "id": 1,
        "title": "Отпуска",
        "text": "Ежегодный оплачиваемый отпуск предоставляется сотруднику по графику, утвержденному до начала календарного года. Перенос отпуска возможен по согласованию с руководителем, если это не нарушает производственный процесс."
    },
    {
        "id": 2,
        "title": "Отпускные",
        "text": "Отпускные выплачиваются не позднее чем за три календарных дня до начала отпуска. Расчет производится исходя из среднего заработка за последние двенадцать месяцев, а при увольнении компенсация выплачивается в день расчета."
    },
    {
        "id": 3,
        "title": "VPN",
        "text": "Удаленный доступ к корпоративной сети предоставляется только через VPN. Запрещается подключаться к рабочим ресурсам через публичные сети без шифрования, а также передавать логины и пароли третьим лицам."
    },
    {
        "id": 4,
        "title": "Инциденты VPN",
        "text": "При потере соединения VPN сотрудник обязан зафиксировать время сбоя, проверить настройки клиента и сообщить в службу поддержки. Если доступ нужен срочно, руководитель может запросить временный резервный канал."
    },
    {
        "id": 5,
        "title": "Бэкапы",
        "text": "Резервное копирование критичных данных выполняется ежедневно, а полные копии создаются не реже одного раза в неделю. Копии хранятся в защищенном хранилище, доступ к ним имеют только администраторы и ответственные за сервис."
    },
    {
        "id": 6,
        "title": "Восстановление",
        "text": "Восстановление данных из резервной копии проводится после согласования с владельцем сервиса. Сначала проверяют целостность копии на тестовом стенде, затем выполняют восстановление и фиксируют результат в журнале инцидентов."
    },
    {
        "id": 7,
        "title": "Доступы",
        "text": "Доступ к информационным системам выдается по заявке руководителя и только в объеме, необходимом для выполнения должностных обязанностей. При изменении роли сотрудника права пересматриваются в течение двух рабочих дней."
    },
    {
        "id": 8,
        "title": "Пароли",
        "text": "Пароли должны содержать не менее двенадцати символов, включая заглавные и строчные буквы, цифры и специальные знаки. Запрещено передавать пароли коллегам и использовать один пароль для разных систем."
    },
    {
        "id": 9,
        "title": "Командировки",
        "text": "Командировка оформляется на основании приказа руководителя. Сотрудник обязан согласовать маршрут, забронировать проживание и сохранить документы, подтверждающие расходы. Аванс выдается не позднее чем за два рабочих дня до выезда."
    },
    {
        "id": 10,
        "title": "Расходы",
        "text": "Расходы сотрудников возмещаются при наличии чеков и подтверждающих документов. Заявка на компенсацию подается в бухгалтерию в течение десяти рабочих дней после возвращения. Суммы сверх установленных лимитов требуют отдельного согласования."
    }
]


GOLD = [
    ("Когда сотрудник может перенести ежегодный отпуск?", [1]),
    ("Как часто делается резервное копирование критичных данных?", [5]),
    ("Как получить доступ к информационной системе компании?", [7]),
    ("Как оформляется командировка и когда выдают аванс?", [9]),
    ("Как возмещаются расходы сотрудника после поездки?", [10]),
]


def main():
    rows = []
    for question, relevant in GOLD:
        fused = rrf_fuse(bm25_search(DOCS, question, 10), dense_search(DOCS, question, 10))[:10]
        before = recall_at5(fused[:5], relevant)
        t0 = time.perf_counter()
        reranked = rerank(question, fused, DOCS, top_n=5)
        ms = (time.perf_counter() - t0) * 1000.0
        after = recall_at5(reranked, relevant)
        rows.append((question, before, after, ms))

    w = 62
    print(f"{'вопрос':<{w}} {'recall@5 до':>12} {'после':>7} {'мс':>9}")
    print("-" * (w + 32))
    for question, before, after, ms in rows:
        print(f"{question[:w]:<{w}} {before:>12.2f} {after:>7.2f} {ms:>9.2f}")
    print("-" * (w + 32))
    n = len(rows)
    print(
        f"{'СРЕДНЕЕ':<{w}} "
        f"{sum(r[1] for r in rows) / n:>12.2f} "
        f"{sum(r[2] for r in rows) / n:>7.2f} "
        f"{sum(r[3] for r in rows) / n:>9.2f}"
    )


def rerank_with_transformers(query, doc_ids):
    """опционально, требует внешних пакетов"""
    raise RuntimeError('см. текст модуля: нужен transformers или API-реранкер')


def rerank_with_api(query, doc_ids):
    """опционально, требует внешних пакетов"""
    raise RuntimeError('см. текст модуля: нужен transformers или API-реранкер')


if __name__ == '__main__':
    main()
Вот как выглядит подмена cross_score на настоящий cross-encoder. Набросок не runnable: он требует transformers и весов модели. Контракт тот же: пара запрос плюс документ на входе, скор на выходе.
# опциональный блок: требует transformers и весов модели
from transformers import AutoTokenizer, AutoModelForSequenceClassification

MODEL_NAME = "BAAI/bge-reranker-v2-m3"  # лёгкая альтернатива: bge-reranker-base
tok = AutoTokenizer.from_pretrained(MODEL_NAME)
model = AutoModelForSequenceClassification.from_pretrained(MODEL_NAME)

def score(query, doc):
    pair = tok(query, doc, truncation=True, return_tensors="pt")
    logits = model(**pair).logits
    return logits.softmax(dim=-1)  # скор релевантности
Замеры читай в двух разрезах. Первый это латентность: сравни время реранкинга с временем ретривера отдельно, а не только суммарное время запроса, иначе не видно, кто именно съел миллисекунды. Второй это качество: прирост recall на hash-эмбеддерах не гарантирован, потому что сам ретривер там слабый и пул кандидатов может не содержать нужных документов. Реранкер не умеет доставать то, чего нет в пуле, он только переупорядочивает. В демо-прогоне на этом корпусе ретривер и так вернул идеальный топ-5 по всем вопросам, поэтому колонки «до» и «после» совпали: это честный результат, а не поломка. На живом эмбеддере и спорных кандидатах порядок в пуле уже не идеален, и там реранкер показывает разницу, а его цена видна в последней колонке.
Поэтому смотри не на абсолютные числа, а на направление эффекта и на цену в миллисекундах. Если метрика выросла, а латентность осталась приемлемой, подмена окупается. Если метрика не изменилась, сначала проверь, попадают ли правильные документы в пул, и только потом трогай реранкер. Дальше модуль 06 прогоняет пайплайны поиска из модуля 04 через золотой набор из модуля 03, и там ты увидишь эффект на метриках по всему набору вопросов, а не на отдельных стадиях.
Лаба: прирост качества и цена в миллисекундах
Возьми свой корпус и золотой набор из модуля 03. Это те же вопросы с эталонными ответами и разметкой релевантности, что ты собирал раньше, менять их не нужно. Твоя задача: понять, окупает ли реранкер потраченные миллисекунды именно на твоих данных, а не в среднем по интернету.
Подключи реранкер одним из трёх способов. Локальный bge-reranker через transformers (модель грузится в память, инференс на твоём железе). API-реранкер (отправляешь пары запрос-документ наружу, платишь за токены). Оффлайн-скор из скрипта модуля (если нет доступа к сети или хочешь зафиксировать окружение). Выбор способа запиши в отчёт, он влияет на латентность и цену.
Дальше замерь nDCG@5 по каждому вопросу два раза. До реранка это порядок, который выдал RRF. После реранка это порядок, который дал реранкер. Латентность стадии реранка измеряй через time.perf_counter() вокруг вызова, а не вокруг всего запроса, иначе смешаешь поиск с пересчётом.
Повтори прогон с глубиной кандидатов 10 и 30. На глубине 30 реранкер видит больше документов, качество может вырасти, но латентность почти линейно растёт от числа пар. Запиши оба числа. Заполни таблицу:
| вопрос | nDCG до | nDCG после | rerank мс | глубина 30 мс |
|---|---|---|---|---|
| ... | ... | ... | ... | ... |
Критерий выполнения: таблица заполнена по всем вопросам; посчитан средний прирост nDCG или честно сказано, что прироста нет; посчитана средняя латентность на глубине 10 и 30; написан абзац-вердикт, стоит ли реранкер своих миллисекунд на твоих данных.
Если прироста нет, это нормальный результат. Возможно, у тебя короткие документы и bi-encoder уже хорошо их ранжирует. Возможно, золотой набор слишком простой. Вердикт важнее красивой цифры.
Критерий готовности
- Объясняешь, почему cross-encoder точнее bi-encoder и почему им не ищут по всему корпусу.
- Понимаешь, откуда берётся латентность и цена реранка.
- Замерил качество до и после реранка на своём наборе.
- Знаешь способы подключения реранкера и когда какой брать.
- Проверил влияние глубины кандидатов на латентность.
Чеклист самопроверки
- Почему bi-encoder индексируется заранее, а cross-encoder нет?
- Что для API-реранкера дороже: глубина 10 или 30 и во сколько раз примерно?
- Когда реранкер не нужен?
- Почему реранкер ставят после RRF, а не до него?
- Что произойдёт с латентностью при удвоении глубины кандидатов?
- Что ты сделаешь, если прирост nDCG после реранка окажется нулевым?
Материалы главы: текст главы в репо · код · иллюстрации · подписка на обновления курса