Хаб курсов / Курс по RAG / глава 6
Модуль 06: оценка качества и eval в CI
Оцениваем качество RAG числами: recall@k, MRR и nDCG на золотом наборе, свой eval-раннер и гейт в CI, который ловит регресс до выкладки.
RAG Engineering. Модуль 06: Оценка качества: метрики, eval-раннер, eval в CI
Зачем измерять RAG и что ломается без метрик
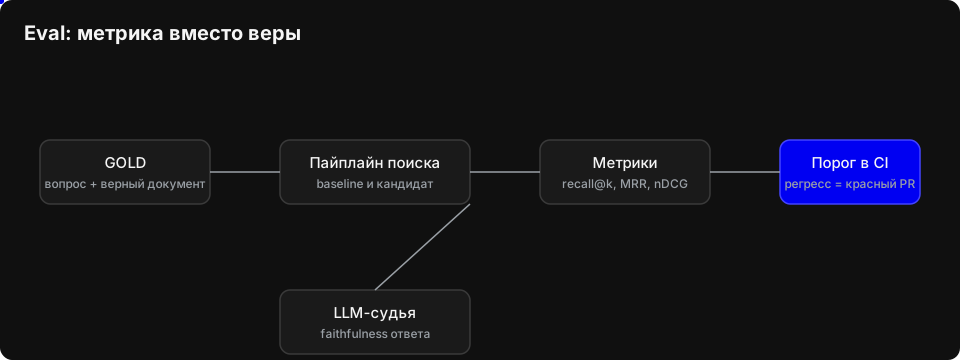
RAG-система почти всегда убедительна на нескольких удачных примерах. Запрос про отпуск находит нужный регламент, ответ выглядит связно, ссылка на документ присутствует. Проблема в том, что демонстрация показывает лишь те случаи, которые уже прошли проверку. Стоит изменить размер чанка, эмбеддер, k в поиске, k_rrf или включить реранкер, и поведение системы меняется на всём корпусе. Без измерения невозможно понять, стало лучше или просто иначе.
Почему «на глаз» не работает. Ручная проверка обычно опирается на два-три запроса, которые автор системы помнит лучше всего. Это создаёт систематическую ошибку: улучшение на показательных вопросах принимается за общее улучшение. Например, уменьшение чанков может повысить точность попадания нужного фрагмента, но разорвать условие регламента на две части, и генератор соберёт неполный ответ. Более агрессивное слияние BM25 и dense-поиска может поднять долю семантически близких документов, но вытеснить точное совпадение по редкому артикулу REG-2024-118. Во всех случаях субъективное «стало лучше» не отделяет улучшение retrieval от улучшения генерации и не показывает регрессии на остальных запросах.
Два слоя оценки. RAG нужно проверять отдельно на двух уровнях. Первый слой отвечает на вопрос: нашлись ли документы, которые действительно нужны для ответа. Здесь работают retrieval-метрики: hit@k (есть ли хотя бы один релевантный документ в выдаче), recall@k (какую долю всех релевантных документов удалось найти), precision@k (какая доля выданных документов полезна), MRR (как высоко стоит первый релевантный результат) и nDCG (качество порядка выдачи). Для корпуса курса особенно важен recall@k: если редкий артикул или условие из REG-2024-118 не попали в контекст, генератор физически не сможет ответить правильно.
Второй слой отвечает на другой вопрос: хороший ли ответ собран из найденного. Generation-метрики проверяют фактическую правильность, полноту, обоснованность источниками, корректность ссылок и уместность отказа. Или наоборот: нужный документ найден, а модель говорит «в регламенте нет информации». Без разделения слоёв такая ошибка выглядит как проблема поиска, хотя на самом деле сломан промпт или генератор.
Золотой набор как контракт. GOLD из модуля 03 ценен тем, что создан до настройки системы. Это JSONL-файл с парами «вопрос, список id релевантных документов», а не набором красивых ответов. Он фиксирует ожидания команды и версионируется вместе с кодом. После каждого изменения поиска, чанкинга, эмбеддера, промпта или реранкера один и тот же набор прогоняется заново.
Если чанкинг меняет идентификаторы, нельзя молча переписывать GOLD под новую выдачу. Нужно либо сохранять стабильный document_id и связь чанка с родительским документом, либо выпускать новую версию набора с явной миграцией.
Связка с модулями 04-05. Один и тот же GOLD позволяет честно сравнить bm25_search, dense_search, rrf_fuse и схему с cross-encoder реранкером. Сравнение должно идти при одинаковом k, одинаковой глубине кандидатов и одинаковом наборе вопросов. Реранкер меняет порядок уже найденных кандидатов, поэтому его эффект особенно заметен на MRR и точности финального контекста, а не на полноте всего пула кандидатов.
Что ломается без метрик. Команда получает ложные улучшения, незаметные регрессии и отсутствие критерия отката. Непонятно, какую конфигурацию оставить, что чинить после обновления корпуса и почему вчерашний ответ перестал быть верным. Метрики нужны не для отчётности, а как обратная связь: они показывают, где именно сломался конвейер, и не дают менять сразу всё.
Метрики ранжирования: recall@k, MRR, nDCG
Поиск в RAG возвращает список документов, и качество этого списка нужно измерять числом. Без метрик любая правка (новый вес BM25, другой k в RRF, добавление реранкера) обсуждается на вкус. С метриками она превращается в сравнение до и после на золотом наборе GOLD, где для каждого вопроса уже выписан список релевантных id. Ниже три метрики, которые закрывают разные вопросы: попал ли нужный документ в контекст, насколько высоко он стоит и насколько удачен весь порядок выдачи.
Recall@k
Recall@k отвечает на вопрос: какая доля релевантных документов вообще доехала до генератора в первых k позициях.
recall@k = |relevant ∩ top_k| / |relevant|
Пример. Запрос «как оформить отпуск», в GOLD три релевантных документа: d2 (регламент отпусков), d4 (форма заявления), d5 (перенос отпуска). Поиск вернул порядок d1, d2, d5, d3, d4. Считаем:
recall@1 = |{d2}| / 3 = 1/3 ≈ 0,33
recall@3 = |{d2, d5}| / 3 = 2/3 ≈ 0,67
recall@5 = |{d2, d5, d4}| / 3 = 3/3 = 1,0
Метрика не смотрит на порядок внутри top-k: d2 на втором месте и d2 на пятом дают одинаковый вклад. Для RAG это чаще плюс, чем минус: генератор получает весь top-k в промпт и может сам найти нужный фрагмент.
MRR
MRR (mean reciprocal rank) отвечает на другой вопрос: как быстро в выдаче встречается первый релевантный документ. Считается обратный ранг первого попадания, затем усредняется по вопросам.
RR_i = 1 / rank_first_relevant_i     (0, если попаданий нет)
MRR = (1/N) * Σ RR_i
Пример на трёх вопросах. Первый релевантный документ найден на позиции 2, затем на позиции 1, затем на позиции 4:
RR_1 = 1/2 = 0,5
RR_2 = 1/1 = 1,0
RR_3 = 1/4 = 0,25
MRR = (0,5 + 1,0 + 0,25) / 3 ≈ 0,583
MRR достаточно, когда на вопрос нужен один главный документ: сотрудник спрашивает «какой артикул у регламента REG-2024-118», и правильный ответ лежит ровно в одном месте. Второй и третий релевантные документы в такой задаче не важны, и MRR честно это отражает. Для широких вопросов («какие есть регламенты по доступам») MRR занижает качество: система может поднять все нужные документы на позиции 2-6 и всё равно получить скромный балл.
nDCG
nDCG (normalized discounted cumulative gain) учитывает и порядок, и градации релевантности. В GOLD релевантность бинарная, но её можно расширить: 2 для документа, который прямо отвечает, 1 для полезного, но неполного, 0 для нерелевантного.
DCG@k = Σ_{i=1..k} (2^rel_i - 1) / log2(i + 1)
IDCG@k = DCG@k для идеального порядка (релевантности по убыванию)
nDCG@k = DCG@k / IDCG@k
Логарифм в знаменателе даёт дисконт: чем ниже позиция, тем меньше вклад. Нормировка на IDCG приводит все вопросы к шкале от 0 до 1, поэтому их можно усреднять, даже если у одного вопроса два релевантных документа, а у другого пять.
Пример. Выдача из четырёх документов с релевантностями 2, 0, 1, 2:
DCG@4 = 3/1 + 0/1,585 + 1/2 + 3/2,322
      = 3 + 0 + 0,5 + 1,292 ≈ 4,792

Идеальный порядок: 2, 2, 1, 0
IDCG@4 = 3/1 + 3/1,585 + 1/2 + 0 ≈ 5,393

nDCG@4 = 4,792 / 5,393 ≈ 0,889
Видно, где система теряет: сильный документ d1 стоит первым, но документ с релевантностью 2 оказался на последней позиции и почти не повлиял на сумму. Перестановка d4 на второе место подняла бы nDCG ближе к единице.
Расчёт на GOLD
Метрики удобно считать одним проходом по золотому набору, подставляя любую функцию поиска: bm25_search, dense_search, результат rrf_fuse или выход реранкера.
import math

def recall_at_k(relevant, retrieved, k):
    """Доля релевантных документов, попавших в первые k позиций."""
    if not relevant:
        return 0.0
    hits = set(retrieved[:k]) & set(relevant)
    return len(hits) / len(relevant)

def reciprocal_rank(relevant, retrieved):
    """Обратный ранг первого релевантного документа."""
    for rank, doc_id in enumerate(retrieved, start=1):
        if doc_id in relevant:
            return 1.0 / rank
    return 0.0

def dcg(grades):
    """DCG с логарифмическим дисконтом по позициям."""
    return sum((2 ** g - 1) / math.log2(i + 1) for i, g in enumerate(grades, start=1))

def ndcg_at_k(graded_relevant, retrieved, k):
    """graded_relevant: словарь doc_id -> степень релевантности 0..2."""
    gains = [graded_relevant.get(d, 0) for d in retrieved[:k]]
    ideal = sorted(graded_relevant.values(), reverse=True)[:k]
    idcg = dcg(ideal)
    return dcg(gains) / idcg if idcg > 0 else 0.0

def evaluate(gold, search_fn, k=5):
    """gold: список пар (вопрос, список id релевантных документов)."""
    recalls, rrs, ndcgs = [], [], []
    for question, relevant in gold:
        retrieved = [doc["id"] for doc in search_fn(question, k)]
        # В GOLD разметка бинарная, поэтому 1 для релевантных, 0 для остальных
        graded = {doc_id: 1 for doc_id in relevant}
        recalls.append(recall_at_k(relevant, retrieved, k))
        rrs.append(reciprocal_rank(relevant, retrieved))
        ndcgs.append(ndcg_at_k(graded, retrieved, k))
    n = len(gold)
    return {
        "recall@k": sum(recalls) / n,
        "mrr": sum(rrs) / n,
        "ndcg@k": sum(ndcgs) / n,
    }
Какую метрику выбирать
Recall@k отвечает за полноту контекста. Если генератор должен собрать ответ из нескольких документов (отпуска плюс перенос, доступы плюс VPN), смотри на recall@k при k, равном числу документов, которые реально уходят в промпт. Падение recall здесь означает, что часть ответа физически не доехала до модели.
MRR отвечает за точность первого попадания. Он уместен, когда у вопроса есть один канонический документ: редкий артикул REG-2024-118, конкретная форма заявления, одна статья регламента. Реранкер в модуле 05 обычно улучшает именно MRR, потому что переставляет сильный документ наверх.
nDCG отвечает за качество всего порядка и нужен, когда важно, какие документы окажутся в начале списка при ограниченном окне контекста. Если в промпт попадают только три первых фрагмента, nDCG покажет деградацию, которую recall@5 не заметит.
Практический минимум: считать все три метрики на одном и том же GOLD и при одном и том же k, а в отчёте рядом с числом указывать k и размер набора. Метрика без этих двух параметров не воспроизводится и в сравнение версий не годится.
Faithfulness и answer relevance: метрики ответа
Retrieval-метрики отвечают на узкий вопрос: попали ли релевантные документы в контекст. Recall@k, MRR и nDCG считаются по GOLD и по списку id, который вернул гибридный поиск после слияния и реранка. Про сам ответ они не говорят ничего. Модель может получить правильный документ и все равно ответить по памяти, перепутать артикул REG-2024-118 с похожим, выдумать срок согласования или ответить на другой вопрос. Контекст был хорошим, ответ плохой. Поэтому поверх retrieval-метрик нужен отдельный слой: метрики ответа, прежде всего faithfulness и answer relevance.
Faithfulness отвечает на вопрос, подтверждается ли ответ найденным контекстом. Рабочее определение: каждое атомарное утверждение в ответе должно опираться на текст контекста. Считается через LLM-судью в два шага. Первый шаг: разбить ответ на утверждения, каждое из которых проверяемо отдельно. Второй шаг: для каждого утверждения спросить судью, подтверждается ли оно контекстом, с ответом строго «да» или «нет». Метрика это доля подтверждённых утверждений.
def split_claims(answer: str, judge) -> list[str]:
    """Режет ответ на атомарные утверждения через LLM."""
    # В продакшене здесь вызов модели с просьбой вернуть JSON-список утверждений
    raw = judge(f"Разбей ответ на атомарные утверждения, верни JSON-список:\n{answer}")
    return [c.strip() for c in raw if c.strip()]

def faithfulness(answer: str, context: str, judge) -> float:
    """Доля утверждений ответа, подтвержденных контекстом."""
    claims = split_claims(answer, judge)
    if not claims:
        return 1.0
    supported = 0
    for claim in claims:
        # Судья отвечает одним словом: yes или no
        verdict = judge(
            "Подтверждается ли утверждение контекстом? Ответь yes или no.\n"
            f"Утверждение: {claim}\nКонтекст: {context}"
        )
        if verdict.strip().lower().startswith("yes"):
            supported += 1
    return supported / len(claims)
Без LLM есть дешёвые эвристики. Первая: пересечение ответа с контекстом, например доля содержательных токенов утверждения, которые встречаются в контексте. Вторая: проверка цитирования, если ответ обязан ссылаться на id документов, проверяется, что каждый id действительно есть в контексте. Обе эвристики грубы. Пересечение наказывает пересказ своими словами и поощряет копирование контекста дословно. Числа и даты требуют точного совпадения, иначе «14 дней» и «14 рабочих дней» дадут высокий скор при разном смысле. Отрицание переворачивает смысл при почти тех же токенах. Поэтому эвристики годятся как быстрый фильтр и сигнал регресса, но не как замена судье.
Answer relevance отвечает на другой вопрос: отвечает ли ответ на заданный вопрос. Здесь тоже работает LLM-судья: на вход идут вопрос и ответ, на выходе бинарная оценка или короткая шкала, то есть число. Второй способ, обратный вопрос: по ответу генерируется вопрос, который этот ответ закрывает, и сравнивается с исходным через эмбеддинг и косинусную близость. Hash-эмбеддер из модуля 04 для этого слаб, его лучше заменить на живой эмбеддер. Обратный вопрос ловит случаи, когда ответ содержательный, но про соседнюю тему: формально связный текст, фактически не то, что спрашивали.
Честная рамка: LLM-судья сам ошибается. Он чувствителен к порядку аргументов, к длине ответа, склонен завышать оценки подробным текстам и иногда соглашается с собственными формулировками. Поэтому доля судейских оценок должна проверяться вручную: небольшая случайная выборка, разметка человеком, сравнение с судьей и оценка согласия. Если согласие низкое, метрику нельзя использовать как порог, сначала надо править промпт судьи и критерии.
Eval в CI: пороги и регресс на PR
Золотой набор GOLD и раннер это обычные артефакты репозитория, поэтому их место в CI. На каждый PR запускается eval_runner.py: он читает GOLD из JSONL рядом с корпусом DOCS, прогоняет текущий пайплайн поиска и считает метрики. Дальше работают два порога одновременно. Первый, абсолютный минимум: метрика не должна опуститься ниже зафиксированного значения. Второй, относительный: метрика не должна упасть относительно основной ветки больше чем на согласованную дельту. Абсолютный порог ловит общий провал, дельта ловит медленную деградацию, которую по одному прогону не видно.
Что делать при падении, решается заранее и одинаково для всей команды. Базовый вариант: merge блокируется, автор разбирается, регресс это баг. Осознанное исключение тоже допустимо, но только явно: порог меняется отдельным коммитом с объяснением в описании PR, почему новое значение корректно, например изменился состав GOLD или добавлен новый тип документов.
Eval в CI это обычный тест, только вместо assert на конкретное значение стоит assert на метрику. Разница в том, что метрика шумная и зависит от корпуса, поэтому порог подбирается по истории прогонов, а не назначается на глаз.
- name: Retrieval eval на золотом наборе
  env:
    MIN_RECALL: "0.80"   # зафиксированный минимум, значение условное
    MAX_DROP: "0.03"     # допустимое падение относительно основной ветки
  run: |
    python eval_runner.py \
      --gold data/gold.jsonl \
      --docs data/docs \
      --min-recall-at-k "$MIN_RECALL" \
      --max-drop "$MAX_DROP"
Раннер возвращает нулевой код при прохождении порогов и ненулевой при регрессе. Ненулевой код валит шаг, шаг валит job, PR блокируется. Никакой отдельной логики в YAML не нужно, код возврата это и есть проверка.
Отдельно про стоимость. LLM-судья в CI дорогой и медленный: он делает десятки вызовов на один ответ, платит за токены и добавляет минуты к сборке. Поэтому слои разделяют. Retrieval-метрики дешёвые и детерминированные, их гоняют на каждый PR. Generation-метрики, faithfulness и answer relevance через судью, запускают по расписанию или вручную перед релизом и крупными изменениями промптов. Такой набор даёт быструю обратную связь на PR и полную картину качества там, где задержка допустима.
Что ты построишь
В этом модуле ты напишешь собственный eval-раннер: скрипт примерно на сто строк на чистом Python stdlib, который отвечает на вопрос «стал ли поиск лучше» без запуска приложения и без установки зависимостей.
Скрипт загрузит корпус DOCS и золотой набор GOLD из модуля 03, поднимет три retrieval-пайплайна из модуля 04 (BM25, dense на hash-эмбеддере и гибридный RRF) и прогонит каждый вопрос из GOLD через каждый пайплайн.
Дальше он посчитает три метрики: recall@k (попал ли релевантный документ в первые k позиций), MRR (на какой позиции стоит первый правильный документ) и nDCG@k (качество всего списка с учётом порядка). Метрики считаются по каждому вопросу, затем усредняются по золотому набору и по каждому пайплайну.
Результат выводится таблицей: строка на пайплайн и вопрос, отдельный блок со средними значениями. В конце скрипт сравнивает средний recall@5 с порогом THRESHOLD и возвращает код выхода 1, если качество упало ниже порога. Это превращает eval из разового эксперимента в проверку, которую можно поставить в CI: любое изменение корпуса, чанкинга или весов, которое ломает поиск, роняет сборку.
Практика: свой eval-раннер
Корпус здесь маленький и намеренно ручной: шесть документов про отпуска, VPN, бэкапы, доступы, командировки с компенсациями и регламент REG-2024-118 с редким артикулом KB-7734. Золотой набор состоит из пяти вопросов, у каждого один релевантный документ. Такой размер нужен не для реалистичных цифр, а чтобы ты видел весь путь данных от вопроса до строки таблицы и мог проверить каждый шаг руками.
Порядок работы скрипта такой. Сначала tokenize приводит текст к нижнему регистру и режет его на слова регуляркой. BM25 считает score по формуле с idf и нормализацией длины документа. Dense строит векторы через embed: детерминированный hash-эмбеддер на sha256, размерность 64, поэтому один и тот же текст всегда даёт один и тот же вектор. В реальном проекте этот вызов заменяется на живой эмбеддер, интерфейс при этом не меняется. RRF сливает два ранжированных списка по формуле 1/(k_rrf + rank).
Метрики реализованы с бинарной релевантностью: документ либо релевантен, либо нет. recall@k проверяет долю найденных релевантных документов в топ-k. MRR берет обратную позицию первого правильного документа. nDCG@k нормирует discounted gain на идеальный порядок, поэтому штрафует за то, что правильный документ стоит ниже.
В main три пайплайна прогоняются по всем вопросам, печатается таблица и средние, затем средний recall@5 лучшего пайплайна сравнивается с THRESHOLD = 0.6. Код выхода 1 при провале позволяет поставить команду python eval_runner.py в CI.
Что делать дальше: добавь вопросы, расширь корпус, подними k, поменяй веса BM25 или k_rrf и посмотри, как двигаются числа. Полезный эксперимент: удали документ d6 и убедись, что recall по вопросу про REG-2024-118 падает до нуля и сборка краснеет.
"""Eval-раннер поиска: recall@k, MRR и nDCG@k. Только стандартная библиотека."""
import hashlib
import math
import re
import sys

K = 5
THRESHOLD = 0.6

# Корпус служебных регламентов: 6 документов
DOCS = [
    {"id": "d1", "text": "Регламент отпусков: заявление на ежегодный оплачиваемый отпуск подается не позднее чем за две недели, отпускные выплачиваются за три рабочих дня до начала отпуска."},
    {"id": "d2", "text": "Инструкция по VPN: корпоративный VPN подключается через клиент WireGuard, конфигурация выдается в отделе ИТ, пароль к VPN меняется раз в квартал."},
    {"id": "d3", "text": "Резервное копирование: полные бэкапы баз данных выполняются ежедневно в 02:00, проверка восстановления из копии проводится раз в месяц."},
    {"id": "d4", "text": "Управление доступами: заявка на доступ к новой системе оформляется в Service Desk и согласуется с владельцем системы."},
    {"id": "d5", "text": "Командировки и компенсации: суточные выплачиваются за каждый день командировки, расходы на проезд компенсируются по чекам после возвращения."},
    {"id": "d6", "text": "Регламент REG-2024-118: хранение резервных копий во внешнем контуре, согласно артикулу KB-7734 срок хранения архивных копий составляет один год."},
]

# Золотой набор: пары «вопрос, список id релевантных документов»
GOLD = [
    {"question": "За сколько дней до начала отпуска нужно подать заявление?", "relevant": ["d1"]},
    {"question": "Как подключить корпоративный VPN и где взять конфигурацию?", "relevant": ["d2"]},
    {"question": "Как часто выполняются полные резервные копии баз данных?", "relevant": ["d3"]},
    {"question": "Как вернуть стоимость билетов после служебной поездки?", "relevant": ["d5"]},
    {"question": "Какой срок хранения задает артикул KB-7734 в регламенте REG-2024-118?", "relevant": ["d6"]},
]

def tokenize(text):
    return re.findall(r"[a-zа-яё0-9]+", text.lower())

def embed(text, dim=64):
    # Для продакшена замените на живой эмбеддер
    vec = [0.0] * dim
    for token in tokenize(text):
        digest = hashlib.sha256(token.encode("utf-8")).digest()
        index = int.from_bytes(digest[:4], "big") % dim
        vec[index] += 1.0 if digest[4] % 2 == 0 else -1.0
    norm = math.sqrt(sum(v * v for v in vec)) or 1.0
    return [v / norm for v in vec]

def bm25_search(docs, query, k=K, k1=1.5, b=0.75):
    corpus = [tokenize(doc["text"]) for doc in docs]
    query_tokens = tokenize(query)
    n = len(corpus)
    # пустой корпус и пустой запрос не должны валить раннер: возвращаем пустую выдачу
    if n == 0 or not query_tokens:
        return []
    avgdl = sum(len(tokens) for tokens in corpus) / n
    df = {}
    for tokens in corpus:
        for word in set(tokens):
            df[word] = df.get(word, 0) + 1
    scored = []
    for doc, tokens in zip(docs, corpus):
        tf = {}
        for word in tokens:
            tf[word] = tf.get(word, 0) + 1
        score = 0.0
        for word in query_tokens:
            if word not in tf:
                continue
            idf = math.log(1 + (n - df[word] + 0.5) / (df[word] + 0.5))
            score += idf * tf[word] * (k1 + 1) / (tf[word] + k1 * (1 - b + b * len(tokens) / avgdl))
        scored.append((-score, doc["id"]))
    # без пересечений (score=0) документ не выдаём: иначе мусорный запрос получает произвольную выдачу
    scored = [pair for pair in scored if -pair[0] > 0.0]
    scored.sort()
    return [doc_id for _, doc_id in scored[:k]]

def dense_search(docs, query, k=K):
    query_vec = embed(query)
    scored = []
    for doc in docs:
        doc_vec = embed(doc["text"])
        scored.append((-sum(a * b for a, b in zip(query_vec, doc_vec)), doc["id"]))
    scored.sort()
    return [doc_id for _, doc_id in scored[:k]]

def rrf_fuse(list_a, list_b, k_rrf=60):
    scores = {}
    for ranked in (list_a, list_b):
        for rank, doc_id in enumerate(ranked, start=1):
            scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k_rrf + rank)
    return sorted(scores, key=lambda doc_id: (-scores[doc_id], doc_id))

def recall_at_k(ranked, relevant, k=K):
    # кривая строка GOLD не должна ронять весь прогон: нет релевантных -> recall 0
    return len(set(ranked[:k]) & set(relevant)) / len(relevant) if relevant else 0.0

def mrr(ranked, relevant):
    for rank, doc_id in enumerate(ranked, start=1):
        if doc_id in relevant:
            return 1.0 / rank
    return 0.0

def ndcg_at_k(ranked, relevant, k=K):
    dcg = sum(1.0 / math.log2(i + 2) for i, doc_id in enumerate(ranked[:k]) if doc_id in relevant)
    ideal = sum(1.0 / math.log2(i + 2) for i in range(min(len(relevant), k)))
    return dcg / ideal if ideal else 0.0

# Три retrieval-пайплайна из модуля 04
PIPELINES = {
    "bm25": lambda docs, query, k: bm25_search(docs, query, k),
    "dense": lambda docs, query, k: dense_search(docs, query, k),
    "rrf": lambda docs, query, k: rrf_fuse(bm25_search(docs, query, k), dense_search(docs, query, k)),
}

def main():
    header = f"{'pipeline':8}{'recall@5':>10}{'mrr':>7}{'ndcg@5':>8}  вопрос"
    print(header)
    means = {}
    for name, run in PIPELINES.items():
        recalls, mrrs, ndcgs = [], [], []
        for item in GOLD:
            ranked = run(DOCS, item["question"], K)
            recall = recall_at_k(ranked, item["relevant"], K)
            rr = mrr(ranked, item["relevant"])
            ndcg = ndcg_at_k(ranked, item["relevant"], K)
            recalls.append(recall)
            mrrs.append(rr)
            ndcgs.append(ndcg)
            print(f"{name:8}{recall:10.2f}{rr:7.2f}{ndcg:8.2f}  {item['question']}")
        means[name] = (sum(recalls) / len(recalls), sum(mrrs) / len(mrrs), sum(ndcgs) / len(ndcgs))
    print("\nСредние по золотому набору:")
    for name, (recall, rr, ndcg) in means.items():
        print(f"{name:8}{recall:10.2f}{rr:7.2f}{ndcg:8.2f}")
    best = max(value[0] for value in means.values())
    passed = best >= THRESHOLD
    print(f"\nПорог recall@5 = {THRESHOLD:.2f}, лучший пайплайн = {best:.2f}: {'OK' if passed else 'FAIL'}")
    return 0 if passed else 1

if __name__ == "__main__":
    sys.exit(main())
Лаба: поймай регрессию
Цель лабораторной: научиться замечать деградацию поиска не по субъективному «стало хуже», а по метрикам и коду завершения eval-раннера. Ты работаешь на своём корпусе DOCS и своём золотом наборе GOLD из модуля 03. Раннер должен считать recall@5, MRR и nDCG@5, сравнивать их с порогом из твоего конфига и возвращать 0 при прохождении, 1 при регрессии.
Сначала зафиксируй baseline. Запусти раннер и сохрани отчёт отдельным файлом, чтобы потом не перезаписать его:
# базовый прогон, имена аргументов адаптируйте под свой раннер
python eval_runner.py --docs ./docs --gold ./gold.jsonl --out ./reports/baseline.json
Убедись, что процесс завершился с кодом 0, а метрики не ниже порога. Запиши значения в таблицу. После этого выбери минимум одну поломку, лучше проверь все три по очереди, каждый раз возвращая исходное состояние:
- Увеличь
k1в BM25 на порядок или больше относительно рабочего значения. Слишком большойk1сглаживает влияние частоты терминов, и ранжирование начинает хуже отделять релевантные документы. - Урежь эмбеддер до
dim=8. При таком размере hash-эмбеддинг начинает сильно страдать от коллизий, а dense-ветка теряет различимость документов. - Обрежь выдачу каждой ветки до
top-2передrrf_fuse. Слияние и cross-encoder получают слишком мало кандидатов, поэтому релевантный документ может не дойти до финального ранжирования.
После изменения запусти тот же раннер с новым путём отчёта:
# регрессионный прогон: ожидаем падение метрик и exit-код 1
python eval_runner.py --docs ./docs --gold ./gold.jsonl --out ./reports/regression.json
Проверь код завершения командой echo $? в Linux или echo %ERRORLEVEL% в Windows. Ожидается 1. Если раннер всё ещё возвращает 0, поломка оказалась слишком мягкой или порог выставлен низко.
Заполни таблицу по своему прогону. В ячейках метрик укажи фактические значения, в последней колонке код завершения.
| Вариант пайплайна | recall@5 | MRR | nDCG@5 | exit-код |
|---|---|---|---|---|
| baseline | ... | ... | ... | 0 |
k1 экстремальный | ... | ... | ... | 1 |
dim=8 | ... | ... | ... | 1 |
top-2 перед слиянием | ... | ... | ... | 1 |
| восстановленный | ... | ... | ... | 0 |
Теперь верни параметр ровно к исходному значению. Если менял код, проверь diff и убедись, что не осталось временных правок. Повтори baseline-команду, например с отчётом ./reports/restored.json. Метрики должны вернуться к прежним значениям с точностью округления, а процесс снова завершиться с кодом 0. Если восстановление неполное, ищи забытое изменение в конфиге, кэше или ветке поиска.
Критерий выполнения: таблица заполнена фактическими значениями, регрессионный прогон дал exit-код 1, восстановленный прогон снова прошёл порог и дал exit-код 0. Дополнительно объясни в отчёте, какая метрика просела сильнее и почему: recall@5 чувствителен к выпадению документов из топ-5, MRR к смещению первого релевантного вниз, nDCG@5 учитывает порядок сильнее всего.
Про порог THRESHOLD = 0.6. Число взято не из ГОСТа, а из здравого смысла для крошечного корпуса: на шести документах и пяти вопросах качество ниже половины означает, что поиск сломан, а не «немного хуже». В реальном проекте порог выводится из истории прогонов: берёшь качество текущего релиза, добавляешь запас на шум между запусками и запрещаешь падение ниже этой планки. Порог, взятый с потолка чужого проекта, либо душит нормальные изменения, либо пропускает деградацию.
И второе, о чём модуль говорит честно: пять вопросов хватает для учёбы, а для проекта нужен набор от десятков до сотен. Методика роста простая и скучная, как всё работающее. Каждая новая фича приносит свои вопросы: добавил фильтры по отделам, заведи вопросы «найди регулямент только для ИТ». Каждый инцидент в бою превращается в вопрос «что искали перед тем, как всё сломалось»: это самые ценные строки набора, потому что они реальные, а не придуманные автором курса. Настоящие вопросы пользователей почти всегда неудобнее тех, что генерирует автор учебника, и именно они ловят то, что удобные вопросы пропускают.
Отдельный слой оценки поверх retrieval-метрик: качество ответа целиком. Библиотеки вроде RAGAS и схемы с LLM-судьёй проверяют верность ответа найденным документам и полноту покрытия вопроса. Наш трекер со split_claims и обратным вопросом из предыдущего раздела решает ту же задачу руками; RAGAS это то же самое, оформленное в библиотеку с готовыми промптами и отчётами. Используй оба слоя, но не путай их: retrieval-метрики говорят, найдены ли документы, метрики ответа говорят, хорошо ли из них собран ответ.
Критерий готовности
- Объяснил, почему retrieval-метрики и метрики ответа это два разных слоя, и что ломается без каждого из них.
- Посчитал recall@k, MRR и nDCG вручную на мини-примере и получил те же числа, что и код.
- Написал свой eval-раннер на золотом наборе из модуля 03, прогнал его и получил exit-код 0 на baseline.
- Специально сломал поиск, поймал регрессию с exit-кодом 1 и вернул систему к исходному поведению.
- Описал, как раннер встаёт в CI: абсолютный порог, дельта против основной ветки, блокировка merge при падении.
Чеклист самопроверки
- Чем recall@k отличается от precision@k и почему для RAG чаще смотрят именно recall?
- Когда MRR достаточно и почему MRR занижает оценку широких вопросов с несколькими релевантными документами?
- Что даёт логарифмический дисконт в nDCG и зачем нужна нормировка на идеальный порядок?
- Почему пересечение токенов ответа с контекстом не заменяет LLM-судью для faithfulness?
- Почему retrieval-метрики гоняют на каждый PR, а faithfulness и answer relevance по расписанию?
- Как правильно поднять порог в CI, чтобы не потерять защиту от регресса?
Материалы главы: текст главы в репо · код · иллюстрации · подписка на обновления курса