
Опубликовано
От цепочек к графам: LangGraph и цена свободы
Автор: Гусев Николай [портфолио]
Обновлено
Третья часть цикла: цепочке нужна память
Третья часть цикла по книге AI Agents and Applications Роберто Инфанте (Manning, 2026). Главы 1-2 разбирали фундамент, главы 3-4 - суммаризацию с живым замером. Теперь глава 5 книги: LangGraph, и главный вопрос - когда линейной цепочке перестаёт хватать.
Серия выходит раз в 1-2 дня, пометки: #AI_Agents_and_Applications #глава_3.
Два паттерна: workflow и агент
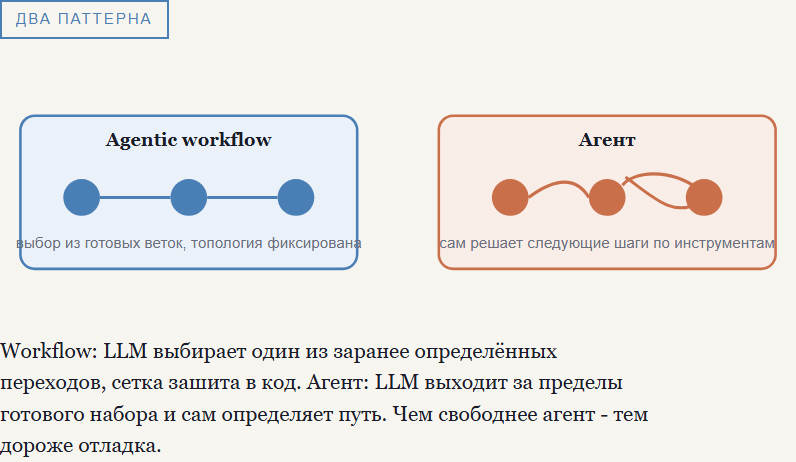
Автор вводит развилку, уточняющую вопрос из первой части. Agentic workflow: LLM выбирает один из заранее определённых переходов, топология сети зашита в коде. Агент: LLM выходит за пределы готового набора и сам определяет следующие шаги по инструментам и контексту. Обе схемы управляют поведением приложения через модель, но путь workflow предсказуем, а агент адаптируется в реальном времени.
Чем свободнее агент - тем дороже отладка и тем нужнее наблюдаемость. Это вторая половина критерия из главы 1: свобода не только стоит денег за токены, она стоит времени инженера.
Почему цепочке становится тесно
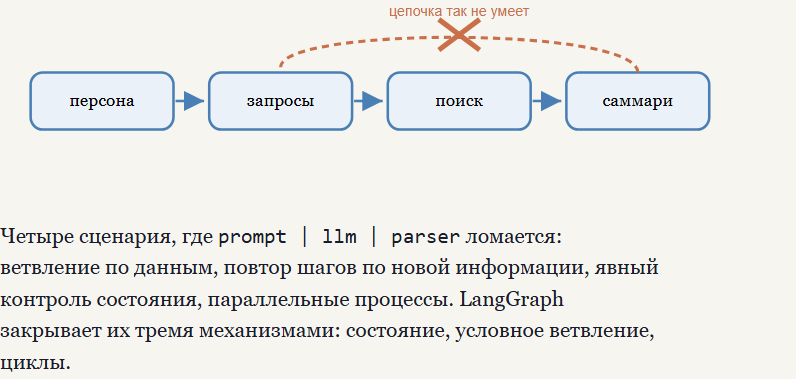
Каноническая цепочка LangChain - prompt, затем llm, затем parser. Она ломается на четырёх сценариях: развести задачу по веткам в зависимости от данных, повторять шаги по мере поступления информации, держать состояние явно на протяжении всего прохода, исполнять процессы параллельно.
Главный сценарий для агентных задач - цикл. Research-агент из главы 4 построен как пять последовательных шагов: персона, запросы, поиск, саммари, отчёт. Если поиск вернул мусор, у цепочки нет способа вернуться и перегенерировать запросы - поток строго вперёд.
Три слова, на которых стоит LangGraph
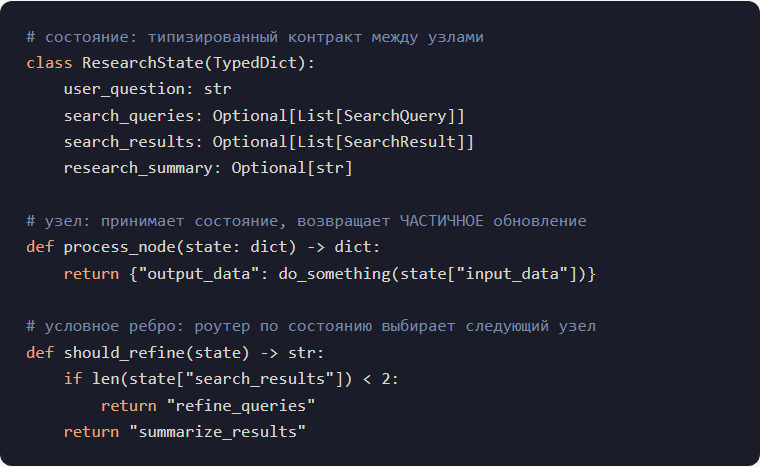
Минимальный словарь невелик: TypedDict для состояния, StateGraph, add_node, add_edge, add_conditional_edges, set_entry_point, END, compile. За ним три контракта.
Состояние - типизированный объект, общий для всех узлов. В примере книги это ResearchState: вопрос, запросы, результаты, саммари, отчёт. Типизация не украшение - она ловит рассогласование полей при чтении кода, а не в рантайме.
Узел принимает состояние и возвращает частичное обновление: изменённые поля мержатся, всё состояние не подменяется. Это правило, к которому глава вернётся с нарушением.
Рёбра бывают трёх видов: линейные задают порядок, условные вызывают функцию-роутер, которая по состоянию решает имя следующего узла, терминальные объявляют конец. Условное ребро - самая ценная часть API для агентных сценариев.
Research-агент становится графом
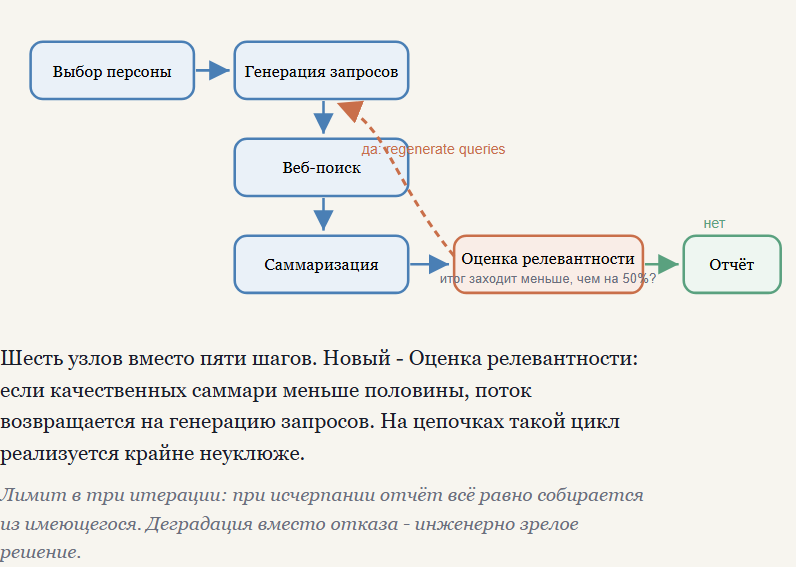
Пять шагов из главы 4 превращаются в шесть узлов. Новый узел - Оценка релевантности: он проверяет, достаточно ли качественных саммари среди результатов. Если нет - поток возвращается на генерацию запросов. Сверка с книгой (раздел 5.5, листинг 5.4): роутер route_based_on_relevance при исчерпании лимита отправляет поток в write_research_report, иначе при флаге should_regenerate_queries - назад на generate_search_queries.
Лимит - три итерации. При исчерпании отчёт собирается из того, что есть. Деградация вместо отказа - инженерно зрелое решение, и оно стоит внимания как паттерн.
"Заметки на полях". У меня почти весь этот словарь уже собран, но руками и на разных стеках. Jev-триаж - условное ребро в чистом виде: модель-классификатор смотрит на письмо и возвращает маршрут action / read_later / archive / promo, две проверки идут параллельно одним запросом. Как она устроена и как её проверяли: Четыре eval для модели решений Jev и Открытая альтернатива Jev: два чекпойнта Laya.
auto-rag - параллельные узлы: fan-out по коннекторам с health-чеками и скипами по состоянию запроса, плюс роутер по доменам на входе. А цикл руками собран в домашнем Perplexity: часть 1, сборка, часть 2, кто думает. Схема там такая: шаг 1 "что такое X", шаг 2 "свяжи X с Y, вот твой ответ про X" - состояние передаётся явно, просто на циклах Python, без фреймворка.
Типизированное состояние со стадиями segment, extract, merge, ground, validate, render и fail-closed на каждой стадии - это meeting-intelligence, конвейер разбора встреч Штурмана. Он открыт, репозиторий на GitFlic: gitflic.ru/project/manve-sulimo2/shturman-meeting. Второй такой же конвейер - аналитика Telegram-экспортов в закрытом проекте kolika: те же стадии, привязанные к типам сообщений, с кэшем сегментов по хэшу промпта. Принцип тот же: каждая стадия принимает типизированный объект и возвращает частичный результат, валидация стоит на выходе каждой.
Замыкать цикл оценкой качества я тоже пробовал: eval для Jev гонялся не абстрактно, а под конкретную задачу - золотая разметка, замер точности на реальных письмах, стоимость на прогон. Так что не "нигде нет" - есть осознанный разрез. Автоцикл "оценил и перегенерировал" я в проде не ставлю по двум причинам из главы 3: каждая итерация удорожает запрос, а refine в наивной реализации ловит recency bias - мы поймали это на живом замере, черновик забывал начало. Оценка качества живёт отдельным шагом с отчётом, а не внутри цикла - когда цикл нужен, его запускают руками с уже известной ценой.
Ловушка в коде самой книги
Роутер из листинга 5.5 инкрементирует счётчик мутацией словаря прямо в условном ребре: берёт iteration_count из состояния, прибавляет единицу и записывает назад в тот же словарь. Это противоречит собственному правилу главы: узлы возвращают частичное обновление, состояние не мутируется. Если движок передаёт роутеру копию словаря - что подпись state: dict только поощряет - счётчик в графе не изменится. Защитный лимит не сработает, и цикл станет бесконечным.
Правильное решение: счётчик живёт в состоянии и обновляется в узле, либо роутер возвращает пару маршрут плюс обновление. Место, где граф обещает воспроизводимость, - именно там авторский код её ломает.
Что это даёт и когда переходить
Все выигрыши из раздела 5.5.4 растут из одного корня: явное состояние делает систему наблюдаемой. Прозрачная обработка, модульность, видимый порядок исполнения, локализация узкого места, точечная обработка ошибок, дешёвое расширение. Плюс слабо раскрытый бонус: граф хранит историю исполнения - инспекция траектории, повтор из чекпоинта, ветвление от прежних решений.
Критерий перехода: граф нужен там, где линейной цепочке не хватает явного состояния, ветвления по результату и цикла. Если ветвление перечислимо и возвратов нет - цепочка остаётся дешевле. Мой рабочий ответ по нашим системам: auto-rag и kolika остаются workflow без циклов сознательно, perplexity-deep получает выгоду от явного состояния при первом же усложнении шагов.
Продолжение - главы 6-7 книги: RAG в глубину, семантический поиск, векторные хранилища и RAG с нуля.
Книга: AI Agents and Applications (Roberto Infante, Manning, 2026), глава 5.
#AI_Agents_and_Applications #глава_3