
Опубликовано
RAG в глубину: 94 колонны и главная ловушка
Автор: Гусев Николай [портфолио]
Обновлено
Четвёртая часть цикла: та же архитектура, что у нас в проде
Четвёртая часть цикла по книге AI Agents and Applications Роберто Инфанте (Manning, 2026). Главы 6-7 книги - RAG в глубину и Q&A-чатботы. Предыдущие части: фундамент и промпты, суммаризация с живым замером, LangGraph.
Серия выходит раз в 1-2 дня, пометки: #AI_Agents_and_Applications #глава_4.
Галлюцинация на проверяемом числе
Автор открывает главу не кодом, а числом. Загружает статью Britannica о Паестуме в ChatGPT, спрашивает про колонны храмов. Модель уверенно выдаёт 94 (32+30+32). У храма Hera I реально 50. И это не выдуманный пример для страшилки: число проверяется за минуту.
Второе наблюдение тоньше: модель ответила про объект Всемирного наследия ЮНЕСКО, которого в загруженном тексте не было. LLM не различает "сказано в контексте" и "я знаю извне". Отсюда вся методология двух глав: сузить контекст до релевантного и добавить в промпт запрет домысливания.
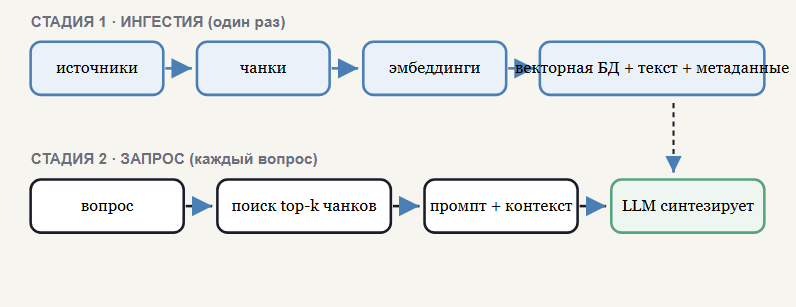
Разделение ролей, которое половина обзоров размывает: векторная БД не генерирует ответ - она возвращает ближайшие чанки. Платная LLM вызывается только на синтезе. Поиск бесплатный.
Наш замер против таблички из книги
В книге показателен эксперимент на трёх моделях: наивный промпт "прочитай и ответь" - GPT-5-nano честно говорит, что числа в тексте нет, а GPT-3.5-turbo выдаёт 24 выдуманные колонны с правдоподобной разбивкой. Лечится защитным промптом, и самая рабочая его часть - не абстрактный запрет "не выдумывай" (модель его игнорирует), а ложный антипример: "не говори, что храмов три, а колонн три". После антипримера обе модели отказываются корректно.
"Заметки на полях". Тот же эксперимент мы делали на российских моделях, в разы жёстче. В замере YandexGPT против GigaChat на 38 задачах была ловушка F01: вопрос о статье 74.1.1 ТК РФ, которой не существует. Четыре версии GigaChat уверенно процитировали несуществующую норму с размерами компенсаций, одна ушла в рассуждения, одна отказалась корректно. Обе яндексовские модели ответили отказом правильно. То есть поведение из главы 6 книги мы видели один в один - но на 38 задачах, с золотой разметкой и с разбором, почему авто-чекер поначалу не засчитал корректный отказ YandexGPT: в списке его маркеров отказа не было формулировки "не содержится". Подробный разбор: YandexGPT против GigaChat: 38 задач.
От библиотек к БД - и дальше
Глава даёт эволюцию хранилищ: библиотеки (FAISS) держали всё в памяти, неизменяемо, текст хранили отдельно. Векторные БД закрыли три проблемы: текст, эмбеддинг и метаданные в одной записи, полный CRUD, поиск во время импорта. Дальше pgvector и MongoDB Atlas добавили векторы в обычные записи.
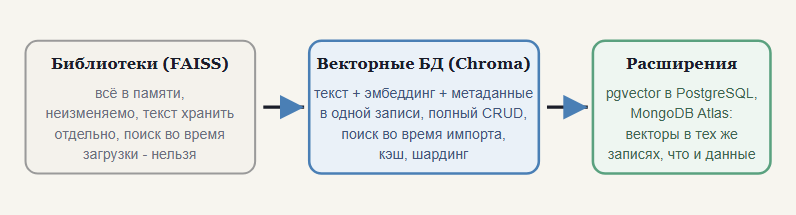
"Заметки на полях". Таблица 6.1 в книге (FAISS, Milvus, Qdrant, Chroma, Pinecone, pgvector) - снимок корпоративного рынка, и по нашему опыту она неполная. Первое: in-process движки. Наш auto-rag работает на ZVec - локальный HNSW-поиск, bge-m3, 1024 размерность, коллекция это папка на диске, ноль серверов и ноль сети - для закрытого контура это первый критерий, а таблица такие движки не упоминает. Второе: файловые форматы памяти. Memvid кодирует эмбеддинги и текст в кадры видео - вся память в одном файле, переносится и архивируется; мы писали об этом отдельно. Отдельная статья: memvid: память для AI-агентов в одном файле. Третье: гибридный поиск. Книга упоминает связку лексического и плотного поиска минимально, а для точных фактов, имён и номеров она почти всегда выигрывает - наш entity match поверх dense собран именно поэтому.
Шесть прогонов, одна коллекция
Самое ценное в этих главах для нас мы получили не из текста, а из собственный ошибки при разборе этой книги.
Индексировал книгу через ZVec: запустил фоновую индексацию 614 чанков и не убил процесс, затем несколько раз стартовал новые прогоны с очисткой. Итого шесть параллельных прогонов в одну коллекцию. Симптом: все 614 документов получили один и тот же вектор - попарный косинус между любыми двумя равен единице, уникальных векторов один из пятидесяти. При этом статистика коллекции показывала норму, и поиск внешне работал: у всех результатов score около 0.55.
Первый вывод был неверный: "ZVec на Windows нерабочий". Изоляция экспериментом его опровергла: тот же код, те же 614 чанков, свежее имя коллекции - 50 из 50 корректных векторов. Виновато состояние каталога, накопленное параллельными прогонами, а не библиотека.
Фиксы: lock-файл в скрипте, optimize после вставки, самопроверка индекса (отказ отдавать его при битых векторах) и правило: перед новой индексацией проверять живые процессы, а не только lock-файл.
Этот эпизод - иллюстрация к учебному примеру из книги, который занимает три строчки: создать коллекцию, добавить документы, спросить. В жизни ингестия сразу параллелится - и "векторная БД с CRUD" не защищает от самого себя.
Память диалога и злое местоимение
Follow-up "And then, what they do?" на боте без памяти улетает в сирен из "Одиссеи": у местоимения "they" нет антецедента. Решение из книги: контекст из векторной БД кладётся в промпт под роль assistant - так извлечённый текст выглядит как уже сказанное в диалоге, а не как инструкция пользователя. История копится отдельно и подставляется при каждом вызове.
Цена видна в токенах: с ростом истории каждый вопрос дорожает. Вывод книги: скользящее окно или сжатие истории в саммари. Это ровно то, как устроена память Hermes - компрессия вместо бесконечного контекста.
Отладка: что показал трейс
Панель LangSmith даёт трёхпанельный разрез: трейсы слева, шаги выбранного трейса в центре, вход и выход каждого шага справа. Практическое правило: клик по шагу ретривера показывает, какие документы вернул поиск. Нет нужного чанка в выходе ретривера - чинить индексацию, промпт бессмысленно трогать.
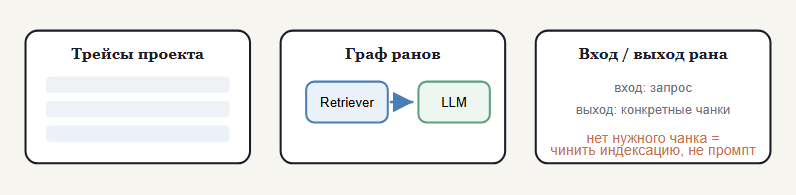
"Заметки на полях". Мы для наблюдаемости используем Langfuse self-hosted на своём контуре: те же трейсы LLM-вызовов, расход токенов, вызовы инструментов - но без отправки фрагментов пользовательских документов во внешнее облако. Для закрытого контура это не вкусовщина, а требование: трейсы содержат куски реальных документов. Langfuse у нас задействован в двух местах: как трейсер поверх Hermes и внутри PII Guard - проекта санитизации запросов к LLM по 152-ФЗ, где трейсы нужны для отладки маскирования, а история маппинга для обратной подстановки в трейсы не пишется принципиально. Тот же подход применим и здесь: видно, на какой стадии санитизации что замаскировано и что ушло в модель.
Критерий, который стоит забрать
Качество RAG определяется качеством чанков и релевантностью выдачи, а не формулировкой промпта. Соблазн чинить плохие ответы промптом при плохом поиске - главная ловушка этой области. Разбивка трейса на шаги в трейсере существует именно для того, чтобы её обойти: сначала посмотри, что вернул поиск, и только потом суди о формулировке ответа.
Второе из этих глав: диагностика через изоляцию. Наша битая коллекция и их галлюцинация с колоннами лечатся одинаково - отделить переменную. Свежая коллекция отделила библиотеку от состояния, другая модель отделила промпт от склонности к выдумыванию.
Продолжение - главы 8-10 книги: продвинутый RAG. Стратегии чанкинга, гибридный поиск, rewrite-retrieve-read, HyDE и self-querying.
Книга: AI Agents and Applications (Roberto Infante, Manning, 2026), главы 6-7.
#AI_Agents_and_Applications #глава_4