Опубликовано
Словарь LLM: от цепи Маркова до каталога моделей
Автор: Гусев Николай [портфолио]
Темы: llm, inference, quantization, moe, tutorial
Автор: Гусев Николай.
Подписчик написал: «Коля,очень интересно, но ничего не понятно, "я ничего не понял, но ты достучался до моего сердца" буквально :) "». Справедливо. Я пишу про замеры, а читатель видит набор аббревиатур. Ну и Фейнман говорил, что можно выучить название птицы на всех языках мира и всё равно не знать, куда она летает и что ест. Дальше будет про полёт и еду. Названия тоже будут, но после механизма.
Один уговор. Если после раздела вам всё ещё непонятно, значит виноват текст, а не вы. Пишите, перепишу.
Цепь Маркова: машина, которая ничего не понимает
Начнём с самой тупой модели языка, какая бывает.
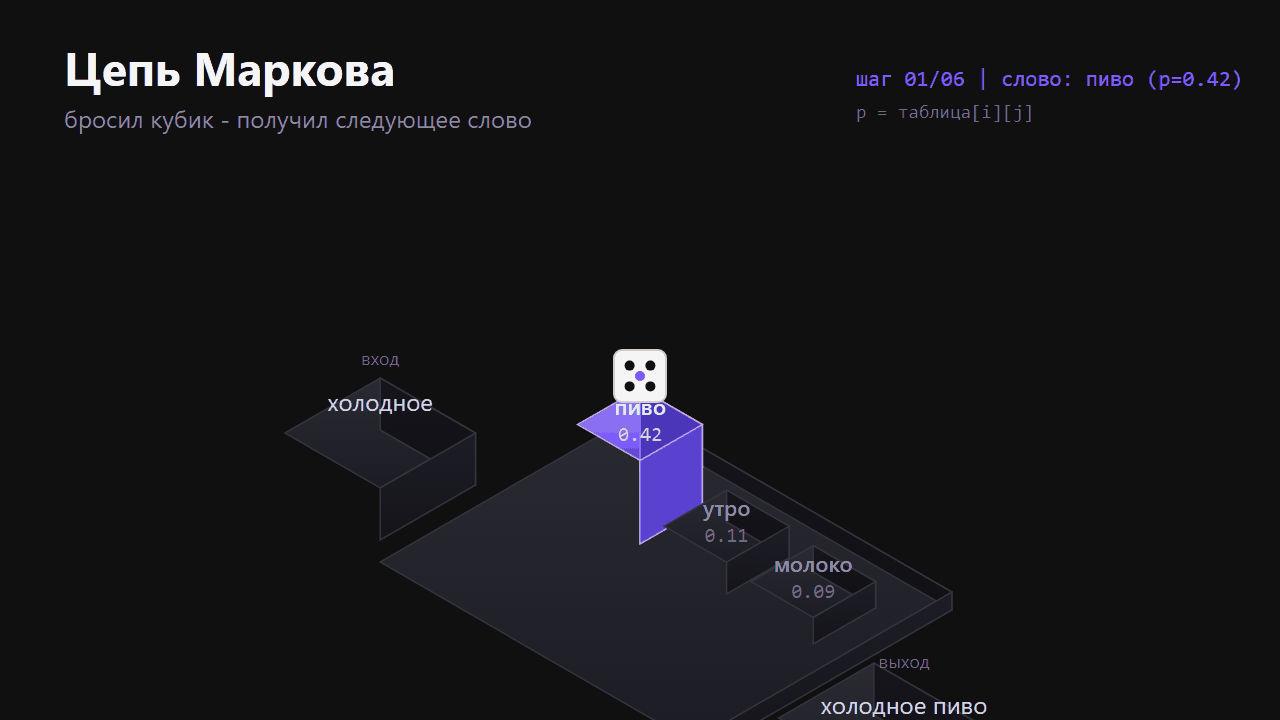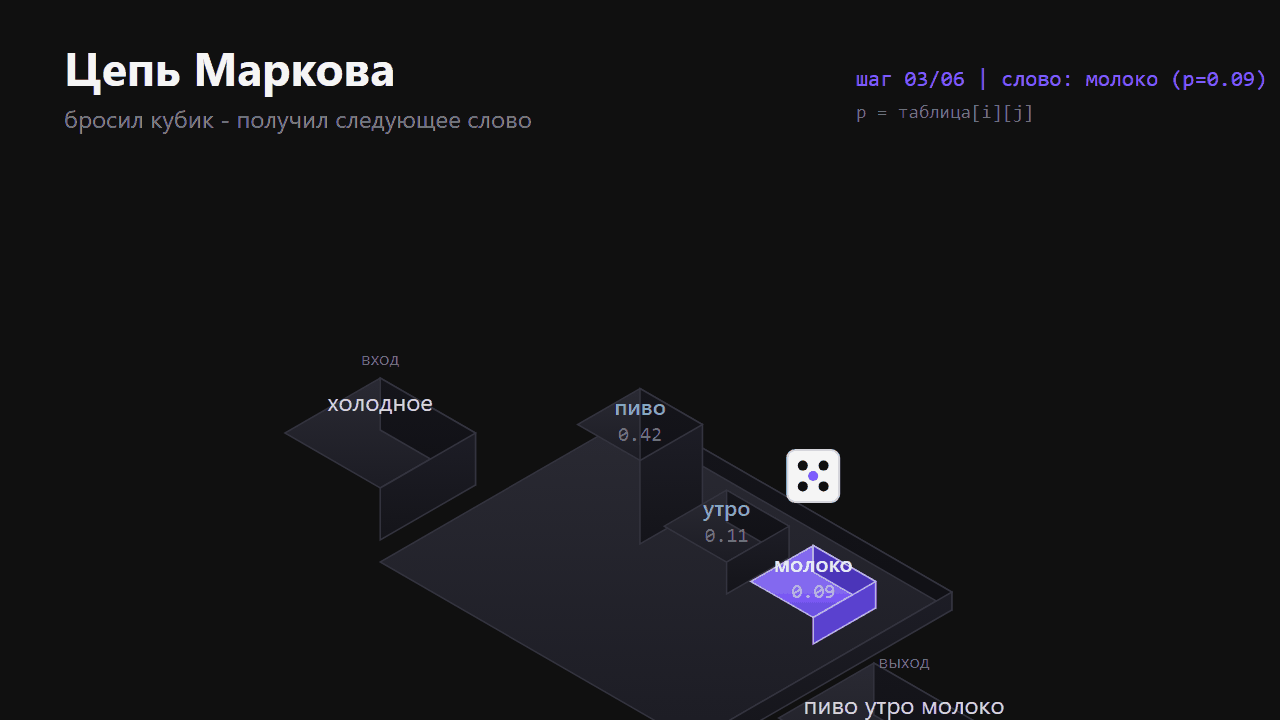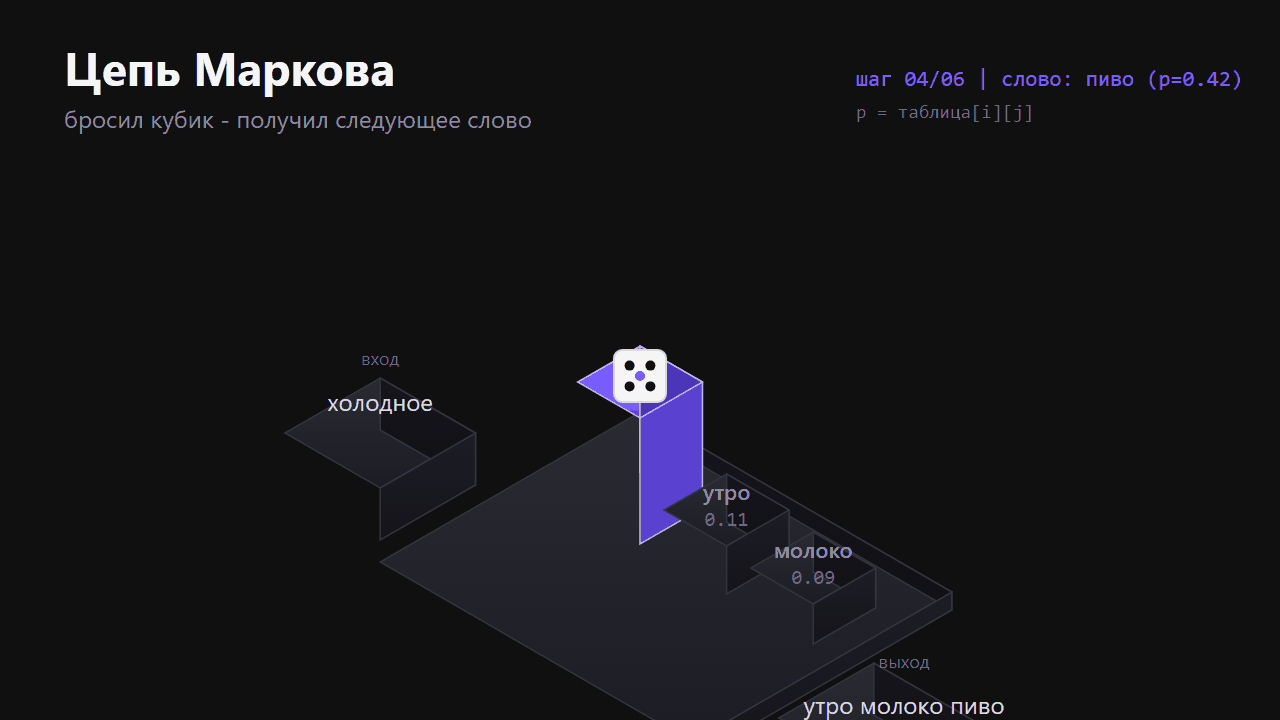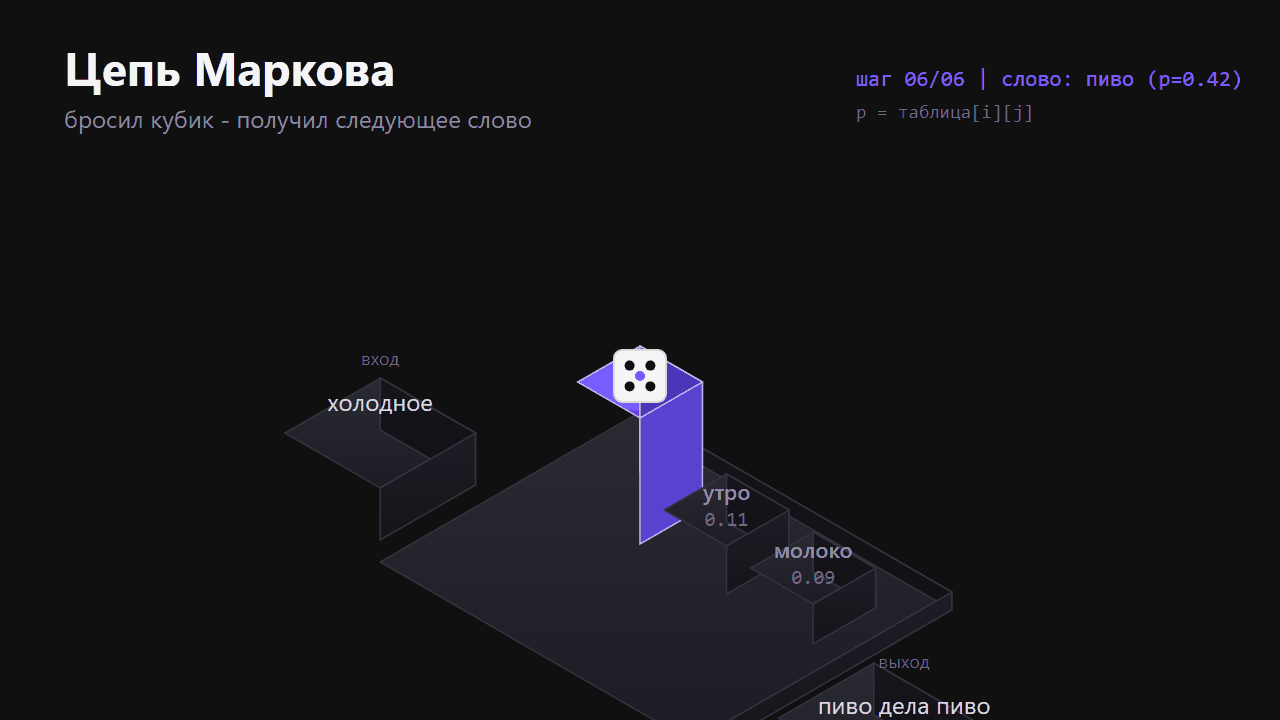
Возьмите текст и посчитайте, какое слово чаще всего идёт после слова «холодное». В кулинарных книгах это будет «пиво». В учебнике физики - «тело». Модель, которая просто держит такую таблицу пар, называется цепью Маркова первого порядка. Она ничего не знает про смысл. У неё есть статистика: после этого слова обычно идёт вот то.
Работает она так. Берём таблицу:
"холодное" -> "пиво" 0.42
 -> "утро" 0.11
 -> "молоко" 0.09
 -> ... остальное
Кидаем кубик по этим вероятностям, получаем слово, смотрим следующую строку таблицы, снова кидаем. Получается текст. Иногда смешной, иногда бессмысленный, но синтаксически похожий на исходный корпус.
Если эта схема кажется абстракцией из учебника - вы носили её в кармане лет пятнадцать. Т9 в кнопочных телефонах работала ровно так же: таблица «какое слово чаще идёт после этих двух» плюс ваши личные дообучения. И тупила она ровно потому, что видела одно-два предыдущих слова: «привет, как дела» после «привет» могло продолжиться чем угодно, контекста у таблицы нет.
Вся языковая модель, включая ту, что отвечает вам в чате, делает ровно это. Предсказывает следующее слово. Разница в размере таблицы и в том, чем таблица заменена.
Путь от Т9 до ChatGPT занял около двадцати лет и прошёл через три шага. Сначала поняли, что смысл слова можно записать вектором чисел, и похожие слова получают близкие векторы. Потом научили модель читать текст не слово за словом, а через механизм внимания, который смотрит на весь контекст сразу. Потом заменили таблицу переходов нейросетью и стали растить её на всём интернете. Ниже разберём все три шага - они же и есть словарь терминов.
Вот и первое слово словаря. LLM (large language model, большая языковая модель) - функция предсказания следующего токена, обученная на очень большом корпусе. «Большая» относится к числу параметров, то есть к размеру той самой функции.
От таблицы к нейросети: три детали, которых хватает
Три шага с пути от Т9 до ChatGPT в деталях. Внутрь лезть не обязательно, но эти три вещи объясняют всё остальное.
Эмбеддинг. Каждый токен превращается в вектор, набор чисел. Смысл слова в этой геометрии - направление. Близкие по смыслу слова оказываются рядом. Модель работает не с буквами, а с этими числами. Идею показали в 2013 году word2vec-ом: «король» минус «мужчина» плюс «женщина» даёт «королеву», и это арифметика над векторами, а не над словами.
Внимание. Главный механизм трансформера, представленного в 2017-м. Каждый токен смотрит на предыдущие и решает, какие из них важны для предсказания следующего. Слово «оно» в предложении находит то существительное, к которому относится, через внимание. Именно это позволило модели держать связность на длинных кусках текста, чего цепь Маркова и Т9 не умеют в принципе: у них контекст - одно-два слова, здесь - весь текст.
Слой. Набор операций: внимание плюс небольшая нейросеть, которая обрабатывает каждый токен отдельно. Слои складываются в стопку. У Qwen3.8-27B их 64, у GLM-5.3 - 78, у MiniCPM-V-4.7-1B - 24. Каждый слой уточняет представление, к концу стопки модель знает достаточно, чтобы выдать вероятности следующего токена.
Всё остальное в архитектуре - оптимизация этих трёх деталей под скорость, память и качество. Отсюда растут все аббревиатуры, которые вас пугают.
Токен: почему цифра tok/s врёт
Слова в модели не целиком. Текст режут на куски, которые называются токенами. Английское слово часто один токен. Русское слово часто два или три, потому что обучающий корпус был в основном английским, а кириллица досталась модели по остаточному принципу.
Пример. Слово «квантование» может развалиться на «кван», «това», «ние». Три токена вместо одного.
Отсюда первый практический вывод, который ломает половину сравнений в интернете. Метрика tok/s (токенов в секунду) считает токены, а не слова и не смысл. Если у модели русский токенизатор в три раза хуже, она покажет те же 40 tok/s и выдаст втрое меньше текста за минуту.
Я на это наступал. В серии про спекулятивное декодирование пришлось выкинуть tok/s из метрик: ускорение токенов там шло вместе с порчей ответов, и мерилом стали корректные ответы в минуту. Проверка спекуляции на одной 4060.
Самый наглядный пример из моих замеров - Яндекс. Их модель обучали преимущественно на русских и английских текстах, и токенизатор строили под русский с самого начала. В карточке YandexGPT-5-Lite на HuggingFace это сказано прямо: 32 тысячи токенов этой модели в среднем соответствуют 48 тысячам токенов Qwen-2.5. Один и тот же текст у Яндекса занимает в полтора раза меньше единиц.
Я это проверил на живом замере: 38 задач, восемь русских моделей, счётчик prompt_tokens на одних и тех же текстах. YandexGPT уложил промпты в 42-43 токена в среднем, GigaChat-3 в 47. Разрыв небольшой, зато он копится: на миллионе запросов это разница в счёт. 38 задач, 8 русских моделей: YandexGPT и GigaChat в одном замере.
Дальше разрыв стал страшнее. В замере на 519 живых запросах русский токенизатор Сбера жал кириллицу в 2 раза плотнее Qwen, в 3 раза плотнее Kimi K3 и в 9 раз плотнее Grok 4.6, хотя у последнего часть разрыва даёт служебный префикс в две сотни токенов. Один и тот же запрос про sunglasses: 23 токена у GigaChat-3 и 217 у Grok. Русский токенизатор GigaChat против открытых моделей.
Отсюда правило для русского трафика. Цену за миллион токенов можно сравнивать только внутри одного токенизатора. Между разными сначала пересчитайте на своём тексте, иначе вы сравниваете километры с милями и удивляетесь, почему счёт не сходится. С tok/s то же самое: между моделями с разными токенизаторами он меряет скорость движка, а не скорость работы.
Второе следствие. Контекст, окно, лимит - всё это тоже в токенах. Когда говорят «контекст миллион», имеют в виду миллион токенов, а это примерно 700 тысяч слов по-английски и заметно меньше по-русски. Точное число зависит от токенизатора конкретной модели.
Prefill и decode: две разные машины в одном корпусе
Это первое место, где менеджер обычно теряет нить, а зря. Тут лежит половина счёта за инференс.
Когда вы отправляете запрос, модель сначала читает весь ваш текст целиком. Этот этап называется prefill (предзаполнение). Токены обрабатываются параллельно, потому что все они уже известны. Работа похожа на матричное умножение большого размера: загрузили GPU и считаете.
Потом модель начинает отвечать. И тут же всё меняется. Каждый следующий токен зависит от предыдущих, поэтому считать приходится по одному. Это decode (декодирование). GPU занят целиком, а полезной работы мало: одно слово за шаг. Именно поэтому генерация всегда медленнее чтения.
Отсюда метрика TTFT (time to first token, время до первого токена). Она меряет prefill. Пользователь видит её как задержку перед началом ответа. Если TTFT большой, дело в длинном запросе, а не в медленной генерации.
Для менеджера это переводится так. Длинный документ на входе бьёт по TTFT, длинный ответ на выходе бьёт по общей длительности. Это два разных бюджета, и оптимизируют их разными способами. Prefill ускоряют кэшированием префикса и распараллеливанием. Decode ускоряют батчингом и спекулятивным декодированием, о котором ниже.
Хороший пример из моих замеров: PFlash на самосборном Lucebox дал 5.34× на префиксе и 1.84× end-to-end при контексте 96K, ответы совпали с upstream до символа, NIAH 100% во всех точках. Разница между этими двумя цифрами и есть разница между ускорением prefill и ускорением всего ответа: 27.7 секунды против 51 у обычного llama.cpp на том же промпте. От 96K до следующего класса железа: Lucebox, EAGLE-3, MLX и ROCm.
KV cache: почему длинный контекст стоит денег
При decode модель на каждом шаге пересчитывает внимание ко всем предыдущим токенам. Если этого не оптимизировать, генерация тысячного токена была бы в тысячу раз дороже первого.
Поэтому промежуточные результаты внимания сохраняют. Этот сохранённый массив называется KV cache (кэш ключей и значений). Он живёт в видеопамяти и растёт линейно с длиной контекста. Каждый токен добавляет свою порцию.
Порцию можно посчитать по конфигу модели, и это лучший способ понять, почему «контекст миллион» - маркетинг, а не обещание. Формула простая: два (ключи и значения) умножить на число слоёв с полным вниманием, умножить на число KV-голов, умножить на размер головы, умножить на два байта.
Считаю на живых конфигах, данные из карточек HuggingFace на 18 октября 2026.
| Модель | Слоёв с полным вниманием | KV-голов | Байт на токен | 32K контекста | 256K контекста |
|---|---|---|---|---|---|
| Qwen3.5-4B | 8 из 32 | 4 | 32 КБ | 1.0 ГБ | 8.0 ГБ |
| Qwen3.8-27B | 16 из 64 | 4 | 64 КБ | 2.0 ГБ | 16.0 ГБ |
| MiniCPM-V-4.7-1B | 6 из 24 | 2 | 12 КБ | 0.4 ГБ | 3.0 ГБ |
Смотрите на первую строку. У Qwen3.5-4B всего 8 слоёв из 32 считают полное внимание, остальные 24 - линейное, которое кэш почти не тратит. Поэтому 256 тысяч токенов стоят 8 гигабайт, а не 32. Это и есть инженерный смысл слова «гибридное внимание»: не красивое название, а конкретная экономия памяти.
Теперь тот же расчёт для большой модели. Условная плотная модель на 70 миллиардов параметров с 80 слоями и 8 KV-головами даёт около 320 килобайт на токен. Миллион токенов - это 320 гигабайт только под кэш, без весов. Отсюда два вывода. Первый: провайдеры берут деньги за длинный контекст не из жадности. Второй: обещание «миллион токенов» обычно означает «миллион токенов при определённой архитектуре и цене за токен», а не «засуньте миллион и работайте как обычно».
Разные модели решают это по-разному, и в топе каталога представлены три разные школы.
Сжать сам кэш. DeepSeek в V4.1-Flash хранит ключи и значения в формате FP4: каждое число вместо 16 бит занимает 4, с таблицей поправок на каждые 16 каналов. Кэш падает до 890 байт на токен, примерно четверть от предыдущей версии модели.
Считать внимание по выборке. GLM-5.3 на каждый токен сперва лёгкий поисковый индекс выбирает 2048 самых релевантных прошлых токенов, и полное внимание считается только по ним. Остальная история лежит в памяти, но в вычислениях не участвует.
Заменить растущий кэш сжатой памятью. Kimi K3 построен на Kimi Delta Attention: 69 слоёв из 93 держат не список всех прошлых токенов, а фиксированную матрицу-конспект, которая переписывается дельта-правилом. Новая информация не дописывается в конец бесконечного списка, а вписывается в конспект с поправкой. Кэш таких слоёв не растёт с длиной контекста. Полное внимание осталось на 24 слоях.
Сюда же относится четвёртый приём, скользящее окно: часть слоёв смотрит не на всю историю, а на последние N токенов. Так устроены gpt-oss (18 слоёв из 36, окно 128) и Gemma-4 (25 из 30, окно 1024). А гибрид из таблицы выше - тот же ход, что у Kimi, только с обычным линейным вниманием вместо дельта-правила.
Все эти механизмы воюют за одно и то же: за память под контекст. Поэтому вопрос «сколько стоит длинный запрос» и вопрос «какая там схема внимания» - это один вопрос.
Контекст: что значит миллион токенов
Контекстное окно - сколько токенов модель держит в работе одновременно. Всё, что за пределами, она не видит.
Сегодня миллион токенов стал стандартом в каталогах: Qwen, DeepSeek, Kimi, GLM, Gemini, GPT-6 все показывают около миллиона. Это примерно 700 тысяч слов английского текста. Роман «Война и мир» - около 590 тысяч слов.
Но есть три вещи, которые в рекламе не пишут.
Первая - цена. Провайдеры берут деньги за каждый входной токен, а кэш на миллион стоит памяти. У некоторых моделей в каталоге есть отдельный тариф при превышении ста тысяч токенов: цена входа вырастает в разы.
Вторая - качество. Модель, которая формально видит миллион токенов, не обязательно одинаково хорошо работает в середине этого миллиона. Проверять надо на своей задаче.
Третья - KV cache, который мы считали выше. Чем длиннее контекст, тем больше памяти нужно на каждый параллельный запрос. Отсюда ограничения на число одновременных пользователей.
У длинного контекста есть и ценовой приём: кэширование префикса. Провайдер помнит ваш системный промпт и историю между запросами и берёт за повторное чтение кэша в разы меньше. В каталоге OpenRouter такая цена есть у 311 моделей из 471. Разброс большой: MiMo от Xiaomi читает свой кэш в 120 раз дешевле свежих токенов, DeepSeek в 50 раз. Если ваш сценарий - длинный системный промпт и много коротких запросов поверх него, это первый вопрос поставщику.
Практический приём, который экономит больше, чем любое железо: не засовывайте в контекст всё. Разбейте задачу, достаньте нужные куски поиском, отдайте модели только их. Это называется RAG (retrieval-augmented generation, генерация с подгрузкой найденного). Работает дешевле и точнее, чем «загрузим весь архив в миллион токенов».
Dense и MoE: 35B, которое работает как 3B
Прежде чем разбирать, карта. У модели несколько независимых осей, и «типов моделей» поэтому не два, а больше. По тому, как модель хранит память о диалоге, мы уже прошли: полное внимание, гибридное, разреженное, линейное - это была ось из раздела про KV cache. Этот раздел - про вторую ось, плотность параметров: dense и MoE. Дальше будет третья, упаковка весов: квантование. И четвёртая, тип выхода: текст, векторы, вероятности, картинки - она появится в разделах про спецмодели и decision-модели. Оси не исключают друг друга, и к концу статьи это станет привычкой: про любую модель спрашивать по каждой оси отдельно.
Теперь - плотность, главный источник путаницы в названиях моделей.
Dense (плотная) модель на каждом токене использует все свои параметры. Qwen3.8-27B - плотная: 27.78 миллиарда параметров, все участвуют в обработке каждого токена. Предсказуемо, просто, дорого.
MoE (mixture of experts, смесь экспертов) устроена иначе. Внутри вместо одного большого блока стоит много маленьких, и на каждый токен выбирается несколько. Маршрутизатор смотрит на токен и говорит: этому нужны эксперты 12, 47 и 203.
Отсюда запись вида 35B-A3B. Читается так: всего 35 миллиардов параметров, на каждый токен активно 3 миллиарда. Активируется A (active), общий размер - первое число.
Зачем так. Память нужна под все параметры, потому что эксперты должны где-то лежать. А вычислений на токен тратится мало, потому что работает только часть. Получается модель, которая по качеству ближе к своим 35 миллиардам, а по скорости - к трёшке.
Что каждая даёт на практике:
| Плотная | MoE | |
|---|---|---|
| Память под веса | только свои параметры | все эксперты сразу, в разы больше |
| Скорость на токен | падает с размером | как у маленькой активной части |
| Качество | ровно уровень своего размера | ближе к полному размеру, а не к активному |
| Задержка | ровная, предсказуемая | скачет: маршрутизация на батче промахивается |
| Развёртывание | просто: одна карта, один файл | капризно: эксперты должны быть под рукой |
| Когда брать | локально, реальное время, узкое железо | сервер или мощная карта, когда нужен максимум качества |
На моей 4060 разница выглядела так. Плотная 27B требует GPU целиком: 7.8 гигабайта весов в мои 6.6 свободных не влезают, и выгружать ей нечего - все параметры нужны на каждом токене. MoE 30B-A3B на той же карте завелась: весит больше, но считает на токен 3 миллиарда, поэтому непомещающихся экспертов можно держать в обычной памяти и подкачивать. Итог: у MoE и память больше, и запуск хитрее, зато качество - уровня 30B при скорости трёшки. Детали вечера: EXL3 на 8 ГБ.
Вот живой пример из карточек. MiniCPM-V-4.7-35B-A3B - 35.2 миллиарда параметров всего, MoE. Авторы заявляют, что модель работает на iPhone 17 Pro Max со скоростью 13 токенов в секунду при трёх гигабайтах памяти. Плотная модель такого размера на телефоне не запустится никогда. Про то, что уже реально тянет средний Android-флагман и какие модели под это брать, - отдельный разбор: мобильные LLM на Android.
Обратная сторона. MoE капризнее в развёртывании: нужно держать в памяти все эксперты, а на батче из разных запросов маршрутизация скачет и кэш процессора промахивается. Отсюда целые техники вроде упреждающего планирования экспертов, которые придумывают специально под мобильный запуск MoE.
Теперь расшифрую названия больших моделей из каталога, все данные с HuggingFace на 18 октября 2026.
| Модель | Параметров всего | Активных на токен | Тип | Лицензия |
|---|---|---|---|---|
| Qwen3.8-27B | 27.8 млрд | все | dense | Apache 2.0 |
| Qwen3.8-2.4T-A95B | 2.45 трлн | 95 млрд | MoE | своя |
| DeepSeek-V4.1-Flash | 552 млрд | 8 млрд на prefill, 16 на decode | MoE | MIT |
| DeepSeek-V4-Pro | 1.6 трлн | не раскрыто в карточке | MoE | MIT |
| Kimi-K3 | 2.78 трлн | 16 экспертов из 896 | MoE | своя |
| GLM-5.3 | 753 млрд | 8 экспертов из 256 | MoE | своя |
| GLM-5.3-Flash | 321 млрд | не раскрыто в карточке | MoE | MIT |
| MiniMax-M3 | 427 млрд | не раскрыто в карточке | MoE | своя |
| Hy4-preview | 780 млрд | не раскрыто в карточке | MoE | Apache 2.0 |
| MiMo-V2.6-Pro | 1.02 трлн | не раскрыто в карточке | MoE | MIT |
| Muse-Spark-Open | 822 млрд | 42 млрд | MoE | своя |
| gpt-oss-120b | 116.8 млрд | около 5 млрд | MoE | Apache 2.0 |
| gpt-oss-20b | 20.9 млрд | около 3.6 млрд | MoE | Apache 2.0 |
Заметьте, насколько разошлись школы. Китайские лаборатории выкладывают веса гигантов: 2.78 триллиона у Kimi, 2.45 у Qwen, 1.6 у DeepSeek. Западные открытые релизы скромнее: 822 миллиарда у Meta, 117 у OpenAI в gpt-oss. У Google открытая линейка Gemma-4 - до 31 миллиарда параметров, включая MoE-версию 26B-A4B со 128 экспертами; суммарно пять её вариантов набрали около 30 миллионов загрузок на HuggingFace. Anthropic открытых весов не отдаёт вовсе.
И последнее про оси. Dense и MoE - это ответ на вопрос «сколько параметров работает на токене». По механизму генерации модели делятся на авторегрессионные, которые пишут токен за токеном, и диффузионные, о которых ниже. По типу выхода - на генераторов текста и моделей, которые текст не пишут вовсе: эмбеддеры, охранники и decision-модели, у которых свой раздел дальше. Оси перемешиваются свободно: Kimi K3 - это MoE и гибридное внимание одновременно, и каждая ось отвечает за своё.
Квантование: 4 бита вместо 16
Параметры модели - это числа. В обученной модели каждое число хранится в 16 битах. Умножьте 27.78 миллиарда параметров на два байта, получите 55.6 гигабайта. Столько нужно, чтобы загрузить Qwen3.8-27B в исходном виде.
Квантование - это сжатие чисел. Вместо 16 бит на параметр берут 4, 8 или сколько влезет, и хранят округлённые значения плюс небольшую таблицу поправок. Качество падает, но не катастрофически, а памяти нужно втрое-вчетверо меньше.
Считаю на той же модели. 27.78 миллиарда параметров:
16 бит (bf16) 55.6 ГБ
8.5 бит (Q8_0) 29.5 ГБ
4.8 бит (Q4_K_M) 16.7 ГБ
Вот почему «27B на домашней карте» - это всегда разговор про квант, а не про модель. И вот почему в моих статьях цифры вроде 8.75 гигабайта на 30B выглядят странно, пока не поймёшь, что это 2.25 бита на параметр. Как я к такой упаковке пришёл и чем она кончилась - EXL3 на 8 ГБ.
Теперь словарь форматов, без которого статьи читаются как ребус.
GGUF - формат файла для llama.cpp и всего, что вокруг него: Ollama, LM Studio, llama-server. Один файл, внутри веса и метаданные. Основной формат для локального запуска на обычном железе.
Q4_K_M, Q8_0, IQ4_XS - схемы квантования внутри GGUF. Буква Q и число означают биты на вес, суффиксы говорят о способе упаковки. Q4_K_M - рабочий компромисс, Q8_0 - почти без потерь, IQ-варианты - хитрее и часто лучше при том же размере.
Отдельная ветка - тернарные веса: каждое число равно минус единице, нулю или единице, то есть честные 1.72 бита на вес без таблиц поправок. Выглядит как издевательство над моделью, но на живом замере тернарная версия Qwen3.8-27B заняла 5.95 гигабайта вместо 54, влезла в 4060 с восемью гигабайтами целиком и держала контекст 64K, с заявленными 98.2% исходного интеллекта. Цена: свой формат PTQ и форк llama.cpp, LM Studio такой файл не откроет. Bonsai 2 27B на RTX 4060.
BPW (bits per weight, бит на вес) - средняя плотность упаковки. Удобная метрика, когда сравниваешь разные схемы: 4.8 bpw и 2.25 bpw различаются не названием, а вдвое меньшим размером файла.
FP8 и FP4 - аппаратные форматы для серверных GPU. Не путать с GGUF: это то, в чём модели выкладывают крупные лаборатории для запуска на H100 и подобном. DeepSeek-V4.1-Flash выложен именно в FP8 с FP4 для экспертов.
EXL3 - формат ExLlamaV3, отдельная ветка для NVIDIA-карт с выгрузкой экспертов MoE на процессор. Живёт в своих файлах, llama.cpp его не читает.
MLX - формат и фреймворк Apple для чипов M-серии. Отдельная экосистема, отдельные кванты.
AWQ и GPTQ - старые схемы квантования для GPU, всё ещё встречаются в карточках моделей.
Для менеджера здесь одно правило. Формат привязан к движку и к железу. Нельзя взять файл EXL3 и запустить его в Ollama, нельзя взять MLX-квант и поставить на Windows с NVIDIA. Прежде чем обещать пилот, спросите, в каком формате модель и на чём её будут запускать.
Открытые веса в GGUF не берутся из ниоткуда: кто-то конвертирует и проверяет каждую свежую модель. Крупнейшая такая витрина - у bartowski: еженедельный срез того, что вышло и какой квант брать, замер недели от 25 сентября. А если нужно подобрать стартовую модель под восемь гигабайт и не наступить на маркетинговые таблицы, у меня есть разбор про цифры 70.6 против 67.3: локальные модели на 8 ГБ.
Движки: кто во что играет
Модель - это файл с числами. Чтобы он отвечал на запросы, нужна программа, которая эти числа считает. Такая программа называется движком, или рантаймом.
llama.cpp - универсальный движок на C++. Работает почти везде: Windows, Linux, macOS, ARM, телефоны. Читает GGUF. Медленнее серверных решений, зато запускается на чём угодно. Именно на нём построены Ollama и LM Studio.
Ollama - обёртка над llama.cpp с удобной установкой и управлением моделями. Для знакомства и для внутренних экспериментов хороша. Для продакшена с нагрузкой обычно нет.
LM Studio - графическое приложение с тем же движком внутри, плюс собственный сервер с OpenAI-совместимым API. Я гоняю замеры именно так.
vLLM - серверный движок для GPU. Главная фишка - эффективный батчинг: много запросов одновременно, память под кэш распределяется динамически. Стандарт для продакшена на NVIDIA.
SGLang - конкурент vLLM с упором на сложные сценарии: ветвление, структурированный вывод, повторное использование префикса.
ExLlamaV3 - движок под свой формат, оптимизирован под NVIDIA и выгрузку MoE-экспертов на процессор.
MLX - фреймворк Apple, работает только на чипах M.
Пока весь список выше - это NVIDIA и отчасти процессор. Два остальных железных мира коротко.
Mac (Apple Silicon). Там единая память: процессор и графика смотрят в один пул, и веса не гоняются по шине туда-обратно - большая модель занимает всю память машины целиком. Инструменты свои: MLX - фреймворк Apple, и Uzu - движок на Rust поверх Metal, позиционируется для встраивания в приложение, MIT. Uzu на GitHub. Замеры с NVIDIA-карт на Mac переносятся только как гипотезы: другой граф, другие точки насыщения, другой батчинг.
AMD (ROCm). Открытый аналог CUDA. llama.cpp собирается с HIP/ROCm, у vLLM есть ROCm-сборки. Практический смысл для проверок: если метод ускоряет на CUDA, надо смотреть, что именно ускорилось - алгоритм или конкретные NVIDIA-ядра. Мой пример: PFlash внутри Lucebox недоступен на ROCm, и это не опровержение метода, а ограничение backend, но для сравнения платформ это эксплуатационный факт. От 96K до следующего класса железа.
Отдельный класс - движки, для которых выгрузка экспертов не аварийный режим, а основной способ существования большой MoE на скромном железе. Через них я и прошёл своим маршрутом.
ExLlamaV3 умеет выгружать эксперты на процессор, но делает это как операционная система делает своп: вытесненные страницы ходят через файл подкачки со всеми издержками.
Colibri - один C-файл без зависимостей, и в нём диск - первоклассное хранилище, а не своп. Плотная часть модели живёт в обычной памяти, эксперты лежат на NVMe и читаются напрямую, минуя кэш страниц. Роутер предсказывает следующих экспертов с точностью около 71% и подкачивает их параллельно с вычислениями, горячие держит в кэше, историю обращений помнит между запусками. Мои замеры из репорта: от 0.05 токена в секунду на ноутбуке с холодным кэшем до 5.8-6.8 на станции с шестью 5090. EXL3-2: тысяча квантов, один подходит.
FreeToken - open-source движок (Apache 2.0) для больших MoE вроде DeepSeek-V4.1-Flash на потребительских GPU: активные эксперты в видеопамяти, холодные в оперативной, переброска через шину, промахи по выбору - на процессор или через шину, движок сам замеряет пропускную способность памяти и выбирает режим. OpenAI- и Anthropic-совместимый API. FreeToken на GitHub.
Strata - движок, который обещает запуск MoE на 125 миллиардов параметров на одной игровой карте плюс системная память, причём инсталлятор сам проверяет железо и сам говорит, какой размер влезет. На моей связке 4060 плюс 32 ГБ в тот вечер не завёлся, остался в списке на отдельный замер. Честная проверка перед покупкой билета - EXL3 на 8 ГБ.
Практический вывод простой. Для одного пользователя на ноутбуке - llama.cpp в любой обёртке. Для десяти одновременных пользователей на сервере - vLLM или SGLang. Для MoE на одной карте, где эксперты не влезают, - ExLlamaV3, Colibri или FreeToken по объёму памяти и диска. Это не вкусовщина, это разные режимы работы.
Спекулятивное декодирование: угадай и проверь
Помните, что decode выдаёт по одному токену за шаг? Это узкое место.
Идея спекулятивного декодирования простая. Ставим рядом маленькую быструю модель, которая угадывает несколько следующих токенов. Большая модель потом проверяет все догадки за один проход и оставляет те, что совпадают с её собственным выбором.
Если маленькая угадала пять токенов и четыре приняты, большая модель сделала один проход вместо пяти. Ускорение в разы.
Считать надо acceptance rate, долю принятых догадок. По-русски её называют просто acceptance. Чем выше, тем больше выигрыш. И вот здесь начинается интересное, потому что acceptance зависит не от квантования и не от настроек, а от того, насколько хорошо маленькая модель предсказывает большую на вашем типе текста.
Мой замер это показал больно. EAGLE-3 - самый цитируемый метод последних двух лет, заявленный acceptance 0.80-0.88 и ускорение до пяти раз. На русском корпусе у меня вышло 0.17. Не 0.80, а 0.17. Проверил на Q8_0 вместо Q4_K_M, чтобы исключить квантование: 0.17 против 0.18, разница в пределах шума. Итог серийно - 0.64× скорости, то есть замедление.
Вот расшифровка терминов из той серии.
Draft - черновик, набор угаданных токенов. Target - большая модель, которая их проверяет. Acceptance - доля принятых.
MTP (multi-token prediction, предсказание нескольких токенов) - головы внутри самой модели, обученные предсказывать не один следующий токен, а несколько. У Qwen3.5-4B в конфиге прямо есть слой MTP. Нативный MTP у меня дал плюс 40 процентов серийно при acceptance 0.81, бесплатно, без внешней модели. Проверка спекуляции на одной 4060.
DFlash - метод с диффузионным черновиком. На коде дал 1.8×, на документах 0.25×: тот же движок, тот же таргет, другой корпус - и ускорение превратилось в замедление. DFlash: граница применимости.
EAGLE-3 - отдельная лёгкая голова, обученная на скрытых состояниях целевой модели. Тот самый случай с acceptance 0.17 на русском корпусе: EAGLE-3 на 4060.
PFlash - не про спекуляцию в чистом виде, а про предзаполнение длинного префикса. Дал 5.34× на префиксе при 96K контекста в 8 гигабайтах: От 96K до следующего класса железа.
Мораль для менеджера. Любая цифра ускорения из статьи или презентации действительна для конкретного домена, конкретной пары моделей и конкретного типа запросов. Спросите, на каком корпусе мерили. Если ответа нет, цифру делить на два, а лучше не считать вовсе.
Thinking: ответ, за который платят дважды
Последние поколения моделей научились рассуждать. Перед финальным ответом такая модель генерирует внутренний текст: план, проверки, перебор вариантов. Он называется reasoning-токенами. В чате вы его обычно не видите, в счёте - видите.
Размах в каталоге: 341 модель из 471 в OpenRouter поддерживает reasoning. У части провайдеров эти токены тарифицируются отдельно от обычного выхода, причём по цене выхода, а не входа: у Gemini 4 Argon вход стоит 2 доллара за миллион, reasoning и выход - 10. Модель может подумать на десять тысяч токенов и ответить двумястами.
Управлять этим можно косвенно, параметром reasoning effort: low, medium, high. Это не выключатель, а просьба. Отсюда два правила. Стоимость запроса к reasoning-модели нельзя оценить по длине ответа. И если задача простая, дешёвая модель без рассуждений часто выигрывает и по скорости, и по деньгам, потому что не тратит бюджет на размышления об очевидном.
Кого ставить рядом: охранники и генеративные
Два класса моделей живут по другим правилам, и в каталоге их легко не заметить.
Охранники. Маленькие классификаторы, которые стоят до или после большой модели. Prompt Guard от Meta - 86 миллионов параметров и 2.5 миллиона загрузок - читает входящий запрос и решает, не попытка ли это взлома. Qwen3Guard в размерах от 0.6 до 8 миллиардов проверяет и ответы: не выдаёт ли модель то, что нельзя. В продакшен-чате они работают фильтром и стоят копейки по сравнению с основной моделью.
Генеративные. Картинки, звук и видео создают модели другого механизма - диффузионные. Вместо предсказания следующего токена они стартуют со случайного шума и шаг за шагом превращают его в картинку, руководствуясь текстом запроса. Qwen-Image-2.1 - открытый генератор изображений с 11 миллионами загрузок; его ускоренная версия Turbo на одной карте даёт в 2.5 раза быстрее базовой при малой потере качества, замер у меня есть. Qwen-Image-2.1 Turbo: в 2.5 раза быстрее. FLUX.1 от Black Forest Labs - открытая генерация картинок, Wan2.2 - открытая генерация видео. На закрытой стороне в том же каталоге живут Nano Banana у Google и GPT-5-image у OpenAI, Lyria сочиняет музыку, GPT-Audio говорит голосом.
Для менеджера различие простое. Языковая модель стоит за текстовым интерфейсом и не рисует. Генеративная модель не читает ваши документы, она рисует. Пилот «ИИ соберёт презентацию» - это обычно два разных продукта в связке: один пишет текст, второй рисует слайды.
Decision-модели: судья вместо собеседника
Есть класс, который вообще не вписывается в привычную картину «модель пишет текст». Decision-модели, они же Jev-класс по имени модели Jev от TypeSafe AI, отвечают не текстом, а вероятностями по закрытому списку вариантов.
Устройство простое. На вход подаётся состояние дел и схема типизированных вопросов трёх видов: да или нет, выбор одного варианта из нескольких, оценка по шкале. На выходе - вероятность по каждому варианту каждого вопроса, одним проходом. Никакого парсинга свободного текста, никаких «модель забыла запятую и JSON развалился». Калибровку тренируют напрямую: в функцию потерь входит Brier loss, который штрафует именно за неверную уверенность.
Экономика класса в том, что судить проще, чем сочинять. Судье не нужен длинный контекст, цепочка рассуждений и стиль. В замерах из моего разбора: модель на 0.8 миллиарда параметров отвечает за 5 миллисекунд на вопрос, 27B - за 32. За одну неделю октября в открытых весах вышли Cloudflare Clef, OmniJev OneJev от 0.8 до 27B, Jebadiah, ringg-router и FRIDA-Decisions от ai-forever. Четыре decision-модели за неделю: Jev-класс вышел из тупика.
Где это нужно вам. Любое узкое решение с закрытым списком вариантов: маршрутизация заявки в нужный отдел, допуск документа к оплате, тревога «срочно позвать человека» в чат-боте. Дешёвая и быстрая судья решает такие вопросы без вызова большой модели, а большая подключается только на спорных случаях.
Каталог: китайские модели
Данные с HuggingFace и из каталога OpenRouter на 18 октября 2026. Цены указаны за миллион токенов, вход и выход, в долларах.
Qwen (Alibaba). Самая широкая линейка открытых весов. Qwen3.8-27B - плотная, 27.8 миллиарда параметров, Apache 2.0, миллион контекста, 0.24 и 2.20. Qwen3.8-2.4T-A95B - флагман, 2.45 триллиона параметров, 95 миллиардов активных, 2.00 и 6.00. Плюс отдельная линейка Max для закрытого API. Если нужна модель, которую можно скачать и дообучить, Qwen сегодня первый выбор по соотношению «качество плюс лицензия».
DeepSeek. V4.1-Flash - 552 миллиарда параметров, но 8 миллиардов активных на prefill и 16 на decode. Лицензия MIT, то есть самая свободная из всех. Цена входа 0.04 за миллион токенов, это почти бесплатно по меркам рынка. Специализация - дешёвая работа с большими объёмами входа: агентские сценарии, где модель читает много и отвечает коротко.
Kimi (Moonshot). K3 - 2.78 триллиона параметров, 16 экспертов из 896, нативное зрение, миллион контекста. Первая открытая модель класса трёх триллионов. Цена входа 0.304, выхода 11.94, и вот эта асимметрия говорит о назначении: читать дёшево, писать дорого. Заявлена под длинные инженерные сессии: работа с большими репозиториями, терминал, отладка.
GLM (Z.ai). GLM-5.3 - 753 миллиарда параметров, 78 слоёв, 8 экспертов на токен, разреженное внимание. GLM-5.3-Flash - 321 миллиард под MIT, цена 0.048 и 0.20, один из самых дешёвых вариантов в каталоге. По цене за выход это лучший открытый вариант для массовых задач.
MiniMax. M3 - 427 миллиардов, миллион контекста, 0.30 и 1.20. Своя лицензия.
Tencent. Hy4-preview - 780 миллиардов под Apache 2.0, 0.834 и 2.50. Отдельная линейка HY-MT - маленькие модели только под перевод, от 1.8 до 30 миллиардов.
Xiaomi. MiMo-V2.6-Pro - 1.02 триллиона параметров под MIT, 0.435 и 0.87. Молодая лаборатория с агрессивной ценой.
StepFun и InclusionAI. Step-3.7-Flash - 201 миллиард под Apache 2.0. Ling-3.0-flash - 127 миллиардов под MIT. Второй эшелон, который стоит смотреть, когда бюджет жмёт.
MiniCPM (OpenBMB). Отдельная история. MiniCPM-V-4.7 существует в двух вариантах: 35B-A3B (MoE, 35.2 миллиарда всего) и 1B (1.55 миллиарда). Оба под Apache 2.0. Линейка сделана под устройства: телефоны, одноплатники, промышленные чипы. Про 1B отдельный разговор ниже.
Каталог: западные модели
OpenAI. Закрытая линейка GPT-6.1 и GPT-5.6 в нескольких размерах: Sol, Terra, Luna. Sol - верхний, 2.00 и 10.00. Luna - дешёвый, 0.10 и 0.50. Контекст около 1.05 миллиона токенов. Открытые веса есть только у gpt-oss: 120b и 20b под Apache 2.0, оба MoE, контекст 131 тысяча токенов.
Anthropic. Закрытые модели поколения 5.5, контекст миллион токенов, работа с изображениями и файлами. Открытых весов нет.
Google. Gemini 4 Argon - 2.00 и 10.00, миллион контекста. Gemini 3.8 Flash - 0.825 и 4.13, дешёвый рабочий вариант для объёмных задач. Отдельно линейка image-моделей Nano Banana. Открытые веса - только Gemma и EmbeddingGemma.
Meta. Muse Spark Open - 822 миллиарда параметров, 42 активных, своя лицензия, 1.25 и 4.25. Muse Wonder - закрытый флагман, 4.00 и 20.00, самая дорогая строка в каталоге.
Mistral. Large 4 - миллион контекста, 0.68 и 2.09. Плюс линейка Ministral от 3 до 14 миллиардов для локального запуска и Devstral под код.
NVIDIA. Nemotron 3.5 Super VL - миллион контекста, 0.10 и 0.40, мультимодальная. Плюс Nemotron 3 Ultra на 550 миллиардов и семейство Nano. Ориентированы на корпоративное развёртывание.
xAI. Grok 4.7 - 500 тысяч контекста, 2.00 и 6.00.
Обратите внимание на закономерность. Западные закрытые модели держат цену в районе двух долларов за вход. Китайские открытые модели при сопоставимом классе стоят от 0.04 до 0.30. Разница в пятьдесят раз - это не про качество, это про бизнес-модель и про то, кто платит за железо.
И отсюда же вывод, который я разбирал отдельно: доступность фронтирной модели не значит, что её надо звать в каждую задачу. Дорогая модель в задаче, которая решается дешёвой, - это не качество, а списанный бюджет. Лечится маршрутизацией по классу задачи, тому же принципу, на котором стоят телефонные сети и CDN: почему фронтирные LLM не всегда оправданы и роутинг моделей в агенте.
Спецмодели: зачем 1B, когда есть 500B
Вот тот самый вопрос из письма. Разберём на живых примерах.
MiniCPM-V-4.7-1B. 1.55 миллиарда параметров, Apache 2.0, понимает изображения и видео, контекст 262 тысячи токенов, кэш на 256K стоит 3 гигабайта. В формате Q4_K_M файл весит 672 мегабайта, а отдельный файл визуального энкодера - 1.11 гигабайта. У меня она лежит в LM Studio и работает на обычной карте.
Зачем такая нужна. Она смотрит на картинку за доли секунды и стоит копейки. Если у вас поток из десяти тысяч фотографий накладных в сутки, отправлять каждую в GPT-6.1 Sol - это счёт, от которого бухгалтер придёт с вопросами. А 1B-модель разберёт их локально, а дорогую вызовете только на спорных случаях.
Qwen3-VL-8B-Instruct. 8.77 миллиарда, Apache 2.0. Тот же класс задач, но с лучшим пониманием сложных изображений. Компромисс между ценой и качеством.
SmolVLM2-2.2B - 2.25 миллиарда, Apache 2.0, сделана под устройства с малым объёмом памяти.
moondream3-preview - компактная модель под описание изображений и поиск объектов, своя лицензия.
Эмбеддеры. Модель, которая не генерирует текст, а превращает его в вектор для поиска. EmbeddingGemma-2 - 744 миллиона параметров, Apache 2.0. На ней строится поиск по базе знаний: находим похожие куски, отдаём модели. Та самая RAG-схема. Живая проверка на 53 скриншотах документации: поиск по всей пачке за 8 секунд на одной видеокарте. Поиск по скриншотам на одной видеокарте.
Реранкеры. Вторая ступень поиска: берут найденные куски и пересортировывают по реальной релевантности. Qwen3-Reranker-4B - 4 миллиарда, Apache 2.0.
OCR. Распознавание текста с картинок. DeepSeek-OCR - 3.34 миллиарда под MIT. GLM-OCR - 1.33 миллиарда под MIT. Обе умеют разбирать документы и таблицы, а не только чистый скан.
ASR. Речь в текст. Whisper large-v3-turbo - 809 мегабайт под MIT, работает на 99 языках, включая русский. Parakeet TDT 0.6B от NVIDIA - 627 мегабайт под CC-BY-4.0, быстрее, но в основном под английский.
TTS. Текст в речь. Kokoro-82M - 82 миллиона параметров под Apache 2.0, звучит на удивление прилично. Qwen3-TTS - от 0.6 до 1.7 миллиарда, с клонированием голоса.
Сегментация изображений. SAM 2.1 от Meta - 224 миллиона параметров, выделяет объекты на картинке по точке или рамке.
Агентные модели. Агент - это модель в цикле: она выполняет шаги, вызывает инструменты, смотрит на результат и решает, что делать дальше. UI-TARS-1.5-7B - 8.29 миллиарда, обучена нажимать на кнопки в интерфейсах. Как научить модель звать инструменты и сколько это стоит - отдельная глава: Агенты: учим модель звать инструменты.
Малые MoE для локального запуска. LFM2.5-8B-A1B - 8 миллиардов всего, 1 активный. Granite-4.1-3B - 3.4 миллиарда под Apache 2.0 от IBM, обучен под корпоративные задачи, включая вызовы инструментов; у линейки Granite есть и гибридные switch-версии, разбираю их отдельно: Granite Switch 4.1 - универсальный солдат?.
Смысл всей этой полки в одном предложении. Большая модель нужна там, где задача сложная и редкая. Маленькая специализированная нужна там, где задача простая и повторяется миллион раз. Деньги экономятся на втором, а не на первом.
Девять вопросов поставщику перед пилотом
Этот раздел я бы вставил в любой коммерческий разговор про ИИ. Вопросы простые, ответы на них сразу показывают, кто разобрался.
- Какая модель по имени и версии, сколько в ней параметров и она плотная или MoE?
- Сколько параметров активно на токен? Если MoE, сколько экспертов выбирается и сколько их всего?
- Какой контекст реально доступен, и меняется ли цена при превышении порога?
- В каком формате веса и на каком железе будет запуск - NVIDIA, AMD с ROCm, Apple Silicon? Формат привязан к платформе: GGUF, EXL3 и MLX - это три несовместимых мира.
- Сколько памяти уходит на веса, а сколько на KV cache при целевом контексте?
- Какая задержка до первого токена и какая скорость генерации на вашем корпусе, а не в презентации?
- Что мерили: tok/s или время до готового результата? На каком домене?
- Что с лицензией: можно ли использовать в коммерческом продукте, можно ли дообучать, нужно ли показывать логотип?
- Нужны ли вам вызовы инструментов и жёсткий JSON на выходе? Вызов инструментов поддерживают 400 моделей из 471 в каталоге, структурный вывод - 391, и это не одни и те же модели. Проверяется тестом, а не словом «да» в презентации.
Если на третий и пятый вопросы отвечают «не важно, там же облако», это не ответ, а отказ считать деньги. Облако тоже считает память, просто счёт приходит вам.
Одиннадцать вопросов на проверку
Ответьте не подглядывая. Если получается десять из одиннадцати, статья свою работу сделала.
- Чем плотная модель отличается от MoE по расходу памяти и по скорости?
- Какие оси классификации моделей вы знаете, кроме плотности параметров?
- Что означает запись 35B-A3B?
- Почему prefill быстрее decode?
- Что такое TTFT и что его увеличивает?
- Зачем нужен KV cache и от чего зависит его размер?
- Почему 27B влезает в 16 гигабайт, а в исходном виде требует 55?
- Чем GGUF отличается от FP8 и почему их нельзя перепутать?
- Что такое acceptance rate и почему он падает на другом языке?
- Зачем нужна модель на 1.5 миллиарда параметров, если есть на 500?
- Почему цена входа и цена выхода у одной модели различаются в двадцать раз?
Что дальше
Все статьи, на которые я ссылался по ходу, собраны на hermes-agent.ru - замеры спекуляции, токенизаторов, квантов и движков лежат там же, где их и обсуждали.
Если после этой статьи у вас остались слова, которых в ней нет, - пишите, разберём следующими.