
Опубликовано
Агенты: учим модель звать инструменты
Автор: Гусев Николай [портфолио]
Обновлено
Шестая часть цикла по книге AI Agents and Applications Роберто Инфанте (Manning, 2026). Главы 11-12: tool-based агенты и мультиагентные системы. Предыдущие части: фундамент и промпты, суммаризация с живым замером, LangGraph, RAG в глубину, продвинутый RAG.
Что меняется, когда цепочка становится агентом
До сих пор в цикле порядок работы диктовали мы. В RAG из прошлых частей маршрут жёсткий: вопрос пользователя - поиск по базе - найденные куски плюс вопрос в модель - ответ. Программа написана заранее, модель на каждом шаге делает ровно одну вещь.
Агент начинается с одного изменения: мы перестаём диктовать маршрут. Вместо него даём модели список инструментов - функций, которые она может попросить выполнить, - и разрешаем самой решать: вызывать инструмент или уже отвечать.
Разберу на примере, как это выглядит изнутри. Пользователь спрашивает: "Что интересного в Корнуолле в мае?" Модель не может знать погоду и события - ей дают три инструмента: поиск по путеводителю, прогноз погоды, календарь фестивалей. Она отвечает не текстом, а заявкой: "вызови поиск по путеводителю с аргументом Корнуолл, май". Программа заявку исполняет, результат возвращается модели. Модель изучает ответ и снова выбирает: позвать ещё один инструмент (прогноз погоды) или ответить. Так по кругу, пока модель не решит, что данных достаточно.
Этот круг и есть агент. Всё остальное в главах 11-12 - инженерия вокруг него: как оформить инструменты, как хранить историю круга, где ставить ограничения и что делать, когда одного агента мало.
Круг изнутри: заявка, исполнение, возврат
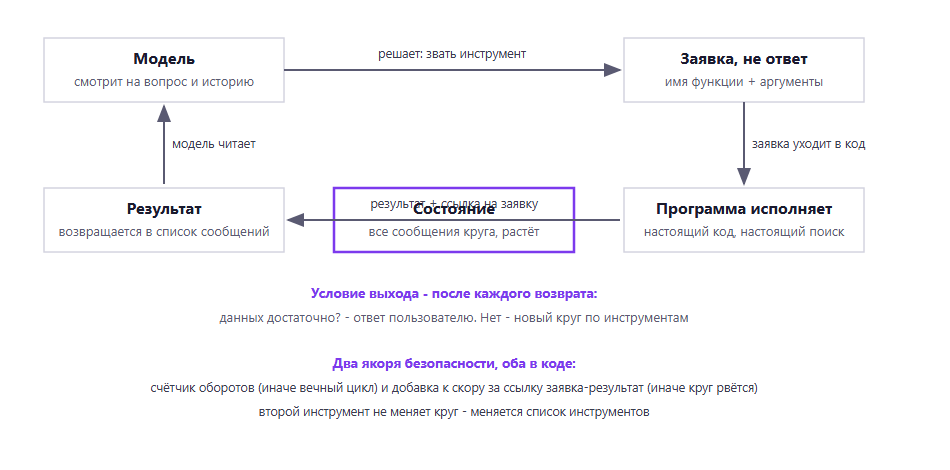
Механику стоит один раз увидеть руками, и книга правильно строит главу так: сначала сборка вручную, потом готовая абстракция.
Шаг первый - инструмент. Это обычная функция с хорошим описанием. У книги это поиск по Wikivoyage, обёрнутый декоратором @tool. В описании функции прописано, что она делает и какие аргументы принимает - и вот что важно: модель выбирает инструмент, читая описание, а не заглядывая в код. Плохое описание - и модель не дойдёт до нужного инструмента или позовёт не тот. Инструмент это контракт, и качество контракта важнее качества реализации.
Шаг второй - заявка. Модель возвращает не ответ, а структурированную запись: имя функции и аргументы. Формат у книги - JSON-схема, языковые модели специально обучены под него.
Шаг третий - исполнение и возврат. Программа выполняет функцию и возвращает результат модели отдельным сообщением. Здесь прячется деталь, которую рукописная сборка показывает наглядно: сообщение с результатом обязано ссылаться на заявку по идентификатору вызова. Без этой ссылки модель не поймёт, на чей запрос пришёл ответ, и круг разорвётся.
Шаг четвёртый - условие выхода. После каждого возврата модель снова выбирает: ещё инструмент или готовый ответ. Программа проверяет решение и направляет поток: есть заявка - исполняем, нет - отдаём пользователю.
И поверх всего - состояние: список всех сообщений круга. Вопрос, заявки, результаты, черновики ответов - всё лежит в одном списке, который растёт с каждым оборотом. К нему я вернусь: именно состояние - источник самых дорогих багов главы.
Два вывода, ради которых глава и написана
Первый. Добавление второго инструмента не меняет ничего из перечисленного выше: ни круг, ни шаги, ни условие выхода. Меняется список инструментов - и всё. Это проверено в книге кодом: второй инструмент, прогноз погоды, добавляется одной строкой в список. Вывод для планирования: начинать с одного инструмента, довести круг до рабочего, потом расширять список. Мультиагентность - следующий уровень, о нём ниже.
Второй. Готовая абстракция create_react_agent делает всё то же самое в одну строку - и именно поэтому стоит собрать круг руками хотя бы раз. Абстракция прячет ту самую ссылку на заявку, склейку состояния, условие выхода. Не зная, что под капотом, ты не поймёшь, почему агент молчит или крутится на месте.
Шесть грабель, на которые книга наступает сама
Учебный код книги демонстрирует ровно те ошибки, которые потом переезжают в прод. Разберу все шесть, потому что каждая узнаваема.
Первая - тихая порча истории. Вот узел модели из книги (листинг 11.8, раздел 11.8):
def llm_node(state):
    current_messages = state["messages"]
    current_messages.append(system_message)  # мутация списка состояния
    return {"messages": [llm.invoke(current_messages)]}
current_messages это не копия, а то же самое, что лежит в state["messages"]: присваивание списка в Python копии не делает. append дописывает в состояние в обход механизма, который склеивает ходы. Результат виден в трассе книги: системный промпт болтается в конце истории и добавляется заново на каждом обороте. Урок: в состояние пишут только через отведённый для этого механизм, алиасы - источник багов, которые живут неделями.
Вторая - цикл без счётчика. Условие выхода доверено модели: если она вечно зовёт инструменты, никто её не остановит. В книге счётчик шагов появляется позже, вместе с абстракцией - то есть после того, как понадобился. Урок: ограничение обязано стоять в коде с первого дня.
Третья - "чат-бот", который не помнит. Демонстрационный REPL-цикл (раздел 11.6) на каждой реплике строит состояние с нуля:
state = {"messages": [HumanMessage(content=user_input)]}
result = travel_info_agent.invoke(state)
Спросил "а там какая погода?" - и агент честно не знает, что такое "там": в состоянии только одна реплика, истории нет. Это не чат-бот, а одноразовый вопросник. Память между репликами - отдельная задача, в книге она отложена на три главы вперёд.
Четвёртая - мусор из инструмента. Инструмент поиска из листинга 11.3:
@tool
def search_travel_info(query: str) -> str:
    docs = ti_retriever.invoke(query)
    top = docs[:4] if isinstance(docs, list) else docs
    return "\n---\n".join(d.page_content for d in top)
Четыре документа склеиваются как есть: page_content чанков Wikivoyage - это сырой HTML с тегами и служебными атрибутами. Всё это едет в контекст модели - платишь токенами за скобки и кавычки, а модель ещё и вынуждена их распарсивать. Побочный эффект: модель не цитирует источники. В возврате нет источника - не из чего. Урок: инструмент возвращает вычищенный, обрезанный по длине текст с указанием, откуда он.
Пятая - недетерминированный мок. Демо-погода из листинга 11.10 - чистый рандом:
weather = random.choice(["sunny", "foggy", "rainy", "windy"])
temperature = random.randint(18, 31)  # WeatherForecastService, листинг 11.10
Задание "найти город с хорошей погодой" при этом проверяется суждением модели. Сколько оборотов сделает агент? Сколько раз не повезёт с рандомом. Пример красивый, вывод из него не сделан: критерий качества должен жить в коде или в структурированной проверке, не в настроении модели. Иначе отладка невозможна - воспроизвести сценарий нельзя.
Шестая - промпт как единственный рычаг. Когда агент начал отвечать из памяти вместо поиска (в трассе книги он выбирает Newquay и Falmouth, "не консультируясь с семантическим поиском"), лечение - строчка в системном промпте:
system_message = SystemMessage(content="""
Only use the tools to find the information you need
(including town names).""")
Работает. Но это мягкий контроль - модель может и ослушаться. Жёсткие аналоги: требовать вызов инструмента настройкой API, ставить проверку перед ответом. Правило: промпт - первый рычаг, не единственный; всё, что обязано произойти, закрепляется в коде.
Продолжение - мультиагентность: роутер, supervisor и цена команды.
Вторая часть выпуска: Мультиагентность: роутер, supervisor и цена команды.
Книга: AI Agents and Applications (Roberto Infante, Manning, 2026), глава 11.
#AI_Agents_and_Applications #глава_6а