
Опубликовано
Продвинутый RAG: четыре места вокруг ретривера
Автор: Гусев Николай [портфолио]
Обновлено
Пятая часть цикла по книге AI Agents and Applications Роберто Инфанте (Manning, 2026). Главы 8-10 книги: продвинутая индексация, трансформации вопросов, роутинг и постобработка. Предыдущие части: фундамент и промпты, суммаризация с живым замером, LangGraph, RAG в глубину.
Серия выходит раз в 1-2 дня, пометки: #AI_Agents_and_Applications #глава_5.
Одна карта на три главы
Главы 6-7 построили RAG из двух шагов: индексация и запрос. Следующие три главы добавляют к ним ещё места вмешательства, и весь материал раскладывается по одной карте:
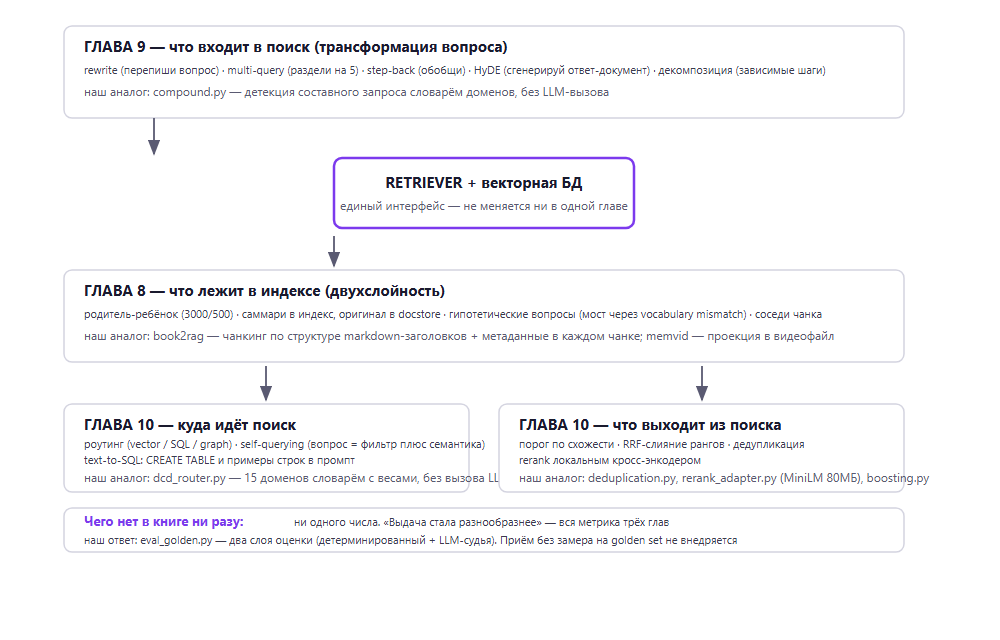
Векторная БД остаётся той же во всех трёх главах. Меняется то, что в неё кладут (глава 8), что в неё приходит (глава 9), куда она смотрит и что отдаёт (глава 10).
Глава 8. Что лежит в индексе
Проблема: один эмбеддинг на чанк - всегда компромисс. Крупный чанк даёт контекст, но его вектор размыт. Мелкий точен, но беден контекстом.
Решение - двухслойность. Нижний слой: мелкие сегменты для точного поиска. Верхний: то, что реально уходит в LLM. Четыре приёма книги - четыре варианта нижнего слоя:
- родитель-ребёнок: родители по 3000 символов, дети по 500, поиск по детям, в LLM уходит родитель;
- эмбеддинги саммари: в индексе плотное саммари, в docstore оригинал;
- гипотетические вопросы: LLM генерирует четыре вопроса на чанк, в индекс кладутся вопросы. Работает как мост: вектор вопроса попадает в вектор вопроса, даже если формулировки документа далеки от формулировки пользователя;
- расширение чанков: индексируем мелкий чанк, в docstore кладём окно из трёх соседних чанков вместо одного.
Последний - самый дешёвый: ноль вызовов LLM на индексации.
Отдельный класс - таблицы и картинки. Их нельзя осмысленно нарезать на чанки, поэтому они индексируются через текстовую проекцию: саммари в векторную БД, исходник в docstore. Общий принцип: вектор всегда про текст, LLM всегда получает оригинал.
"Заметки на полях". Наш book2rag режет книги по структуре markdown-заголовков - иерархический чанкинг из этого раздела: чанк это раздел, семантика не рвётся посреди таблицы. Метаданные (глава, страница, источник) кладутся в каждый чанк с первого дня - именно это потом сделало возможной фильтрацию. Крайняя форма текстовой проекции - memvid: вся память агента в одном видеофайле, эмбеддинги в кадрах.
Отдельная статья: memvid: память для AI-агентов в одном файле.
Глава 9. Что входит в поиск
Поиск проседает часто не из-за отсутствия данных, а из-за самого вопроса. Четыре приёма:
- Rewrite-Retrieve-Read: перед поиском дешёвая модель переписывает вопрос. "Tell me some fun things I can enjoy in Cornwall" превращается в "fun activities to do in Cornwall" - и выдача перестаёт быть тремя кусками одной секции.
- Multi-query: вопрос с несколькими неявными вопросами разворачивается в пять независимых. Самый дорогой приём: пять поисков плюс пять вызовов LLM на один вопрос, и без ранжирования на выходе пять списков идут в промпт как есть.
- Step-back: не дробить, а обобщить. "Tips for a trip to Brighton?" становится "general tips for a coastal city", поиск идёт по обоим. Нюанс автора: дешёвые модели генерируют слишком общие абстракции, в книге сюда поставлена дорогая модель.
- HyDE: индекс не трогаем, под вопрос генерируется гипотетический ответ-документ и ищется по нему. Риск, который книга не обсуждает: гипотетический документ может быть уверенно неверным, и синтез потом опирается на выдумку.
Плюс декомпозиция зависимых вопросов: "средняя температура августа на самом популярном песчаном пляже Корнволла" - сначала пляж, потом температуры для него, потом среднее. Честная оговорка авторов: в SQL этот вопрос решается одним AVG, то есть LLM городит цепочку там, где база справится сама.
"Заметки на полях". Наш аналог декомпозиции - детектор составных запросов из auto-rag. Отличие от книги принципиальное: детекция детерминированная, словарём доменных слов, а не LLM-промптом. Ноль вызовов модели, ноль латентности, покрыто юнит-тестами. Если в вопросе есть слова и из домена продуктов, и из домена инфраструктуры - вопрос составной, разворачивается в два под-запроса по своим коллекциям:
def detect_compound(query: str, dcd: dict | None = None) -> list[dict]:
    ql = query.lower()
    has_product = any(w in ql for w in _COMPOUND_PRODUCT_WORDS)
    has_infra = any(w in ql for w in _COMPOUND_INFRA_WORDS)
    if not (has_product and has_infra):
        return []
    subqueries = []
    if has_product:
        subqueries.append({"query": query, "domain": "astra-products",
                           "collection": "astra-products"})
    if has_infra:
        infra_terms = [w for w in _COMPOUND_INFRA_WORDS if w in ql]
        infra_query = f"{query} {' '.join(infra_terms[:3])}" if infra_terms else query
        subqueries.append({"query": infra_query, "domain": "devops",
                           "collection": "deployment"})
    return subqueries
Вопрос "миграция ALD Pro на MS AD" содержит слова обоих словарей - получает два под-запроса: по коллекции продуктов и по коллекции развёртывания. Полный файл: compound.py в материалах выпуска. Роутинг по типу вопроса мы разбирали отдельно: Домашний Perplexity, часть 2: кто думает.
Глава 10. Куда идёт поиск
Когда источников несколько - векторная БД, SQL, граф - вопрос классифицируется и уходит в нужную ветку. В книге роутер сделан через структурированный вывод с ограничением на два значения. Два пункта из summary, которых нет в основном тексте и которые критичны: few-shot примеры в промпт роутера и fallback на альтернативный источник при пустой выдаче. Классификатор всегда ошибается, а пустая выдача без fallback выглядит для пользователя как "не знаю".
Self-querying: вопрос разделяется на семантическую часть и метаданные, БД сначала фильтрует, потом ищет по смыслу в отобранном. Узкое место - не LLM, а разметка: поле destination в примере расставлено руками по 20 URL. Без качественной разметки на индексации LLM будет уверенно генерировать фильтр по несуществующему полю.
Text-to-SQL: главная находка из цитируемой статьи Rajkumar и коллег - галлюцинации в SQL это в первую очередь выдуманные имена таблиц и колонок, и они резко падают, если в промпт класть CREATE TABLE плюс примеры строк. Отдельно чистка: модель заворачивает SQL в markdown-обвязку, и исполнитель падает на тройных кавычках перед SELECT.
*"Заметки на полях". Наш роутер dcd_router тоже детерминированный: 15 доменов словарём ключевых слов с весами и anti-keywords (слова, которые наоборот уводят из домена). Цена вопроса - микросекунды вместо вызова LLM. Полный файл - dcd_router.py в материалах выпуска (ссылка следом). LLM-классификатор из книги хорош там, где домены нельзя выразить словарём; у нас домены известны заранее, и словарь дешевле, предсказуемее и тестируем.
Файл: dcd_router.py в материалах выпуска.
Глава 10. Что выходит из поиска
Постобработка отсекает и улучшает то, что дошло от ретривера, до отправки в LLM:
- порог по схожести. Число 0.6 в примере с потолка: зависит от модели эмбеддингов и метрики, между проектами не переносится;
- ключевые слова: обязательные и запрещённые, пересечение по токенам;
- временное взвешивание: скор плюс штраф за давность обращения. Побочный эффект - штрафуются вечные корректные статьи, которые давно не открывали;
- RRF, Reciprocal Rank Fusion: слияние нескольких выдач по рангам, формула 1/(rank+k), без калибровки абсолютных скоров. Естественный мост к гибридному поиску: dense-выдача плюс BM25, слитые по рангам.
RRF в книге - 20 строк на чистом Python, и в них дыра, которую авторы не замечают: ключ пары это группа и локальный ранг, дедупликации по содержимому нет. Два одинаковых чанка из двух запросов считаются разными документами: дубликат задваивается в промпте, а его двойной вклад искажает ранжирование.
"Заметки на полях". Наша постобработка в gateway собрана ровно из этих деталей. Дедупликация каноническая: документы группируются по каноническому идентификатору, победитель группы выбирается по приоритету источника (живой корпоративный источник бьёт локальный снапшот, тот бьёт память агента, тот - открытый веб), а проигравшие сохраняются в метаданные как альтернативные источники:
_ORIGIN_PREFERENCE = {
    EvidenceOrigin.LIVE_CORPORATE: 4,
    EvidenceOrigin.LOCAL_SNAPSHOT: 3,
    EvidenceOrigin.AGENT_MEMORY: 2,
    EvidenceOrigin.PUBLIC_WEB: 1,
}

def deduplicate_evidence(evidence: Iterable[Evidence]) -> list[Evidence]:
    groups: dict[str, list[Evidence]] = {}
    order: list[str] = []
    for item in evidence:
        canonical_id = item.canonical_id or item.document_id
        if canonical_id not in groups:
            groups[canonical_id] = []
            order.append(canonical_id)
        groups[canonical_id].append(item)
    deduplicated = []
    for canonical_id in order:
        candidates = groups[canonical_id]
        winner = max(candidates, key=lambda item: (
            _ORIGIN_PREFERENCE.get(item.origin, 0),
            item.final_score, item.retrieval_score))
        alternates = [item for item in candidates if item is not winner]
        if alternates:
            metadata = dict(winner.metadata)
            metadata["alternate_sources"] = tuple(i.source for i in alternates)
            winner = replace(winner, metadata=metadata)
        deduplicated.append(winner)
    return deduplicated
Дальше rerank локальным кросс-энкодером ms-marco-MiniLM (около 80МБ, на CPU, без round-trip в LM Studio) и бусты за точное совпадение идентификаторов: если запрос это номер документа или slug - такой документ поднимается фиксированной добавкой к скору. Оба файла лежат в материалах выпуска, ссылки следом. Почему порог схожести и "больше контекста" не работают сами по себе - отдельная статья, ссылка следом.
Статья: Больше контекста - хуже результат.
Файлы: rerank_adapter.py, boosting.py.
Чего нет в книге ни разу
Во всех трёх главах нет ни одного числа. Ни recall@k до и после, ни доли вопросов, где приём дал выигрыш. Вся метрика - "выдача стала разнообразнее". Для книги допустимо, для инженерного решения нет: приём без замера на золотом наборе не внедряется, потому что половина описанных приёмов на среднем корпусе не окупит добавленную сложность и точку отказа.
У нас оценка двухслойная: детерминированный слой без модели и слой LLM-судьи поверх. Приём внедряется, только если метрика на золотом наборе выросла.
"Заметки на полях". Методологию "RAG от простого к сложному" и типовые ловушки мы разбирали в трёх статьях, ссылки следом.
Статьи: RAG от простого к сложному, Что не пишут в "RAG за 5 минут", Что не пишут в "RAG за 5 минут", часть 2.
Что забрать в работу
- Двухслойность из главы 8 - самый дешёвый приём: расширение чанков соседями вообще без LLM на индексации.
- Rewrite перед поиском - один вызов дешёвой модели, заметный эффект на кривых вопросах.
- Роутинг с fallback - всегда. Пустая выдача без fallback это "не знаю" для пользователя.
- Дедупликация перед RRF - обязательна, иначе двойной вклад дубликата искажает слияние.
- Метрики до и после - приём без замера на золотом наборе не внедряется.
Продолжение - главы 11-12 книги: агенты и мультиагентные системы.
Книга: AI Agents and Applications (Roberto Infante, Manning, 2026), главы 8-10.
#AI_Agents_and_Applications #глава_5